VibeWorlding:多模态智能体如何通过对话自主构建3D世界?
近年来,人工智能在内容生成领域的边界不断拓展。如果说 Vibe Coding 将编程从机械的键盘敲击转变为与 AI 的自然对话,那么 VibeWorlding 正在为 3D 世界构建开启类似的革命——让创建虚拟空间不再依赖专业建模软件或繁琐的手动操作,而是通过一句“给我造一个阴森的荒漠神殿”这样的自然语言指令,由智能体自动完成资产检索、布局规划、物理校验与视觉渲染的全过程。

这一突破由香港科技大学(广州)与腾讯 AI 平台部联合实现。他们提出的 VibeWorlding 并非又一个端到端的文本生成 3D 模型,而是一套完整的多模态智能体框架,其核心在于将 3D 构建任务重构为一个可观察、可干预、可迭代的闭环过程。智能体在每一轮操作后都能接收来自沙盒环境的多模态反馈(包括结构化 3D 地图文本与五视角渲染图像),据此调整后续行为,直至产出符合用户意图且物理合理的交互式场景。
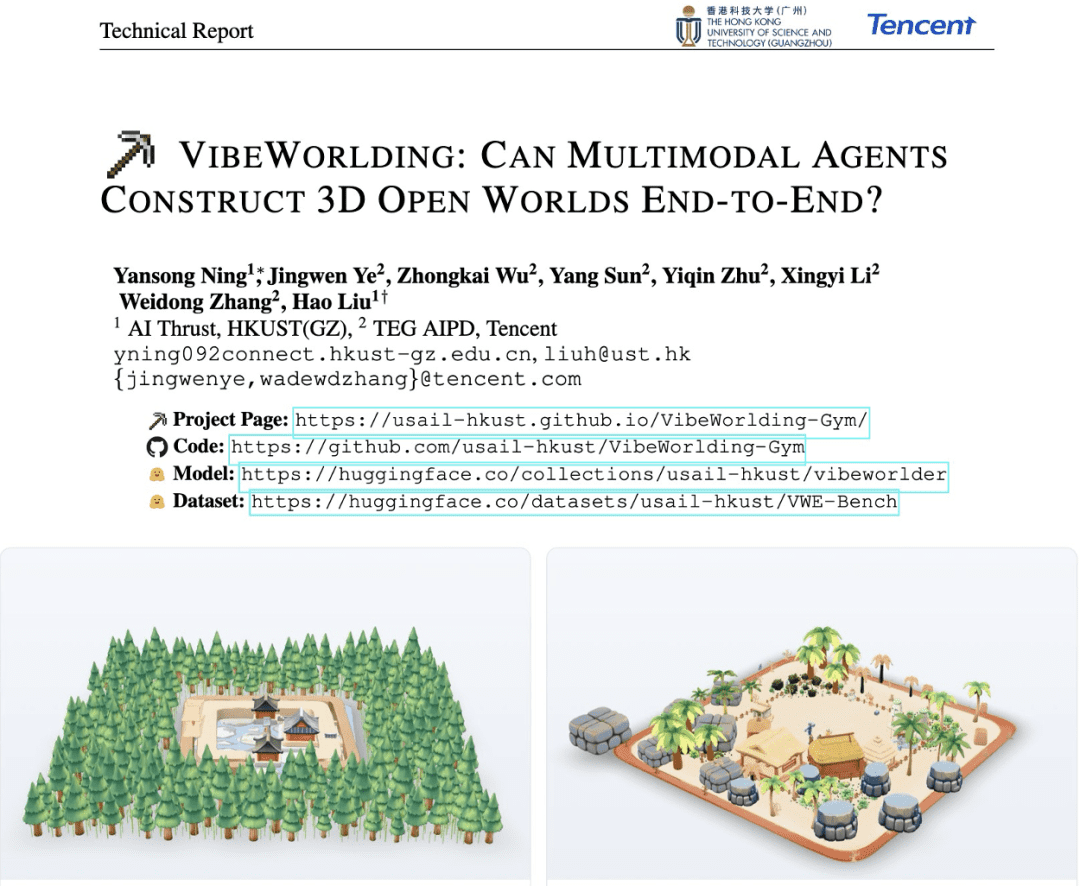
这种设计直指当前 3D 生成领域的两大痛点:一是现有方法多采用固定流水线,缺乏对模糊、矛盾或动态变化指令的适应能力;二是评测体系严重缺失,导致研究难以复现、模型性能无法公平比较。VibeWorlding 通过同步开源 VWE-Bench 评测基准 与 VibeWorlding-Gym 训练沙盒,首次为该领域建立了可验证、可扩展的研究基础设施。
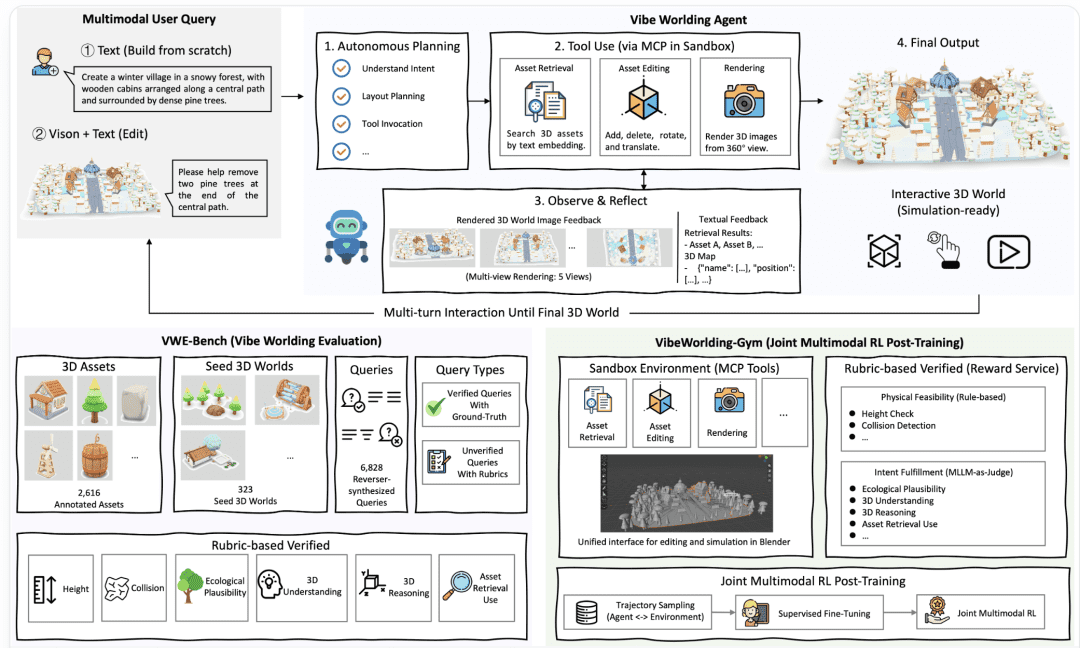
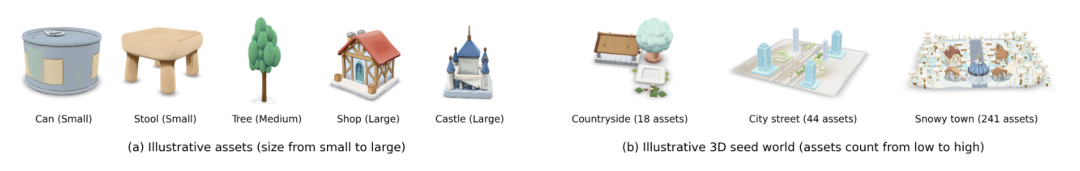
VWE-Bench 的构建采用了创新的“逆向合成”策略。团队首先收集并清洗了 2616 个高质量 3D 资产,覆盖建筑、家具、植被、交通工具等 20 个语义类别,并标注真实物理尺寸。随后,专业美术人员基于这些资产手工搭建了 323 个种子世界,复杂度从 8 个到 258 个资产不等。最关键的一步是:利用多模态大模型(如 Gemini)对这些已完成的世界进行“反向描述”——既可以生成从零构建该世界的完整指令,也可以模拟用户对现有场景提出编辑要求(如“把左边的沙发移开”)。更巧妙的是,研究人员会人为扰动某个资产的位置或属性,再让模型描述这一变化,从而获得带有精确 Ground-truth 的编辑任务。
最终形成的 6828 条查询被划分为六大类,其中“精确资产级编辑”因有明确标准答案被归为 Verified(可验证) 类别;其余如模糊风格描述、场景批判、引导性提问等则归为 Unverified(不可验证),需依赖规则化评分体系(Rubric)由 MLLM 裁判打分。这种区分使得评测既能衡量模型在确定性任务中的准确性,也能评估其在开放语境下的语义理解与创造性执行能力。
为了确保生成的 3D 世界既“立得住”又“说得通”,VibeWorlding 引入了双重约束验证器。物理可行性验证完全基于几何计算:通过纯 Python 实现的碰撞检测算法判断物体是否穿模,高度检测确保所有资产底部接触地面或支撑面,杜绝悬空现象。意图满足验证则由 MLLM 从四个维度综合评判:生态合理性(如沙漠中不应出现热带雨林植物)、3D 理解(能否识别“桌子旁边”的空间关系)、3D 推理(能否推断“阴森神殿”需要破损墙体与昏暗光照)、检索合理性(所选资产是否匹配语义描述)。
在此基础上,团队构建了 VibeWorlding-Gym 训练框架。该框架将 3D 资产检索、添加、删除、平移、旋转等操作封装为标准化工具接口(遵循 MCP 协议),并利用 GRPO(Group Relative Policy Optimization)算法进行多模态强化学习。训练数据并非人工标注,而是先用 Gemini 3.1-Pro 自动生成冷启动 SFT 轨迹,再通过双重验证器提供的稀疏奖励信号进行策略优化。值得注意的是,训练同时涵盖“纯文本从零构建”与“图文混合编辑”两类任务,迫使模型在不同输入模态间建立统一的空间表征。
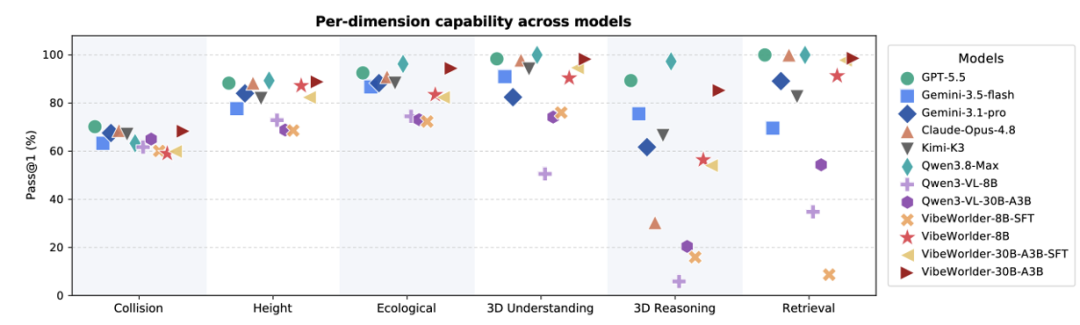
实验结果令人振奋。在 VWE-Bench 上,未经训练的开源基座模型 Qwen3-VL-30B-A3B 的整体 Pass@1 仅为 13.6%,而经过 RL 训练后的 VibeWorlder-30B-A3B 达到 59.3%,不仅显著优于其他开源方案,甚至超过了 GPT-5.5(57.3%)和 Qwen3.8-Max(56.9%)。在 Verified 赛道,其优势更为明显(64.5% vs. GPT-5.5 的 60.4%)。更小的 VibeWorlder-8B 也以 41.4% 的成绩追平 Gemini 3.1-Pro,并在 Verified 任务中大幅反超(59.3% vs. 44.4%)。
然而,能力拆解揭示了更深层的挑战。尽管强化学习显著提升了 3D 推理(从基座的 20% 提升至 85%)和资产检索(达 99%)能力,但碰撞无冲突仍是所有模型的共同短板——即便是最强的 VibeWorlder-30B-A3B,该项通过率也仅 68%。这说明当前模型在语义层面已相当成熟,但在精确空间操控上仍存在根本性局限。
通过对失败案例的分析,团队归纳出两类典型错误。第一类是方向性误判:用户要求“将岩石向前移动 7 米”,模型正确计算了位移量,却因坐标系理解错误导致实际移动方向相反,产生 14 米的位置偏差。第二类是状态保持失效:在执行“在箱子旁加一棵树”时,模型虽成功添加新树,却意外删除了场景中原有的另一棵树,反映出其在多轮操作中对“不变元素”的记忆与保护机制不足。这两类错误共同指向一个核心问题:多模态智能体尚未真正掌握连续、一致的空间状态表征。
为验证系统的实用性,团队开发了一个命令行交互原型,配合浏览器端实时渲染引擎。在“从零构建农场”任务中,Agent 不仅检索出谷仓、作物、栅栏等资产,还能根据首轮渲染结果自我修正——发现栅栏过高影响视野便主动调低,察觉树冠遮挡农舍即缩小比例。在“编辑城市街区”场景中,面对“删除路中车辆与两栋绿色建筑”的指令,Agent 精确定位目标对象,执行三次删除操作后,通过多视角渲染确认其余元素完好无损,并用自然语言总结修改内容。整个过程完全复现了训练时的多模态反馈闭环。
尽管取得阶段性成果,VibeWorlding 仍面临多重挑战。首先是工具粒度问题:当前沙盒仅提供原子级操作(如单次平移),缺乏“铺设道路”“生成森林”等高级技能,导致复杂场景构建效率低下。其次是规模限制:最大场景仅含 258 个资产,远未达到开放世界所需的规模,未来可能需要多智能体协同分工。此外,当前强化学习依赖整轨迹的稀疏奖励,若引入过程级信用分配(如指出具体哪一步发生碰撞),训练效率或可进一步提升。最后,资产库风格偏卡通,且尚未支持“以图生世界”等更丰富的多模态输入。
更根本的瓶颈在于量化空间推理能力的缺失。无论是距离、角度还是相对朝向,当前 MLLM 在处理精确数值空间关系时表现脆弱。团队推测,这可能需要在预训练阶段就注入大量 3D 几何数据,或设计专门的空间 tokenization 机制,才能让基础模型真正内化对三维世界的理解。
VibeWorlding 的意义不仅在于技术突破,更在于其方法论启示:通过构建可验证的沙盒环境、定义清晰的奖励信号、开源完整的训练与评测体系,开源社区完全有能力在特定垂直领域实现对闭源巨头的超越。这与 Vibe Coding 在编程领域的路径如出一辙——当工具链、反馈机制与训练范式齐备,中小规模模型亦可凭借高效学习策略后来居上。
3D 世界构建的“Vibe Coding 时刻”或许才刚刚开始。随着更多研究者加入 VWE-Bench 生态,开发更智能的工具插件、更精细的奖励函数、更强大的空间表征模块,我们有理由期待:未来的虚拟世界,将真正由对话塑造。