知识驱动的零样本药物响应预测:MAP框架如何突破虚拟细胞建模瓶颈?
近年来,随着单细胞测序技术与大规模扰动实验(如Perturb-seq)的迅猛发展,构建能够在计算机中模拟药物干预下细胞转录组变化的“虚拟细胞”已成为计算生物学和药物研发领域的核心目标。理想状态下,虚拟细胞应能对任意细胞类型施加任意化合物后产生的全基因组表达变化进行精准预测,从而大幅缩短药物发现周期、降低研发成本。然而,这一愿景长期受制于一个根本性矛盾:人类可合成的化学分子空间估计高达10^60量级,而现有高通量实验所能覆盖的化合物数量通常仅在千至万级别。这种巨大的数据鸿沟导致当前主流的单细胞扰动预测模型普遍依赖“药物ID”作为输入特征——即模型仅能对训练阶段出现过的已知药物做出预测,无法泛化至从未观测过的全新化合物。
正是在这一背景下,上海交通大学人工智能学院团队提出的MAP(Mechanism-Aware Prediction)框架,为虚拟细胞的真正落地提供了关键性突破。该研究摒弃了传统“ID驱动”的建模范式,转而构建一个以生物学机制为核心的知识驱动系统,首次实现了在完全无转录组扰动数据支持的情况下,对未表征药物(unprofiled drugs)的单细胞响应进行零样本预测。这一成果不仅在技术上打通了虚拟筛药的闭环,更在方法论层面重新定义了AI for Science的演进方向。
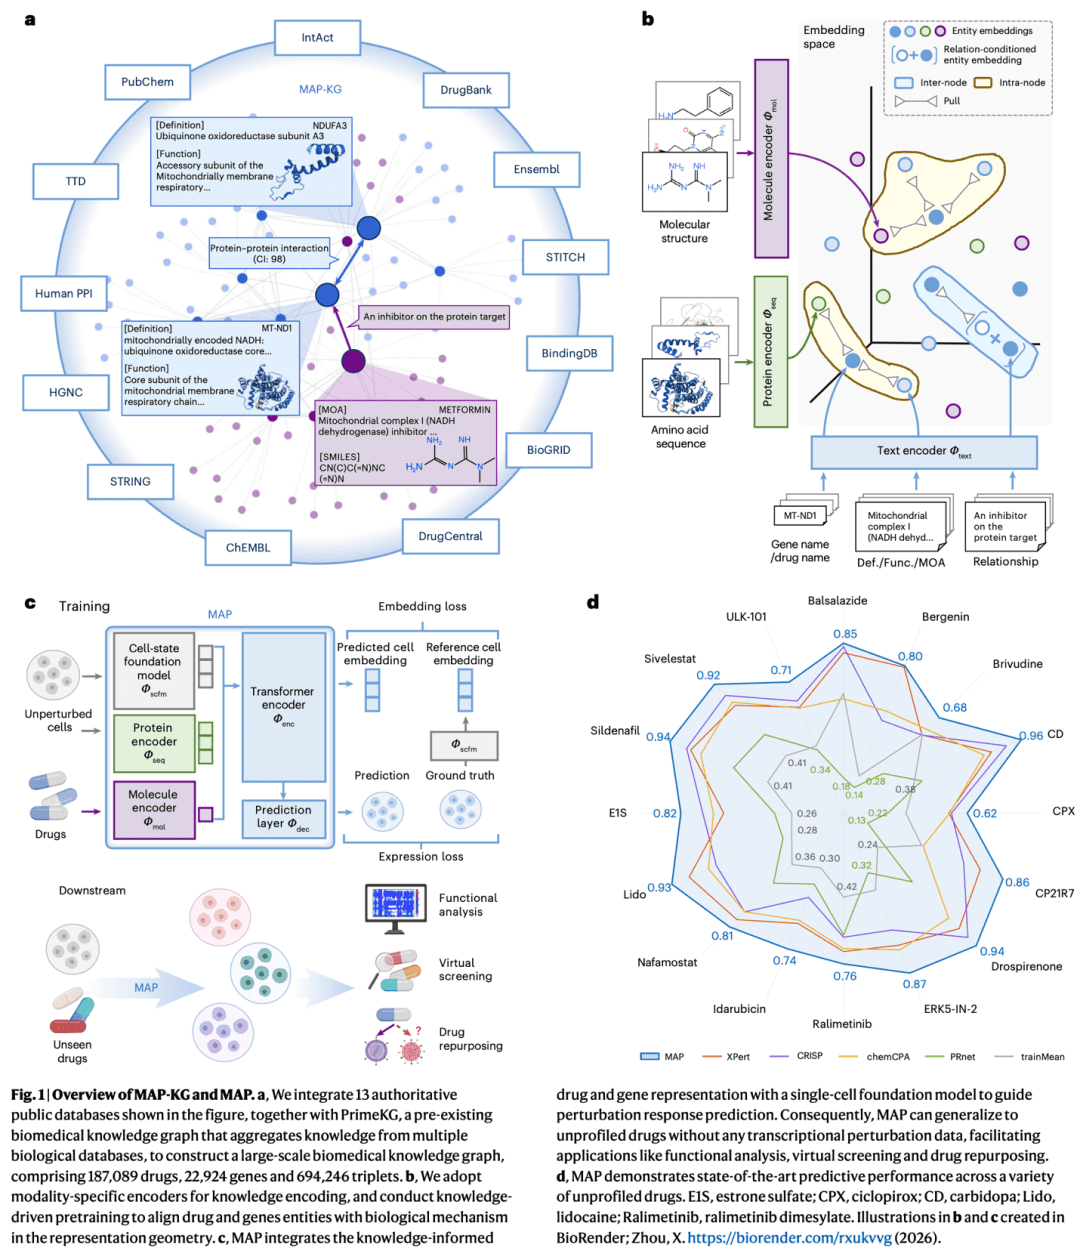
MAP框架的核心创新在于其三层递进式架构:首先,构建一个大规模、多模态、机制导向的生物医学知识图谱(MAP-KG);其次,通过知识驱动的多模态对齐预训练,学习具有强迁移能力的机制感知表示;最后,将这些知识增强的表示作为条件信息注入单细胞基础模型,实现从“细胞状态+药物ID”到“细胞状态+药物机制”的范式跃迁。
在知识图谱构建阶段,研究团队系统整合了包括DrugBank、ChEMBL、STITCH、DisGeNET等在内的14个权威公共数据库,最终形成包含187,000种药物、22,000个基因以及近694,000条机制关系的异构网络。尤为关键的是,MAP-KG不仅记录了传统的“药物-靶点”相互作用,还为每个实体绑定了丰富的多模态属性:药物节点关联其SMILES分子结构与作用机制(MOA)文本描述,基因节点则嵌入其蛋白序列信息。这种设计使得图谱不仅具备拓扑结构,更承载了跨越化学与生物学语义的深层关联。
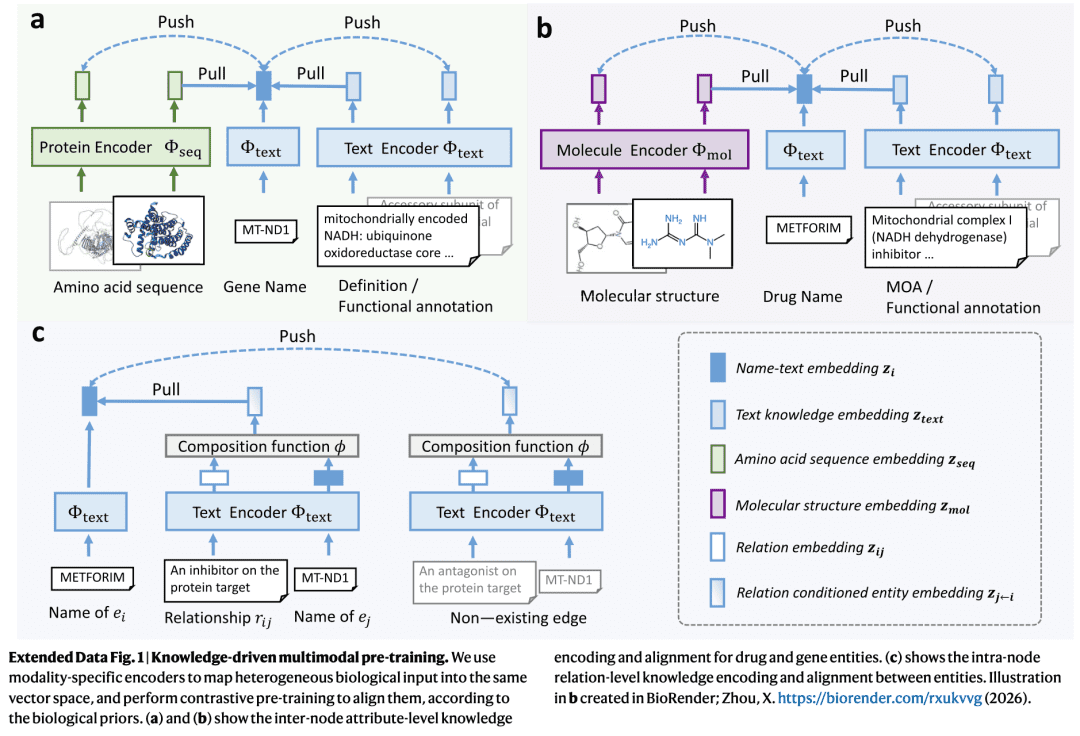
为了有效利用这些异构信息,MAP引入了一套专门设计的多模态对齐预训练策略。具体而言,研究者为不同模态分别部署专用编码器:图神经网络处理图谱拓扑,Transformer编码MOA文本,图卷积或GNN变体处理蛋白序列,而分子图神经网络(如MPNN)则负责SMILES结构。随后,通过对比学习目标函数,强制同一药物的不同模态表示在嵌入空间中彼此靠近,同时远离无关实体。更重要的是,模型在预训练中显式引入关系约束——例如,若药物A抑制基因B,则其嵌入向量应满足特定几何关系(如向量差近似于“抑制”关系向量)。这种机制感知的表示学习确保了即使面对全新化合物,只要提供其分子结构,模型即可在知识空间中准确定位其潜在作用机制。
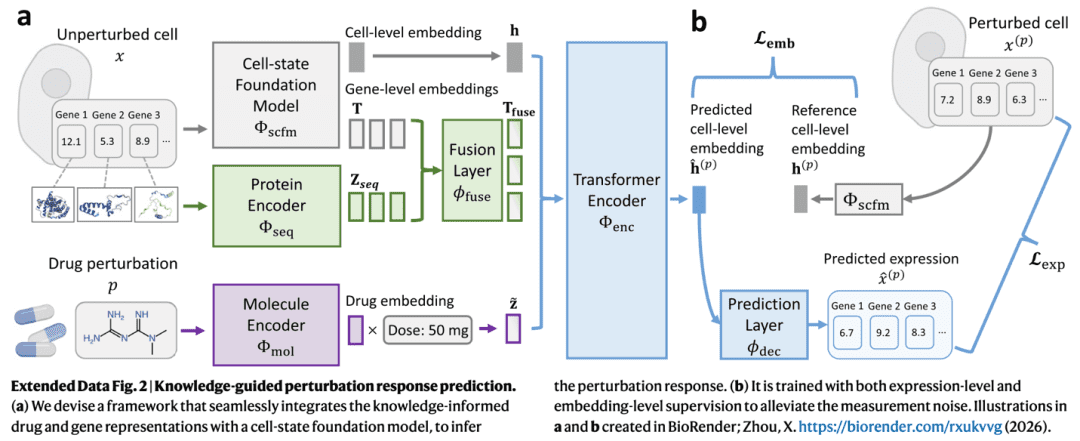
在扰动预测阶段,MAP以现有的单细胞基础模型(如scFoundation或类似架构)为骨干网络,但对其条件输入机制进行了根本性改造。传统模型通常将药物表示为one-hot ID向量,而MAP则用预训练得到的机制感知药物嵌入替代之。同时,基因的表示也由静态ID替换为融合了蛋白序列与图谱上下文的知识增强向量。整个预测流程以未扰动细胞的基因表达谱为输入,通过多层双向注意力Transformer编码器,在知识条件的引导下解码出扰动后的表达状态。这种设计使得模型不再依赖药物是否在训练集中出现过,而是依据其内在机制进行推理。
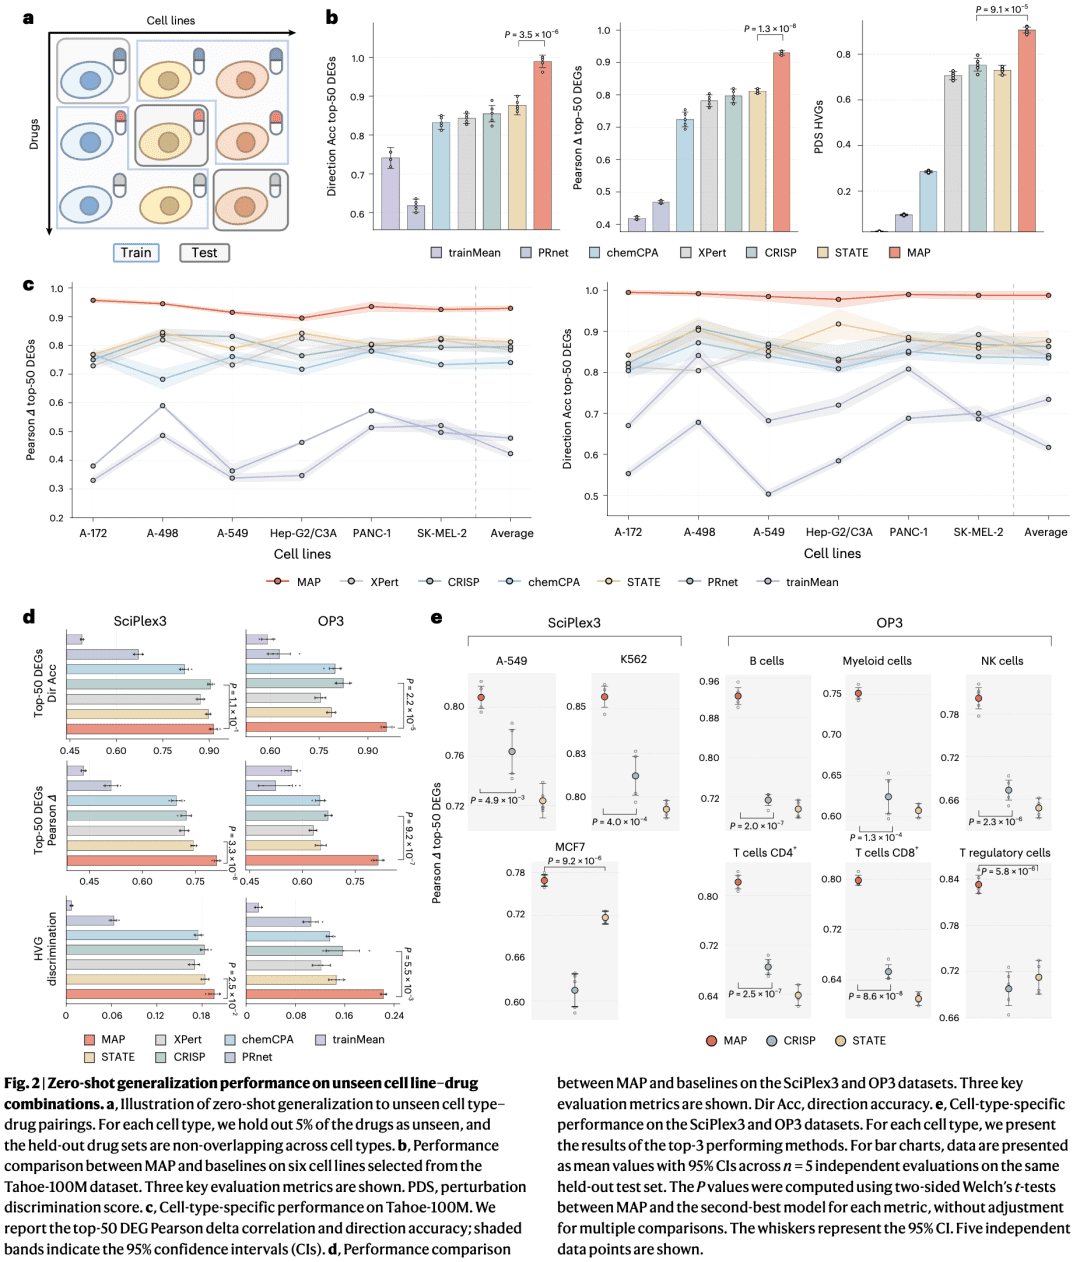
为验证MAP的零样本泛化能力,研究团队设计了两类极具挑战性的评估场景。第一类为“未见细胞类型-药物组合”任务,模拟药物重定位场景:模型在训练中仅见过某药物在特定细胞系(如K562)的作用,需预测其在另一细胞系(如A549)中的响应。在Tahoe-100M数据集上,MAP在Top-50差异表达基因(DEG)的Pearson相关性指标上较当前最优基线CRISP提升13.3%,且在调控方向(上调/下调)的预测准确率上优势更为显著。这表明MAP不仅捕捉到表达幅度的变化,更理解了细胞类型特异性的调控逻辑。
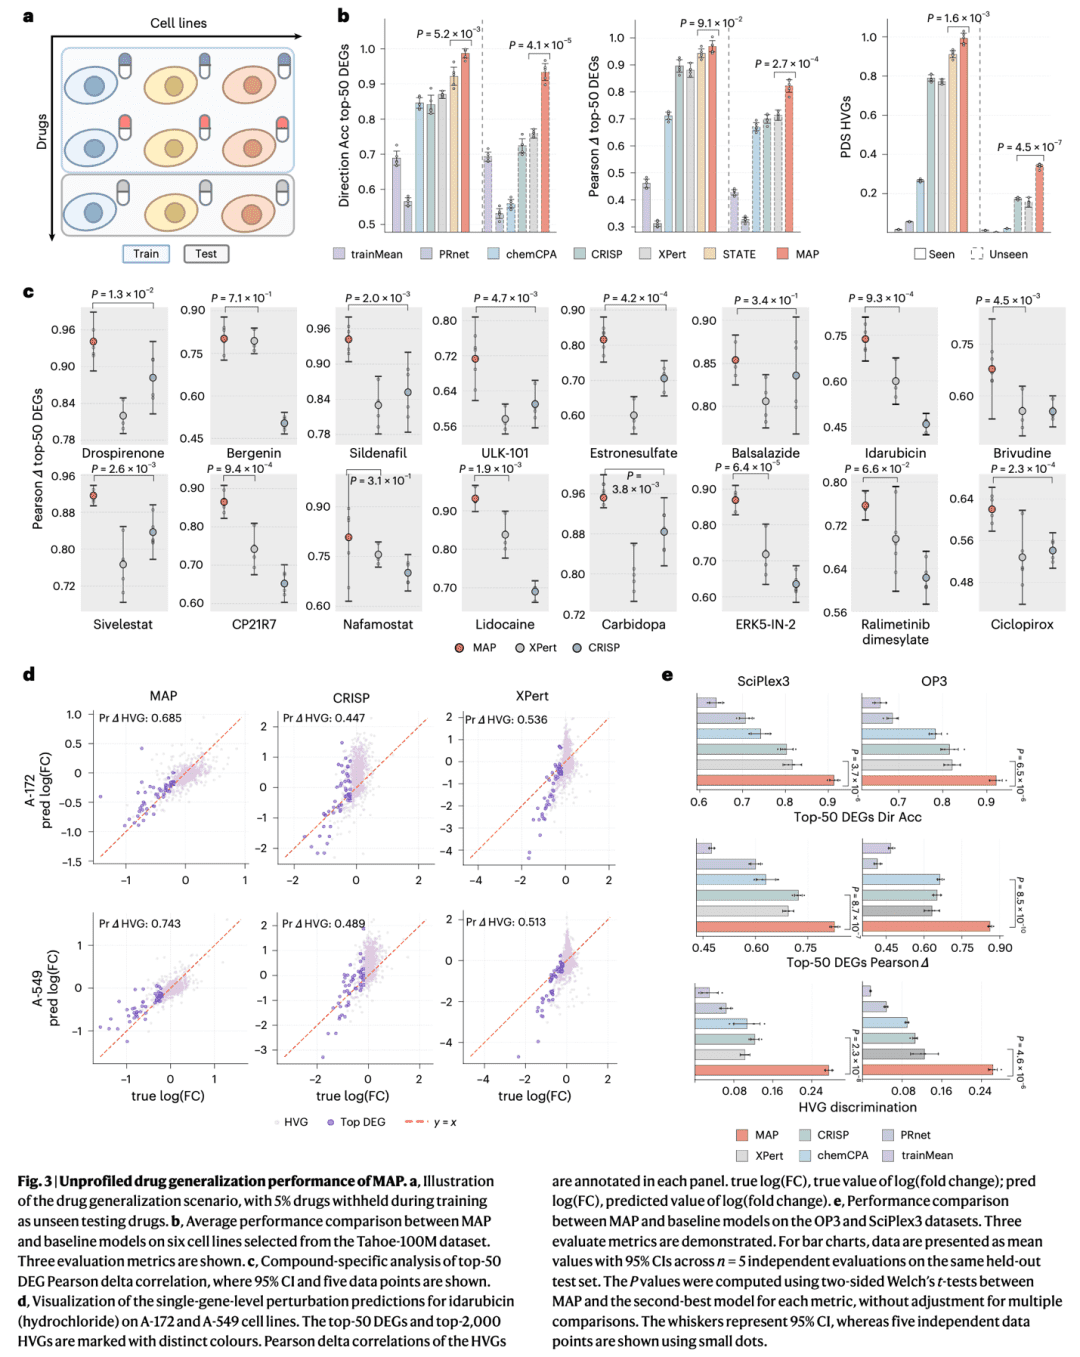
更具突破性的是第二类任务——“完全未表征药物”的零样本预测。在此设置中,测试药物的所有扰动数据及其在知识图谱中的直接关联节点均被移除,模型仅能通过输入该药物的SMILES字符串进行“盲猜”。结果显示,MAP在Tahoe-100M上仍能实现12.2%的相关性提升和21.0%的方向准确率增益。这一结果彻底打破了“无数据则无预测”的传统局限,证明模型确实学会了从分子结构推断生物学效应的泛化能力。
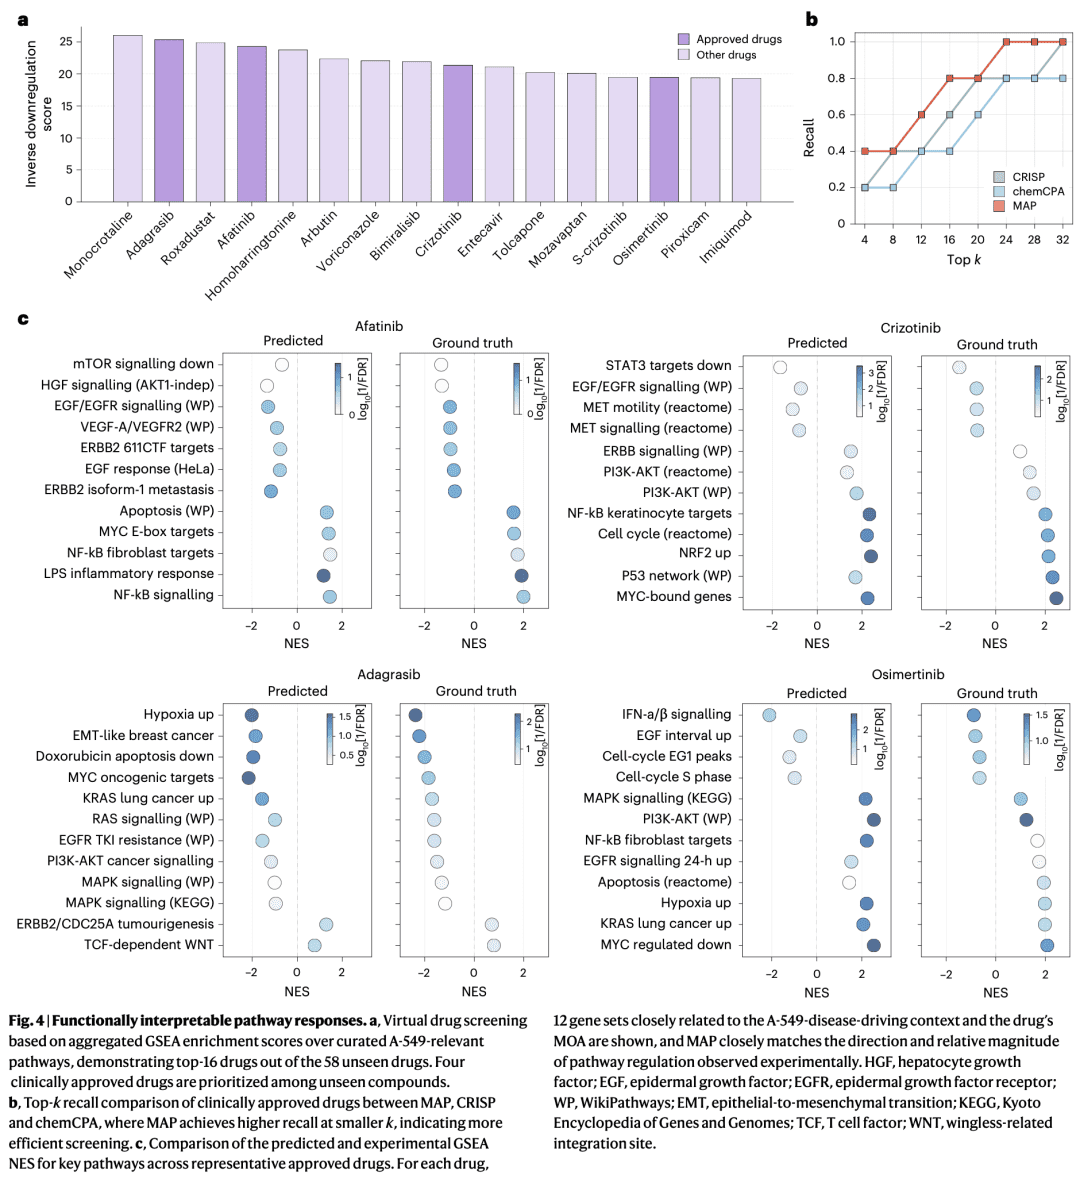
为进一步检验预测结果的生物学合理性,研究团队开展了通路层面的一致性分析。通过对预测表达谱进行GSEA(Gene Set Enrichment Analysis),发现MAP所识别的富集通路与已知药物机制高度吻合。例如,在预测EGFR抑制剂作用时,MAP显著激活了“EGFR酪氨酸激酶抑制剂耐药性”通路;对于HDAC抑制剂,则正确富集了“组蛋白乙酰化调控”相关基因集。这种通路一致性不仅增强了结果的可信度,也为机制解释提供了新工具。
在实际应用层面,MAP展示了强大的虚拟筛药潜力。研究者针对非小细胞肺癌细胞系A549,对58个候选化合物进行虚拟筛选。结果显示,在预测响应最强的前15个药物中,MAP成功命中了5个已获批用于肺癌治疗的药物中的4个(包括吉非替尼、厄洛替尼等EGFR抑制剂)。相比之下,传统ID驱动模型因无法处理未见药物而完全失效。这一案例直接证明MAP可作为高通量初筛引擎,优先推荐具有潜在疗效的化合物进入后续实验验证。
MAP的成功不仅体现在性能指标上,更在于其揭示了一条新的AI for Science发展路径。长期以来,深度学习在生物医学领域的进步主要依赖“数据规模”和“模型参数”两大维度。而MAP通过实验证明,“知识规模”——即注入先验知识的广度与深度——构成了第三大核心驱动力。当知识图谱从稀疏子集扩展至完整MAP-KG时,模型性能呈现持续增长趋势,验证了“知识扩展定律”的存在。这意味着未来虚拟细胞的发展不应仅追求更大模型或更多测序数据,更需系统性地整合多源异构知识,构建机制完备的数字孪生体。
此外,MAP框架具有良好的可扩展性。其知识图谱可随新数据库发布而动态更新,多模态对齐模块亦可纳入更多数据类型(如3D蛋白结构、单细胞空间转录组等)。未来,结合生成式AI技术,MAP甚至可能反向指导新药设计——通过优化分子结构使其在机制空间中靠近理想靶点区域,从而生成具有预期扰动效应的候选化合物。
当然,MAP仍面临若干挑战。例如,当前知识图谱虽大规模,但仍存在覆盖不全问题,尤其对于罕见靶点或新型作用机制;多模态对齐的精度也受限于各模态数据的质量与噪声水平。此外,模型对复杂多靶点药物或协同用药的预测能力尚需进一步验证。但这些问题恰恰指明了下一步的研究方向:构建更全面的知识基础设施、开发更鲁棒的跨模态融合算法、拓展至组合扰动建模等。
综上所述,MAP框架通过将生物学先验知识深度融入单细胞扰动预测流程,成功突破了虚拟细胞长期受限于实验数据稀缺的瓶颈。它不仅是一项技术成果,更是一种范式革新——从“数据拟合”走向“机制推理”,从“复现已知”迈向“探索未知”。随着知识驱动AI在生命科学领域的深入应用,一个真正能够加速药物发现、理解疾病机制、个性化治疗的智能生物计算时代正在加速到来。