启发学习:让大模型在推理中复用跨域经验的新范式
近年来,大型语言模型(LLMs)在代码生成、信息检索和复杂推理等任务上展现出惊人能力。然而,这种“智能”很大程度上建立在人为构建的外部脚手架之上——从RAG(Retrieval-Augmented Generation)到Function Calling,再到复杂的Agent工作流,系统通过预设流程将任务拆解、调用工具、整合结果。这种方式虽有效支撑了当前AI应用的繁荣,却也暴露出根本性局限:模型本身并未真正“学会”如何解决问题,而是被动执行人类设计的指令链。

一旦场景变更或工具更新,整个流程往往需要重新设计提示词、调整权限配置甚至重构知识库。更关键的是,大量知识被固化在外部流程中,未能内化为模型自身的认知能力。这导致系统看似强大,实则脆弱,缺乏真正的泛化与适应性。面对这一困境,我们亟需一条新路径:让模型在面对新问题时,能够自主调用过往解决类似问题的经验,实现“举一反三”的认知跃迁。
受人类智慧演进方式的启发——科学史上的重大突破极少凭空而来,更多是通过类比、迁移与重组已有知识结构实现——我们提出“启发学习”(Inspirational Learning)这一全新范式。其核心思想是:在推理过程中,模型不应仅依赖当前输入和静态知识库,而应主动检索经验库中结构相似的旧问题及其解决思路,并将这些“启发性经验”注入当前推理过程,最终将新获得的有效推理链抽象沉淀回经验库,形成持续进化的认知飞轮。
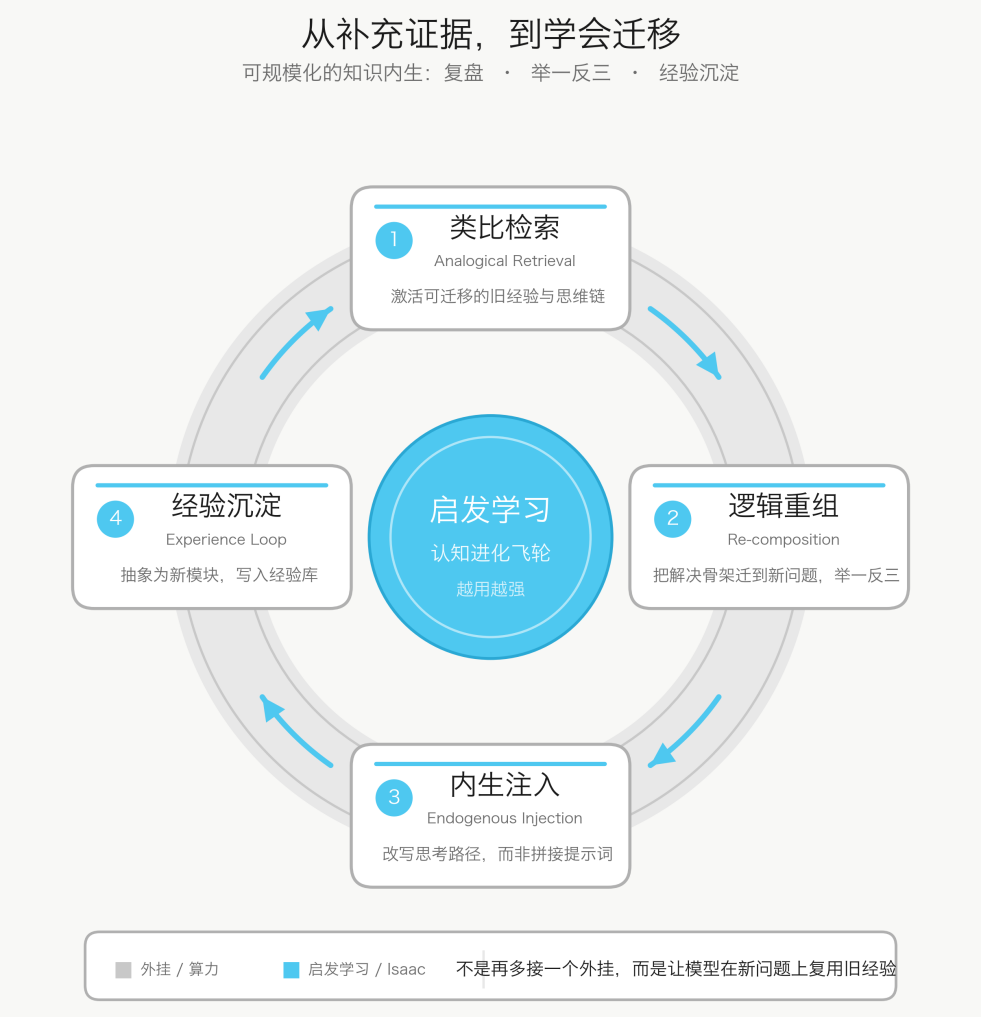
该范式包含四个关键环节:首先是类比检索(Analogical Retrieval),系统不再基于字面语义或关键词匹配,而是寻找在问题结构、推理逻辑或解决策略上相似的历史案例;其次是逻辑重组(Re-composition),将检索到的跨域经验进行抽象提炼,去除领域特异性细节,保留通用推理骨架;接着是内生注入(Endogenous Injection),将重组后的启发性知识以特定方式融入当前输入,引导模型生成更优解;最后是经验沉淀(Experience Loop),将本次成功解决新问题的完整思维链进行泛化处理,存入经验库供未来调用。这一闭环机制使得模型的认知能力得以在使用中不断积累和进化。
为实现这一构想,我们构建了名为Isaac的推理侧增强框架(取名自牛顿“站在巨人肩膀上”的典故),其最大特点是无需修改基座模型权重,亦无需额外训练。Isaac通过两种互补的技术路径实现经验注入:Prompt注入与网络层注入。
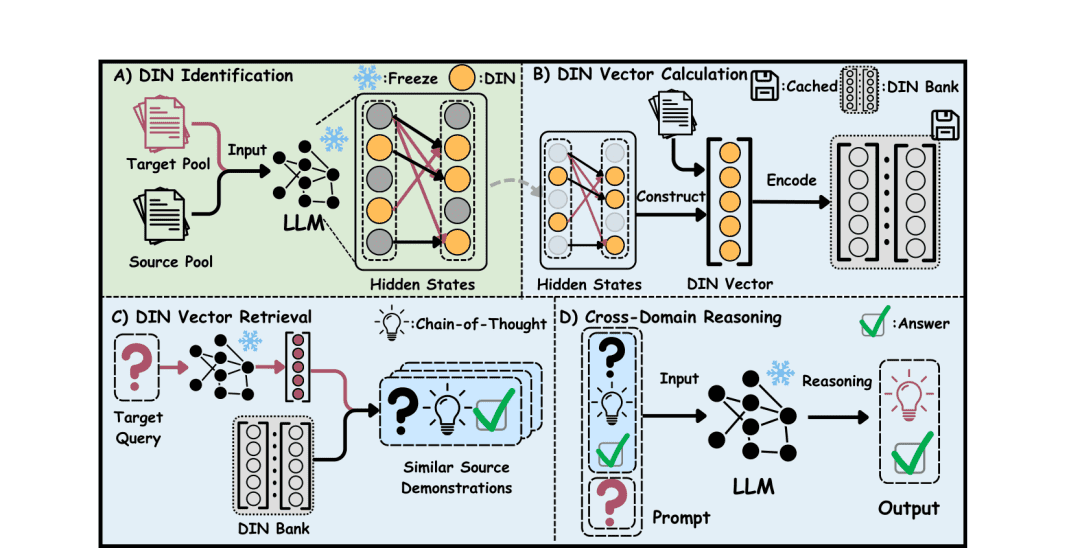
在Prompt注入路径中,我们提出了域不变神经元检索(Domain-Invariant Neuron Retrieval, DIN)。传统基于文本嵌入的检索方法在跨域场景下效果有限,因为不同领域的表述差异巨大。DIN转而关注模型内部的神经元激活模式。具体而言,在源域(有标注数据)和目标域(无标注)上分别运行输入,计算各token的隐状态均值,再对每个神经元维度计算z-score标准化值。那些在两个域中激活极性一致且幅度显著的神经元,被视为“域不变神经元”,它们编码了超越具体语言表层的通用语义或推理信号。仅使用这些维度构建低维向量,在子空间中通过余弦相似度检索最相关的源域示范案例,并利用MMR(Maximal Marginal Relevance)算法去重,确保多样性。最终,这些精选的跨域示范被拼接到目标查询的上下文中,供冻结的基座模型进行推理。
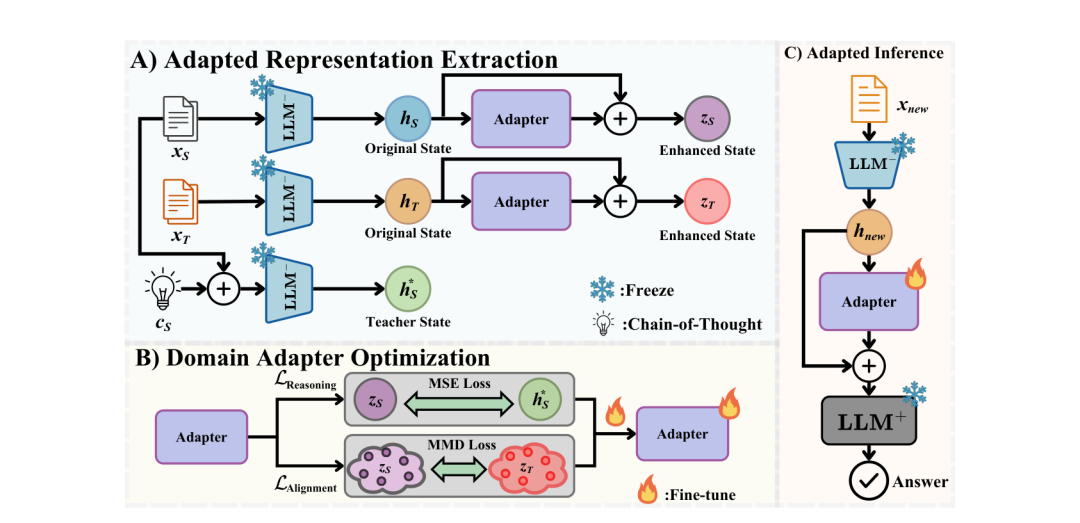
然而,仅靠上下文提示有时不足以弥合源域与目标域之间的深层表征鸿沟。为此,我们开发了网络层注入路径——思维链引导的域适配(Chain-of-Thought guided Domain Adaptation, CoDA)。CoDA在冻结的大模型中间层插入一个轻量级可训练适配器(Adapter),以残差方式调制隐状态:增强态 = 原始隐状态 + Adapter输出。训练阶段,源域输入配以完整的思维链(Chain-of-Thought)作为“教师信号”,生成教师隐状态;同时,源域和目标域的原始输入经Adapter后得到“学生”增强态。优化目标包含两项损失:一是均方误差(MSE),迫使源域增强态逼近教师态,从而学习到高质量的推理表征;二是最大均值差异(MMD),用于对齐源域与目标域增强态的分布,减少域偏移。推理时,仅需对目标输入通过Adapter即可获得适配后的表征,无需目标域的思维链标注。这种方法将知识迁移从表面的提示层面深入到模型内部的表征空间。
为全面评估启发学习的有效性,我们在四个具有挑战性的公开基准上进行了实验:HumanEval(函数级代码生成)、StrategyQA(隐式多跳推理)、ScienceQA(图文结合的科学问答)以及SciCode(真实科研场景下的编程任务)。这些任务覆盖了从精确逻辑推导到跨模态理解、从通用编程到专业领域编码的广泛能力谱系。
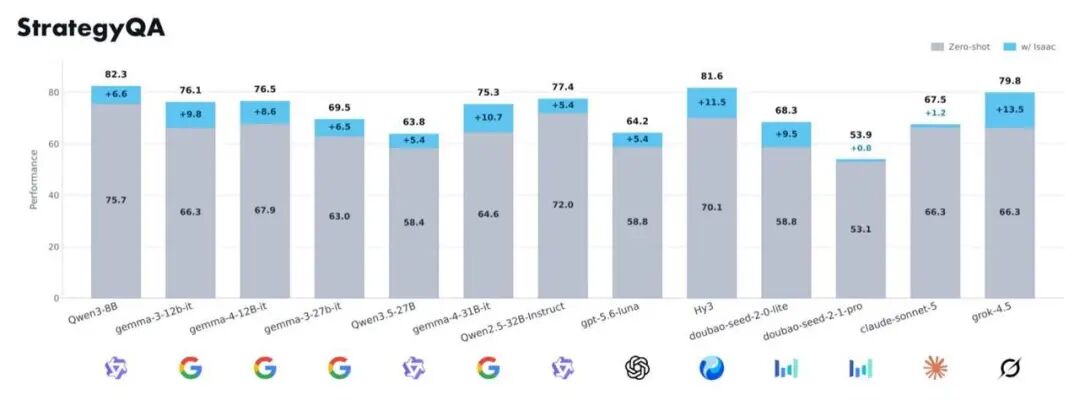
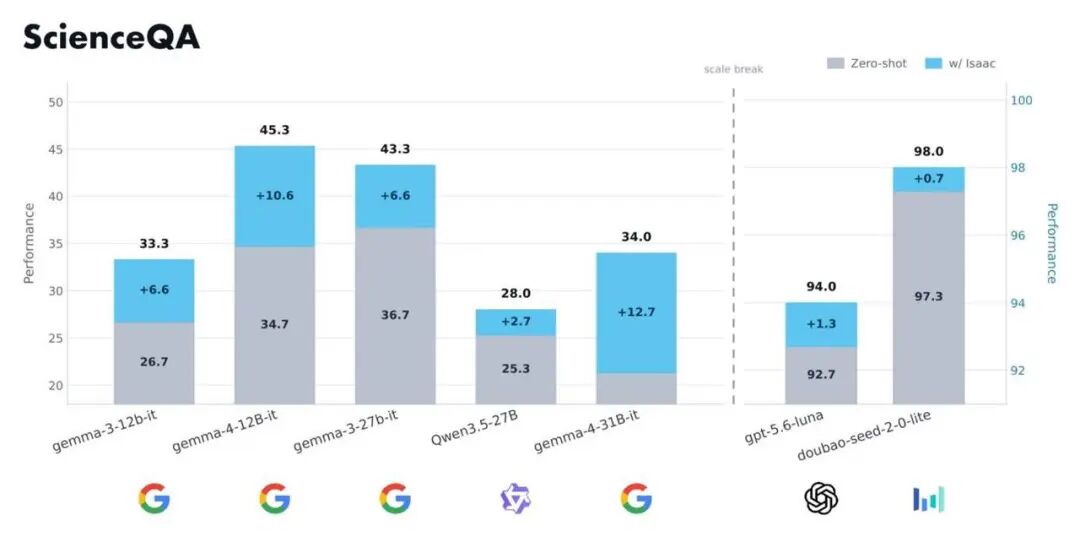
实验结果显示,接入Isaac框架后,多个主流大模型在各项任务上均取得显著提升。在HumanEval上,Claude模型达到100.0%的通过率,远超此前公开榜单约95.1%的记录;在StrategyQA上,Qwen3-8B模型得分达82.3%,接近当前最优水平;ScienceQA方面,Doubao模型准确率高达98.0%,大幅领先于约91.3%的先前最佳结果;而在SciCode等科研编程任务中,多家模型也展现出稳定的正向增益。值得注意的是,增益幅度与模型原始能力呈负相关:相对 weaker 的模型往往获得更大的绝对提升。例如,Grok-4.5在StrategyQA上提升13.5个百分点,Gemma-4-31B在ScienceQA上提升12.7个百分点,14B级别模型在HumanEval上平均提升8.5个百分点。这表明启发学习特别有助于释放中等规模模型的潜力,为其提供一种低成本、高效益的能力增强路径。
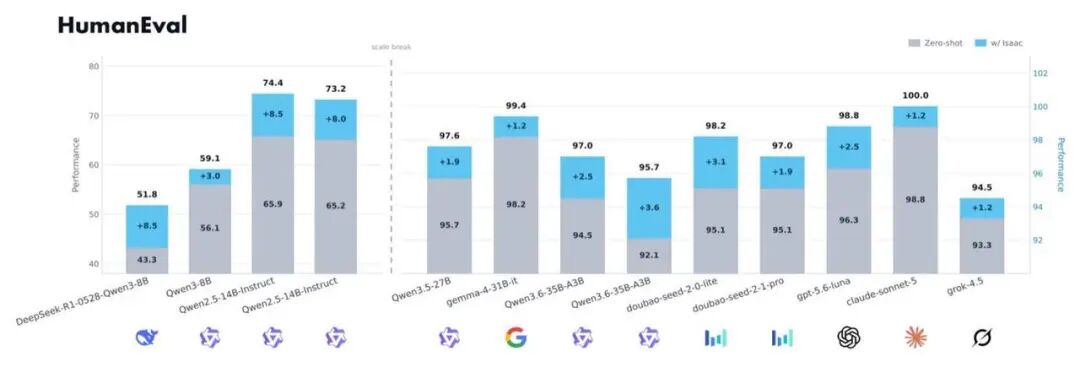
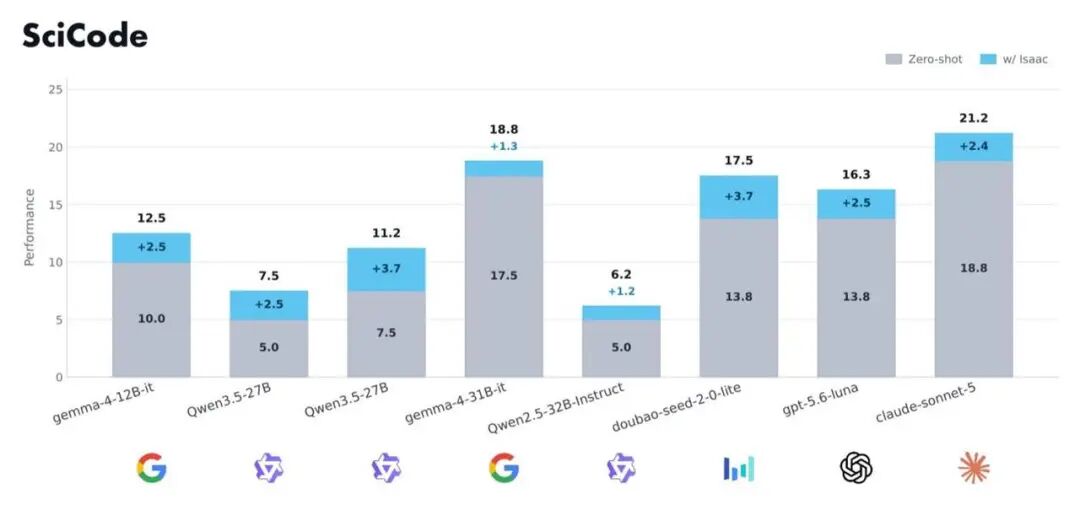
这些结果有力证明,大模型性能的提升并非只能依赖预训练数据的扩展或参数规模的堆砌。在推理侧引入结构化的经验复用机制,同样能带来实质性突破。更重要的是,这种方法具备良好的普适性和可组合性——DIN与CoDA可单独使用,也可协同工作;适用于有无目标域标注的不同场景;且完全兼容现有模型部署流程。
从更宏观的视角看,启发学习试图解决的不仅是技术指标的提升,更是AI系统认知范式的转变。当前主流方案将模型视为“工具调用引擎”,而启发学习则致力于将其塑造为“经验复用者”。它让模型在解决新问题时,不仅能查阅资料、调用API,更能“回想”过去如何解决类似难题,借鉴其思路并加以改造。这种能力更接近人类的学习本质:不是记住所有答案,而是掌握解决问题的通用方法论。
未来,随着经验库的不断丰富和检索-注入机制的持续优化,启发学习有望在更复杂的开放域任务中发挥作用,例如长期规划、跨学科研究辅助或动态环境中的决策制定。它也为构建具备持续学习能力的AI系统提供了新思路——无需频繁微调或重训,仅通过推理过程中的经验沉淀与复用,即可实现认知能力的渐进式进化。
外挂工具和算力投入仍将是AI发展的重要驱动力,但与此同时,将“复盘”与“举一反三”内化为模型的稳定能力,或许才是通向真正智能的关键一步。启发学习正是朝这一方向迈出的坚实尝试,它不仅是一种技术方案,更是一种关于AI如何学习、如何思考的新哲学。