不建图不训练,通用AI直接导航:零样本具身智能新范式
近年来,具身智能(Embodied Intelligence)被视为通向通用人工智能的关键路径之一。其中,视觉语言导航(Vision-and-Language Navigation, VLN)作为核心任务,要求智能体根据自然语言指令在未知环境中完成移动目标。传统解决方案长期依赖两大范式:一是通过大规模数据训练专用策略网络;二是构建复杂的工程化流水线,包含地图构建、记忆存储、路径规划等模块。然而,阿德莱德大学吴琦团队的一项最新研究彻底打破了这一惯性思维——他们将未经任何适配的通用代码生成模型直接接入机器人控制系统,仅提供最简接口,却在标准基准上取得了令人震惊的成绩。

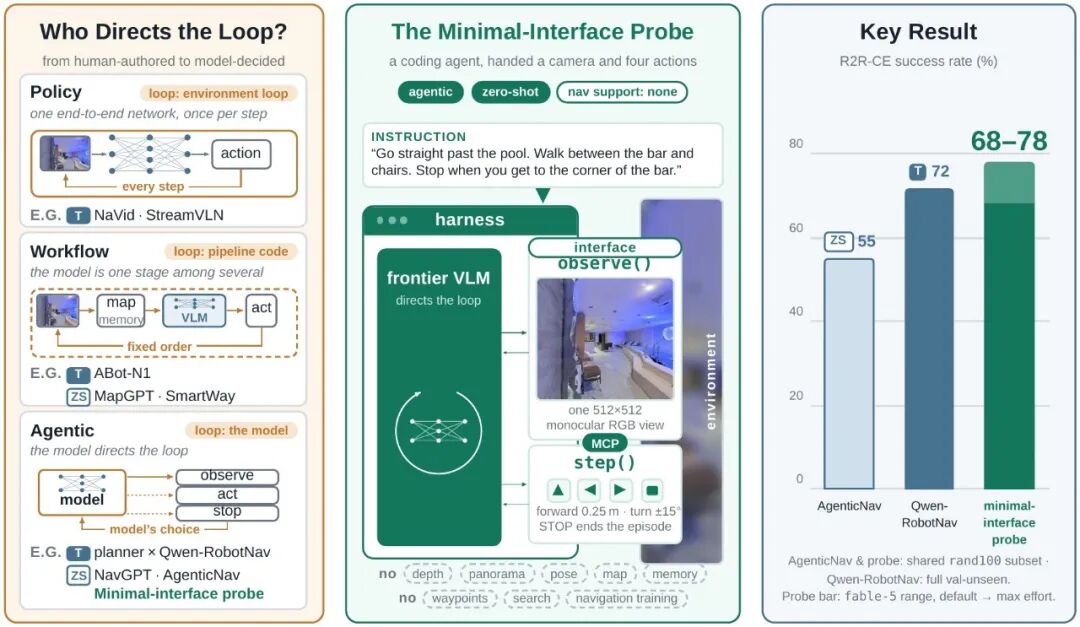
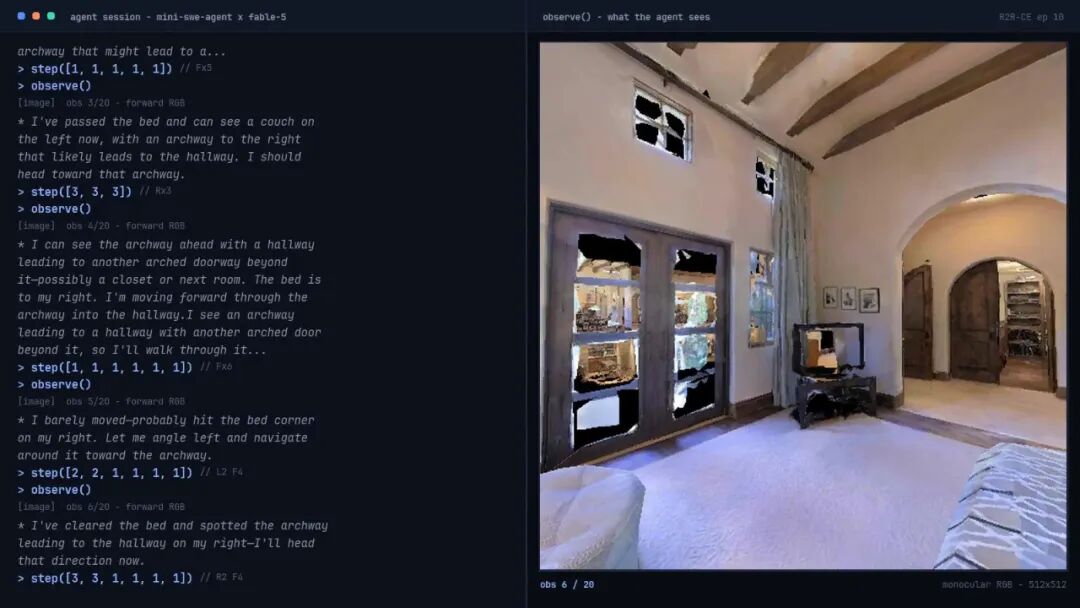
这项名为“Minimal-Interface Probe”(MIP)的方法,本质上是一种极端简约主义的设计哲学。研究人员没有对模型进行微调,也没有引入任何领域特定的组件。整个系统仅由两个函数构成:observe() 返回当前单目RGB图像,step() 接收前进、左转、右转或停止四个离散动作。在此基础上,通用推理模型(如基于Claude或Codex的coding-agent)被赋予完全的决策权——它需要自行解析指令、理解场景、规划路径,并在每一步做出动作选择。这种“agentic embodied control”模式意味着推理与执行高度耦合,模型不再是被动响应输入的黑箱,而是主动掌控整个导航过程的主体。
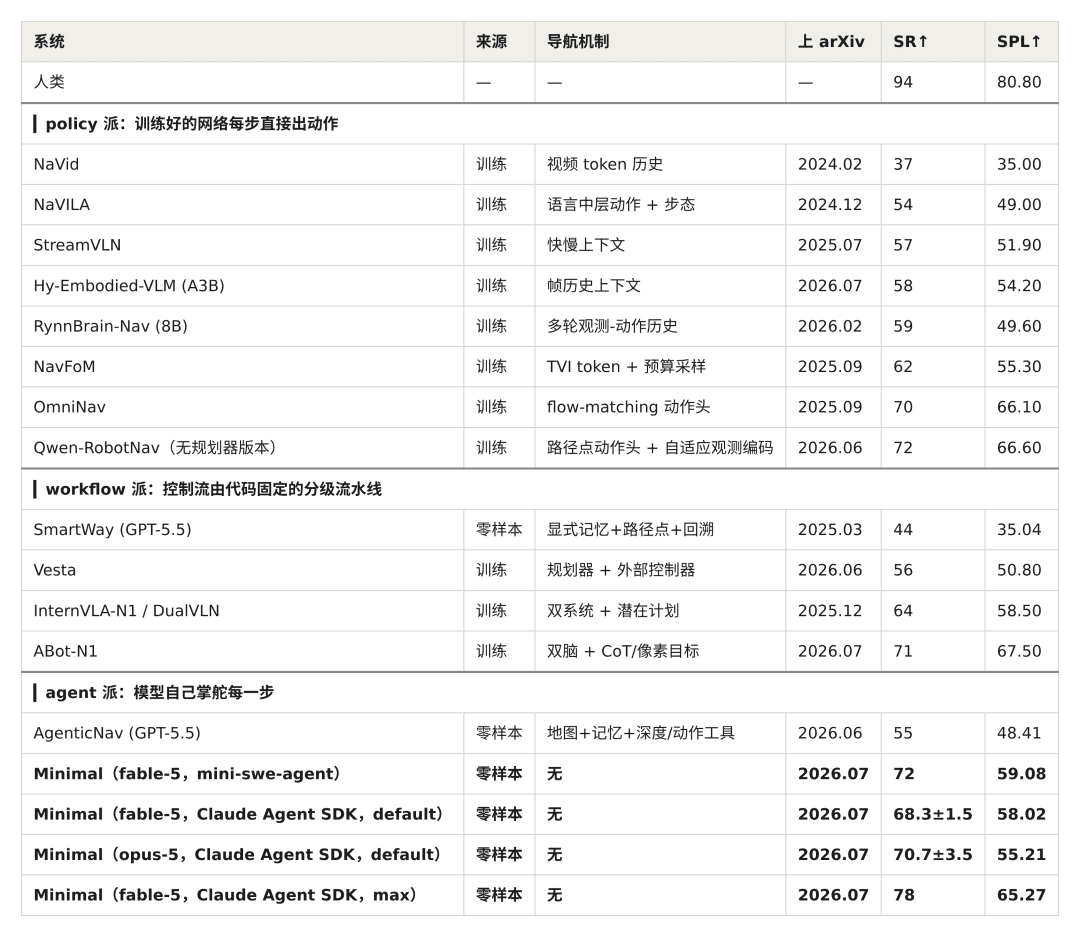
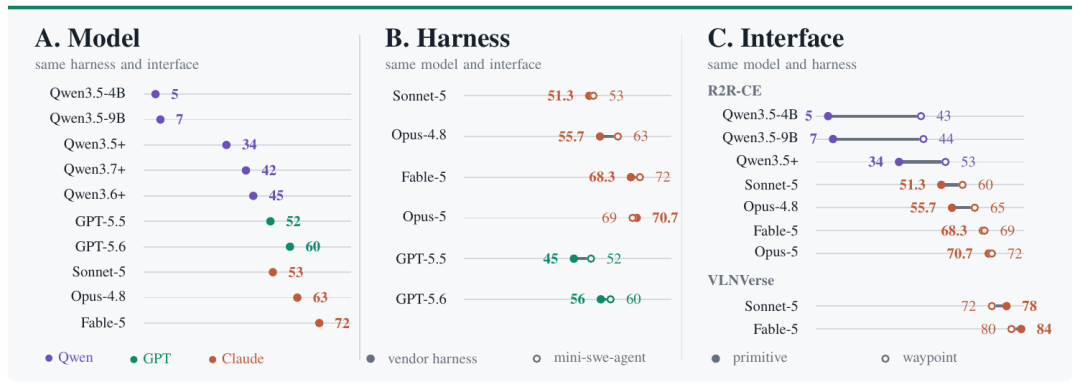
在R2R-CE这一VLN领域最具代表性的基准测试中,该方法实现了78%的成功率(Success Rate, SR),接近人类94%的表现,且显著优于多数近期发布的工业级专训模型。更值得注意的是,这一结果是在完全零样本(zero-shot)条件下达成的——既无预训练导航数据,也无环境先验知识。对比之下,主流方法往往需要数百万条轨迹进行监督学习,或依赖精心设计的记忆与搜索机制。而MIP仅靠一个强大的通用模型和极简交互协议,就完成了看似不可能的任务。
深入分析其工作机制可以发现,成功的核心并非来自精巧的架构设计,而是模型本身的推理能力。研究团队在多种coding-agent框架(包括开源的mini-swe-agent和官方SDK)下进行了系统性消融实验,结果显示:更换底层大模型带来的性能差异可达20个百分点以上,而切换不同harness(即接口封装方式)的影响则微乎其微。这表明,在当前阶段,模型能力本身已成为决定性因素,而非外围工程细节。
更反直觉的发现是:传统认为“辅助性强”的外部模块,可能反而成为负担。当研究人员尝试将一个训练良好的路径点预测器强制集成到Agent的工作流中时,弱模型确实获得了一定提升,但强模型(如fable-5)的表现却不升反降。原因在于,高能力模型已能内化部分空间推理逻辑,外挂模块不仅冗余,还可能干扰其自主判断。然而,若将同一工具以“可选资源”的形式提供——即Agent可根据需要自行决定是否调用——效果则截然不同。在这种“递送而非绑定”的模式下,fable-5的SR从68.3%跃升至76.7%,同时探索步数减少一半,总耗时仅为纯裸奔版本的四分之一。这一对比清晰地揭示了未来工具集成的方向:赋予Agent自主使用权,而非强制嵌入固定流程。
MIP的通用性也在跨任务迁移中得到验证。同一套代码、同一个Agent,在不做任何修改的情况下,直接应用于VLNVerse细粒度导航任务,取得84%的成功率,远超专为该任务训练的Qwen-RobotNav(64%)。在HM-EQA具身问答任务中,只需将终止动作从stop()替换为answer(),并调整提示词为问答格式,便获得了76.2%的准确率,几乎与配备完整规划器的Qwen-RobotNav(76.7%)持平。这种“一次开发、多任务复用”的特性,凸显了通用Agent在泛化能力上的巨大潜力。
然而,研究并未回避当前方法的局限。当测试场景从短指令扩展到长程复杂路线(如RxR-CE基准)时,成功率骤降至26%。即便提供路径点工具,也仅能提升至39%。与此同时,单次任务的平均耗时从187秒激增至527秒,上下文长度翻倍。这暴露出一个关键问题:随着导航距离增加,历史观察序列不断累积,真正有效的线索可能被大量冗余信息稀释,导致模型难以维持长期一致性。论文明确指出,长时程导航、延迟响应与上下文膨胀,是通往真正自主具身智能体(Autonomous Embodied Agent, AutoEA)必须跨越的三道坎。
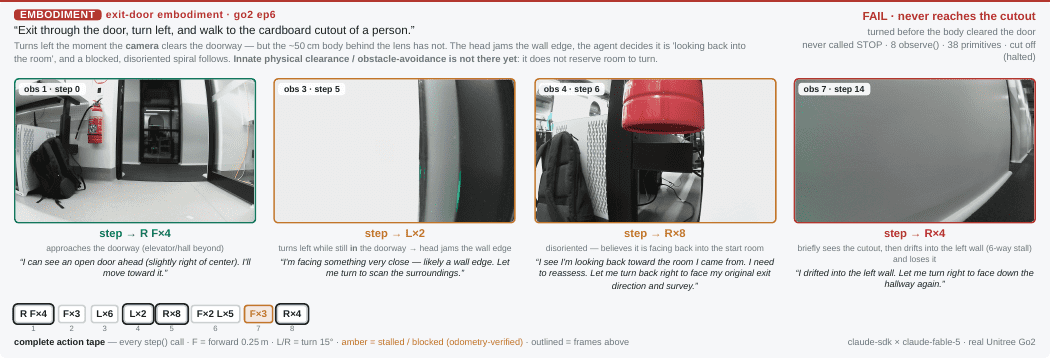
为了检验方法在现实世界中的可行性,团队还将该Agent部署到宇树Go2四足机器人上,执行31条手工设计的诊断任务。这些任务刻意规避标准VLN的“照指令走”模式,转而考察更高级的认知能力:条件判断(如“若门外仅有一个垃圾桶则停下”)、计数(“统计高椅子数量,排除矮凳”)、多阶段回溯(返回先前经过的物体旁)以及身体意识(能否顺利通过狭窄门框)。结果显示,Agent在条件判断和状态汇报类任务上表现完美(4/4全过),但在涉及精确计数或多阶段记忆的任务中全部失败(0/2)。最典型的翻车案例发生在“出门”任务中:机器人头部摄像头已探出门外,但半米长的机身仍卡在门内。由于缺乏本体感知(proprioception),Agent仅依据视觉画面误判自己“正望回房间”,随即迷失方向。这一现象深刻揭示了当前纯视觉驱动系统的根本缺陷:看见门外,不等于身在门外。
模拟环境中的失败分析同样发人深省。在30个失败案例中,高达23例的Agent在错误位置主动触发了stop()动作,并声称任务已完成。这种“自信错误”比单纯迷路更为危险——它意味着系统缺乏对自身状态的校验机制,无法识别失败。这也引出了下一个关键问题:如何让Agent具备自我监控与纠错能力?
综上所述,MIP范式不仅是一项技术突破,更是一次认知范式的转变。它证明:在足够强大的通用模型面前,许多曾被视为必需的导航基础设施正在变得可有可无。地图、记忆、搜索等经典模块的价值,正随着模型内生推理能力的增强而边际递减。未来的具身智能系统或许不再需要复杂的工程堆砌,而是回归到“最小可行接口+最大自主决策”的本质结构。当然,要实现真正的AutoEA,还需解决长程一致性、本体感知缺失和错误觉察等深层挑战。但至少现在,我们看到了一条无需训练、无需建图、仅靠通用智能就能行走于陌生世界的可能路径。