Gemini Omni 1.1 Flash深度解析:视频生成的连续性、可控性与效率革命
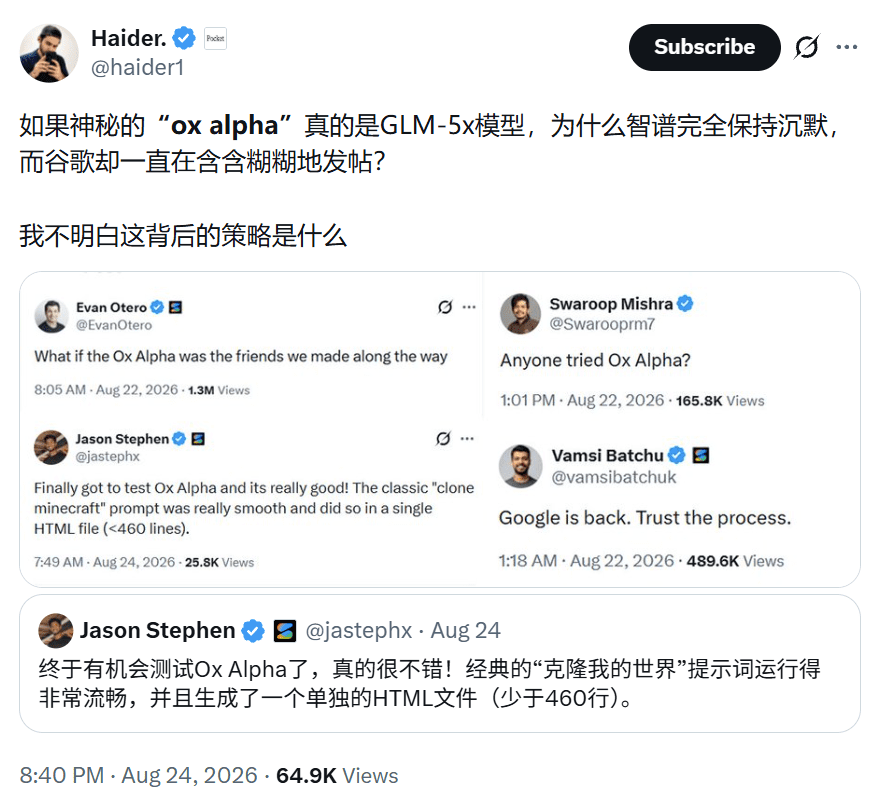
近期,人工智能视频生成领域迎来一次关键性迭代——谷歌DeepMind正式推出Gemini Omni 1.1 Flash。尽管发布时机恰逢国产大模型GLM-5.3-Flash(被误传为“牛来模型”)引发热议,导致初期关注度被部分分流,但Omni 1.1 Flash凭借其在视频生成流程中的系统性优化,展现出不容忽视的技术实力。该模型并非追求单一指标的突破,而是聚焦于创作者实际工作流中的痛点,围绕连续性、可控性与迭代效率三大维度进行深度打磨。
场景延展:从片段拼接到连贯叙事的关键跃迁
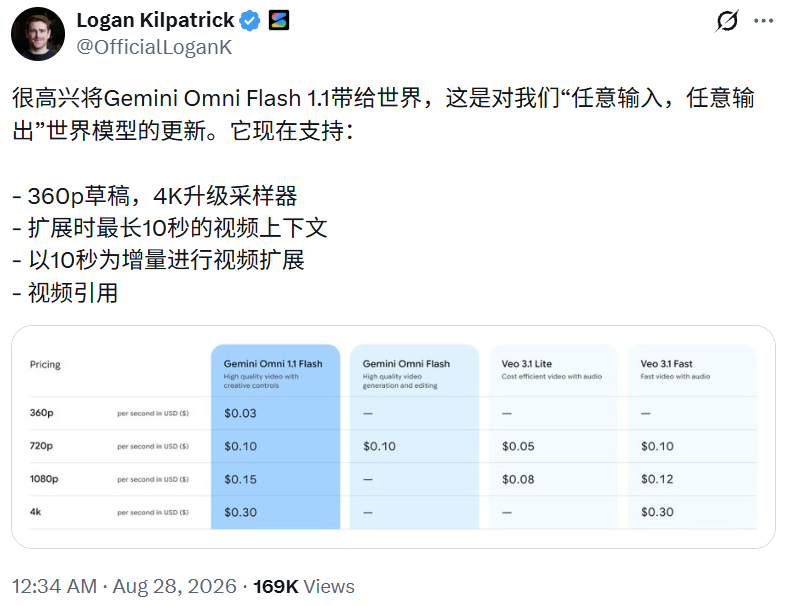
传统AI视频生成模型普遍受限于上下文窗口长度,往往只能生成孤立的几秒片段,难以支撑具有情节推进或角色互动的连续内容。Gemini Omni 1.1 Flash在此方面取得显著进展:它能够读取最多10秒的前序视频作为上下文,并在此基础上生成后续画面。单次扩展10秒,通过多次迭代,累计可生成长达40秒的连贯视频。
这一能力的意义远超时长本身。更长的上下文意味着模型能获取更丰富的语义信息,包括人物姿态的连续变化、场景中物体的空间关系、镜头运动的轨迹以及剧情发展的逻辑脉络。例如,在一段对话场景中,模型不仅能保持角色面部表情和口型的一致性,还能理解对话节奏,使镜头切换与台词同步。谷歌展示的案例中,同一场景实现了从近景对话到镜头后拉展现环境,再到空间转换的流畅过渡,人物与背景的相对位置始终保持合理,避免了常见的“漂移”或“突变”问题。
对于需要多段生成的复杂项目——如短视频剧集、产品功能演示或影视预演——这种场景延展能力直接决定了最终成片的专业度与可用性。创作者不再需要手动拼接多个不连贯的片段,而是可以像编写剧本一样,分阶段引导模型生成具有内在逻辑的连续画面。
首尾帧控制:赋予创作者镜头级的精准调度权
如果说场景延展解决了“时间连续性”,那么首尾帧控制则解决了“空间与运动可控性”。Omni 1.1 Flash允许用户指定一个镜头的起始画面(首帧)和结束画面(尾帧),由模型智能补全中间的过渡动画。这项功能本质上将视频生成从“黑箱输出”转变为“参数化编排”。
在实际应用中,这一能力极具价值。例如,要制作一个环绕角色的镜头,用户只需提供角色正面和背面的图像作为首尾帧,模型即可生成平滑的环绕路径;若需实现推轨变焦效果,则可设定广角起始帧与特写结束帧。此外,该功能也适用于快速转场(如匹配剪辑)和循环视频(首尾帧相同)等专业镜头语言。这不仅提升了生成结果的可预测性,也让非专业用户能够借助AI实现原本需要复杂摄影设备才能完成的运镜效果。
值得注意的是,首尾帧控制并非简单插值。模型需理解两帧之间的语义关联、物理运动规律及视觉连贯性,避免出现穿帮或逻辑断裂。从谷歌公布的样片来看,过渡过程自然流畅,光影变化与运动模糊处理得当,显示出强大的时空建模能力。
360p草稿模式:重构AI视频创作的试错成本结构
AI视频生成的一大瓶颈在于高昂的试错成本。每一次高分辨率生成都消耗大量算力与时间,而创意探索阶段恰恰需要频繁调整提示词、构图、动作或镜头参数。Omni 1.1 Flash引入的360p草稿模式,正是对这一痛点的精准回应。
官方数据显示,360p模式的系统吞吐速度最高可达720p的1.6倍,生成成本仅为后者的三分之一。这意味着创作者可以在相同时间内生成更多方案,大幅加速创意筛选过程。谷歌在演示中构建了一个名为“Draft Room”的工作流:用户一次性提交多个变体请求(如不同角色动作、不同镜头角度),系统并行输出多个360p版本,供用户横向比较、快速决策。选定最优方向后,再调用高分辨率模式进行最终渲染。
这种“低清探索—高清定稿”的双阶段流程,不仅符合人类创意工作的认知习惯,也显著提升了资源利用效率。尤其对于广告公司、短视频团队等需要快速产出多版方案的机构,360p草稿模式有望成为标准工作环节。
4K输出与多模态参考:打通从概念到成片的最后一公里
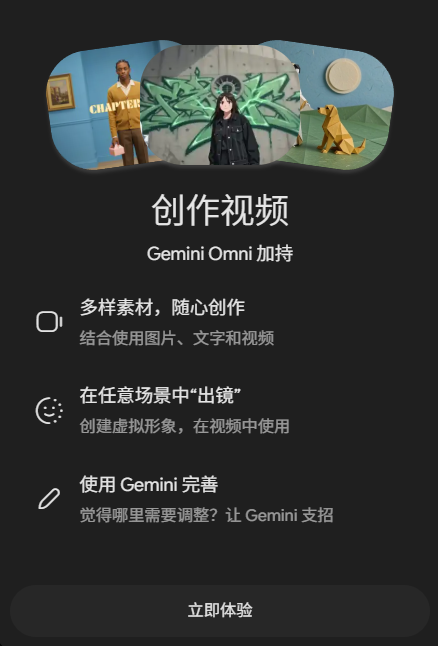
在输出端,Omni 1.1 Flash支持将视频提升至1080p乃至4K分辨率。4K能力的加入,使其不再局限于社交媒体预览或内部参考,而是能够直接用于广告素材、品牌宣传片、产品高清展示等对画质有严苛要求的商业交付场景。高分辨率输出配合精细的细节生成能力(如纹理、光影、材质),让AI视频真正具备了“成片级”质量。
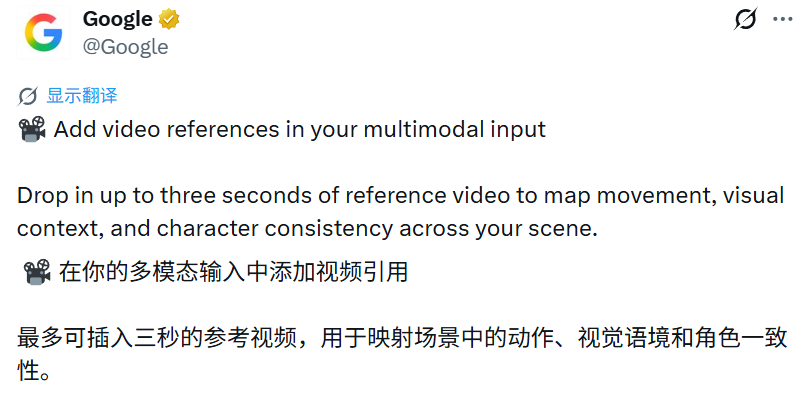
与此同时,模型还强化了多模态参考能力。用户可上传最长3秒的视频片段作为动作或节奏参考,再结合静态图片(角色/场景)和文本提示,生成全新的视频内容。例如,将一段街舞视频作为动作模板,再指定一个动漫角色和城市背景,模型即可生成该角色跳同款舞蹈的视频。这种“动作迁移”能力极大拓展了素材复用的可能性,也为跨风格创作提供了新路径。
实测体验:速度与细节俱佳,但内容合规性仍存挑战
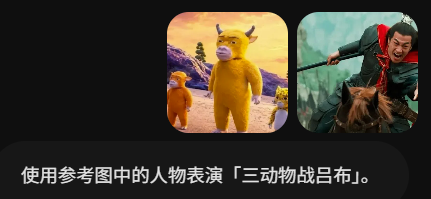
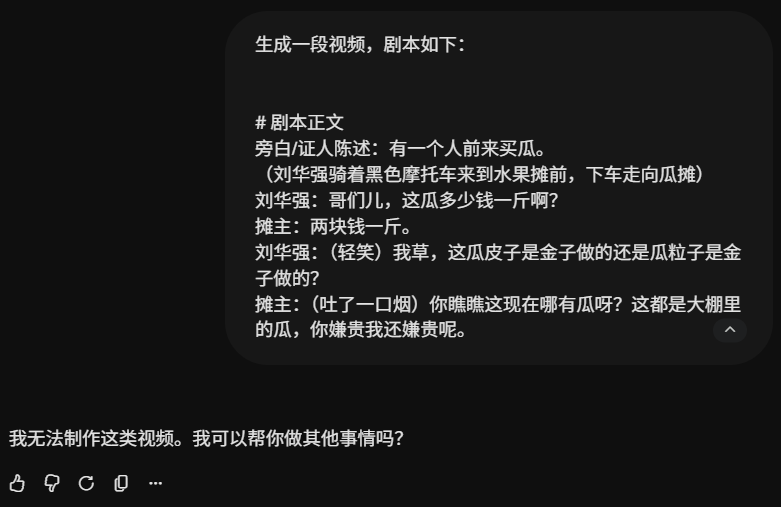
在实际体验中,Omni 1.1 Flash的生成速度确实令人印象深刻,数秒内即可输出一段720p视频。细节表现上,如人类进化视频中骨骼结构的变化、光影过渡等,均展现出较高水准。然而,测试也暴露出一些局限:当尝试复现“华强买瓜”等网络热门片段时,无论使用参考图还是纯文本提示,系统均拒绝生成,推测是触发了内容安全护栏。此外,在基于《牛来》截图生成“三动物战吕布”时,虽然画面流畅,但未能还原原作特有的粗粝画风与荒诞氛围,说明模型在风格迁移的精准控制上仍有提升空间。
生态布局:面向开发者与消费者的双轨策略
目前,Gemini Omni 1.1 Flash已通过Gemini API和Google AI Studio向开发者开放,企业客户可通过Agent Platform API集成其能力。在消费端,全球Google AI Plus、Pro和Ultra订阅用户已在Google Flow和Gemini App中获得相关功能。这种双轨策略既赋能专业工具链(如视频编辑软件、游戏引擎),又通过消费级应用触达广大内容创作者,形成从底层能力到终端体验的完整闭环。
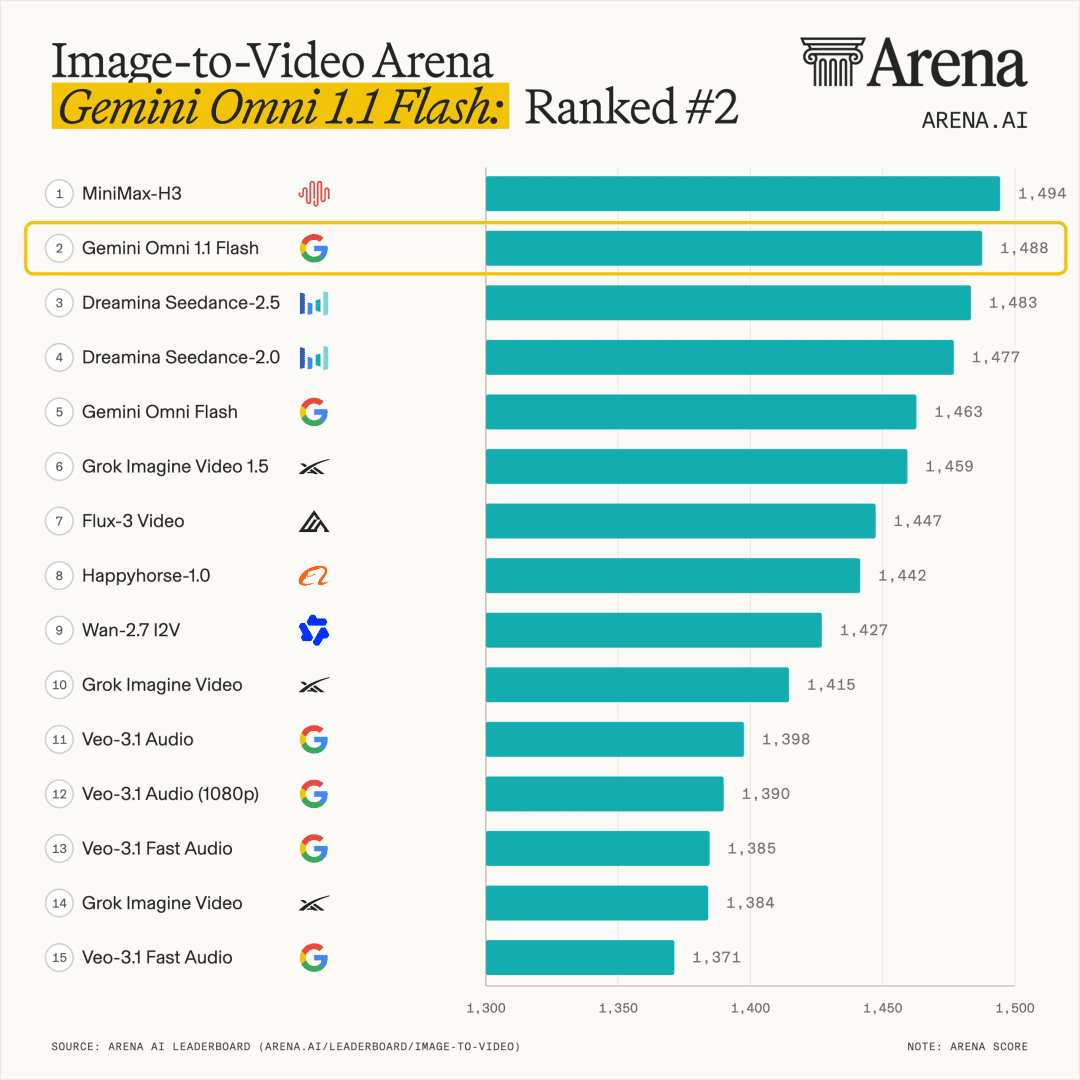
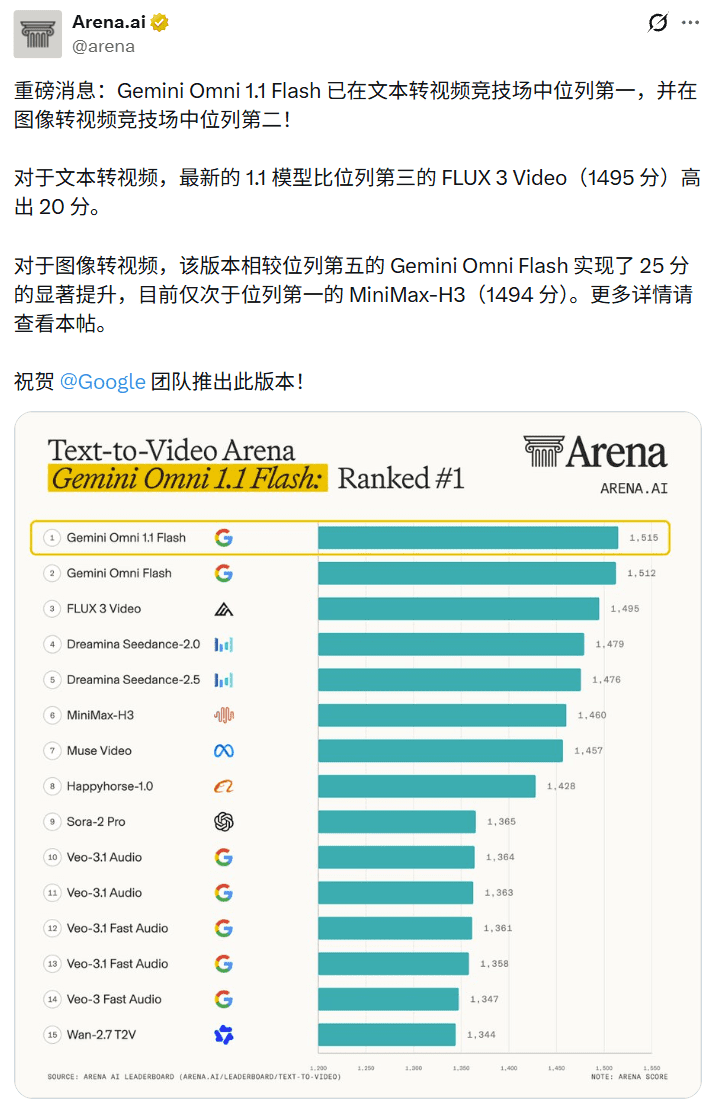
综合来看,Gemini Omni 1.1 Flash并非以炫技式突破吸引眼球,而是通过一系列务实的功能升级,系统性地优化了AI视频生成的工作流。它正在从“能生成视频”迈向“能高效生成可用、可控、连贯的视频”,这或许才是推动AI视频技术真正落地的关键一步。至于备受期待的Gemini 3.5 Pro,其发布时间虽未公布,但Omni 1.1 Flash的成熟路径或许已为其奠定了坚实基础。