AI抗体设计真的靠谱吗?Nature子刊盲测评揭示三大挑战真相
近年来,人工智能在生物医药领域的渗透速度令人瞩目,尤其是在抗体设计这一高壁垒赛道。从蛋白质语言模型到结构预测网络,各类算法纷纷宣称能够“从头设计”高亲和力、高稳定性的治疗性抗体。然而,这些模型在真实实验环境中的表现究竟如何?它们是真正具备预测能力,还是仅仅在已知数据上“事后合理化”?
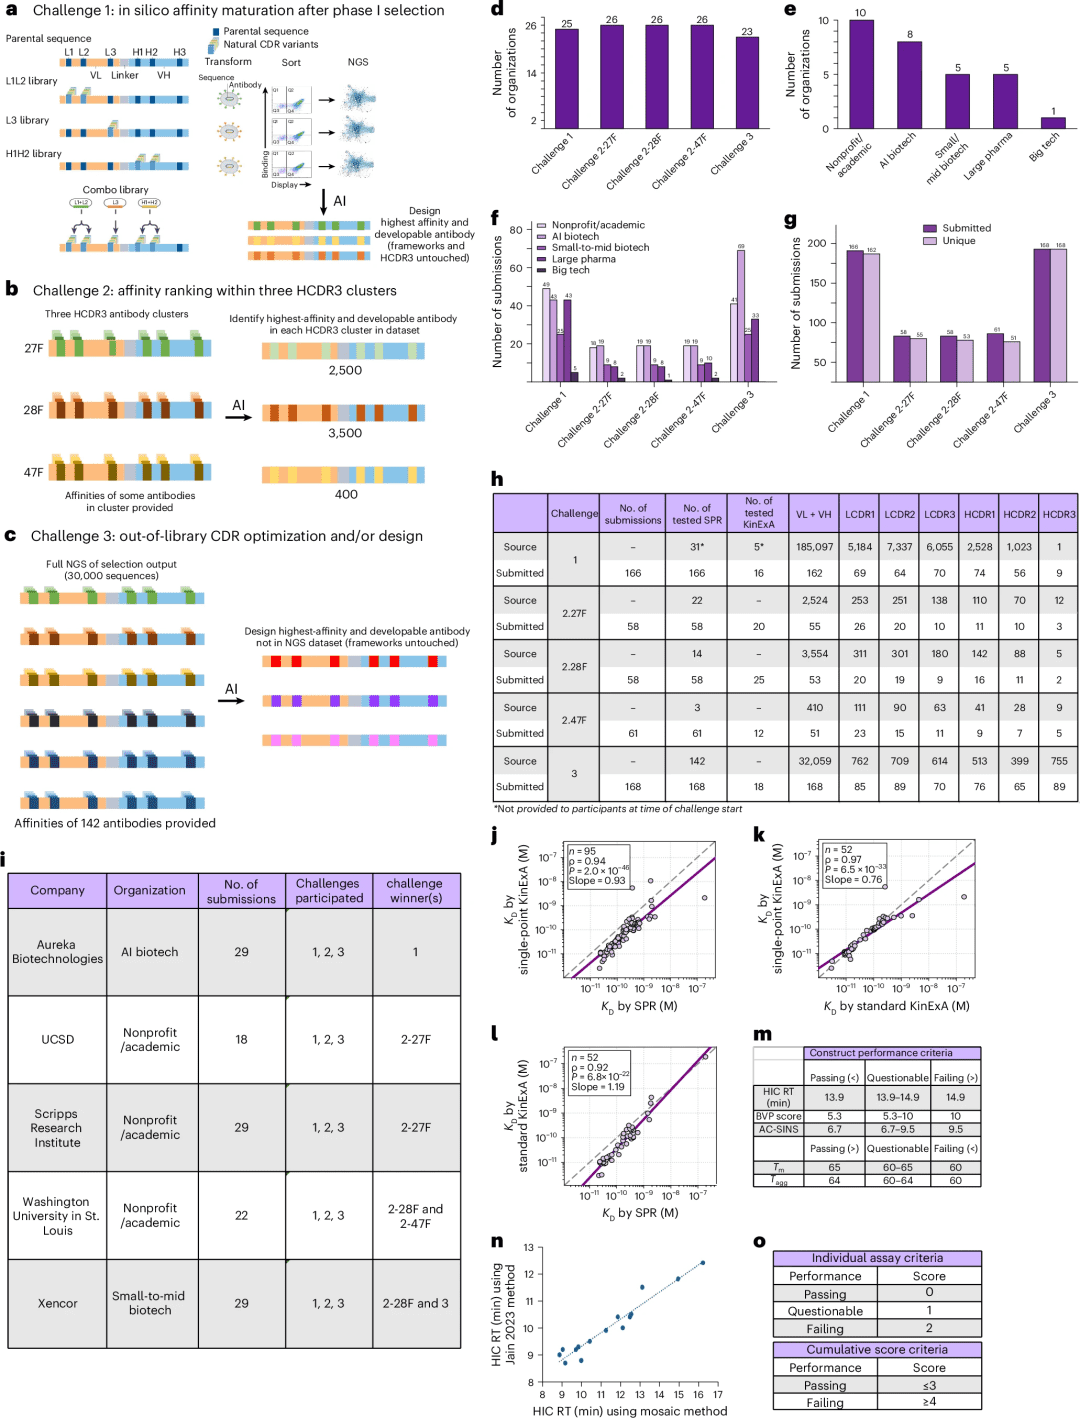
2026年8月,《Nature Biotechnology》发表了一项里程碑式的研究——AIntibody挑战(AIntibody Challenge)。这项工作受蛋白质结构预测关键评估(CASP)启发,首次采用前瞻性、双盲实验设计,对全球29个研究团队提交的511条AI设计抗体进行系统性验证。其核心目标并非比较模型精度,而是回答一个更根本的问题:AI能否在未知序列上提前识别或生成真正有效的抗体候选物?
研究团队选择了SARS-CoV-2的受体结合域(RBD)作为靶点。这一选择极具策略性——RBD拥有海量的结构、序列及结合数据,是当前信息最完备的抗原之一。如果连这样的“理想靶点”都无法让AI稳定产出有效设计,那么在数据稀疏的真实药物发现场景中,AI的实用性将大打折扣。
整个挑战分为三个递进阶段,分别对应抗体研发中的关键环节:亲和力优化、候选排序与从头设计。
第一阶段聚焦于亲和力成熟(affinity maturation)。参赛者获得一个亲本抗体及其首轮实验筛选后得到的CDR测序数据集,任务是在不改变框架区和HCDR3的前提下,仅修改指定CDR区域,设计出亲和力更高且具备良好成药性(developability)的新变体。值得注意的是,除了亲本抗体外,未提供任何其他序列的亲和力实测值,迫使模型必须基于有限信息进行外推。
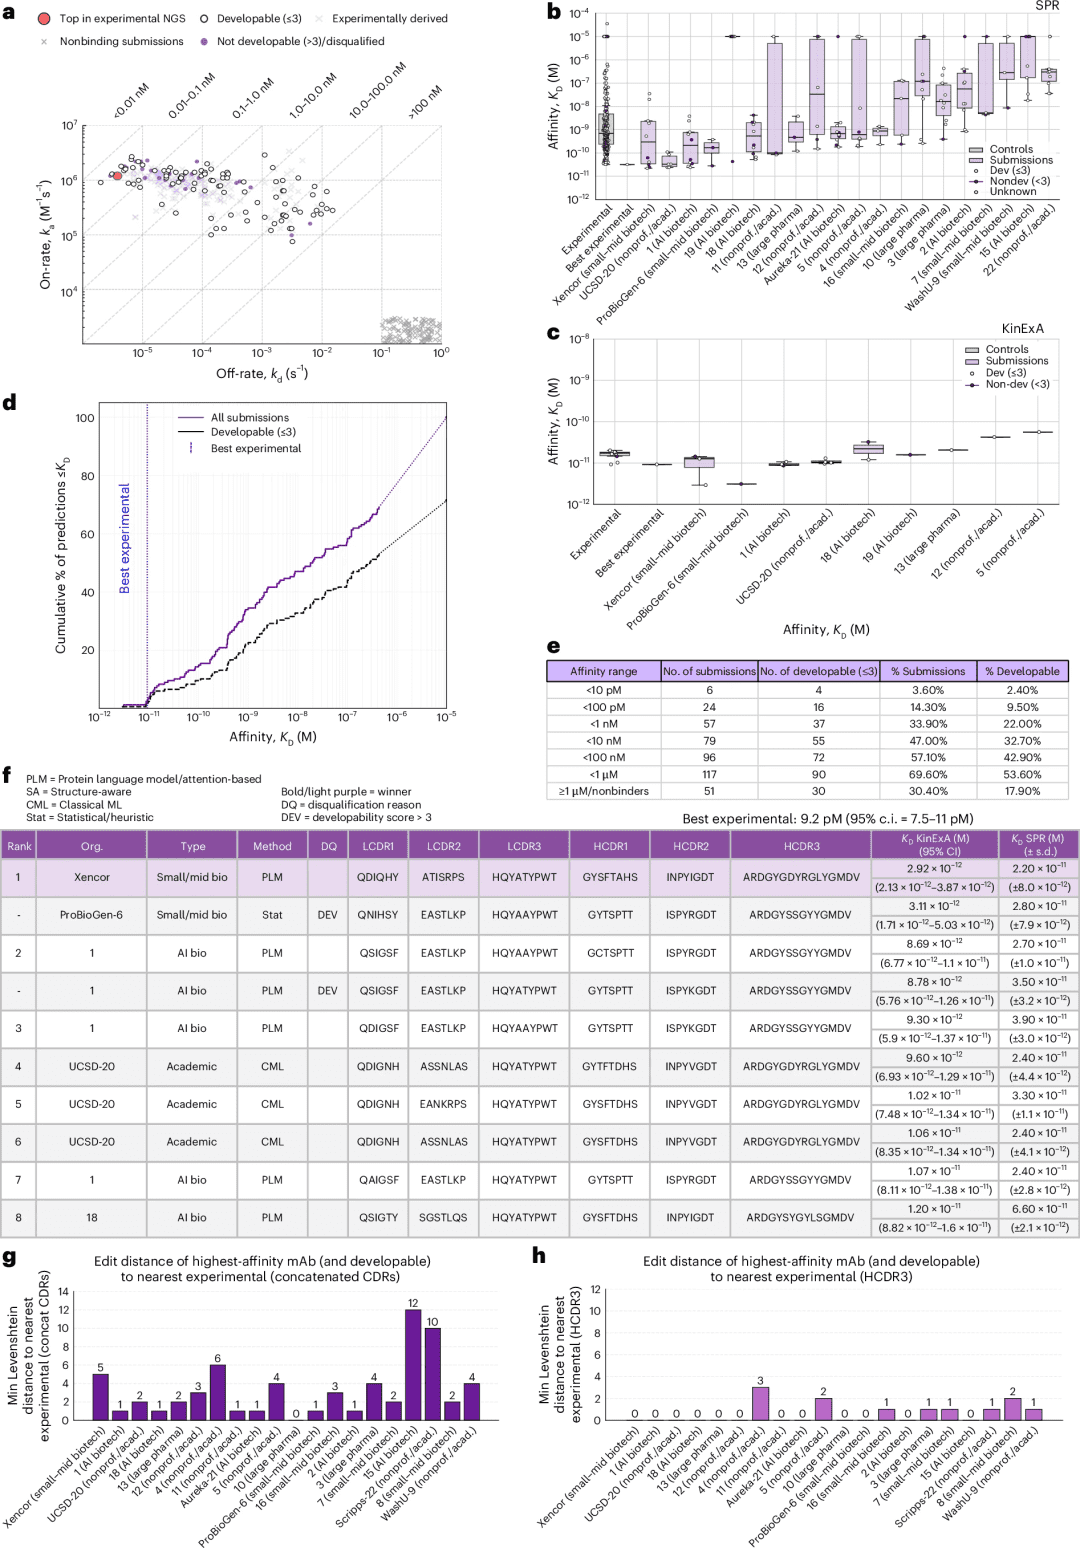
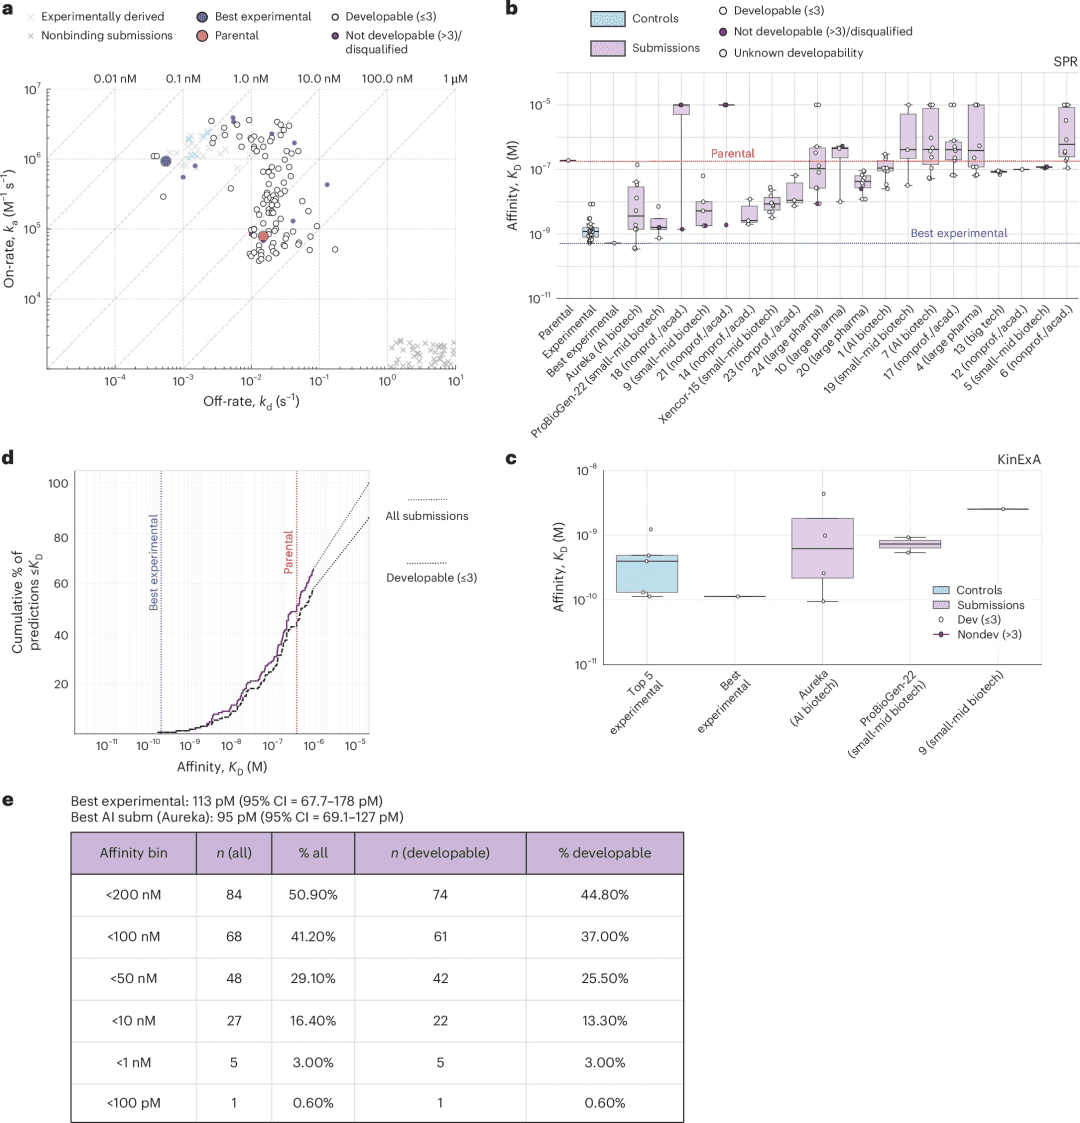
共有25家机构提交了165条序列。结果显示,86.1%的设计通过了基础成药性筛选(包括热稳定性、溶解度、低聚集倾向等),而63.0%同时满足“能结合RBD”和“成药性良好”两大条件。其中,来自Aureka团队的设计最为突出:其最佳抗体经KinExA测定亲和力达95 pM,不仅优于实验筛选出的最佳抗体(113 pM),更比原始亲本提升了约2000倍。这一结果表明,在任务边界清晰、数据相对充分的优化场景中,部分AI系统确实具备实用价值。
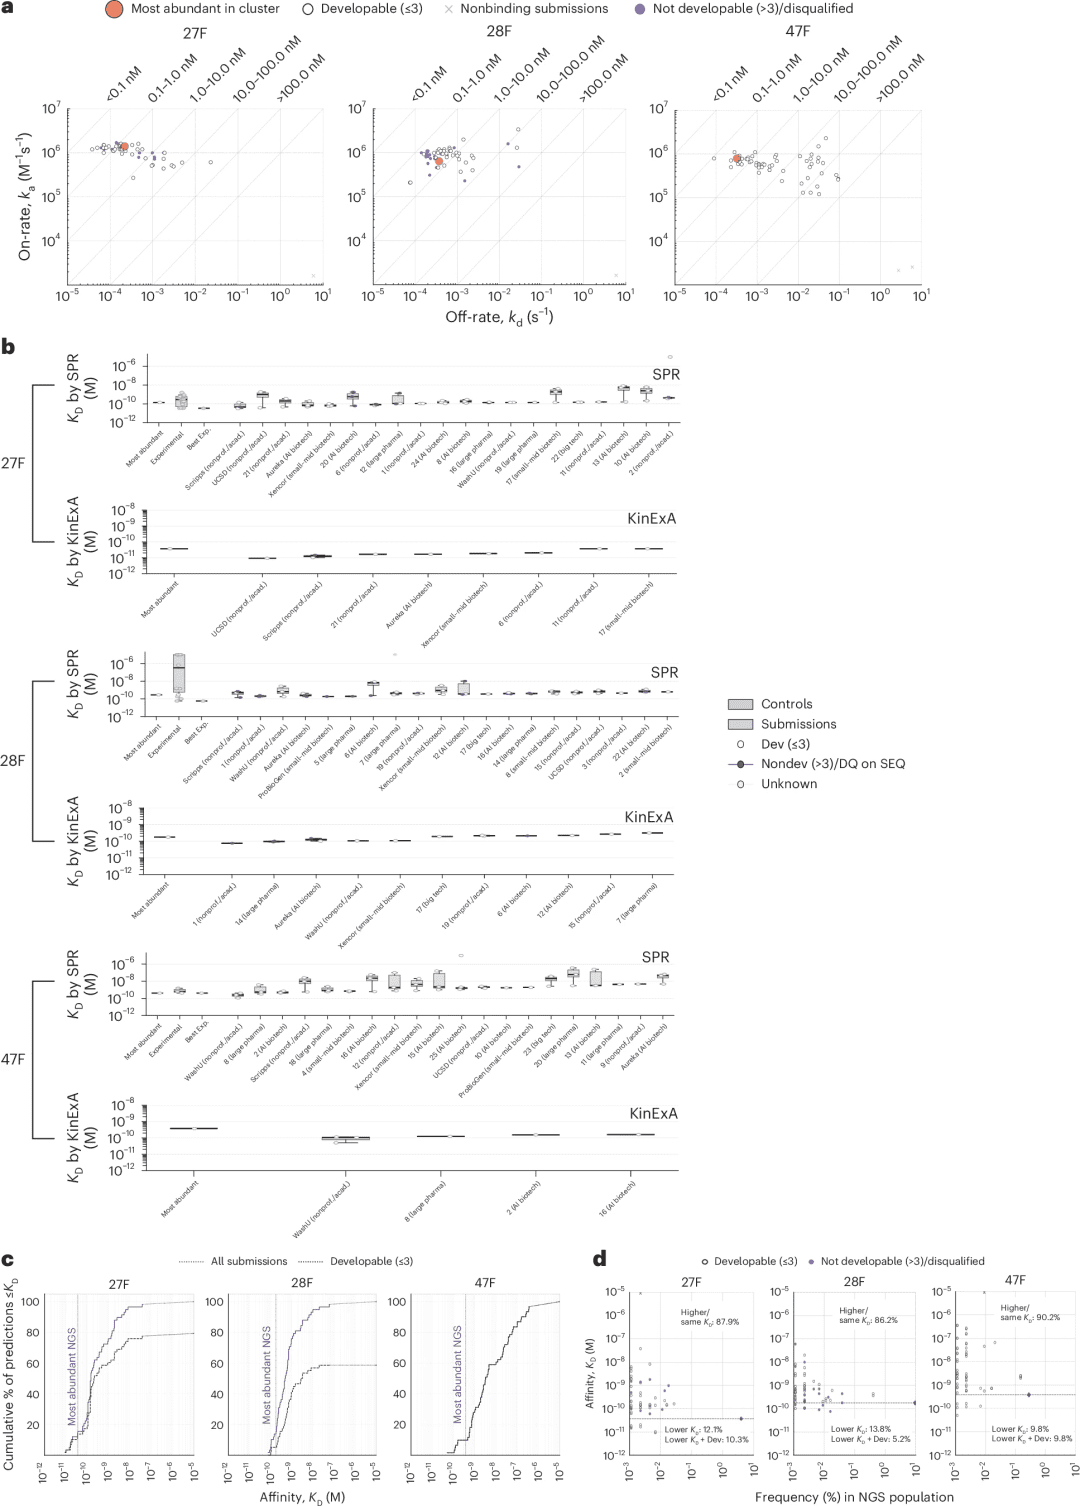
然而,第二阶段的结果却急转直下。该阶段不要求生成新序列,而是测试模型的预测排序能力。参赛者面对三个已通过实验筛选的HCDR3簇(27F、28F、47F),需从中选出亲和力最高且成药性良好的抗体。此前研究表明,若随机从每个簇中抽取抗体,约有30%的概率找到比“最丰富克隆”(即丰度最高的天然序列)亲和力更高的变体。
但AI的表现令人失望。在27F、28F和47F三个簇中,AI提交序列中优于最丰富克隆的比例分别仅为10.3%、13.8%和9.8%——显著低于随机选择的预期成功率。除华盛顿大学(WashU)外,所有AI策略均未超越随机基线。WashU虽在某一簇中达到50%的成功率(对比随机39%),但这一优势未能在其他簇中复现,暗示其可能捕捉到了局部序列特征,而非掌握了普适的亲和力预测规律。
这一结果暴露出当前AI模型的核心缺陷:过度依赖训练数据中的统计关联,缺乏对物理-化学机制的深层理解。当面对高度相似但未见过的序列时,模型难以准确判断微小突变对结合自由能的影响,更无法平衡亲和力与成药性之间的复杂权衡。
第三阶段最具挑战性——从头设计全新抗体。参赛者可使用全部32,059条实验序列及其中142条的亲和力数据,但必须生成数据库中不存在的新CDR组合。这直接模拟了真实药物发现中“探索未知序列空间”的核心需求。
23家机构提交了168条全新设计。最终,仅53.6%的抗体同时满足“结合RBD”和“成药性良好”。更值得警惕的是,30.4%的设计完全无法结合靶点,16%虽能结合但成药性失败,合计近半数提交无效。这说明即便拥有大量训练数据,AI在跨出已知分布一步后,失败率急剧上升。
其中,Xencor团队的设计一度带来惊喜:其最佳抗体亲和力高达2.9 pM,甚至优于挑战中所有实验筛选出的抗体。然而,这条“超级高亲”抗体在疏水相互作用色谱(HIC)中无法正常洗脱,表明其表面存在异常疏水斑块,极易导致聚集;同时,其特异性活性偏低,并表现出非典型的协同结合行为。这意味着,单纯追求亲和力可能牺牲成药性,而当前多数AI模型尚未有效整合多维优化目标。
研究团队进一步将参赛方法分为四类:统计/启发式方法、传统机器学习、蛋白质语言模型(含注意力机制)以及结构感知模型。分析发现,没有一类方法在所有任务中全面领先。蛋白质语言模型在序列生成多样性上占优,但预测准确性不足;结构感知模型在亲和力优化中表现较好,却在新设计中频繁失败;传统机器学习则受限于特征工程,泛化能力有限。
这一分类结果揭示了一个关键现实:当前AI抗体设计仍处于“工具箱”阶段,而非“通用引擎”。不同方法适用于不同子任务,但尚无模型能端到端地解决从靶点识别到候选优化的全链条问题。
更重要的是,AIntibody挑战暴露了领域内长期存在的方法论缺陷——过度依赖回溯性验证(retrospective validation)。许多论文在已知结合/非结合序列上训练并测试模型,本质上是在“开卷考试”。而真实药物发现是“闭卷考试”:你必须在合成和测试前就判断一条全新序列是否有效。AIntibody通过前瞻性实验设计,首次将AI置于这种真实压力之下,其结果无疑是一剂清醒剂。
当然,挑战也并非全盘否定AI的价值。在第一阶段,多个团队成功实现了显著亲和力提升,证明AI可作为高效辅助工具,加速已有苗头化合物的优化。但若期望AI独立完成从靶点到临床候选物的跨越,则为时尚早。
未来方向或许在于多模态融合与机制引导。例如,将蛋白质语言模型的序列先验知识与分子动力学模拟的物理约束相结合,或引入可微分的成药性预测模块,在生成过程中实时反馈疏水性、电荷分布等关键参数。此外,建立更大规模、标准化的抗体-抗原结合与成药性数据库,也是提升模型泛化能力的基础。
总之,AIntibody挑战并未宣告AI抗体设计的终结,而是为其划定了当前的能力边界。它提醒我们:在欢呼技术突破的同时,必须保持对生物学复杂性的敬畏。真正的智能药物设计,不仅需要算法的精巧,更需要对生命系统深层规律的理解与尊重。