Recuris:递归记忆演化的智能体架构如何破解长程任务瓶颈?
近年来,随着大语言模型(Large Language Models, LLMs)能力的快速演进,基于LLM构建的智能体(Agent)在复杂任务中展现出前所未有的潜力。然而,当任务时间跨度拉长、步骤增多、依赖关系复杂化时,现有智能体框架普遍遭遇“长程瓶颈”——即随着交互轮次增加,性能急剧下降,错误累积导致任务失败。这一问题的核心,并非模型本身缺乏推理能力,而在于记忆的使用与迭代机制存在结构性缺陷。
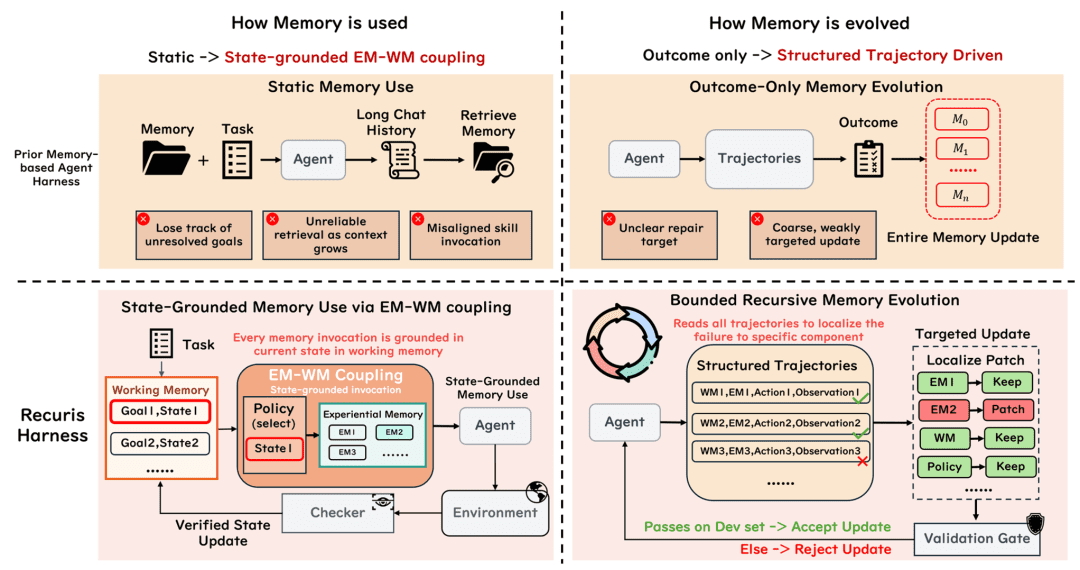
传统智能体通常采用两种记忆处理方式:一是在任务开始前一次性检索相关历史经验;二是在每轮交互中基于当前上下文动态检索过往信息。这两种策略在短程任务中尚可奏效,但在长程场景下却迅速失效。原因在于,任务初期检索的记忆无法随环境动态更新,而不断膨胀的对话历史则混杂了大量过期信息、执行噪声甚至幻觉内容,导致后续检索越来越不可靠。更关键的是,这些方法缺乏一个紧凑、可信且持续演化的任务状态表示,无法将已有经验与当前执行需求精准对齐。
与此同时,尽管递归式自我改进(Recursive Self-Improvement, RSI)被寄予厚望,但其在记忆层面的应用同样受限。现有RSI方法多依赖最终任务得分作为反馈信号,这种粗粒度的奖励无法定位具体出错环节——是技能库不准确?任务状态追踪错误?还是进度验证机制失效?因此,记忆更新往往是全局重写,效率低下且容易引入新错误。此外,随着推理轨迹不断增长,智能体难以从中提取有效改进线索,进一步削弱了递归优化的效果。
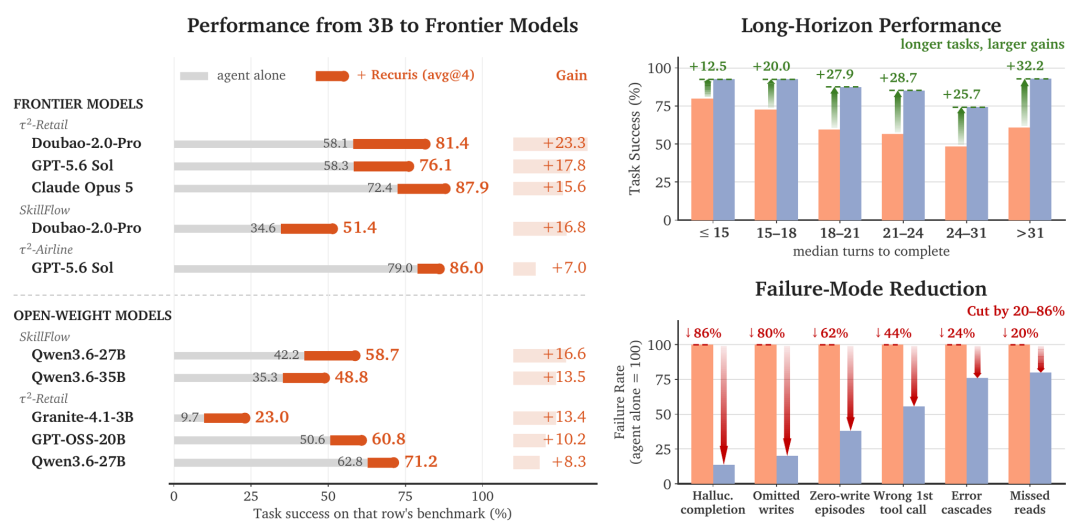
针对上述挑战,新加坡国立大学、普林斯顿大学联合斯坦福、牛津等机构的研究团队提出了 Recuris(Recursive Experiential–Working Memory Evolution) ——首个将递归自我改进机制深度嵌入记忆控制层的智能体架构。值得注意的是,Recuris 无需任何模型训练或微调,仅通过重构记忆的使用与演化逻辑,便在多个长程基准上实现了从3B参数开源模型到Claude Opus 5、GPT-5.6-Sol等前沿大模型的全面性能跃升。
记忆使用的范式转变:从上下文检索到状态驱动
Recuris 的首要突破在于彻底改变了记忆的使用方式。传统方法将整个对话历史视为记忆池,在每一步通过语义相似度检索“相关”片段。这种方式在长程任务中极易引发幻觉——例如,智能体可能因误读某句“已完成支付”的对话文本而跳过实际未执行的支付步骤,导致后续流程崩溃。
Recuris 则引入工作记忆(Working Memory, WM) 作为任务状态的核心载体。WM 并非简单记录对话内容,而是显式维护当前任务的目标树、已达成子目标、待执行动作及环境约束。技能调用不再基于模糊的上下文匹配,而是在明确的“执行事件”(如状态变更点或交互边界)触发,并严格依据环境返回的工具回执(tool receipt) 进行验证。只有当外部工具确认操作成功(如API返回“订单已创建”),该状态变更才会被提交至工作记忆。这种机制确保了记忆的真实性与因果性,从根本上避免了因语言幻觉导致的执行错位。
结构化轨迹:让失败可解释、可定位
要实现有效的递归改进,前提是知道该修哪里。Recuris 通过 EM–WM 耦合机制(经验记忆与工作记忆的协同)将整个执行过程转化为一条结构化轨迹 Γ。该轨迹不仅包含最终成败结果,更详细记录了:
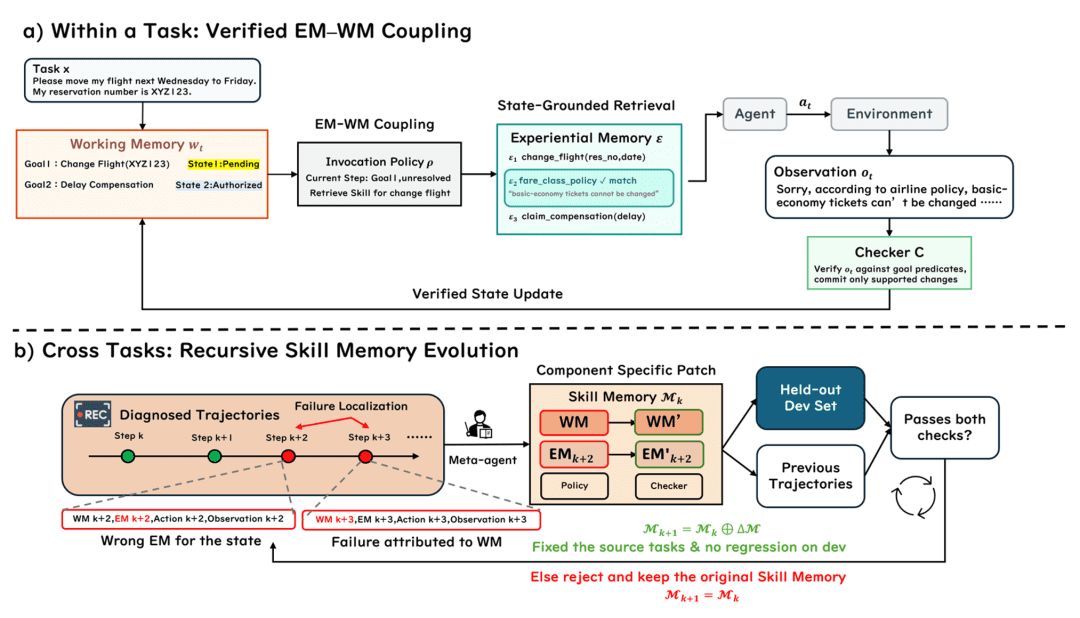
- 每一时刻的工作记忆状态(目标进展、未决问题)
- 被调用的具体技能及其参数
- 工具执行的实际观测结果
- 状态更新是否通过验证
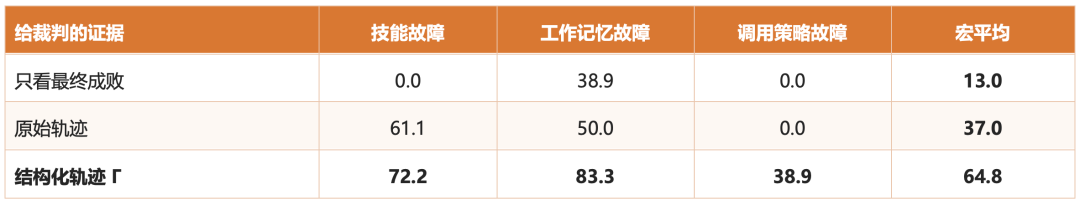
这种结构化表示使得失败归因成为可能。研究团队设计了一项关键实验:向记忆中注入已知类型的故障(如技能参数错误、状态更新遗漏、验证逻辑缺陷),并让裁判模型基于不同信息源判断故障类型。结果显示:
- 仅凭最终成败判断,准确率仅为13.0%,甚至低于随机猜测基线(33.3%)
- 基于原始对话轨迹,准确率提升至37.0%
- 而基于 Recuris 生成的结构化轨迹 Γ,准确率高达 64.8%,接近基线的两倍
这一结果证明,结构化轨迹能有效揭示失败的组件级根源,为靶向修复提供坚实基础。
验证门控的递归演化:精准、安全、可持续
在定位失败组件后,Recuris 启动递归演化流程。一个固定的 Meta-Agent 分析结构化轨迹,生成针对特定记忆组件(如某个技能模板、状态更新规则或验证条件)的补丁。但并非所有补丁都会被立即采纳——系统设置了一个验证门控机制:只有当补丁在目标任务上修复了问题,且在留出验证集上未引发性能回退时,才允许其更新记忆库。
这种有界、受控的演化策略确保了记忆改进的安全性与泛化性。每一次成功的更新都会改变未来的执行路径,产生新的优化数据,从而形成“执行→失败→定位→修复→再执行”的正向循环。更重要的是,由于演化过程不依赖模型内部参数调整,同一份优化后的记忆可直接迁移至其他模型。
实验验证:全面超越,且优势随任务延长而凸显
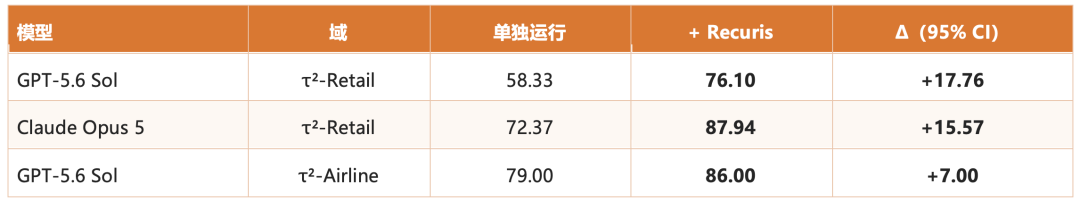
研究团队在四个长程基准(τ²-Retail、τ²-Airline、SkillFlow、Terminal-Bench 2.1)上对 Recuris 进行了系统评估,覆盖从 Phi-3(3B)到 Claude Opus 5、GPT-5.6-Sol 等十种模型。结果表明:
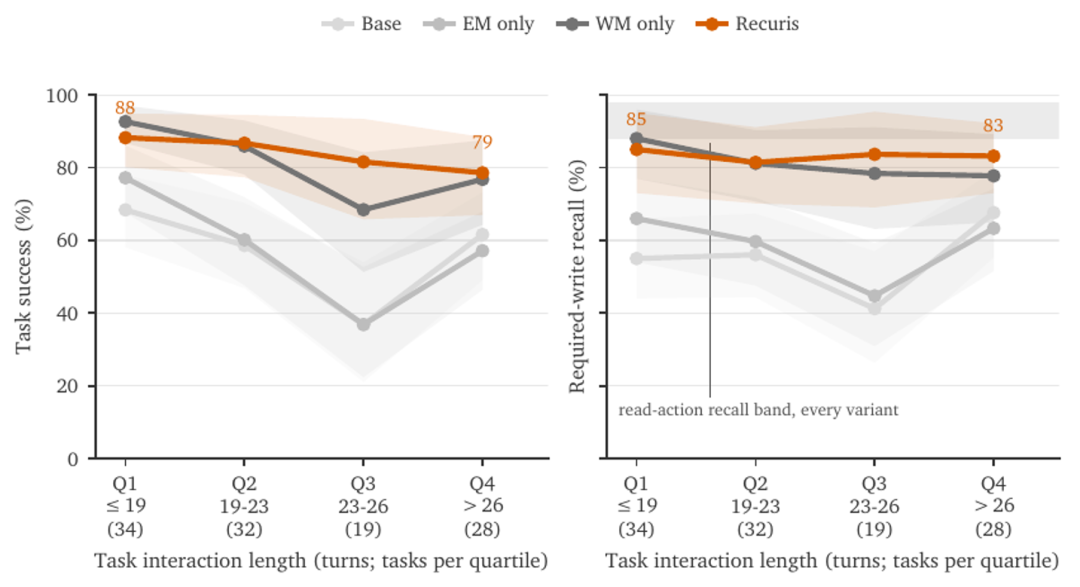
- 在所有模型上,Recuris 均带来显著性能提升,平均任务完成率提高 17–44.7 个百分点
- 优势在长任务中尤为突出:按任务固有长度分四组测试,Recuris 在最长任务组仍保持 +44.7 的绝对领先,未出现随轮次增加而衰减的现象
- 常见失败模式(如重复调用、跳步执行、状态漂移)发生率大幅降低
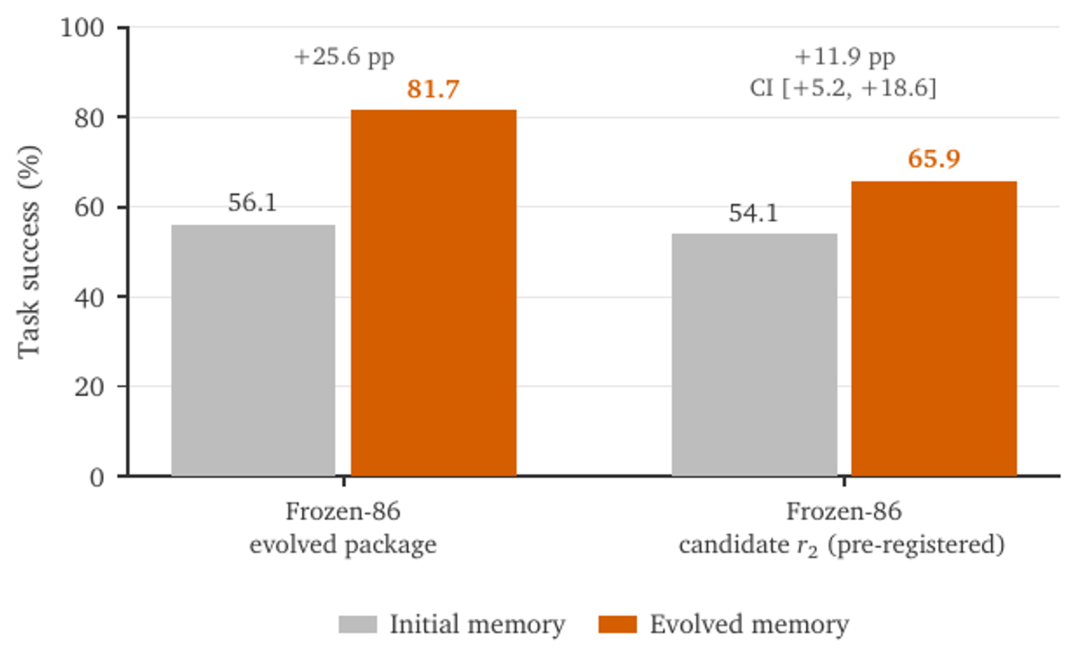
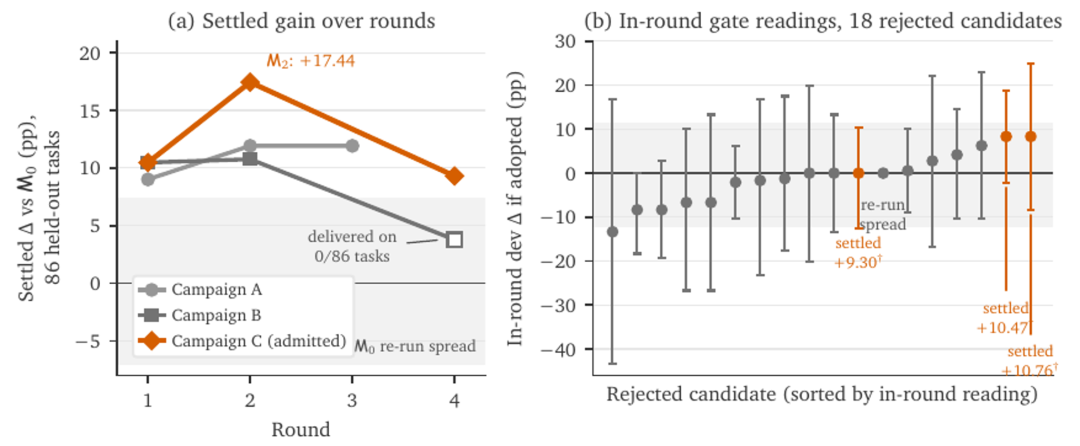
更令人瞩目的是其跨任务与跨模型迁移能力。研究者从16个失败任务中蒸馏出优化记忆,在从未见过的86个留出任务上仍获得 +9.01 至 +17.44 的提升。此外,一份在较小模型上演化出的记忆,直接用于 Claude Opus 5 等前沿模型,同样带来可观增益,证明了 Recuris 框架的模型无关性与泛化鲁棒性。
技术启示:任务状态是长程智能的核心枢纽
Recuris 的成功揭示了一个关键洞见:在长程智能体系统中,真正的瓶颈往往不是“缺乏经验”,而是缺乏一个可靠的任务状态表示来桥接经验与行动。传统方法将记忆视为静态知识库,而 Recuris 将其重构为一个动态演化的状态机——经验记忆(EM)提供技能库,工作记忆(WM)维护实时状态,两者通过结构化轨迹紧密耦合,形成闭环反馈。
这种架构不仅解决了记忆过期与检索噪声问题,更将智能体从“被动响应”推向“主动验证与自我修正”。未来,此类状态驱动的记忆机制有望扩展至多智能体协作、具身智能、科学发现等更复杂场景,为构建真正可靠的长期自主系统奠定基础。
综上所述,Recuris 通过重新定义记忆的使用与迭代逻辑,在不依赖模型训练的前提下,实现了智能体在长程任务中的质变式提升。其核心思想——以结构化状态为中心、以组件级诊断为手段、以验证门控为保障——为下一代智能体架构提供了清晰的技术路径。