视触觉被高估了吗?从技术原理到产业落地的深度剖析
近年来,随着具身智能(Embodied Intelligence)概念的兴起,机器人对物理世界交互能力的需求日益迫切。在这一背景下,触觉感知作为继视觉之后的关键模态,被寄予厚望。其中,基于视觉原理的触觉传感器(Vision-Based Tactile Sensor, VBTS),因其高空间分辨率和直观的形变可视化能力,成为学术界与创业圈的宠儿。然而,当热潮退去,回归工程现实,我们不得不追问:这种看似先进的技术,是否真的具备支撑机器人规模化落地的产业基础?

视觉红利下的“低门槛幻觉”
视触觉的核心架构并不复杂:一个微型CMOS摄像头、一组LED光源、一块透明弹性体(通常为硅胶或凝胶),再加上表面标记点或随机纹理,即可构成一个可工作的原型。这种高度依赖成熟视觉产业链的构建方式,使得其硬件门槛极低。在国内高校实验室,学生团队往往能在数周内完成自研,并在电商平台上以数百元价格出售。
这种“即插即用”的便利性,表面上加速了技术普及,实则暴露了其技术空心化的本质。核心成像芯片(如索尼IMX系列)由少数国际厂商垄断,国内具备自主CMOS设计能力的企业屈指可数。大多数视触觉创业公司所做的,不过是将现成摄像头模组嵌入定制外壳,再套用开源算法进行微调。这种“系统集成式创新”缺乏对底层传感器工艺、材料科学和信号链路的深度掌控,导致其技术护城河极其薄弱。
更值得警惕的是,这种低壁垒催生了大量同质化竞争者。全球范围内已有数十家公司在开发类似产品,但鲜有企业在核心性能上实现突破。产品之间差异微乎其微,最终陷入价格战与营销战的泥潭,而非技术迭代的良性循环。
算法层面的“拿来主义”困局
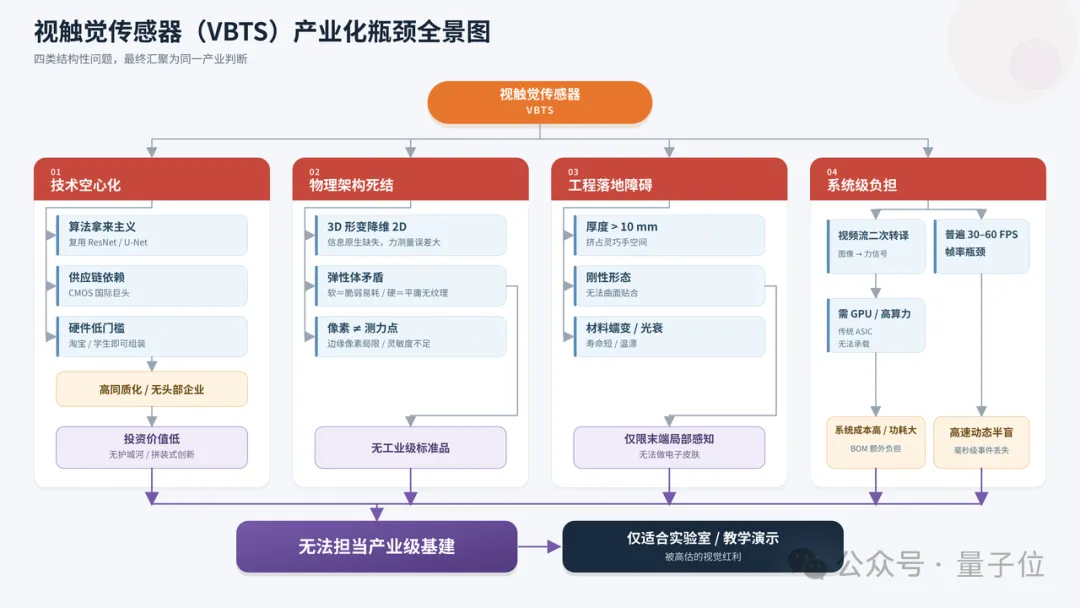
视触觉的研究繁荣,很大程度上得益于计算机视觉(CV)领域的算法外溢。ResNet、U-Net、光流法等成熟模型被直接迁移到触觉图像处理中,用于力分类、形状重建或滑移检测。这种复用虽提升了论文产出效率,却也掩盖了一个根本问题:触觉感知并非视觉的简单延伸。
触觉的本质是力学交互,涉及法向力、切向力、扭矩、摩擦系数等多维物理量的耦合。而视触觉将这些三维力学信息压缩为二维像素位移,本质上是一个欠定逆问题。即便使用最先进的深度学习模型,也无法从信息降维的图像中完美还原原始力场。尤其在多点接触、边缘抓取等复杂工况下,算法误差会显著放大。
此外,行业内普遍存在一个认知误区:将光学像素数等同于触觉空间分辨率。实际上,有效测力点密度受弹性体形变衰减、算法多解性及力解耦极限的三重约束,远低于CMOS的物理像素数。盲目堆砌高分辨率摄像头,不仅无法提升感知精度,反而会引入冗余噪声,降低信噪比。
工业落地的四大硬伤
1. 结构厚重,难以微型化集成
为保证成像质量,视触觉传感器需满足最小工作焦距要求,并预留匀光空间。即便采用无透镜设计,整体厚度仍普遍超过10mm。这对于空间极度受限的灵巧手而言是致命缺陷。指尖内部已密布电机、减速器、腱绳等传动部件,再塞入刚性摄像头模组,必然牺牲自由度或负载能力。
2. 刚性形态限制部署范围
视触觉依赖封闭光学腔体维持稳定成像,天然不具备柔性。它只能部署于平面或小曲率区域(如指腹),无法像电子皮肤那样贴合机器人躯干、关节等复杂曲面。这意味着它永远只能作为局部感知方案,无法构建全身触觉网络。
3. 多模组集成引发系统崩溃
一台双手机器人若需覆盖9个指腹加掌心,需部署近30个视触觉模组。这相当于在机械结构中塞入30个微型摄像头,带来三大灾难性后果:
- 走线无解:30余条供电与数据线需通过直径仅数毫米的手指根部中空通道,物理上不可行;
- 算力爆炸:30路高清视频流需160+ TOPS算力,必须外挂GPU服务器,功耗超百瓦;
- 延迟失控:端到端延迟达数十毫秒,远超柔顺控制所需的1–4ms闭环窗口。
这种“视觉通路增加→走线困难→算力飙升→功耗暴涨→部署受限”的死亡螺旋,从根本上否定了其在整机系统中的可行性。
4. 弹性体的“零和博弈”
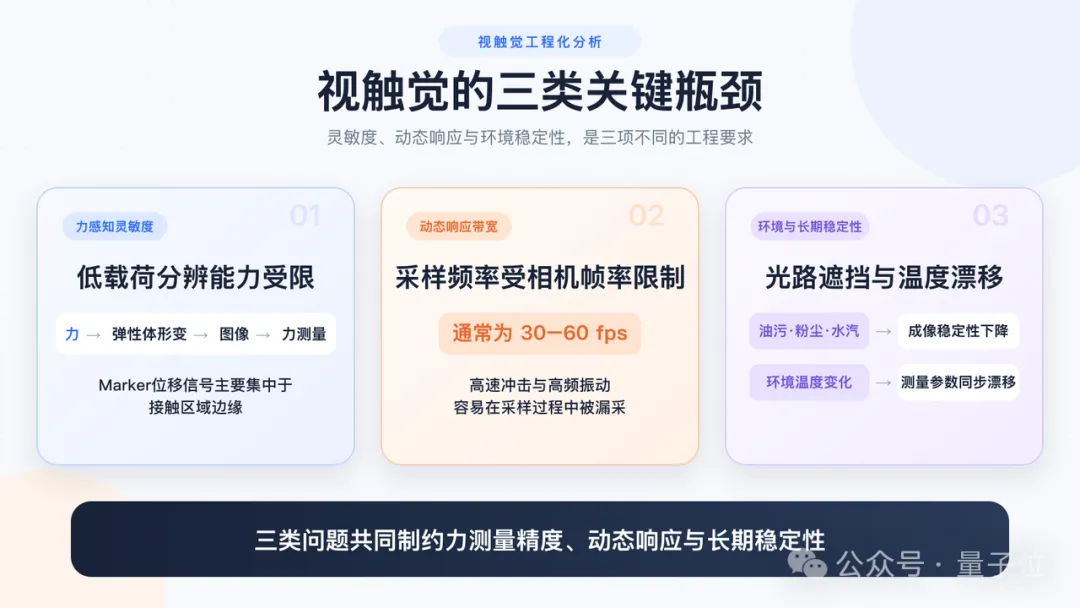
视触觉的感知能力与弹性体软硬度直接相关:越软,灵敏度越高,成像越清晰;越硬,耐久性越好,但灵敏度骤降。这是一个无法调和的物理矛盾。
在工业现场,油污、高温、机械磨损无处不在。若使用柔软凝胶,虽能捕捉微观纹理,但极易老化撕裂,信号漂移严重;若硬化材料以提升寿命,则精细感知能力瞬间归零。更危险的是,即使摄像头仍在工作,弹性体一旦发生不可逆形变,力-光映射关系即已失真,输出的只是“误差信息”。对于依赖闭环反馈的机器人而言,错误的力信号比无信号更具破坏性。
动态性能的先天不足
灵巧操作中的接触力瞬息万变,包含高频冲击与微振动。然而,视触觉受限于相机帧率(通常30–60fps),采样频率远低于压阻式传感器的kHz级响应。这意味着:
- 抓取瞬间的力峰值被遗漏;
- 滑移前兆无法及时捕捉;
- 控制系统处于“半盲”状态。
此外,曝光时间不可压缩,进一步锁死帧率上限。面对毫秒级力事件,33ms的采样间隔意味着控制指令往往在下一帧到来前已失效,极易导致工件滑脱或设备损坏。
环境干扰更是雪上加霜。油污附着改变反射率,水汽凝结散射光线,温度变化引发三重复合漂移(弹性体模量、LED光强、相机暗电流)。这些因素共同导致标定失效,精度优势仅存在于理想实验室环境。
隐性成本:被忽视的系统负担
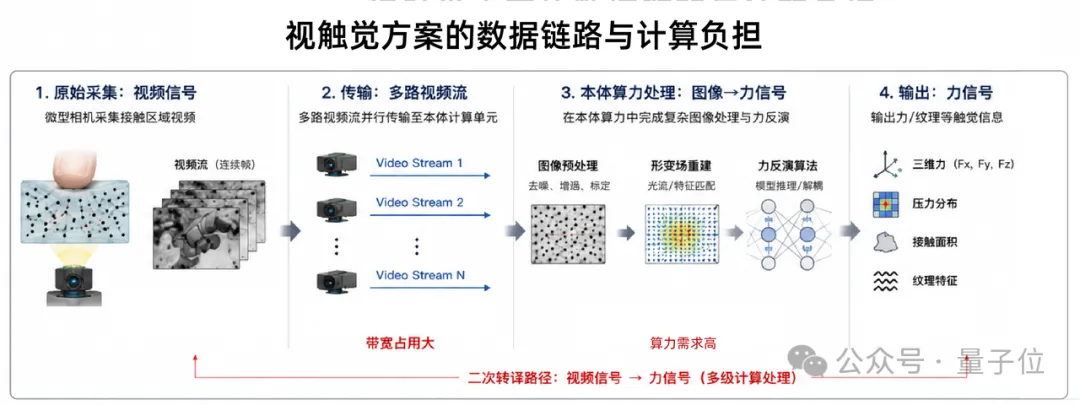
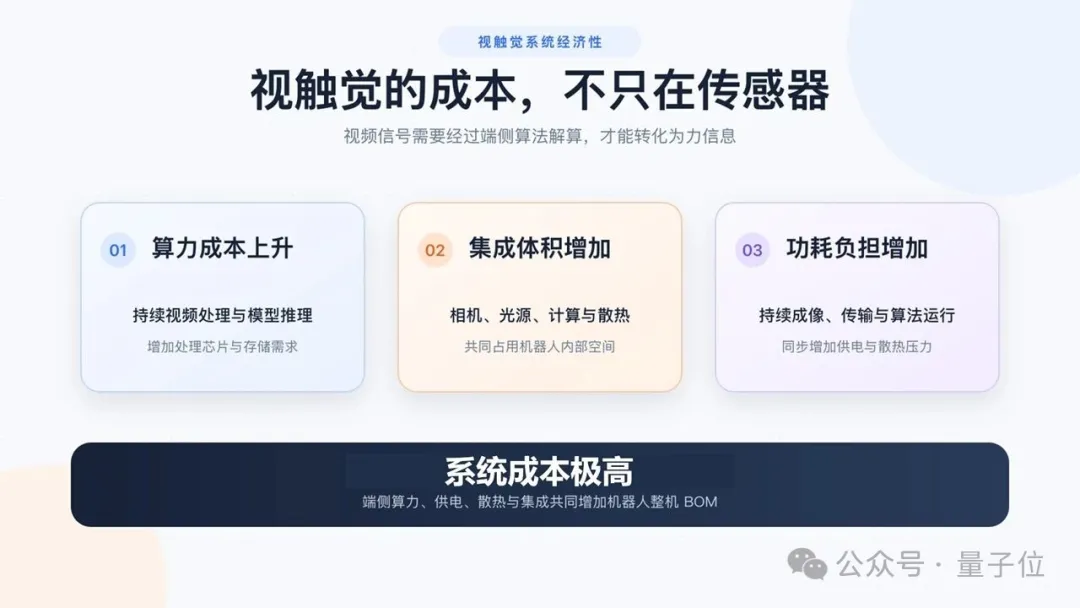
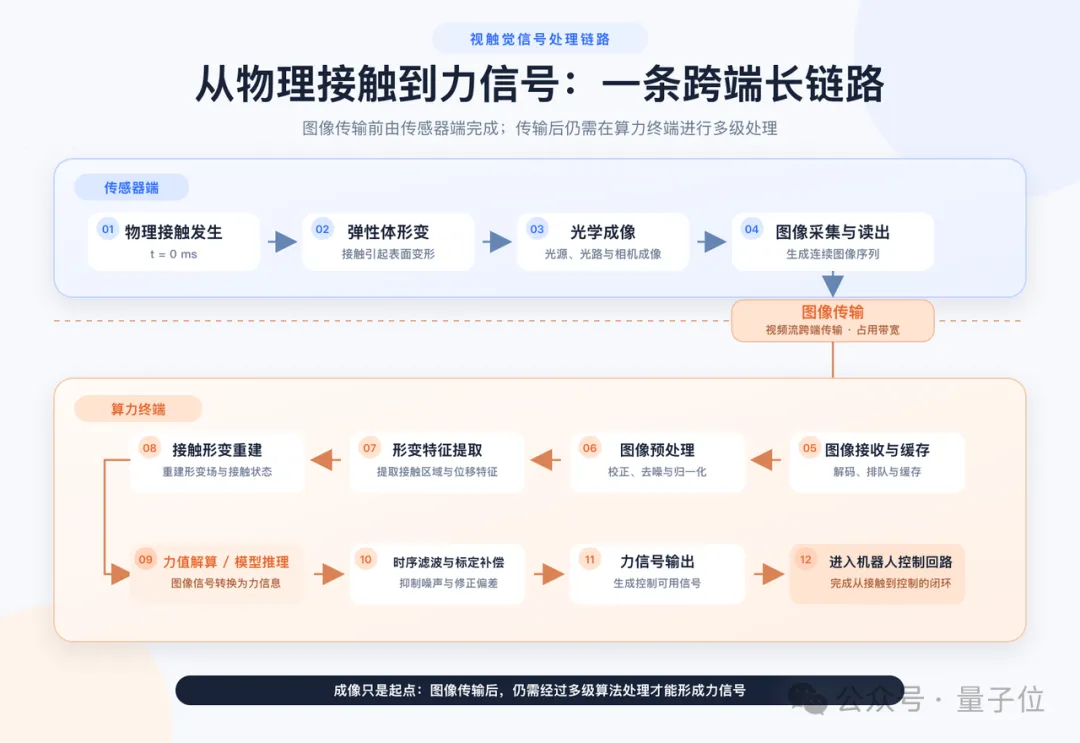
视触觉看似只是一个传感器,实则将触觉问题转嫁为视频处理问题。其数据链路需经历“图像采集→形变重建→力值解算”多级转译,传统ASIC无法承载,必须依赖GPU等并行计算单元。这带来三重隐性成本:
- 系统成本抬升:用户需额外采购算力模块;
- 体积牺牲:算力单元挤占本体设计空间;
- 功耗加剧:持续视频流压缩移动机器人续航。
在机器人整机BOM(物料清单)中,视触觉非但不是赋能组件,反而成为负担。
结论:热度不等于价值
视触觉的繁荣,本质上是视觉技术红利与低硬件门槛共同催生的泡沫。它在学术演示中光彩夺目,却在工业落地中步履维艰。一个无法小型化、不可柔性化、难耐久、高延迟、强依赖外部供应链的技术路线,显然不具备成为产业基础设施的资格。
具身智能的下半场,拼的不是论文数量或Demo炫酷程度,而是交付确定性、工程可靠性和规模化量产能力。资本应当警惕那些“看起来很美”但缺乏物理根基的技术叙事,将资源投向真正敢于啃硬骨头、掌握全栈核心技术的破局者。
视触觉或许仍有其 niche 应用场景,如实验室研究、教育演示或特定纹理识别任务。但若将其视为机器人触觉感知的主流路径,则无异于缘木求鱼。在物理AI的时代,我们需要的是能经受住产线考验的“钢铁触觉”,而非娇贵易损的“玻璃感知”。