Midjourney V8.2图像编辑模型深度解析:指令微调与画布扩展如何重塑AI绘画工作流?
近年来,生成式人工智能在视觉领域的演进速度令人瞩目。从最初的文本到图像生成,到如今具备精细编辑能力的智能系统,AI绘画工具正逐步从“灵感辅助”转向“全流程创作伙伴”。在这一进程中,Midjourney始终处于行业前沿。2026年8月,其正式向公众开放测试的V8.2图像编辑模型,无疑是该领域的一次重大跃迁——它不再满足于“生成一张图”,而是致力于“让你随心所欲地修改这张图”。
这一版本的核心突破,在于将图像编辑能力深度集成到生成流程中,使用户能够以接近传统数字绘画软件的自由度,对AI生成结果进行二次创作。这种转变不仅提升了工具的专业性,也重新定义了人与AI在创意过程中的协作关系。
指令驱动的精准编辑:从模糊描述到像素级控制
V8.2最引人注目的功能之一,是其强大的指令编辑能力。用户不再需要重新生成整张图像来修正细节,而是可以直接对已有图像输入自然语言指令,如“将人物的帽子换成红色贝雷帽”或“让背景建筑呈现赛博朋克风格”。系统会基于原始图像的语义结构,智能识别目标区域并执行修改。
这种能力的背后,是模型对图像-文本对齐机制的深度优化。相较于早期版本仅依赖全局提示词,V8.2引入了更细粒度的空间注意力机制,使得指令能够精准定位到图像中的特定对象或区域。例如,当用户要求“给左侧的狗添加项圈”时,模型不仅能识别“狗”这一类别,还能区分画面中多个同类物体的位置关系,从而避免误操作。
值得注意的是,指令的有效性高度依赖于描述的清晰度。模糊的表述如“让它更好看”往往导致不可预测的结果,而具体、结构化的指令则能显著提升编辑精度。这也意味着,用户需要逐步培养“与AI对话”的新技能——不是命令机器,而是引导它理解你的视觉意图。
多图参考融合:告别单一灵感源
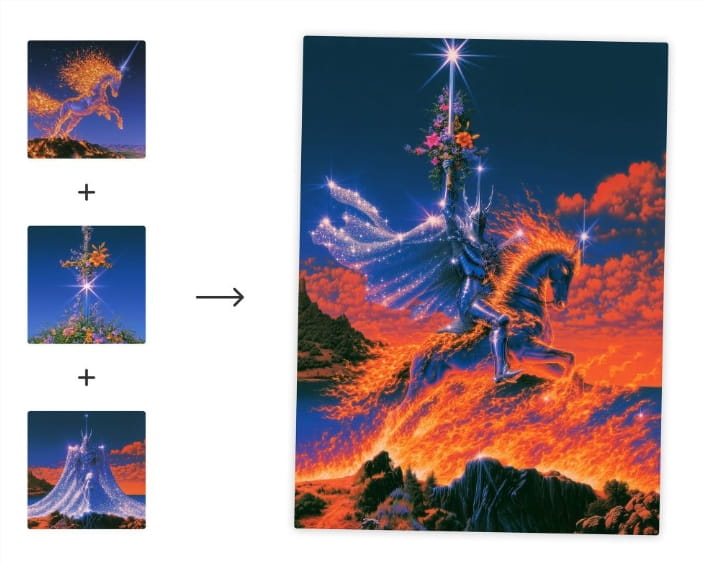
在V8.2之前,Midjourney的全景参考(omni-reference)功能允许用户上传一张参考图来引导整体风格或构图。然而,单一参考往往难以满足复杂创作需求。V8.2彻底重构了这一机制,推出全新的多图参考生成功能,单次最多可融合四张不同来源的图像。
这一升级为跨风格融合、元素拼接和概念混合提供了前所未有的可能性。例如,用户可以同时上传一张梵高风格的星空、一张现代城市夜景、一张人物肖像和一张机械装置图,要求生成“一位站在未来都市屋顶上、凝视着漩涡状星空的机械义体人”。模型会尝试从每张参考图中提取关键视觉特征——笔触、光影、结构、材质——并有机整合到新图像中。
技术上,这依赖于多模态嵌入空间的对齐与加权融合策略。系统并非简单拼贴参考图,而是通过潜在空间中的特征解耦与重组,实现语义层面的创造性合成。不过,参考图之间的风格冲突或语义矛盾仍可能导致输出不稳定,因此官方建议用户在使用时辅以明确的文本提示,以引导融合方向。
局部重绘与画布扩展:突破原始构图限制
对于专业创作者而言,图像的边界从来不是创作的终点。V8.2引入的局部重绘(inpainting)和画布扩展(outpainting)功能,正是为了解决这一痛点。
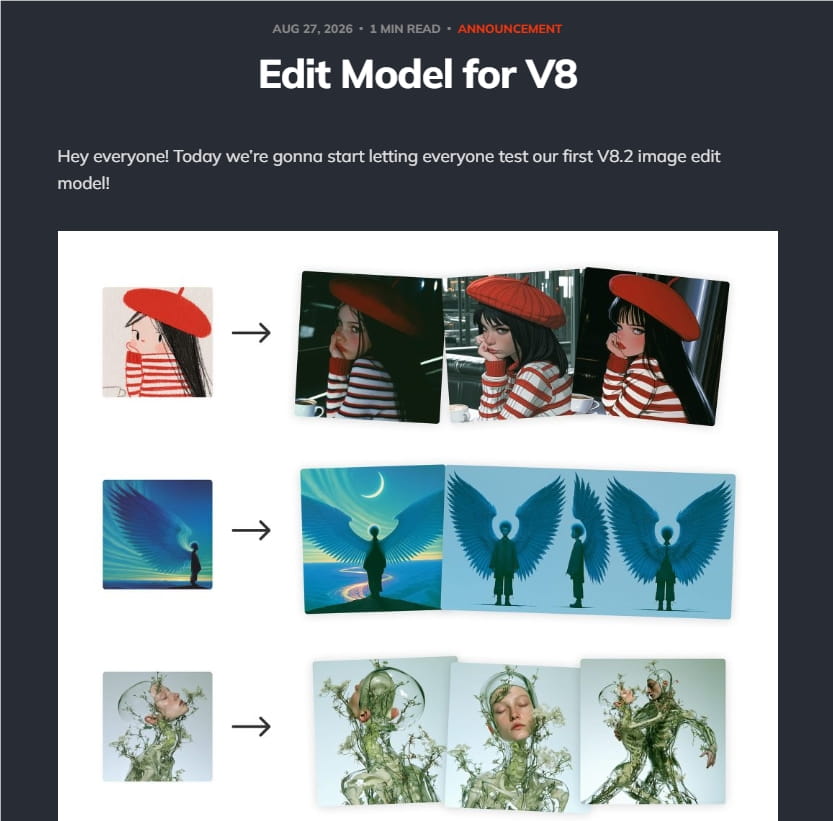
局部重绘允许用户选定图像中的任意区域进行重新生成。无论是修复瑕疵、替换元素,还是添加新细节,都可在保持其余部分不变的前提下完成。例如,在一幅风景画中,用户可以圈出天空区域,输入“暴风雨来临前的乌云”,系统将仅重绘该区域,同时确保与下方山峦的光影和透视关系自然衔接。
画布扩展则更进一步,支持向图像四周延展内容。用户可选择向左、右、上、下或任意组合方向扩展画布,AI会基于原始图像的构图逻辑、透视规律和风格特征,智能生成连贯的延伸内容。这对于制作横幅海报、全景图或需要预留排版空间的设计稿尤为实用。
这两项功能的实现,依赖于模型对图像上下文的深度理解能力。它不仅要“看到”像素,更要“理解”场景的三维结构、光源方向和物体间的空间关系。尽管目前在处理复杂透视或多物体交互场景时仍有局限,但其表现已远超早期基于补丁拼接的outpainting方案。
工作流整合:无缝接入现有创作习惯
Midjourney深知,再强大的功能若无法融入用户习惯,也难以发挥价值。因此,V8.2在交互设计上做了大量优化,提供多种调用路径以适配不同使用场景。
最直观的方式是在官网预览灯箱中点击右下角的“编辑”按钮,系统会自动加载当前图像进入编辑模式。对于习惯在Discord中操作的用户,只需在频道中回复生成消息并附加编辑指令(如“/edit prompt: add a cat on the windowsill”),即可触发V8.2处理。此外,用户还可直接将图片拖入提示词输入框,选择“附加到提示”,实现图文混合输入。
这种多入口设计降低了学习成本,也让编辑功能自然嵌入到从灵感到成稿的完整流程中。创作者可以在生成初步结果后立即进行微调,无需切换工具或导出导入文件,极大提升了迭代效率。
兼容性与协同:情绪板、风格参考与个性化设置
V8.2并未抛弃Midjourney已有的强大生态,而是将其与新编辑功能深度融合。用户仍可使用个性化设置(如--v 8.2 --style raw)、情绪板(mood boards)和风格参考(srefs)来引导生成方向。
尤其值得注意的是,官方特别提醒:在使用情绪板或srefs时,配合额外的文本提示效果更佳。这是因为情绪板主要提供色彩、质感和氛围的隐式引导,而文本指令则能明确表达结构和内容需求。两者结合,可实现“感性氛围+理性控制”的双重引导。
例如,上传一组蒸汽朋克风格的情绪板,同时输入“一位戴护目镜的女工程师正在修理齿轮驱动的飞行器”,模型既能捕捉铜管、铆钉、皮革等材质细节,又能准确构建人物动作与机械结构的逻辑关系。
测试阶段的挑战与社区共建
尽管V8.2展现了强大的潜力,但官方坦承其仍处于高频迭代的测试阶段。在处理极端光照、复杂遮挡、非刚性形变或抽象概念时,模型可能出现语义错位、结构崩坏或风格漂移等问题。
为此,Midjourney建立了高效的反馈机制。用户可通过灯箱右侧的表情符号快速标记问题,或提交任务ID供开发团队复现。同时,官方Discord频道设有专门的“创意与功能建议”区,鼓励用户分享使用案例、提出改进建议。
这种开放协作的模式,不仅加速了模型的优化进程,也构建了一个活跃的创作者社区。许多早期测试者已开始探索V8.2在概念设计、插画细化、广告视觉甚至影视分镜中的应用,不断拓展AI绘画的边界。
对行业生态的深远影响
V8.2的发布,标志着AI绘画工具正从“黑箱生成器”向“可控创作平台”转型。它不再要求用户一次性写出完美提示词,而是允许在生成后持续对话、调整、完善——这更符合人类的创作直觉。
对专业设计师而言,这意味着AI可以真正成为草图深化、方案迭代的得力助手;对业余爱好者来说,则降低了高质量视觉创作的门槛。更重要的是,这种“生成+编辑”的混合范式,可能推动整个行业从追求“惊艳首图”转向重视“可控流程”和“创意迭代效率”。
未来,随着模型对物理规律、艺术史知识和用户意图的理解不断加深,AI绘画或将真正实现“所想即所得”的终极愿景。而V8.2,无疑是通往这一未来的关键一步。