TAVR技术解析:基于视频参考的高保真数字人生成新范式
在人工智能驱动的数字内容创作领域,高保真说话头像(talking avatar)的生成一直是核心挑战之一。传统方法普遍依赖单张静态图像作为身份参考,这种“一图定终身”的模式虽在特定条件下表现尚可,却存在根本性局限:模型必须从单一视角、固定表情和恒定光照中推断出人物在动态交互中的全部视觉特征。当目标场景与参考图像环境差异显著时,身份失真、伪影生成等问题尤为突出。TAVR(Talking Avatar from Video Reference)技术的提出,正是对这一范式的根本性革新——它将输入源从静态图像升级为包含丰富时空信息的短视频片段,从而在跨场景条件下实现前所未有的身份保真度。
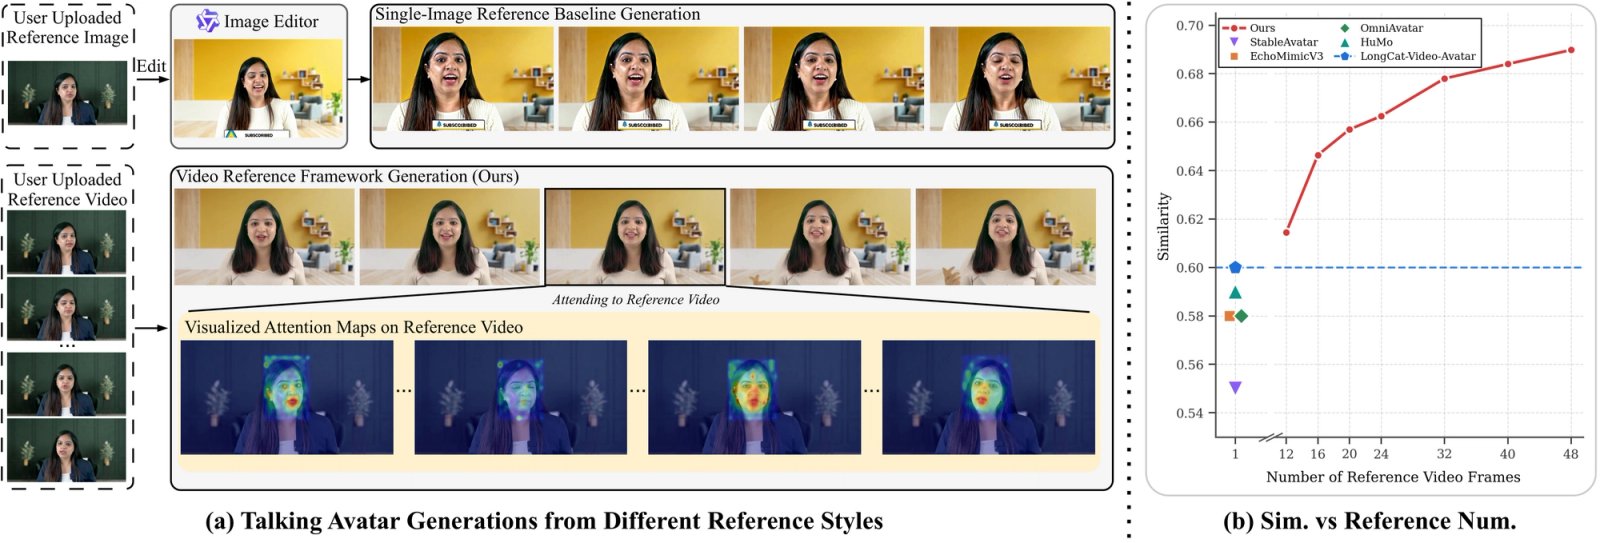
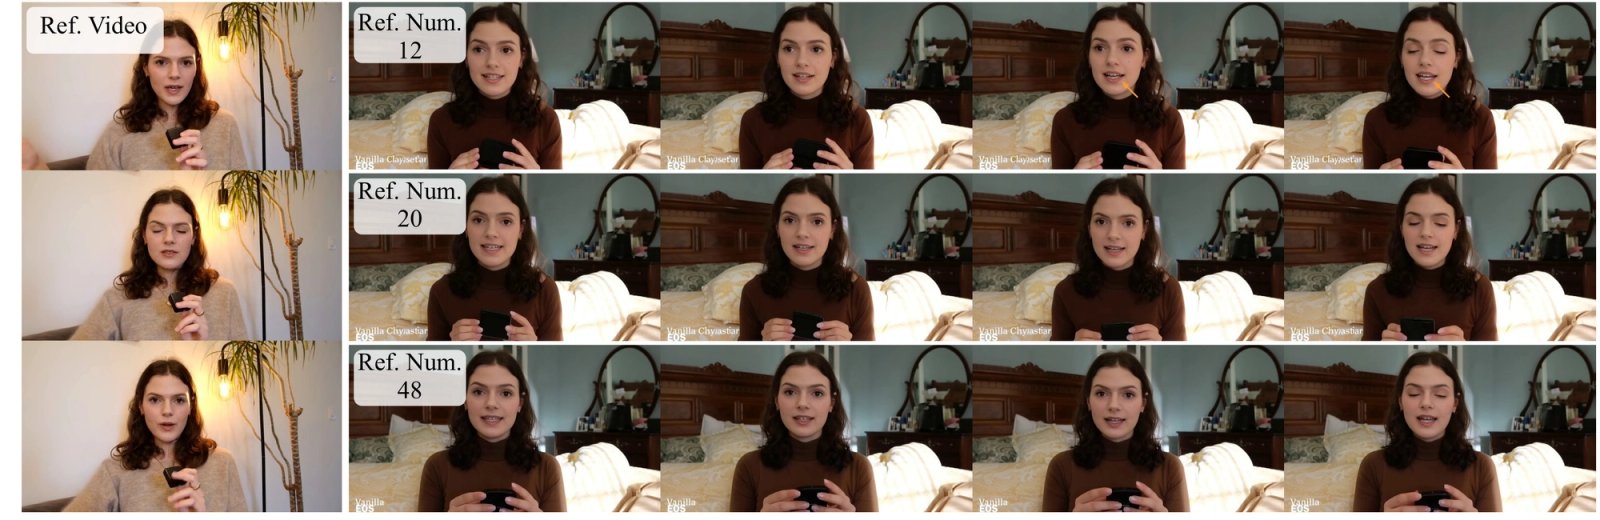
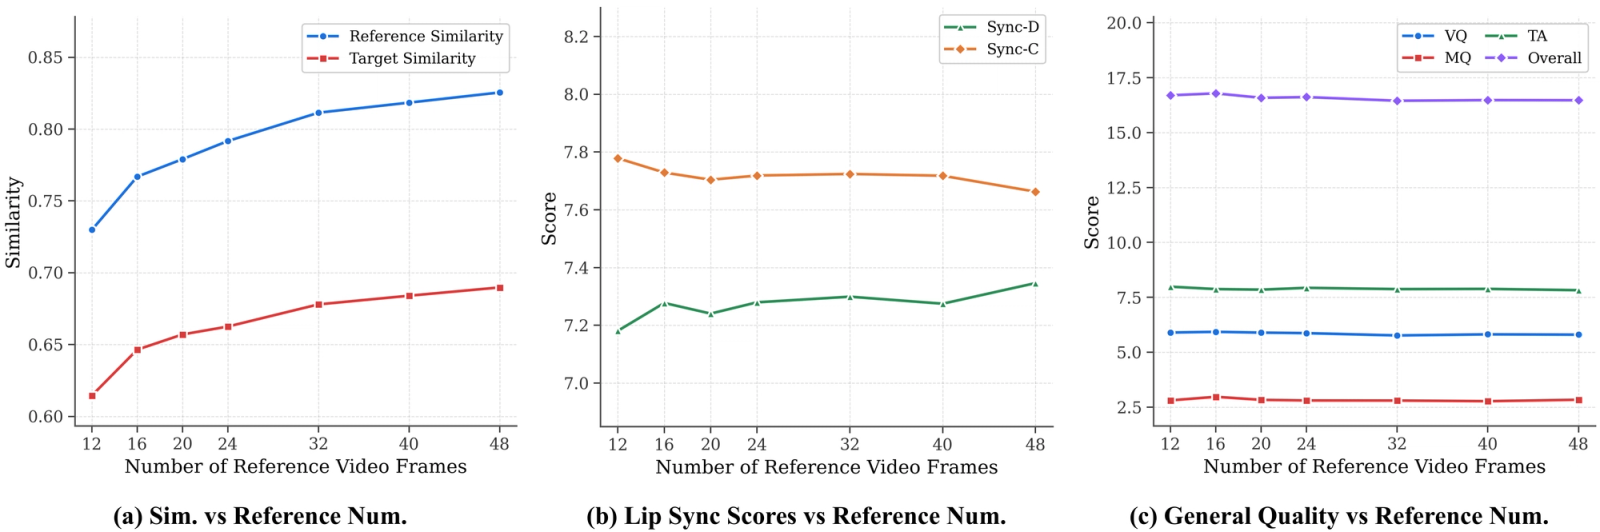
视频参考之所以关键,在于其天然蕴含的多维动态信息。一段仅数秒的视频可捕捉数十个不同角度的人脸姿态、微妙的表情变化以及多样化的光照条件。TAVR充分利用这一优势,设计了可接受12至48帧不等长度视频输入的灵活架构。实验数据明确显示,随着参考帧数从12增加到48,身份相似度呈现持续上升趋势,而唇形同步准确率与整体视频质量保持稳定,证明身份信息的增强并未以牺牲生成稳定性为代价。更具说服力的是视觉对比:在12帧条件下,模型因缺乏口腔内部先验知识而频繁产生牙齿伪影;当参考帧增至48帧时,丰富的上下文提供了明确的视觉线索,此类伪影被彻底消除。这种从“猜测”到“观察”的转变,是TAVR实现质变的核心逻辑。
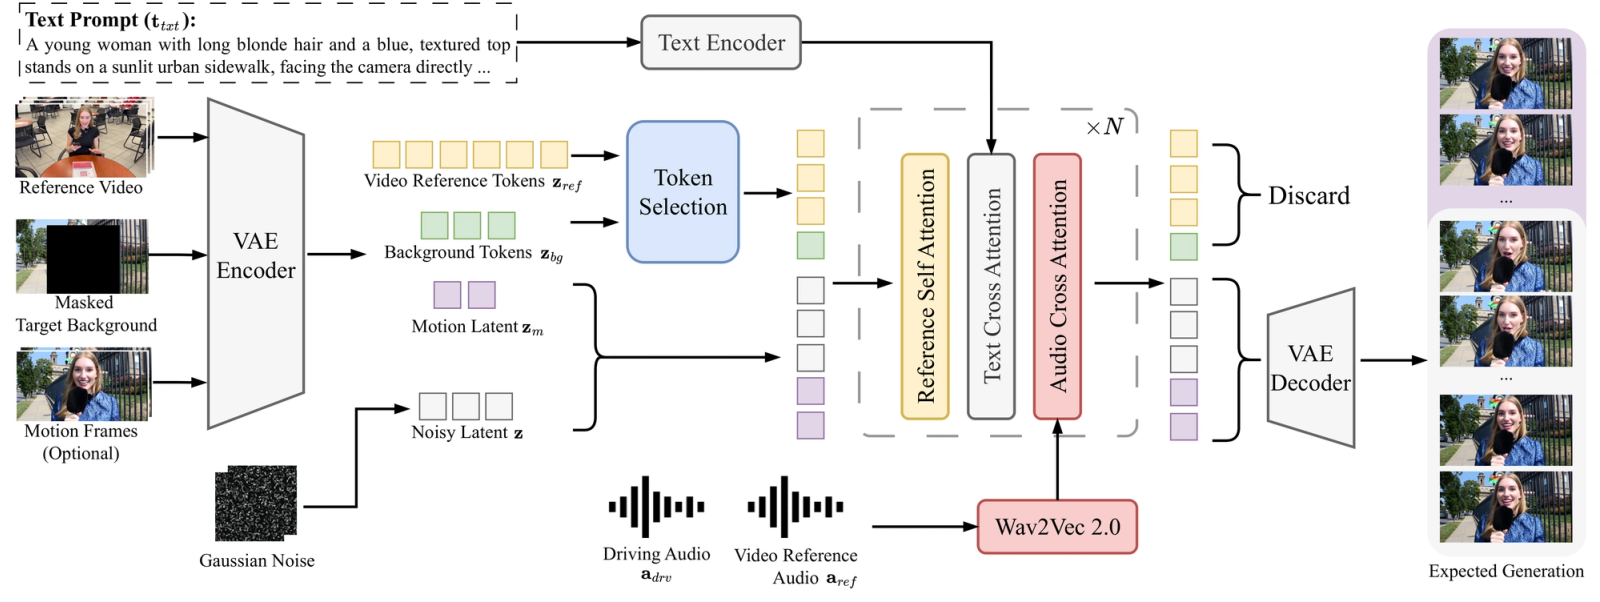
TAVR的架构建立在Wan2.1-T2V-14B视频扩散模型基础之上,但针对说话头像生成任务进行了深度定制。其创新点集中体现在四个相互协同的组件中。首先是灵活的视频引用机制,允许模型动态利用不同长度的时序上下文,使身份表征随输入信息量自适应增强。其次是Token选择模块,该模块在潜在空间中对视频参考编码后的海量Token进行智能过滤——通过人脸检测框精准定位身份相关区域,剔除背景及冗余信息,在保证信息完整性的前提下大幅降低计算开销。第三项创新是参考自注意力(Reference Self-Attention)机制,它重构了标准自注意力层,使目标生成序列与参考Token能在统一上下文中联合计算注意力权重,从而将丰富的身份线索无缝注入生成流,避免了传统交叉注意力模块可能引入的信息瓶颈。最后是音频交叉注意力模块,它采用逐帧对齐策略,一方面确保驱动音频与生成画面的精确唇形同步,另一方面将参考视频中的原始音频作为时序锚点,建立参考流内部的音视频对应关系,强化身份动态特征的学习。
对于超过基础模型3秒生成窗口的长视频需求,TAVR设计了精巧的运动帧延续策略。具体而言,系统将前一段生成结果的末尾潜在帧作为运动先验传递给下一段生成过程,确保头部转动、表情过渡等动态特征的连贯性。同时,为防止长时间生成导致的身份漂移,TAVR引入全局外观锚定机制:在每段生成中,将当前被掩码处理的背景区域替换为整个序列首帧的潜在表示。这种双重保障既维持了动作流畅性,又锁定了核心身份特征,使分钟级长视频生成成为可能。
跨场景生成面临的最大障碍是域间差异——参考视频可能在室内摄影棚拍摄,而目标场景却是户外街景。为弥合这一鸿沟,TAVR采用渐进式三阶段训练策略。第一阶段为同场景预训练,利用大规模同源视频数据(参考与目标来自同一视频片段),让模型掌握基础的身份复制与动作再现能力,此时无需考虑环境差异。第二阶段转向跨场景微调,参考与目标分别采样自同一人物的不同视频,迫使模型学习剥离环境干扰、提取本质身份特征的能力,而非简单进行像素级复制。第三阶段引入基于直接偏好优化(DPO)的强化学习,以ArcFace计算的身份相似度作为奖励信号。特别值得注意的是,该阶段采用空间掩码策略,仅对前景人物区域计算奖励,有效避免了背景像素对身份评估的干扰,使优化目标高度聚焦于核心任务。
为客观评估跨场景视频参考生成的性能,研究团队构建了首个专用评测基准。该基准从TalkVid数据集中精心筛选158组高质量跨场景视频对,每对均展示同一人物在视觉差异显著的环境中(如办公室vs海滩)。为确保评测严谨性,所有配对均通过ArcFace阈值验证面部一致性,并通过保留每人物身份中背景PSNR最低的配对来最大化场景差异。这一基准填补了现有评测体系的空白——传统基准多使用同场景单图参考,无法反映真实应用场景中的跨域挑战。
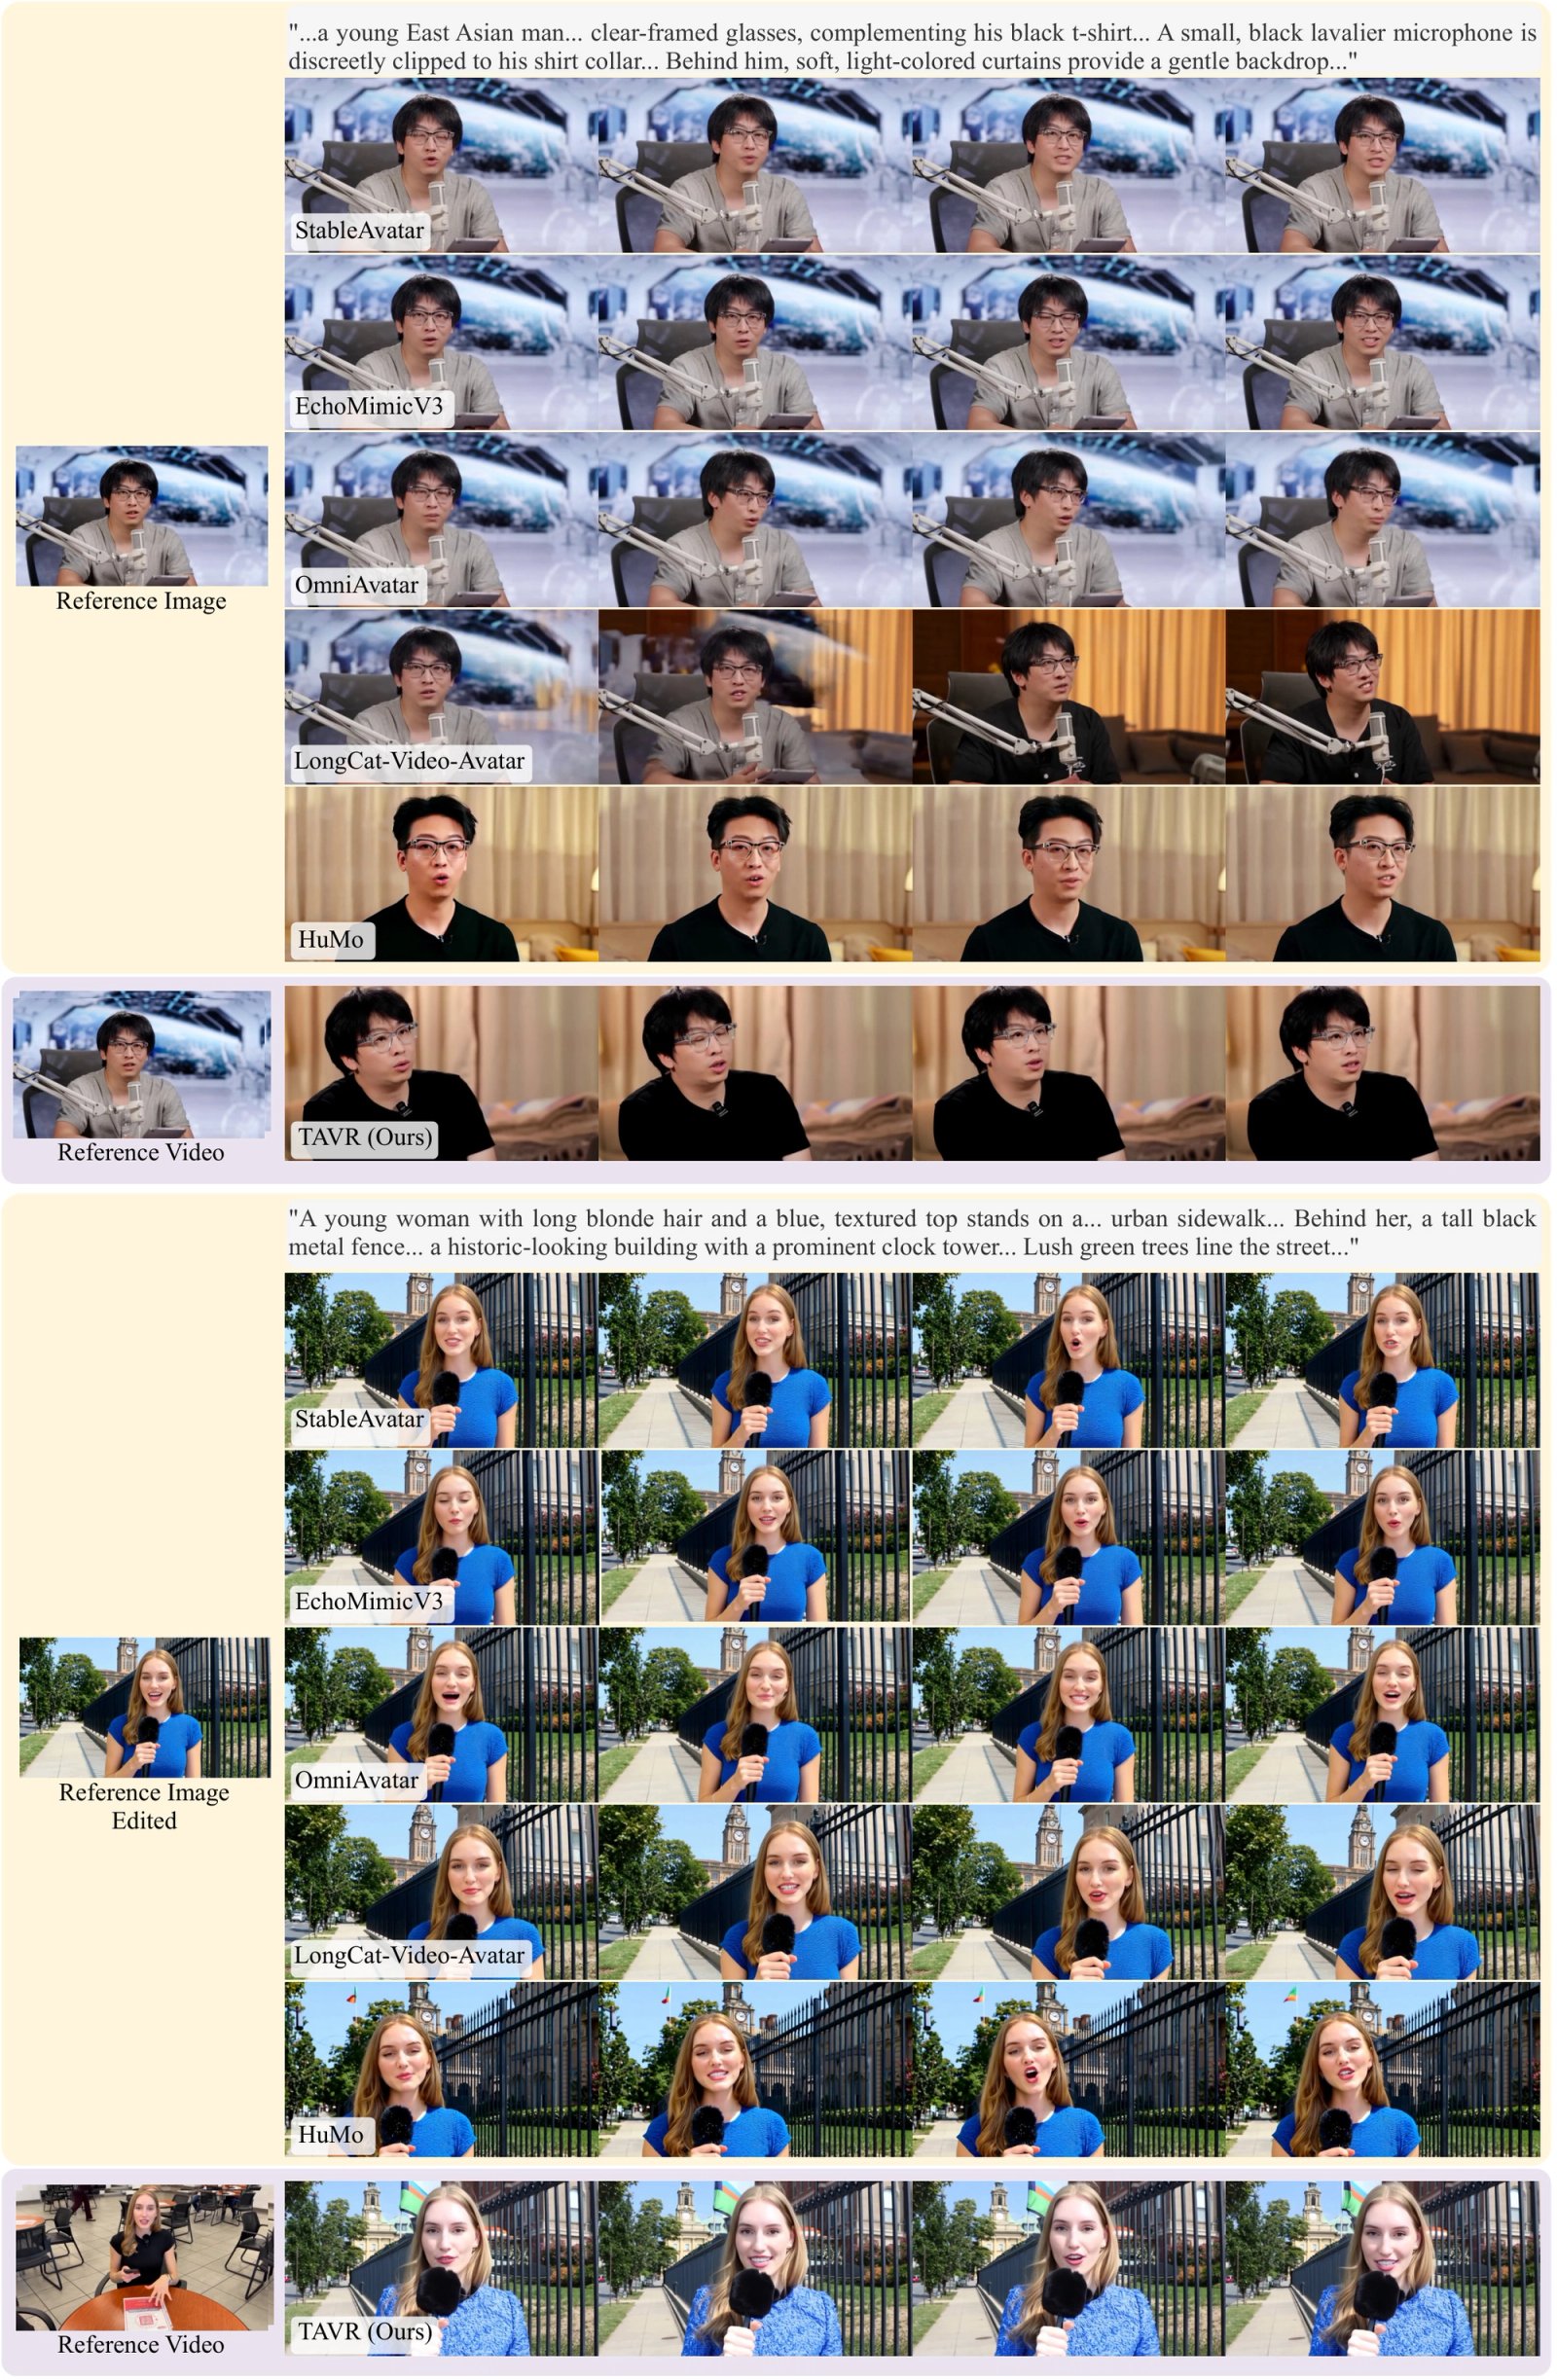
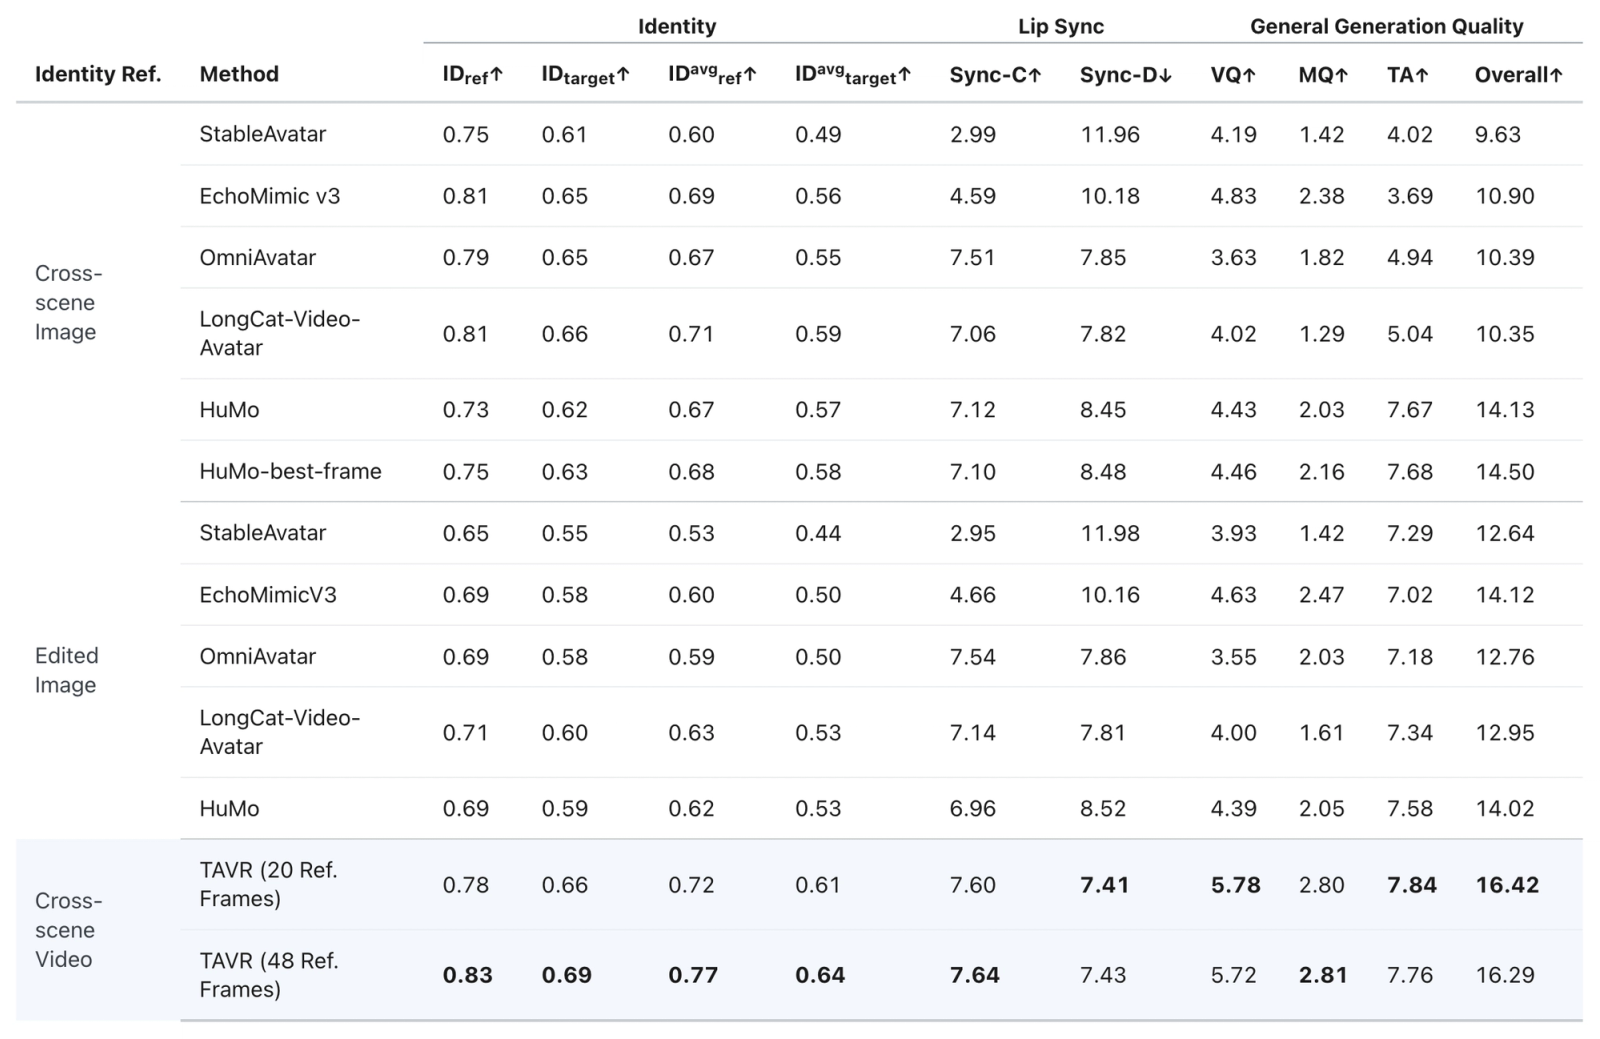
在新建基准上的量化结果充分验证了TAVR的优越性。当使用20帧参考视频时,TAVR取得16.42的综合质量分,显著领先于次优方法HuMo的14.13分。在48帧条件下,其身份相似度达到参考场景0.83、目标场景0.69,均为当前最高纪录。尤为关键的是,即使与“神谕基线”(即向HuMo提供与目标最相似的单帧参考)相比,TAVR仍以0.64对0.58的身份相似度和16.29对14.50的综合质量分保持明显优势。这确凿证明TAVR的性能增益源于多帧信息的有效聚合,而非偶然获取了更优的单帧。视觉对比同样令人信服:在背景差异巨大的场景中,TAVR生成的头像不仅五官细节更贴近真人,肤色、发质等纹理特征也保持高度一致,而其他方法则普遍存在面部结构扭曲或肤色偏移问题。
TAVR的技术突破具有深远的应用价值。它标志着数字人生成从静态图像时代迈向动态视频时代的范式转移。用户不再需要专业摄影设备或精心布置的拍摄环境,仅需一段普通的手机自拍短视频,即可生成高度逼真的数字分身。这一能力已集成至HeyGen平台的视频参考数字人产品中,大幅降低高质量数字人创建门槛。从技术演进角度看,TAVR证明了时序身份信号对动态表征学习的不可替代性——人类身份的本质是动态的,静态快照无法承载其全部信息。未来,随着视频参考机制与更先进的时序建模技术结合,数字人生成有望在情感表达、微表情模拟等维度实现进一步突破,为虚拟社交、远程协作、数字娱乐等领域带来更自然、更可信的交互体验。