谁在赚机器人的「学费」?具身智能数据产业链深度解析
近年来,随着具身智能(Embodied AI)技术的突破,机器人正从实验室走向真实世界。但要让机器人在厨房叠衣服、在仓库搬箱子、在餐厅端盘子,仅靠算法远远不够——它们需要大量来自物理世界的“经验”。于是,一个看似不起眼却至关重要的环节浮出水面:谁在为机器人提供“教材”?谁又在从中赚钱?
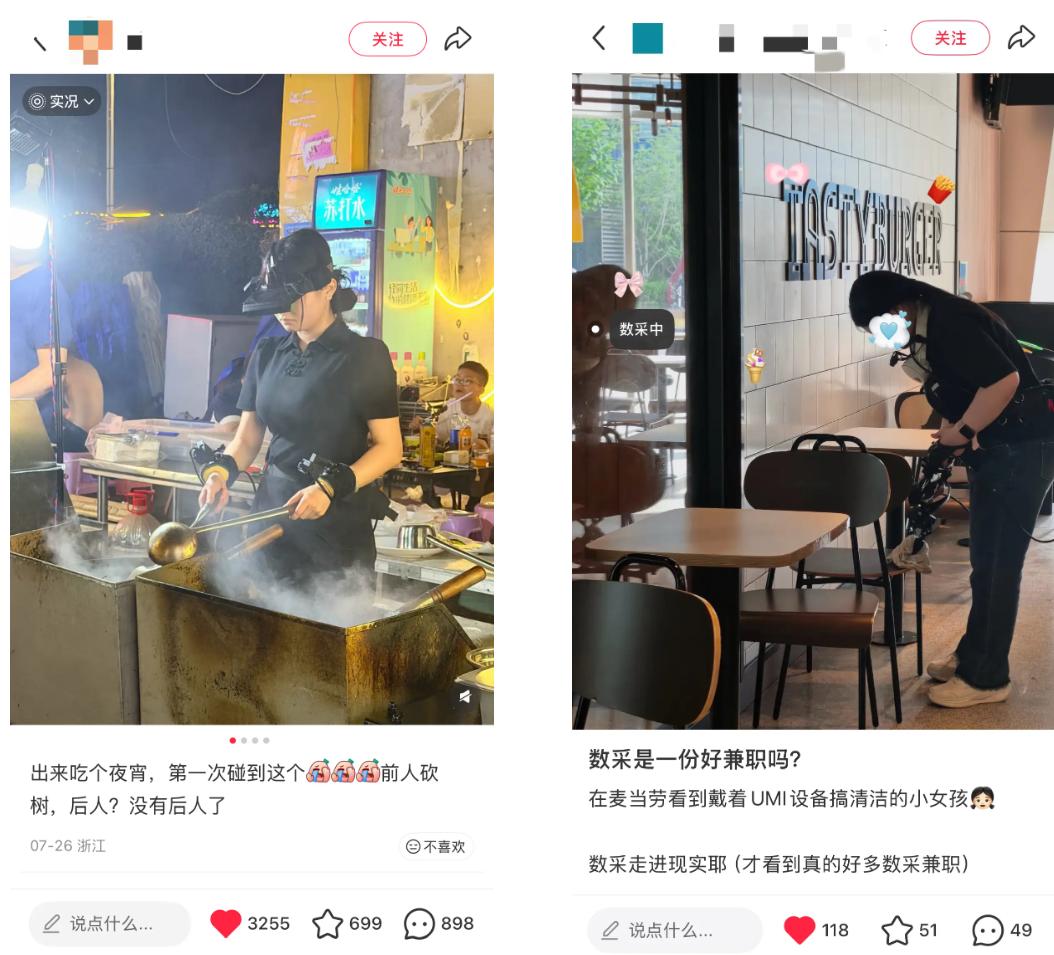
在山东,50多岁的全职妈妈高波每天用手机记录自己做饭、洗衣、打扫的过程,六小时可收入120元。这些第一视角视频经过处理后,成为机器人学习家务动作的训练素材。类似场景在全国各地上演:麦当劳员工佩戴采集设备清洁餐桌,厨师在颠锅时同步记录手腕轨迹……这标志着具身数据正式进入“众包”时代。
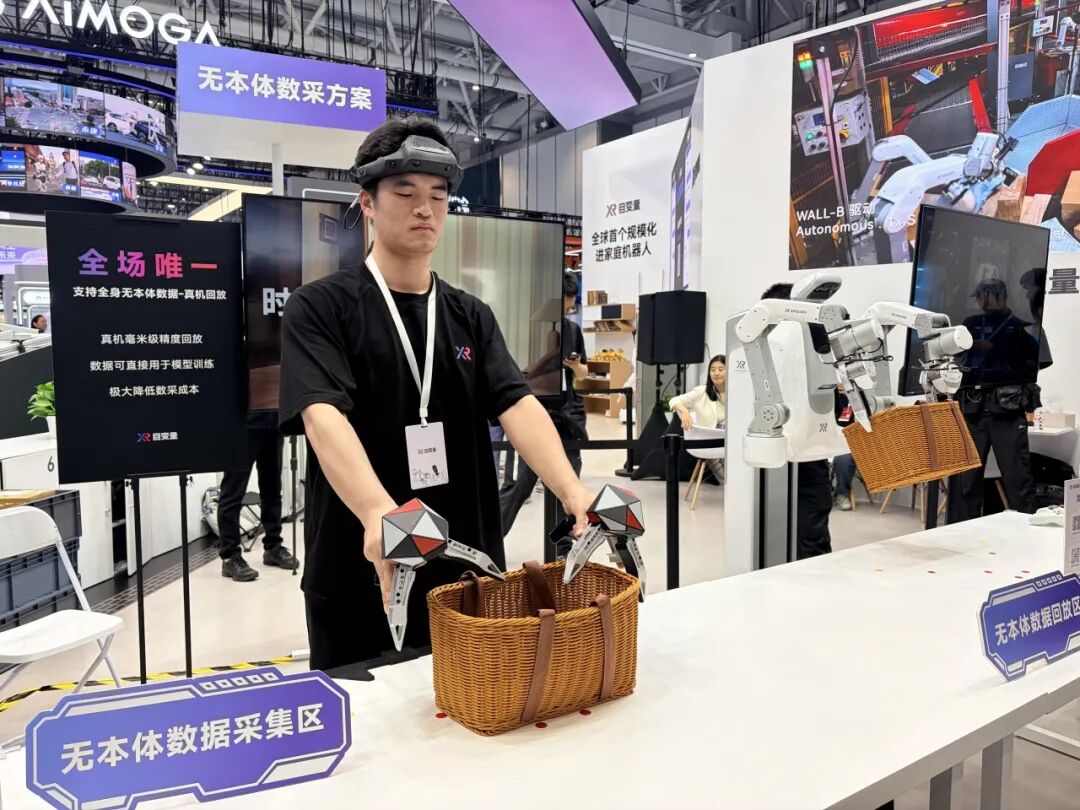
过去,机器人训练数据主要依赖专业采集员在封闭训练中心遥控真机完成。这种方式成本高、效率低——一名训练员通常只能操作一台机器人,一天仅能完成几十次有效采集。而如今,借助轻量化的无本体采集设备(如头戴式EGO相机、手持UMI通用操作接口、腕部触觉传感器等),普通人也能成为“机器人老师”,大幅降低数据获取门槛。
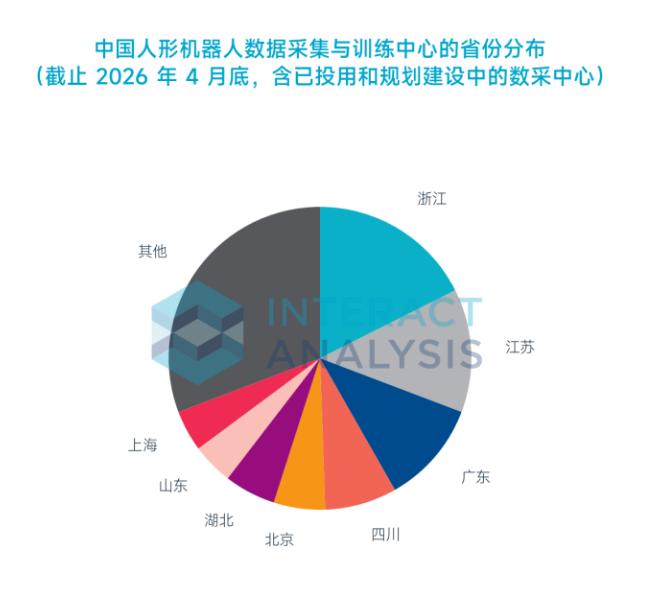
据Interact Analysis统计,截至2026年4月,全国已投用的数据采集与训练中心达64个,在建及规划项目超90个,其中13个中心部署了上百台机器人。这些中心复刻家居、商超、仓储等真实场景,形成“机器人课堂”。与此同时,招聘平台涌现大量“具身智能数据采集员”岗位,部分甚至不要求经验,反映出行业对人力的迫切需求。
这股热潮背后,是机器人行业重心的转移。当本体结构、关节控制和全身运控技术日趋成熟,机器人已能完成跑步、跳舞等复杂动作,真正的瓶颈转向“理解物理世界”。当前主流方法是借鉴AI大模型的Scaling Law——通过海量数据提升模型泛化能力。行业估算,目前全球积累的高质量具身训练数据约50万小时,而要实现智能涌现,可能需要1亿小时以上,缺口高达200倍。
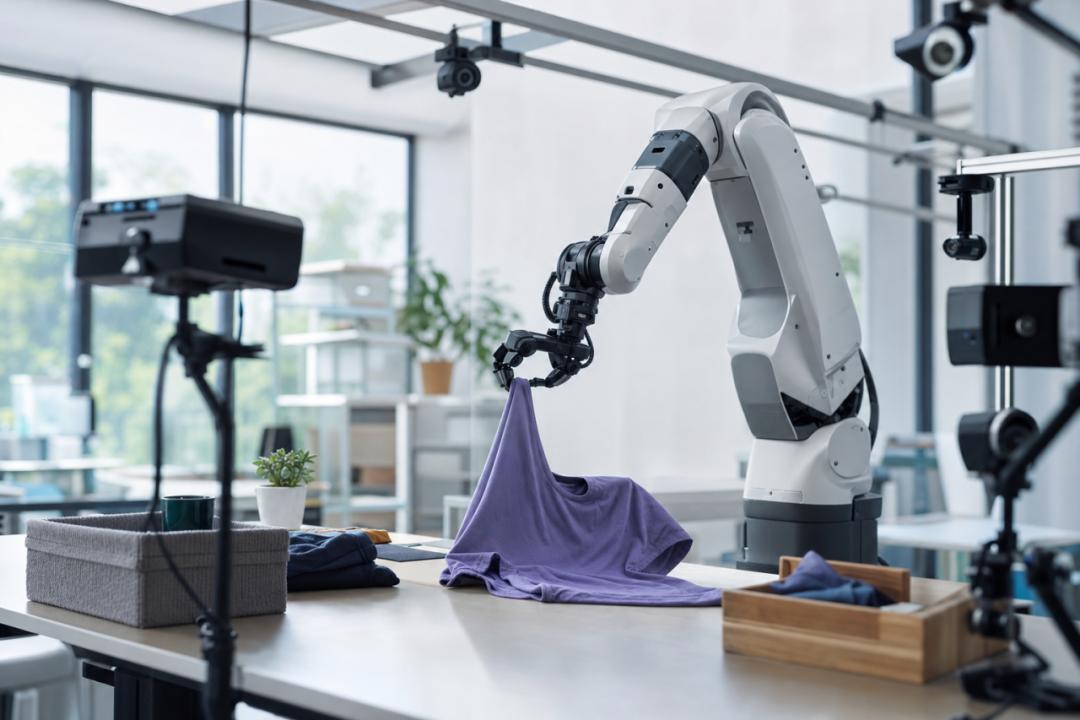
面对如此巨大的数据鸿沟,传统真机采集显然力不从心。无本体采集因此成为破局关键。它不仅成本更低,还能覆盖更丰富的环境变量——不同光线、地面材质、物体摆放方式等,这些都是提升泛化能力的关键因子。政策也在推波助澜:2026年6月,工信部与国资委启动“实景实训专项行动”,计划年底建成100+高价值应用场景,推动万台级机器人落地。
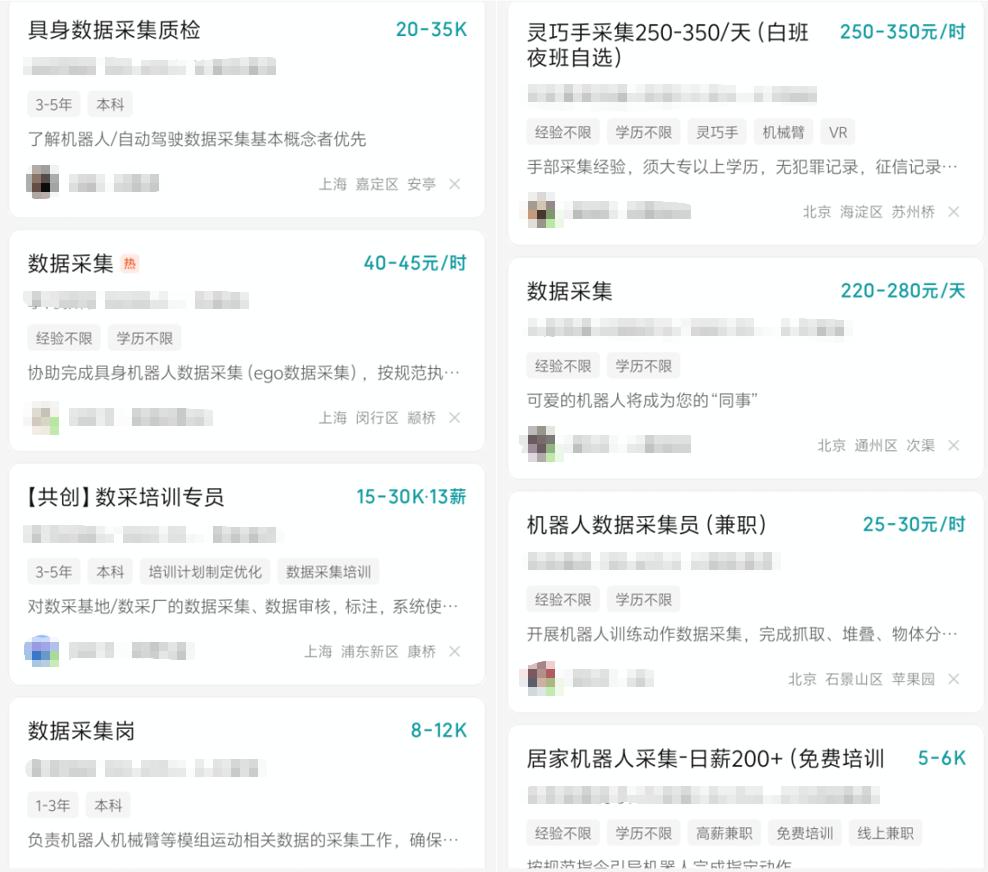
在这条迅速膨胀的产业链上,各类玩家纷纷入场。硬件厂商如奥比中光、途见科技扮演“卖铲人”角色,前者将3D视觉技术延伸至EGO和UMI设备,后者以柔性电子皮肤打造触觉手套;本体厂商如优必选、自变量则“既造车又修路”,通过承接地方政府数采中心项目(如惠州、呼和浩特项目合计超1.3亿元)绑定设备销售与数据闭环;平台型公司如智元孵化的觅蜂科技,则试图整合采集、治理、训练、评测全流程,成为数据生产的“操作系统”;而京东、仙工智能等拥有现成场景的企业,则利用物流、零售、工厂等真实环境进行“边运行边采集”,仙工甚至宣称其机器人大脑已积累超50万小时真机数据。
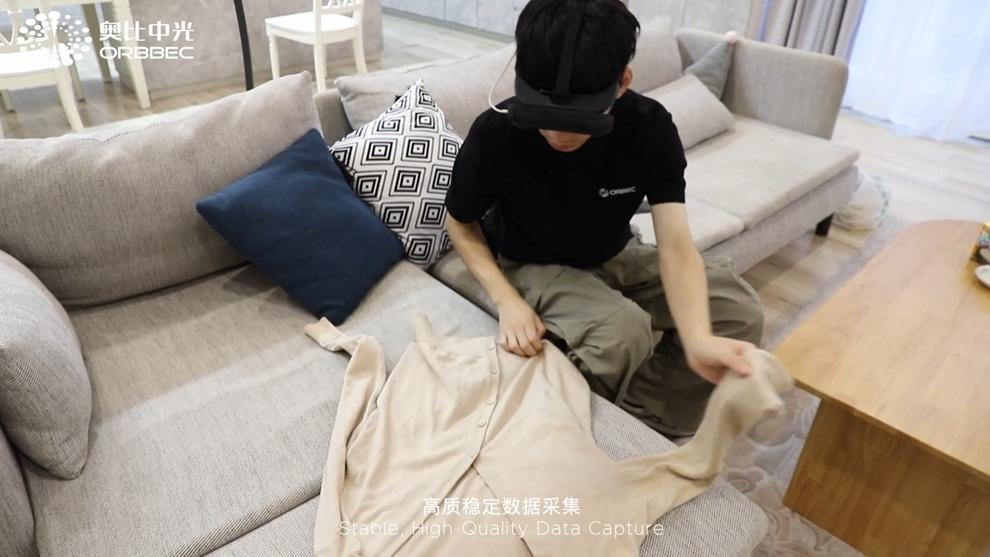
然而,数据多≠能力强。今年6月,机器人公司XDOF的一项实验揭示了残酷现实:当团队向叠T恤模型加入更多“成功示范”后,成功率反而从100%暴跌至0%。问题出在那些看似合格的视频中——人类操作包含停顿、调整、重新抓取等“无效动作”,而机器人会不加分辨地全盘模仿。这暴露了行业核心痛点:缺乏对“有效学习内容”的判断力。
一条人类动作要转化为机器人能力,需经历多重筛选。首先,任务定义决定采集维度:搬箱子重稳定与节奏,拧螺丝重精度与力控,叠衣服则需处理形变与遮挡。其次,原始数据需通过三重“有效性”检验:采集有效(任务完成、无遮挡、传感器正常)、数据集有效(清洗标注后可接入训练管线)、模型有效(实际提升成功率与泛化性)。目前多数供应商仅能保证前两层,而客户真正买单的是第三层——这种错位导致交易困难。
更复杂的是,具身数据高度依赖机器人本体结构与模型架构。六轴与七轴机械臂、两指夹爪与五指灵巧手、不同摄像头布局……都会导致同一段轨迹在不同系统中无法直接复用。这意味着数据难以标准化交易,客户往往提出定制化需求:“我的机器人执行某任务成功率仅60%,请设计一套数据补采与训练方案。”这种服务模式虽精准,但成本高、周期长。
宇树科技创始人王兴兴曾指出,机器人每次输入输出都可能产生偏差与损失,这是泛化能力不足的根源。从人类动作到机器人学会,中间存在一条数据折损链——原始视频→动作提取→坐标映射→控制指令→物理执行,每一步都可能失真。因此,行业尚未找到“喂够X小时数据=Y%能力提升”的公式。
这种不确定性直接影响商业模式。目前,产业链中最先变现的是基础设施建设:相机、手套、遥操作系统、机器人本体均可按件结算,训练场也可按面积验收。但一旦涉及纯数据交易,风险陡增。多地政府在采购机器人项目时,要求厂商“回购数据”,实则是为重资产投入加一道保险。据估算,专业遥操员8小时仅产出2-3小时有效数据,真机数据报价500-1000元/小时,高端采集员月薪达8000-15000元,成本压力巨大。
头部企业已开始调整策略。美国Figure公司曾尝试外购数据,后因质量与适配问题转向自建Index众包平台,向全球用户征集日常视频,已支付1500万美元。国内厂商则探索混合采集模式:用低成本无本体设备扩大人类示范规模,用仿真生成海量环境变异与失败案例,再以少量真机数据完成最终校准。英伟达曾用11小时生成78万条合成轨迹,相当于6500小时人工数据,极大压缩成本。
另一条出路是推动标准化。2025年底,浙江检测中心通过统一数据格式与接口,成功整合全国11个点位的真实、仿真与测试数据。2026年3月以来,多项具身智能数据规范陆续立项,旨在降低跨系统适配成本。虽然无法消除本体差异,但至少能让数据“可读、可用、可评估”。
展望未来,具身数据产业仍处爆发前夜。一旦基础模型技术路线收敛、行业标准形成共识,高质量数据的价值将被重新定价。届时,真正能赚钱的或许不是单纯的数据“搬运工”,而是那些掌握任务定义能力、数据治理能力与模型反馈闭环能力的综合服务商。毕竟,机器人要的不是海量视频,而是能教会它“在不确定世界中稳健行动”的智慧——这份学费,终究要为真正的理解力买单。