Claude Desktop被‘偷梁换柱’:本地代理如何绕开Anthropic模型限制?
近期,人工智能工具生态中上演了一场颇具技术巧思的“越狱”事件:Ollama 在其 v0.33.0 版本中,通过一个精巧的本地代理机制,成功让 Kimi、Qwen、DeepSeek、GLM 等非 Anthropic 模型,在 Claude Desktop 这款由 Anthropic 官方开发的桌面应用中流畅运行。这一操作不仅绕开了四个月前 Anthropic 设下的严格限制,更揭示了当前大模型生态中一个关键趋势——前端用户界面与后端推理引擎的深度解耦。
回顾今年4月,Anthropic 曾短暂开放 Claude Desktop 的第三方网关接口,允许用户连接外部模型服务。Ollama 迅速响应,推出一键集成命令。然而好景不长,Anthropic 很快通过一次更新,在应用层面对模型 ID 实施了白名单校验。即便网关返回了数十个可用模型,Claude Desktop 也仅认可自家的 Opus、Sonnet 等模型 ID,导致所有第三方尝试均告失败。Ollama 被迫下架相关功能,承认集成已“仅限 Anthropic 模型使用”。
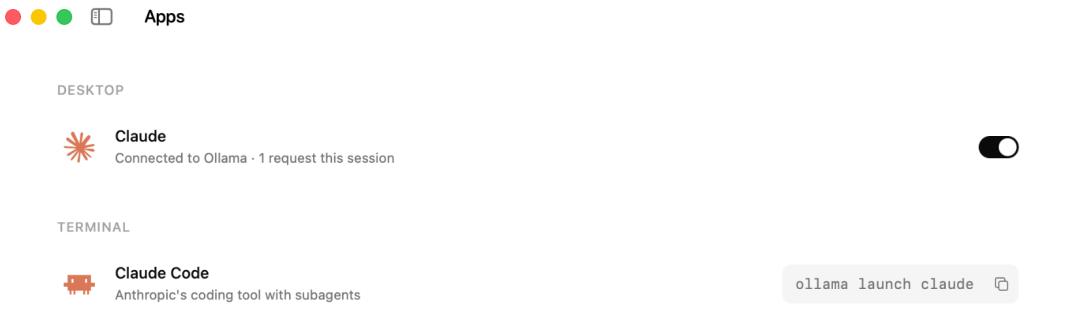
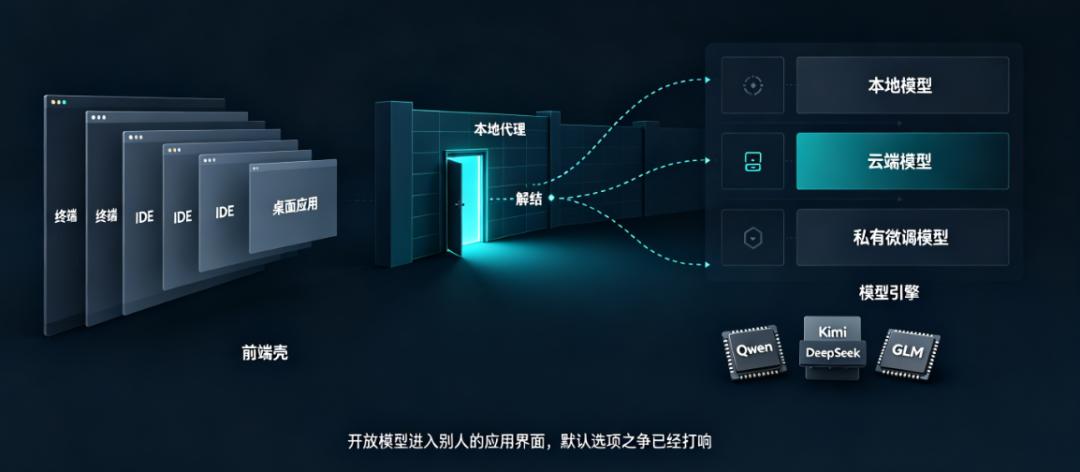
这场猫鼠游戏的转折点出现在8月。Ollama 的新方案没有再去挑战 Anthropic 在应用层设置的校验逻辑,而是巧妙地改变了信任边界的物理位置。新引入的本地代理(其核心代码位于 internal/proxy/claude_desktop.go)作为一个中间人,运行在用户的本机上。当用户在 Claude Desktop 中发起对话时,请求首先被发送到这个本地代理(通常是 127.0.0.1 或 localhost 上的一个端口),而非直接发往 Anthropic 的服务器或任何远程网关。
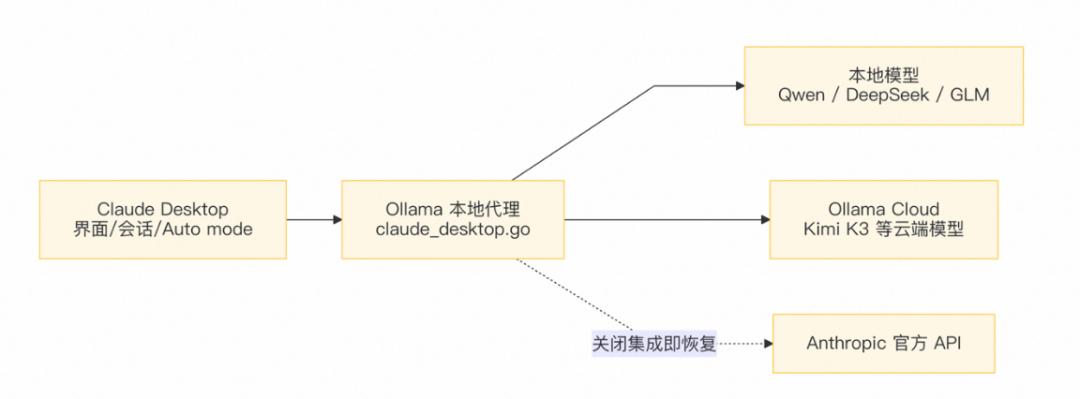
对 Claude Desktop 而言,它只是在与一个“合法”的本地端点通信,完全符合其网络策略。而这个本地代理拿到请求后,会根据用户的预设配置,将其转发给 Ollama 所托管的任意模型——无论是本地运行的 Qwen-72B,还是云端的 Kimi K3。整个过程对 Claude Desktop 是透明的,它既看不到真实的模型 ID,也无法干预请求的最终去向。校验环节被有效地“内化”到了用户完全掌控的本机环境中,从而绕开了 Anthropic 的远程封锁。
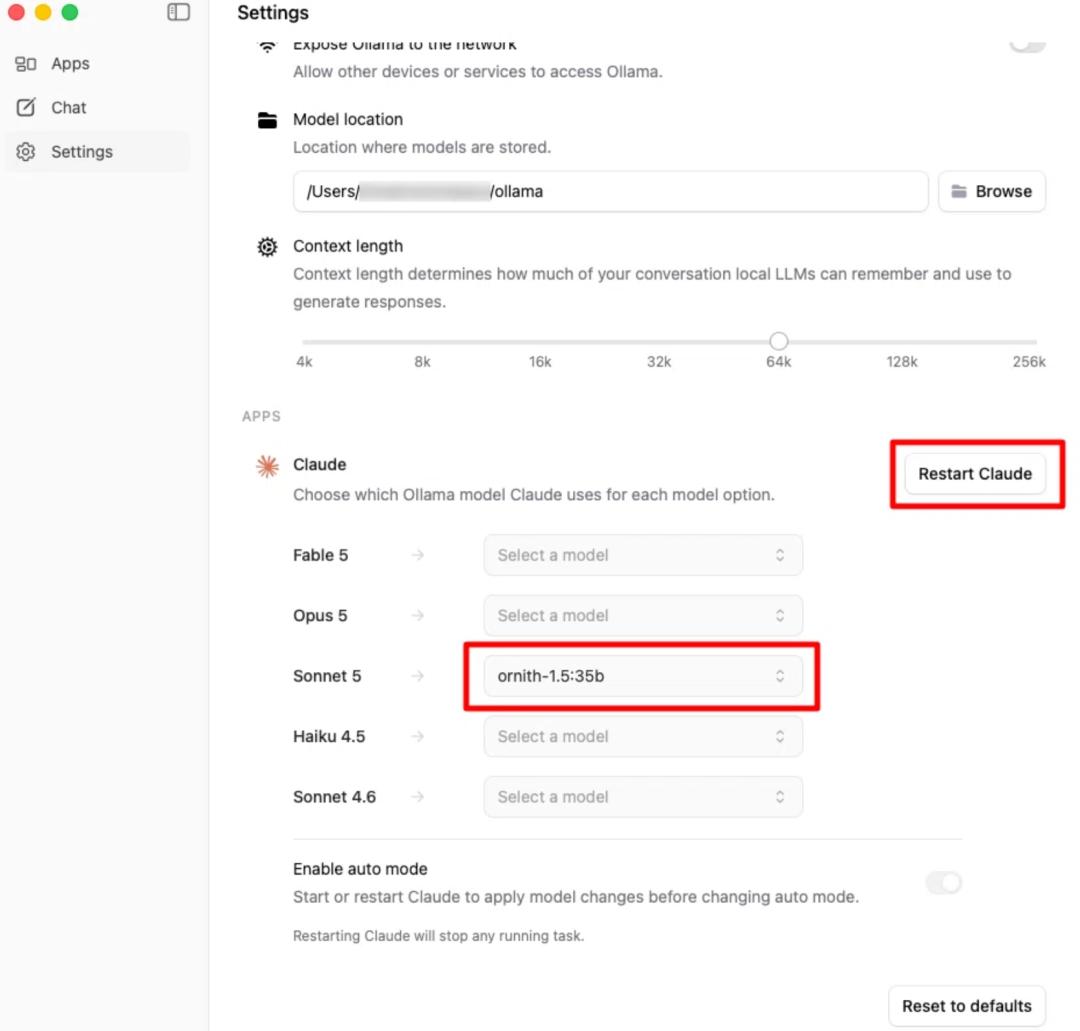
这一机制的核心创新在于“槽位重映射”(Slot Remapping)。Claude Desktop 的用户界面是围绕 Anthropic 自家的模型家族设计的,下拉菜单里只有 Opus、Sonnet、Haiku 等选项。Ollama 的解决方案极具巧思:它允许用户将这些预设的“槽位”映射到任意第三方模型。例如,用户可以将界面上的 “Opus 5” 槽位,实际指向 Kimi K3;将 “Sonnet 5” 槽位,指向 DeepSeek V4 Pro。这样一来,用户无需改变任何操作习惯,依然在熟悉的 Anthropic 界面中工作,但底层的推理引擎早已被替换。这种“换汤不换药”的策略,极大地降低了用户的迁移和使用门槛。
那么,用户为何要费此周折,在 Claude 里运行其他模型?Ollama 给出的官方理由是成本、速度、可移植性和自定义能力。本地运行的开源模型意味着零 API 调用费用,且无网络延迟,对于高频、轻量级的任务极具吸引力。更重要的是,用户可以将自己使用私有数据微调过的专属模型无缝接入日常工作流,这是通用商业模型无法提供的价值。
然而,一个更为关键但未被明说的驱动力是数据隐私与合规性。在企业环境中,处理敏感代码、内部战略文档或客户个人信息时,将数据发送至第三方云端服务存在巨大的合规风险。通过本地代理运行模型,整条数据链路——从输入提示词到生成结果——都严格限定在用户自己的机器内部。配合 Ollama 声明的“零数据保留”政策,这为那些“想用 AI 又怕踩红线”的企业用户提供了切实可行的解决方案。数据不出机,成为这项技术最具现实意义的价值锚点。
有人或许会问,这与之前在终端中通过 Claude Code 集成 Ollama 有何不同?区别在于应用场景的广度。Claude Code 主要服务于开发者,在终端内提供编程辅助。而此次集成将同样的强大能力带入了图形化的桌面应用,覆盖了更广泛的非技术用户群体。无论是撰写报告、进行市场研究、处理合同,还是日常的知识问答,用户都可以在 Claude Desktop 这一统一界面中完成,且能自由选择最合适的模型引擎,无需在多个应用间切换。
将这一事件置于更广阔的产业坐标系中观察,其信号意义十分明显。Ollama 的 CEO Jeffrey Morgan 在7月 B 轮融资后曾明确表示:“AI 的未来,是开放模型在工作发生的每一处地方运行。” Claude Desktop 集成正是这一战略的最新实践。Ollama 并不试图让用户抛弃他们已经习惯的优秀工具(如 Claude),而是选择“寄生”于这些工具之中,默默地将开放模型注入到用户的工作流里。这是一种典型的“润物细无声”式生态扩张策略。
这种“前端壳与后端引擎解耦”的模式并非 Ollama 首创。在开发者社区,LiteLLM、Bifrost 等网关早已成熟,它们能将任何支持 OpenAI API 的应用中的模型调用,无缝重定向到数十家不同的模型提供商。Ollama 此次的贡献在于,将这一强大的能力从命令行世界带入了普通用户触手可及的图形界面,并通过极致简化的配置(一键开关)使其普及成为可能。
当然,这场博弈远未结束。Anthropic 在四月已经展示过其技术反制能力。目前,官方尚未对 Ollama 的新方案作出公开回应。但可以预见,如果 Anthropic 决心彻底封堵这一路径,它可能会采取更激进的措施,例如在应用启动时验证本地代理的合法性,或对请求内容进行更深层次的指纹识别。届时,Ollama 的本地代理能否继续有效,将是一个悬而未决的技术挑战。
无论如何,这次事件已经产生了实质性的影响。Qwen、DeepSeek、Kimi、GLM 等中国及全球的开放模型,首次集体出现在了 Anthropic 官方应用的模型选择器中。这扇由第三方安装的“后门”,虽然未必稳固,却实实在在地在 Anthropic 精心构筑的“围墙花园”上凿开了一个缺口。它证明了在当今的 AI 时代,“默认选项”的争夺战,已经不再局限于应用商店的排名或官网的推广位,而是深入到了竞争对手的应用内部,成为一场关于用户体验、技术架构和生态控制力的全方位较量。
对于广大用户和开发者而言,这无疑是一个利好。它意味着更多的选择、更强的控制力以及更高的灵活性。未来,我们或许会看到更多类似的集成出现,Notion、Obsidian、甚至 Microsoft Office 等主流生产力工具,都可能成为开放模型的新战场。而 Ollama 的打法——不争地盘,只做连接——或许会成为开放模型阵营在巨头林立的 AI 世界中,一条独特而有效的突围之路。