一个周末从 SPEC 到上线:如何用 AiiOnly Token Plan 快速构建 AI 合同避坑工具
需求驱动:为什么普通人需要“跨条款”合同分析
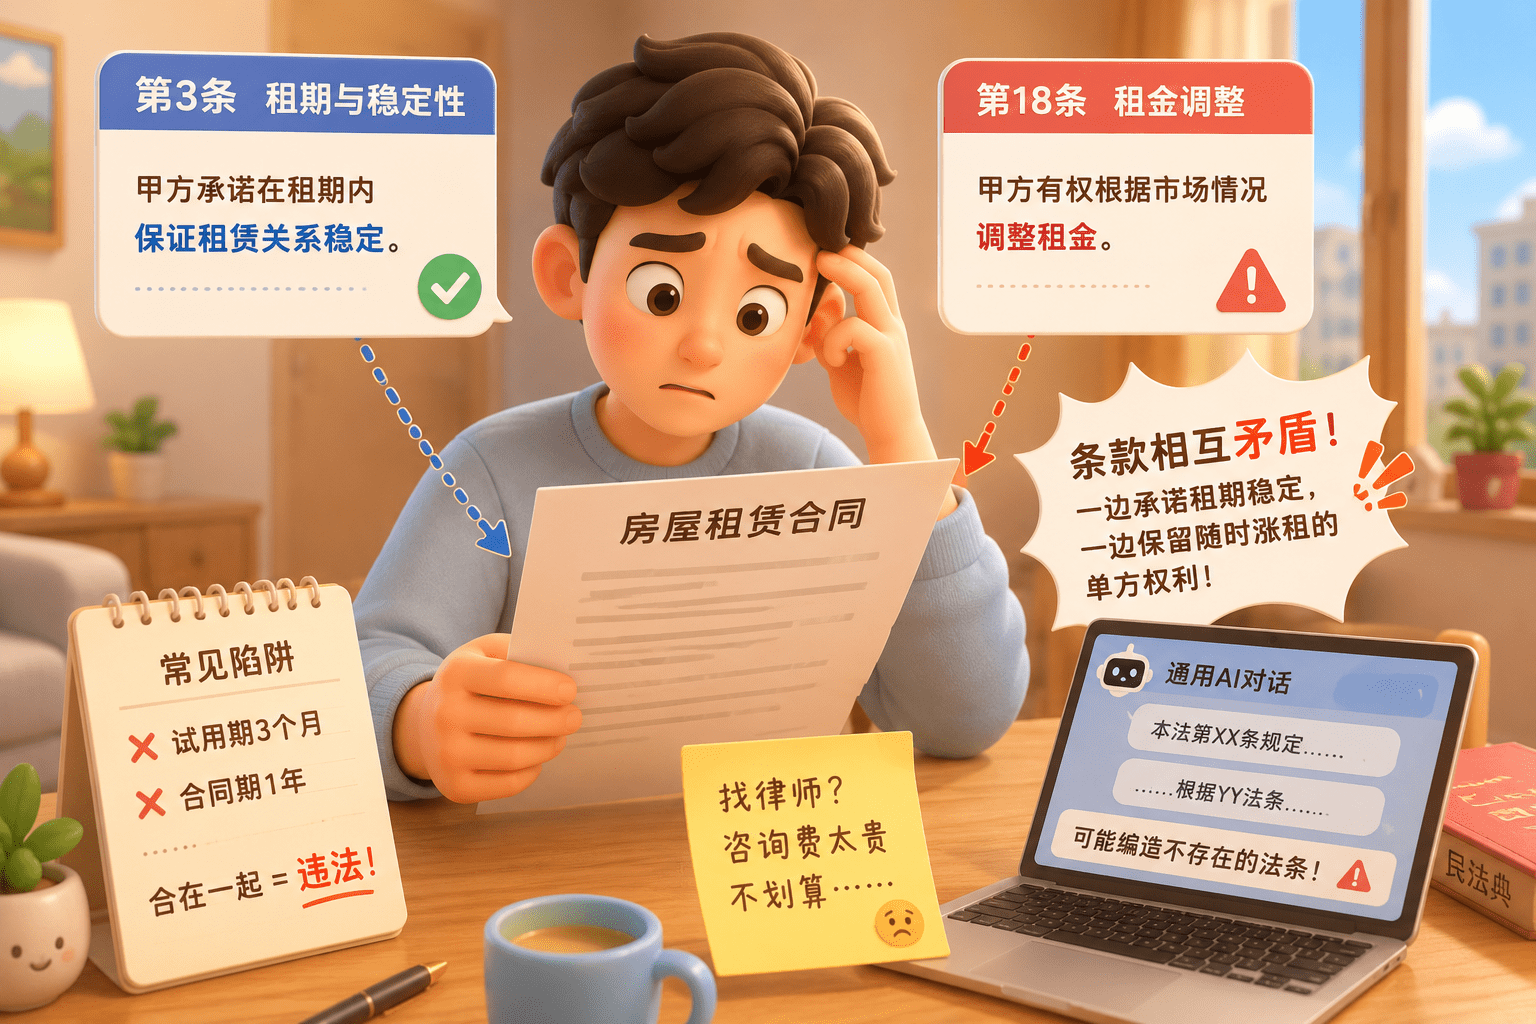
传统合同审查存在一个结构性盲区:条款孤立解读。无论是通用大模型还是人工初审,往往逐条审视文本,却难以捕捉隐藏在不同章节之间的逻辑矛盾。例如,一份租房合同可能在第三条承诺“租期内租金不变”,却在第十八条保留“甲方有权根据市场情况调整租金”的单方权利——单独看每一条都看似合理,合在一起却构成实质性违约风险。
这种“条款间冲突”正是普通用户最容易踩的坑。而现有解决方案存在明显断层:律师服务成本过高,不适合小额合同;通用聊天机器人缺乏上下文整合能力,且存在编造法条的严重风险。因此,一个可行的产品方向浮现出来:将整份合同一次性输入具备超长上下文能力的大模型,强制其进行全局关联推理,并对每项结论标注置信度,同时联网验证法律依据的真实性。
这一设想对底层模型提出了复合要求:必须支持百万级 token 上下文、具备稳定工具调用能力、能处理 PDF/图片等多模态输入,且推理过程需可解释、可验证。更重要的是,作为个人 side project,整个技术栈必须轻量、低成本、低运维负担。
平台选型:为何 AiiOnly 成为关键支点
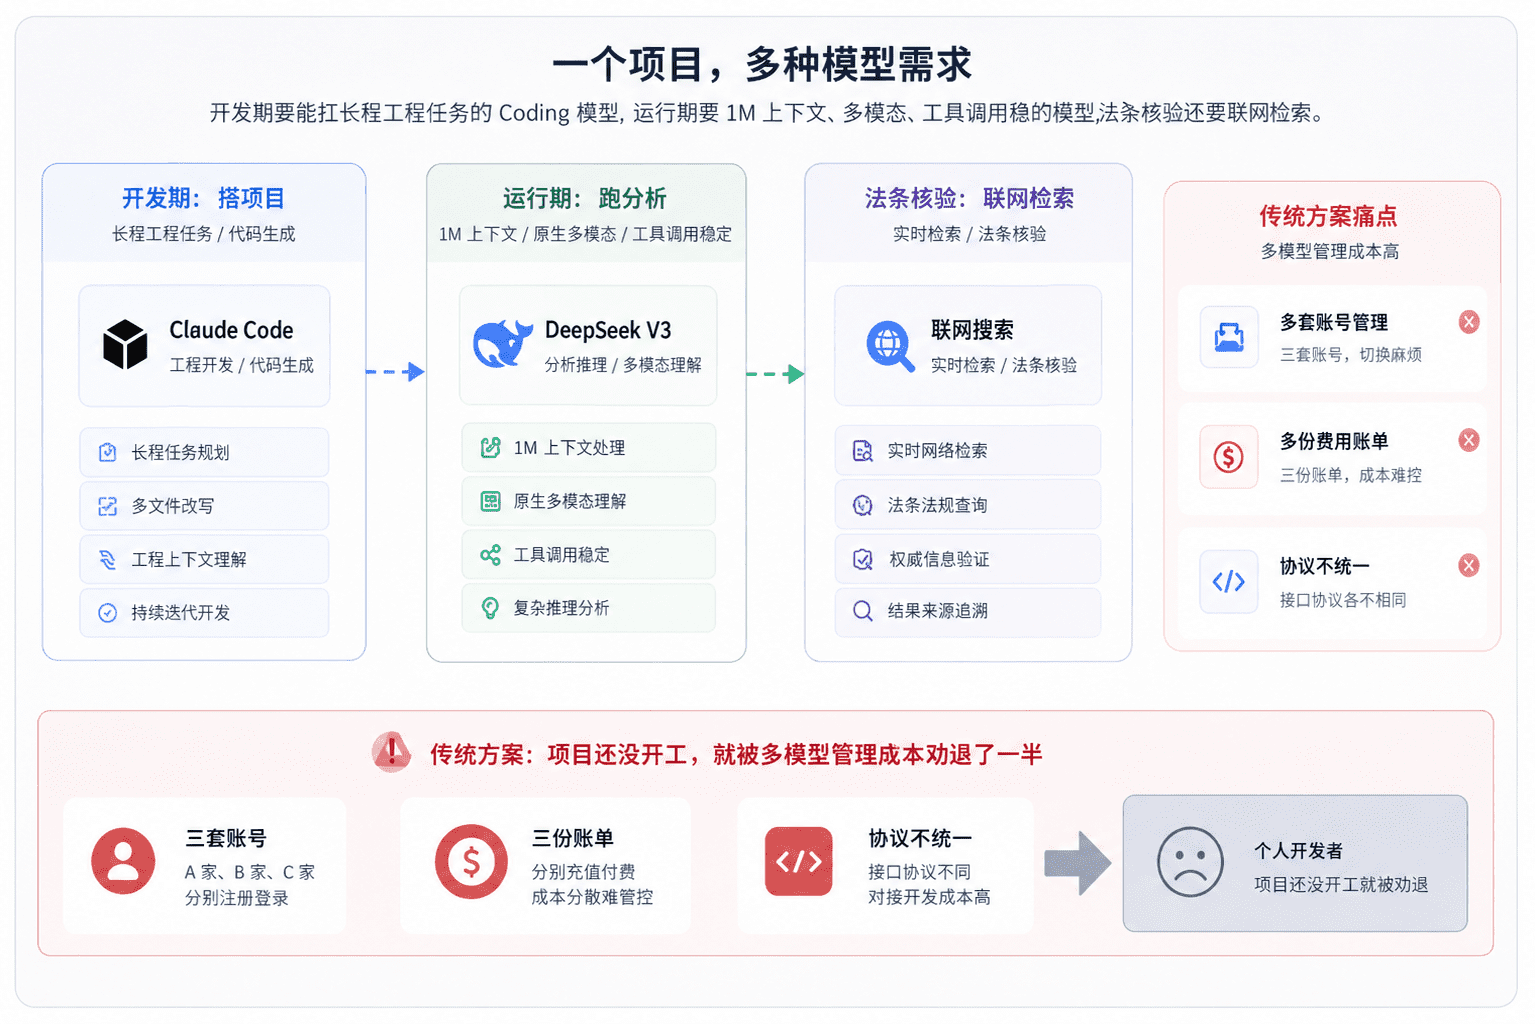
面对上述需求,开发者面临典型的“模型碎片化”困境:写代码需要强工程模型,合同分析依赖长上下文推理,法条核验又需联网检索能力。若分别对接不同厂商 API,不仅管理复杂,成本也难以控制。
AiiOnly 的出现解决了这一痛点。其核心优势在于三点:
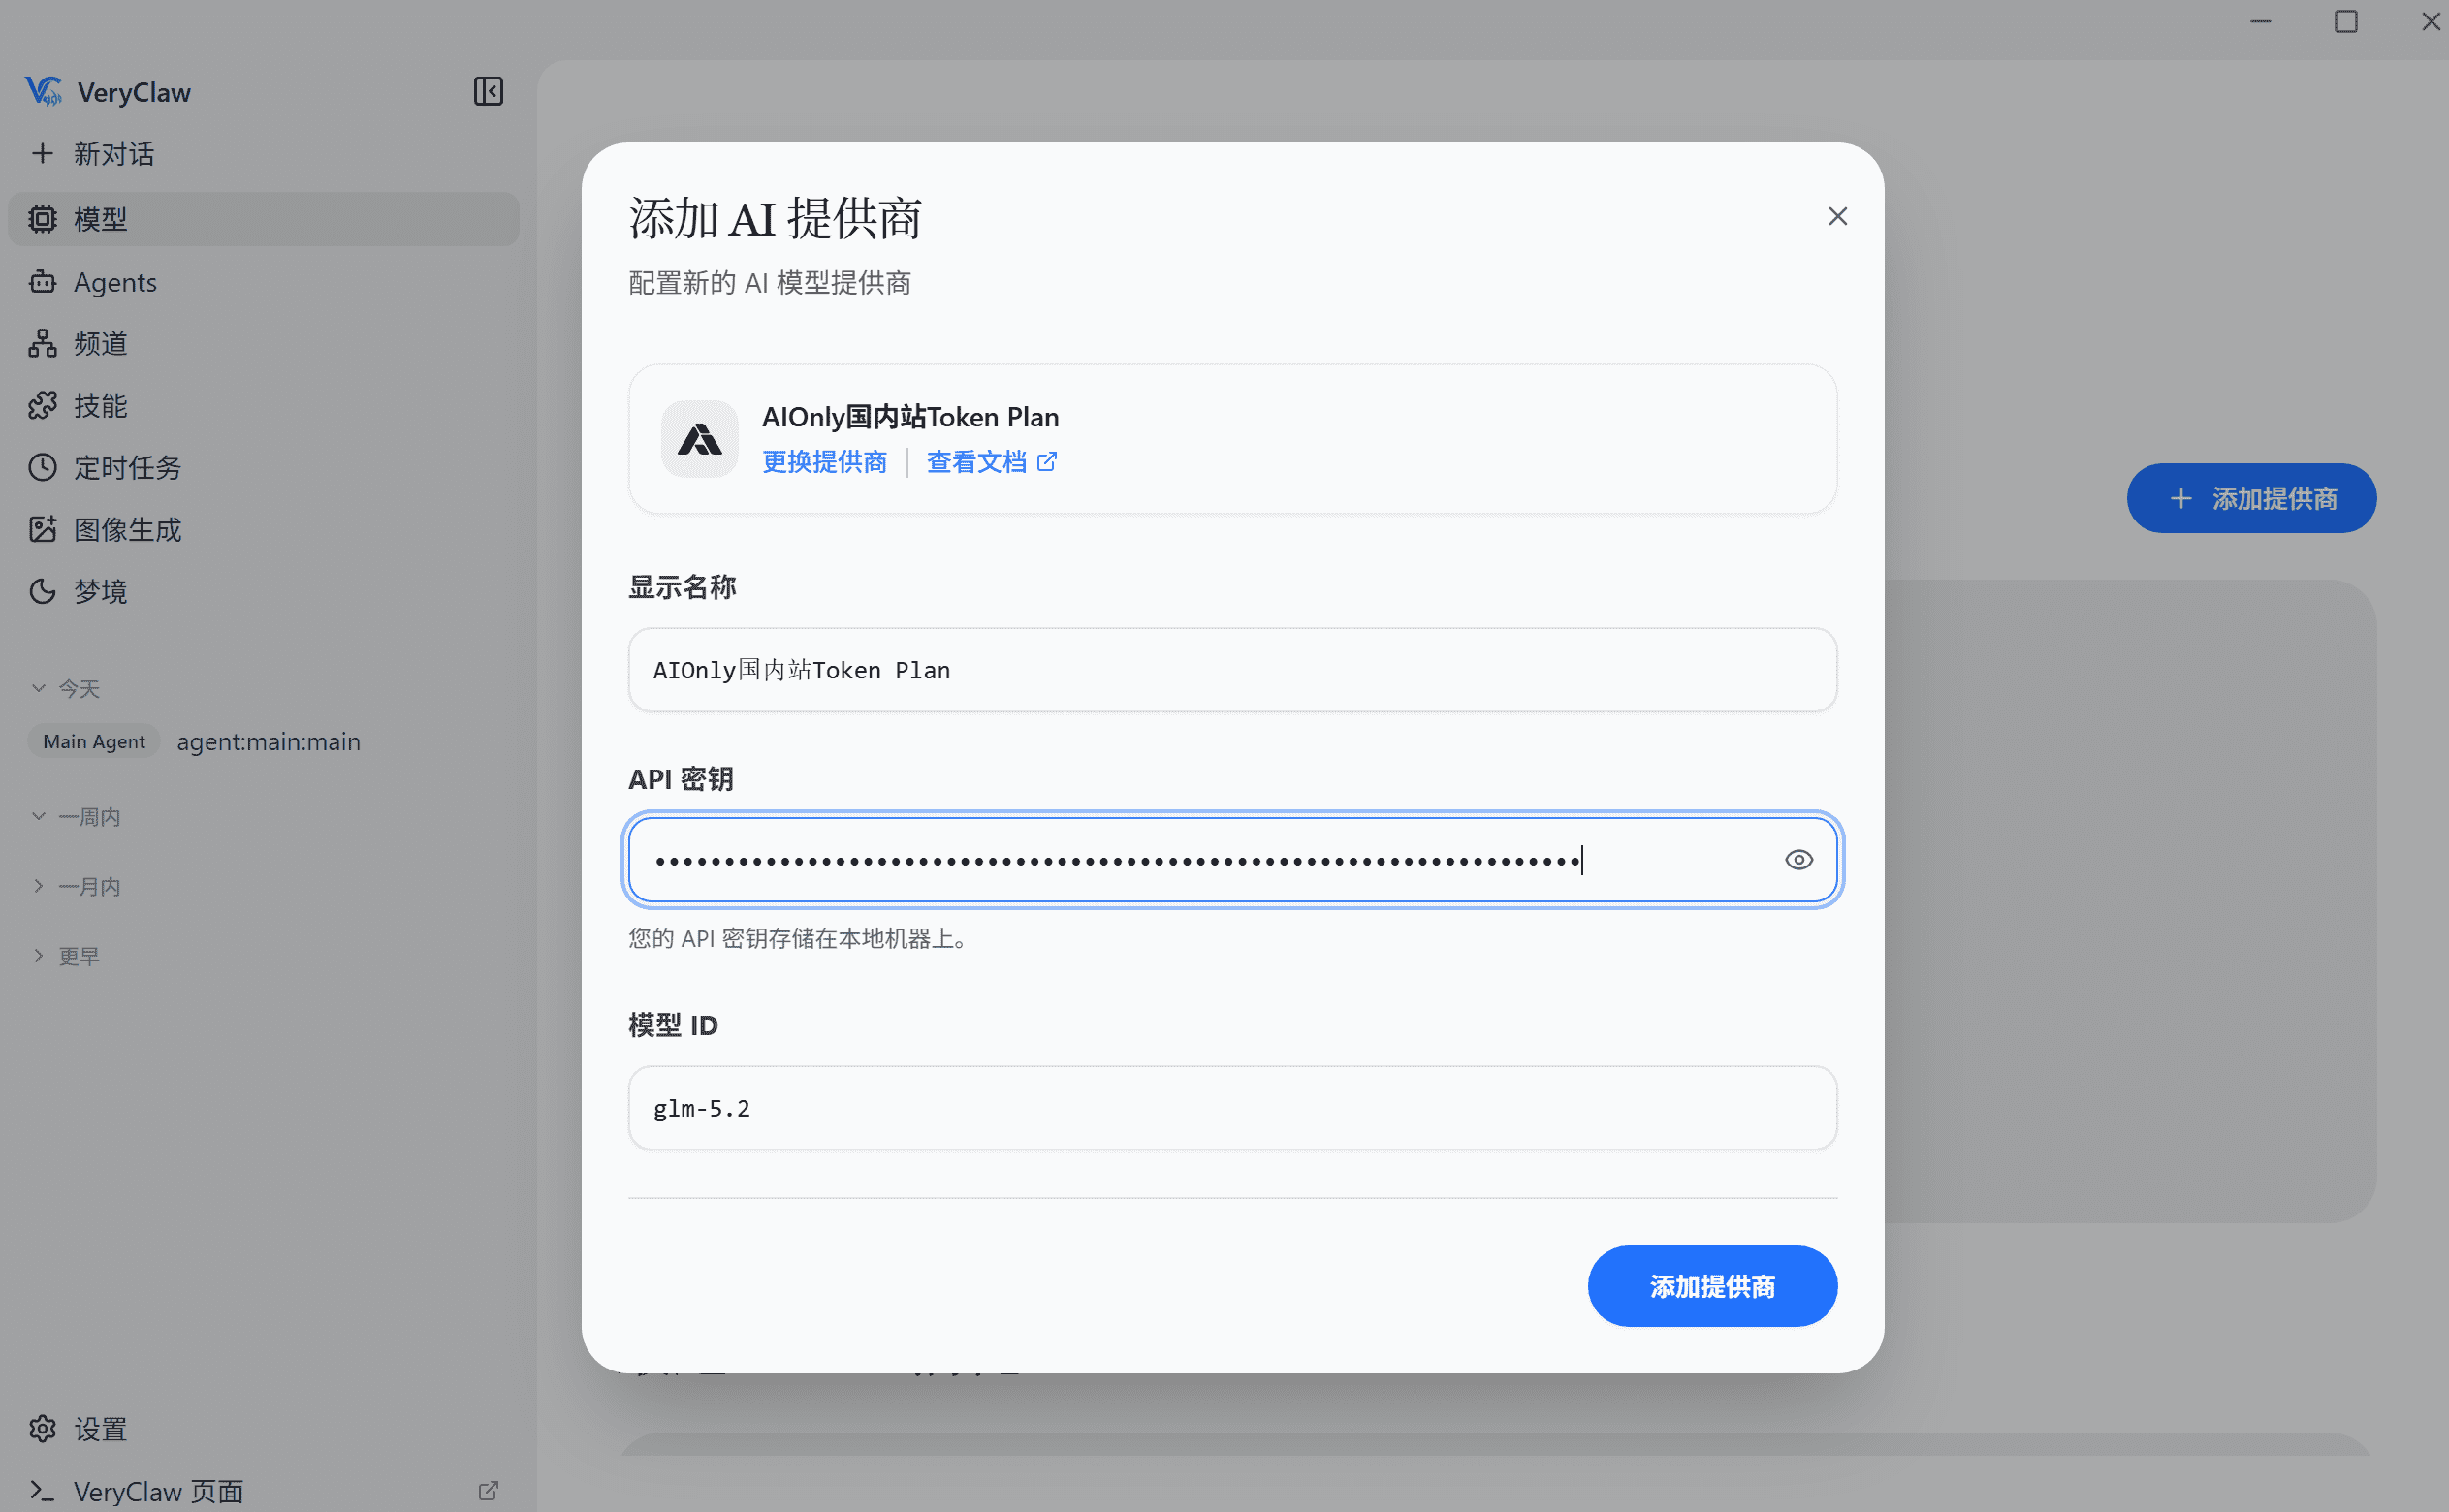
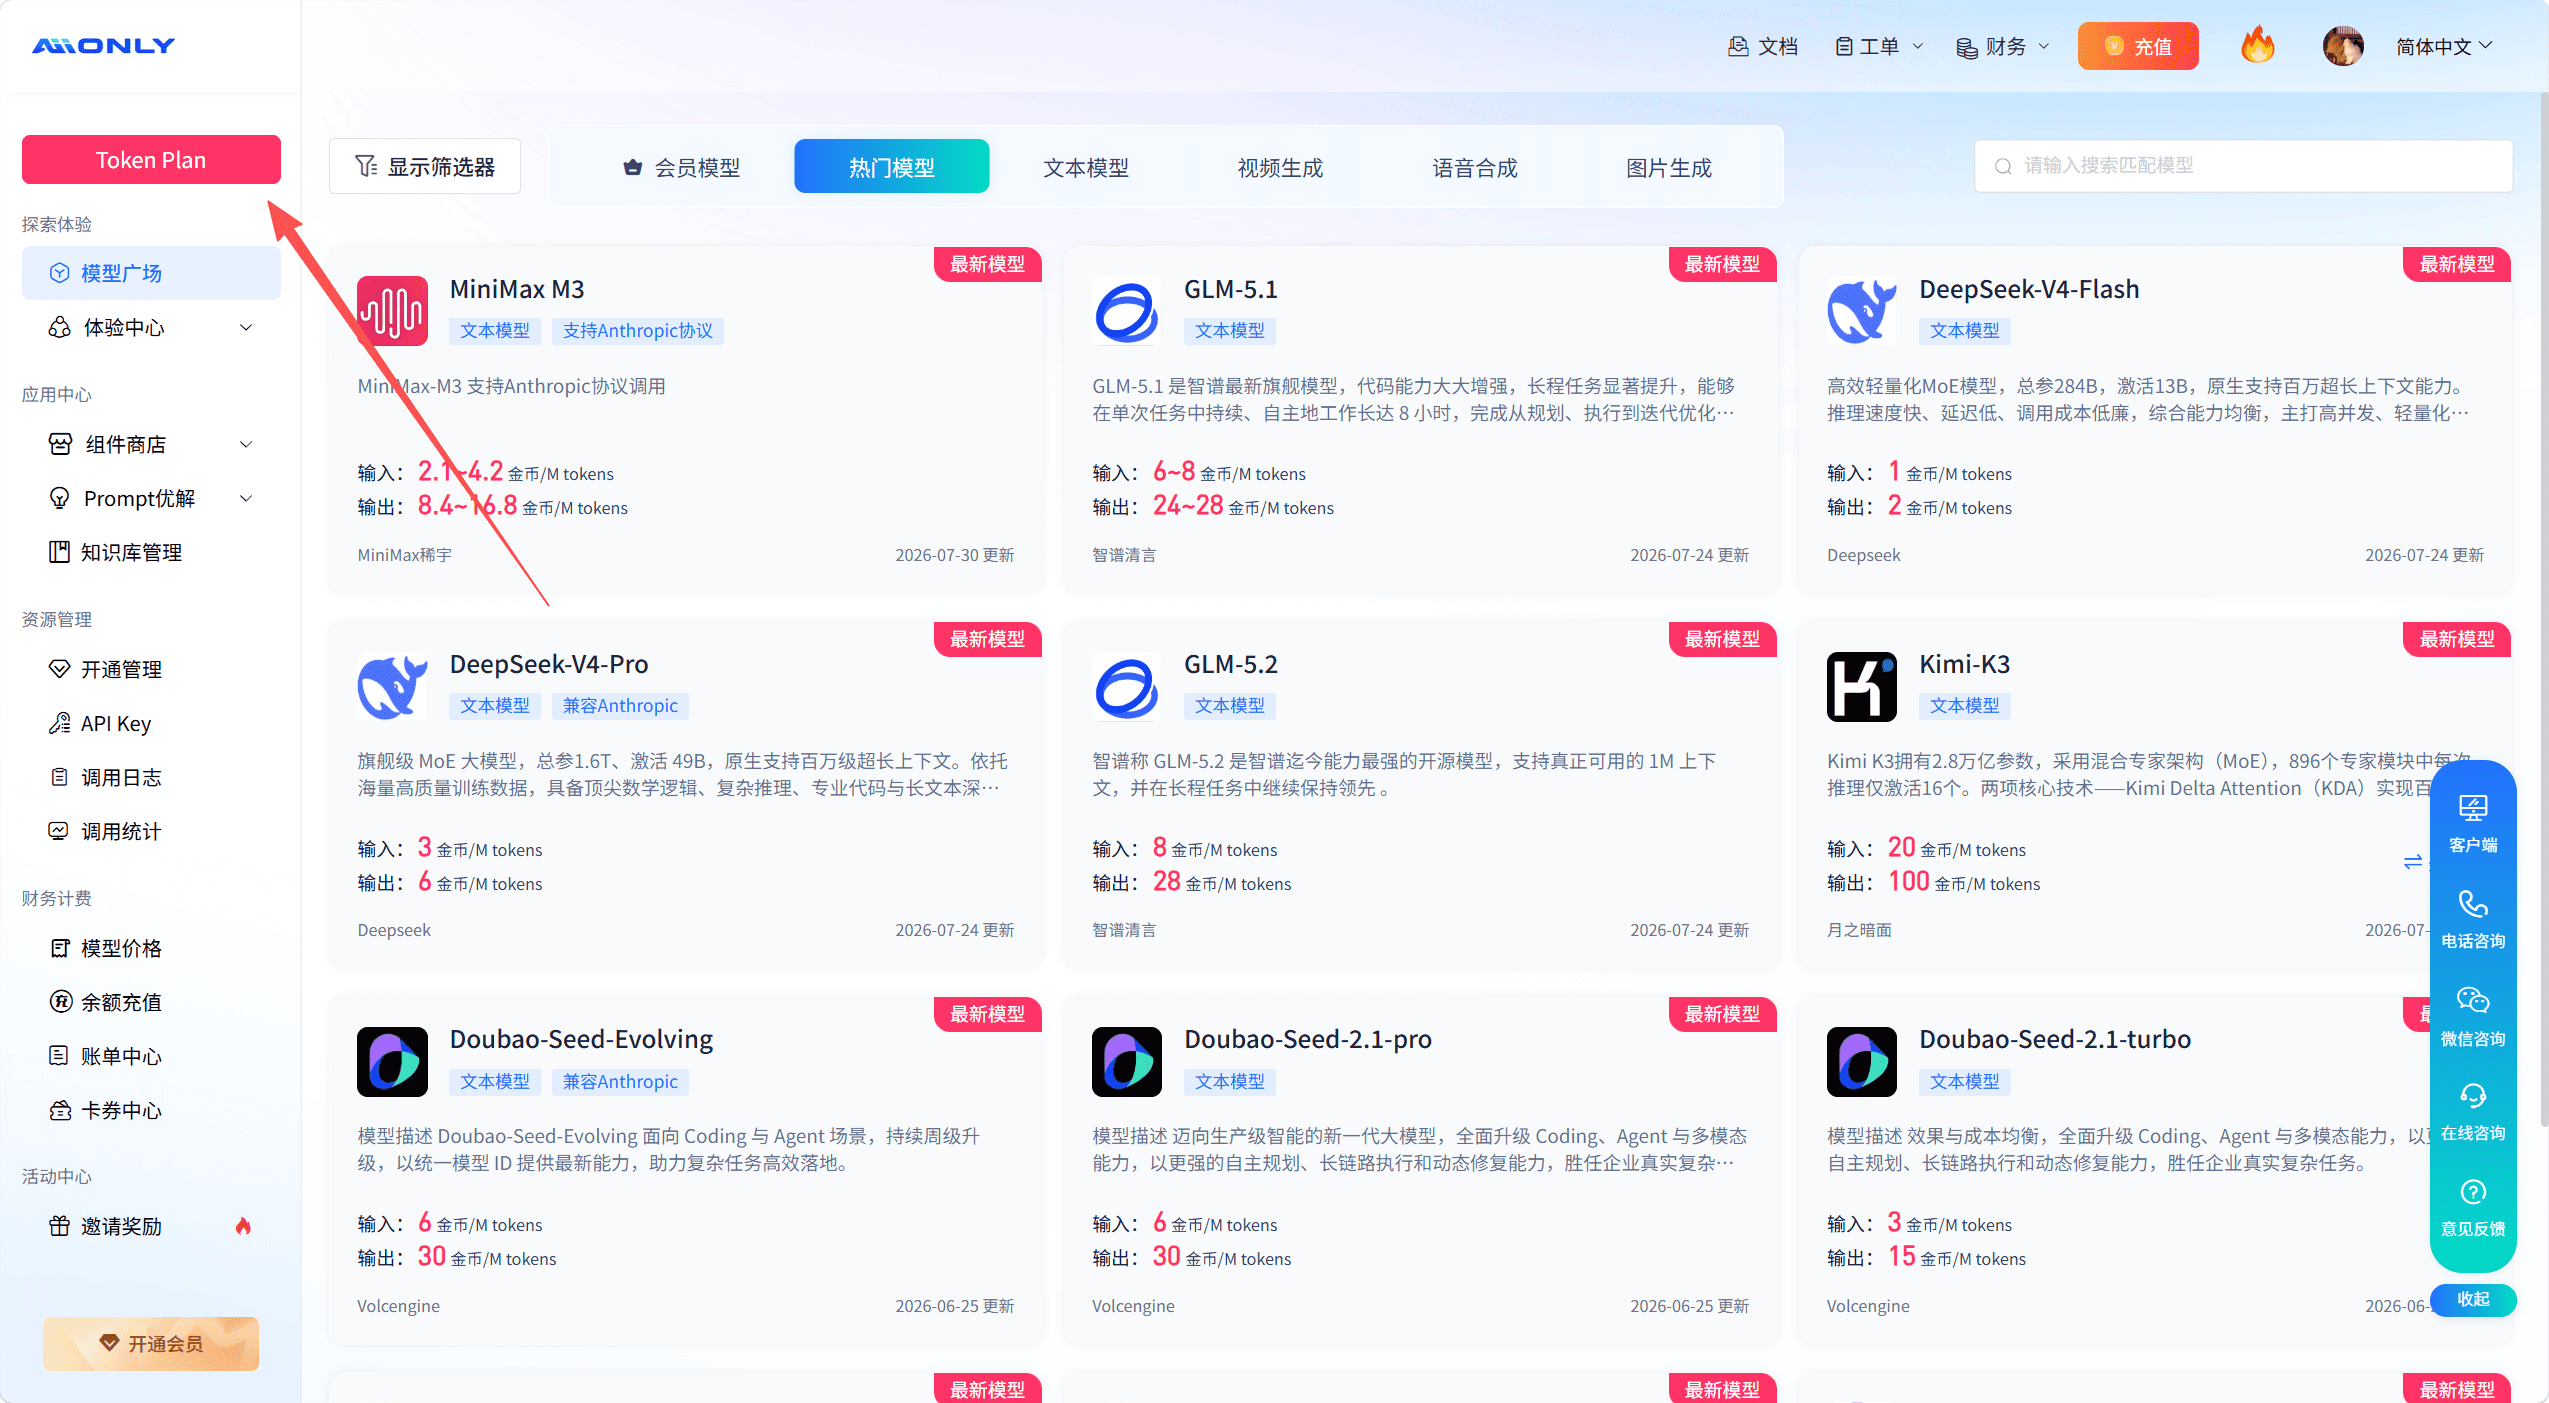
- 统一接入层:通过 OpenAI 或 Anthropic 兼容协议,一个 API Key 即可调用包括 GLM-5.2、DeepSeek-V4、Kimi-K2 等在内的主流大模型,无需为每个模型单独申请密钥或适配接口。
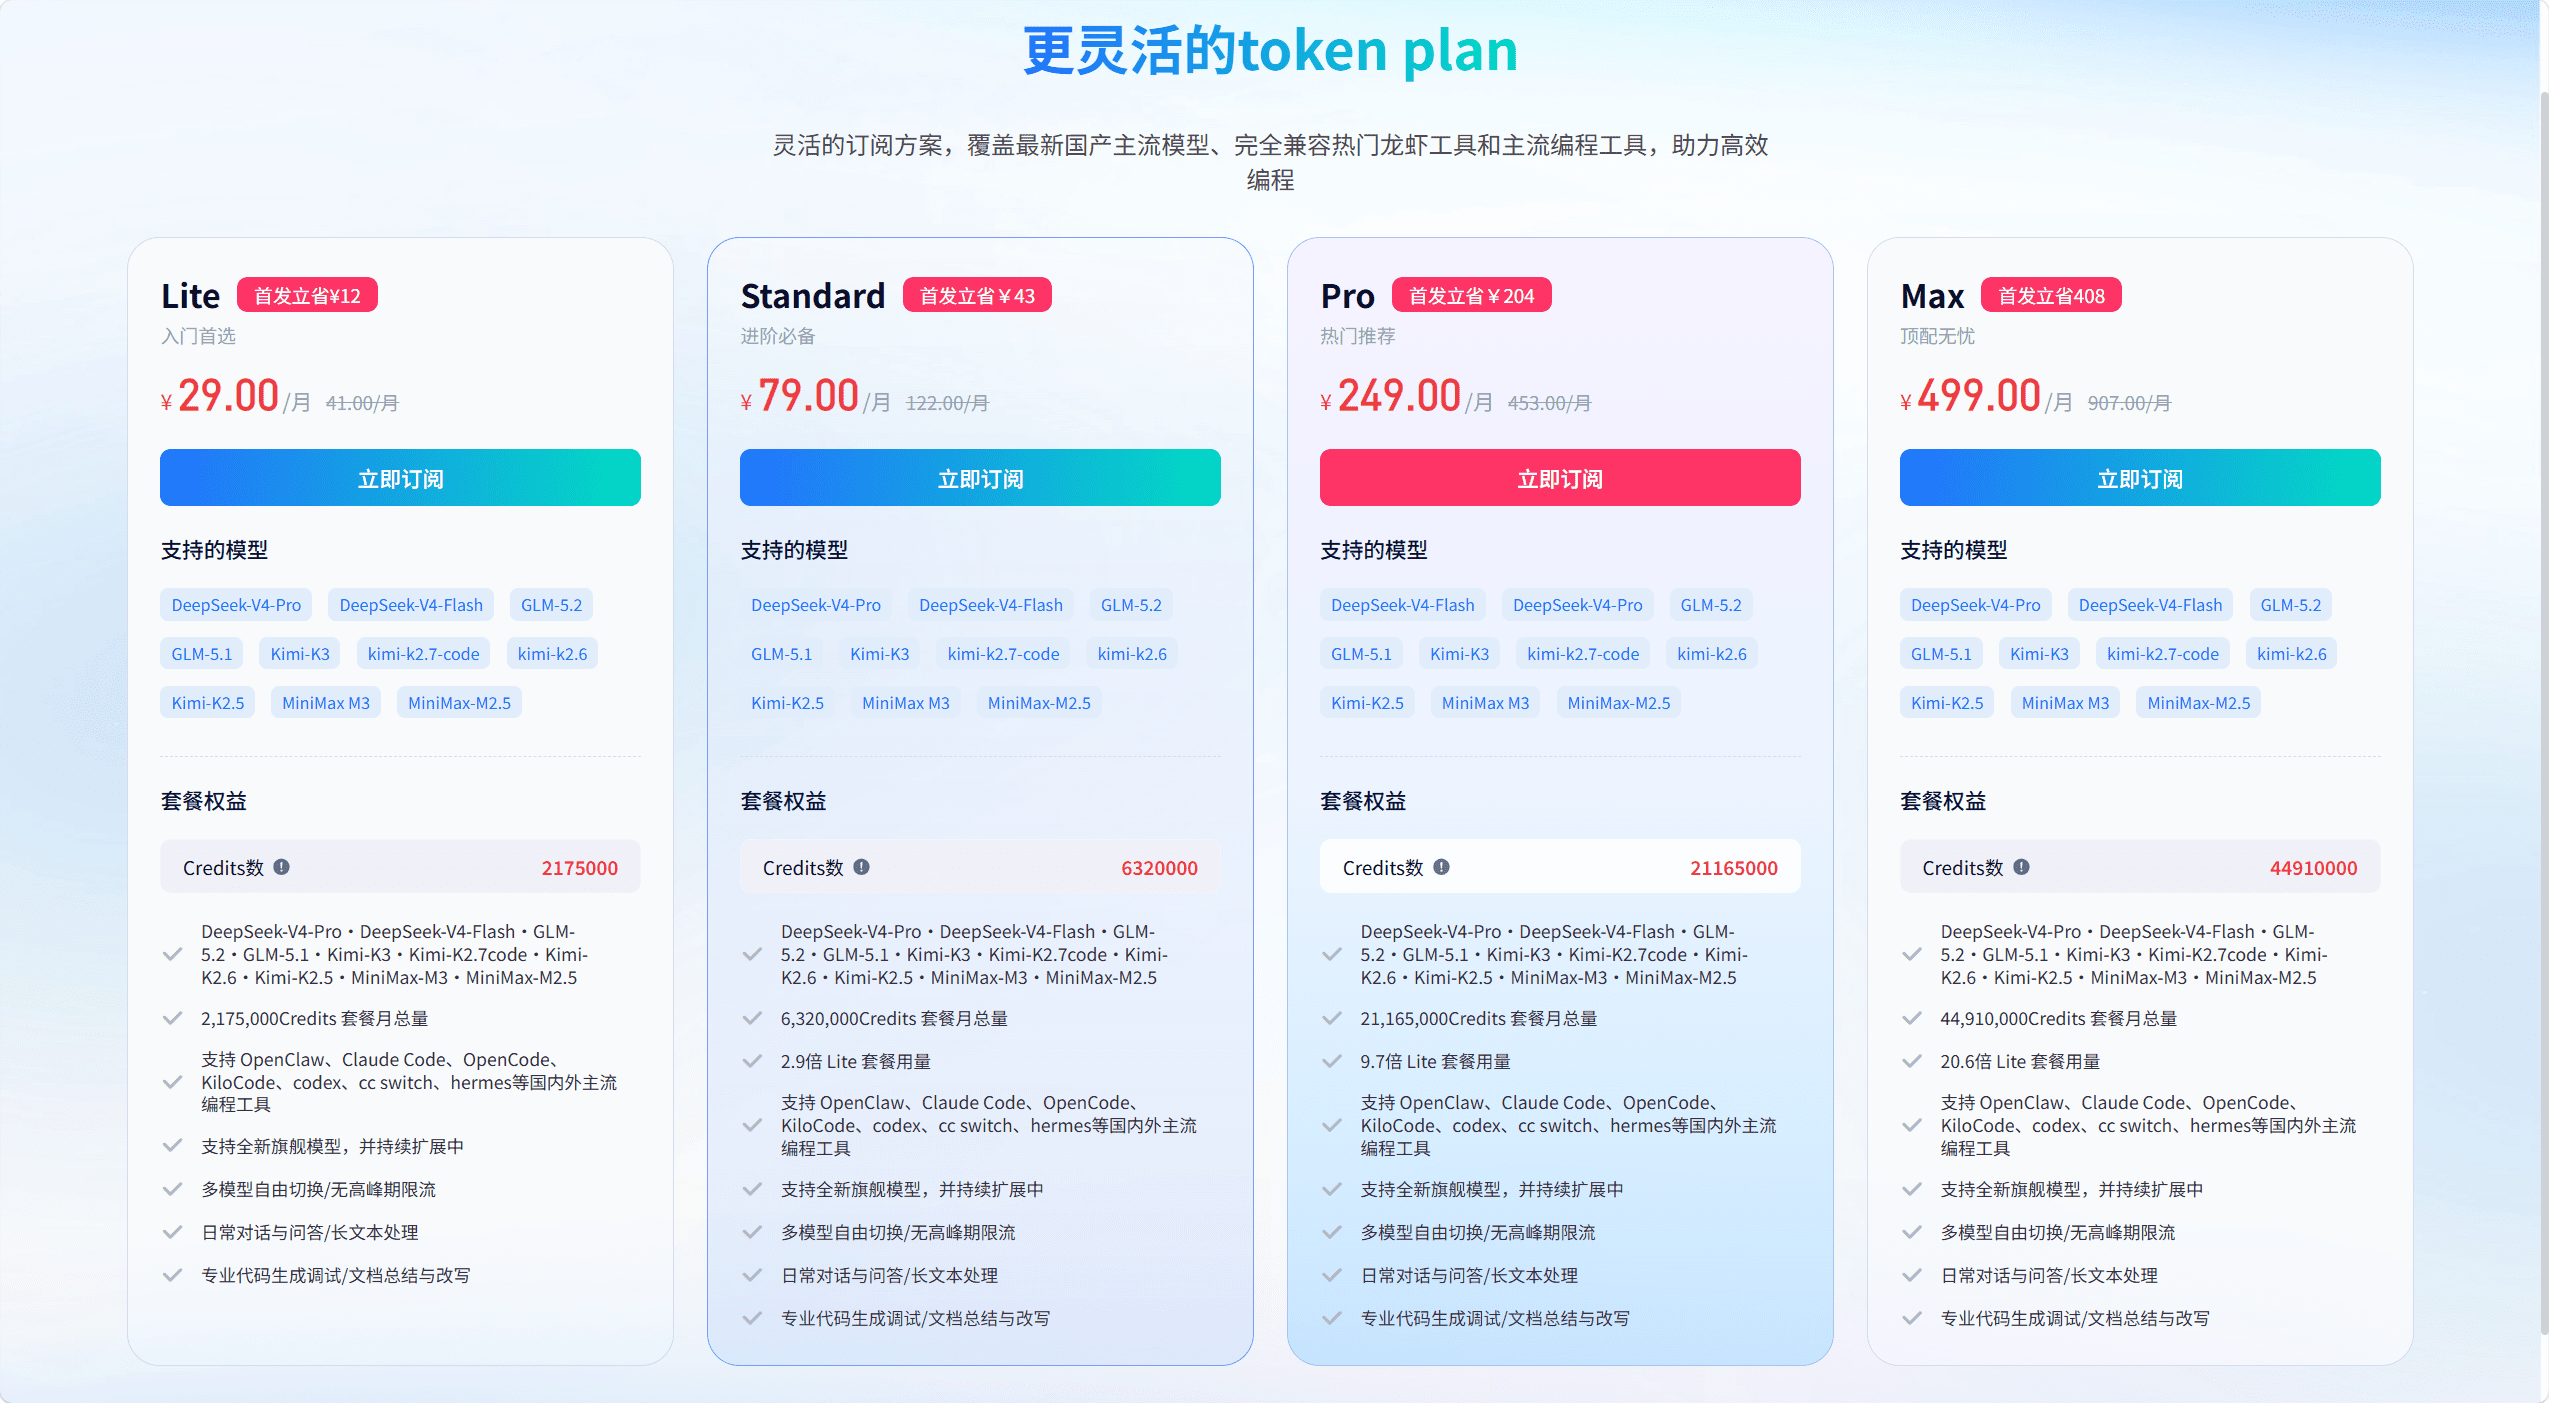
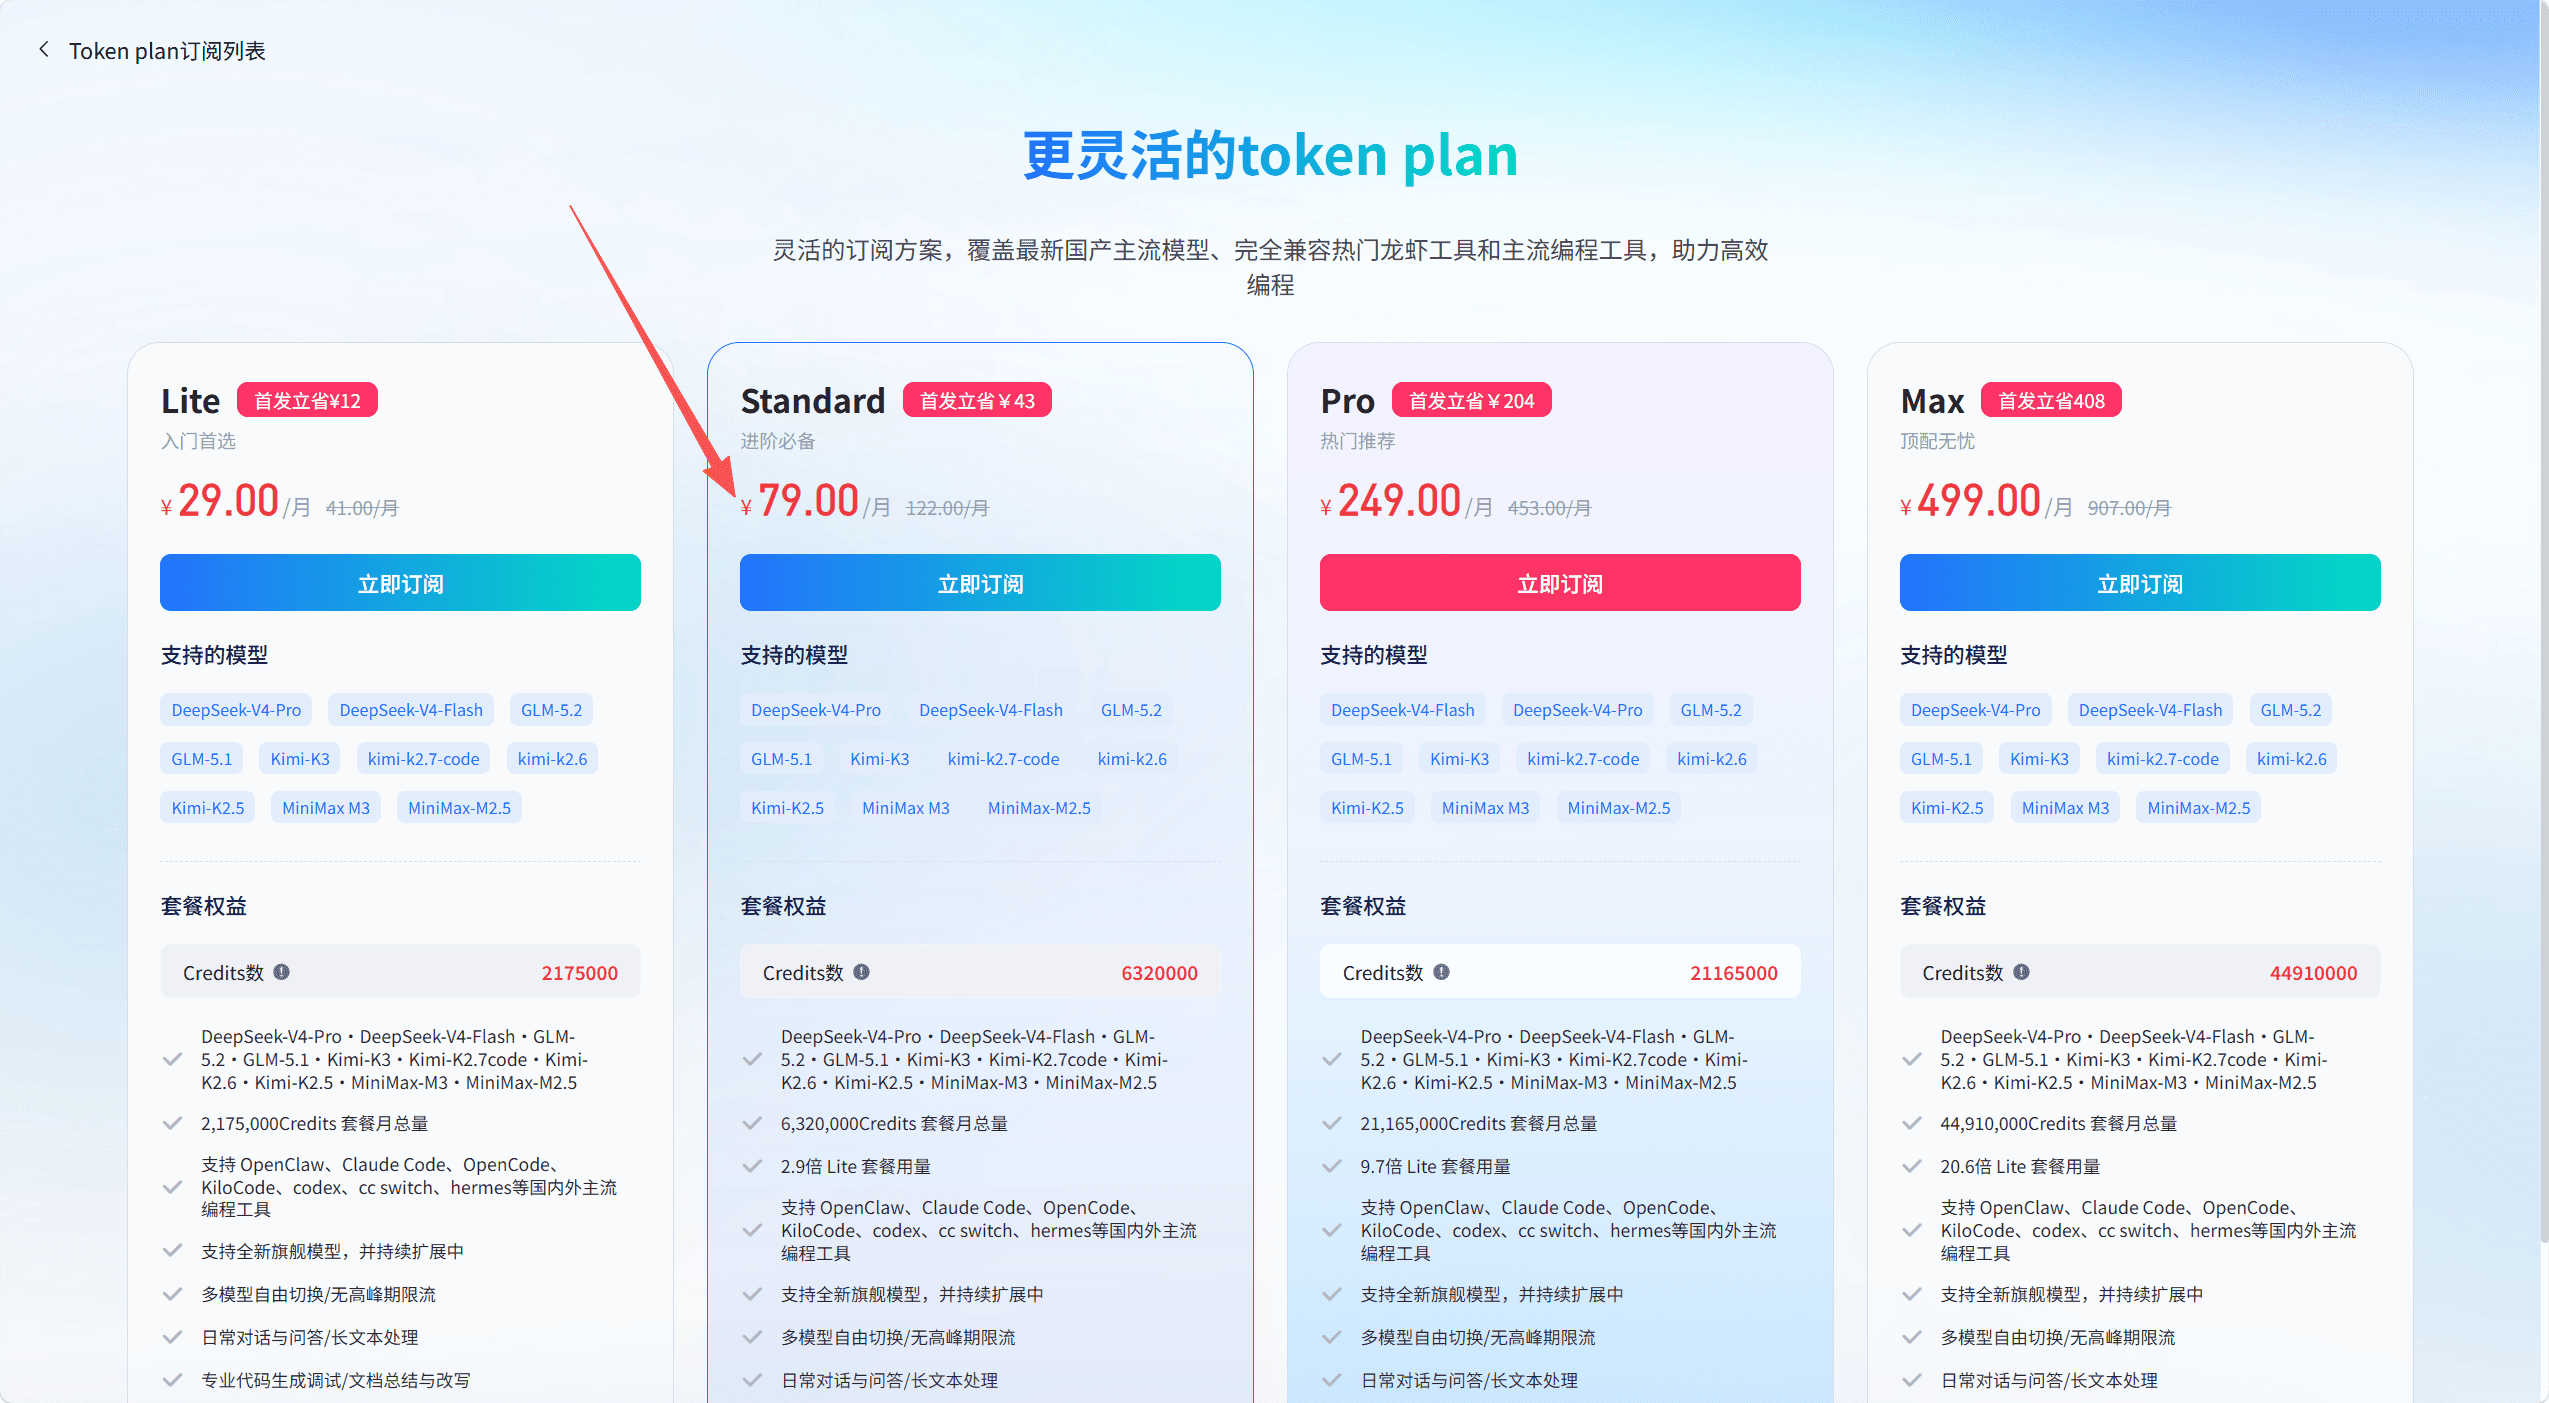
- Token Plan 订阅制:Standard 档位以 ¥79/月的价格打包 632 万 Credits,覆盖开发与运行全周期。额度内模型自由切换、无高峰期限流,且用尽自动暂停,彻底规避超额费用风险。
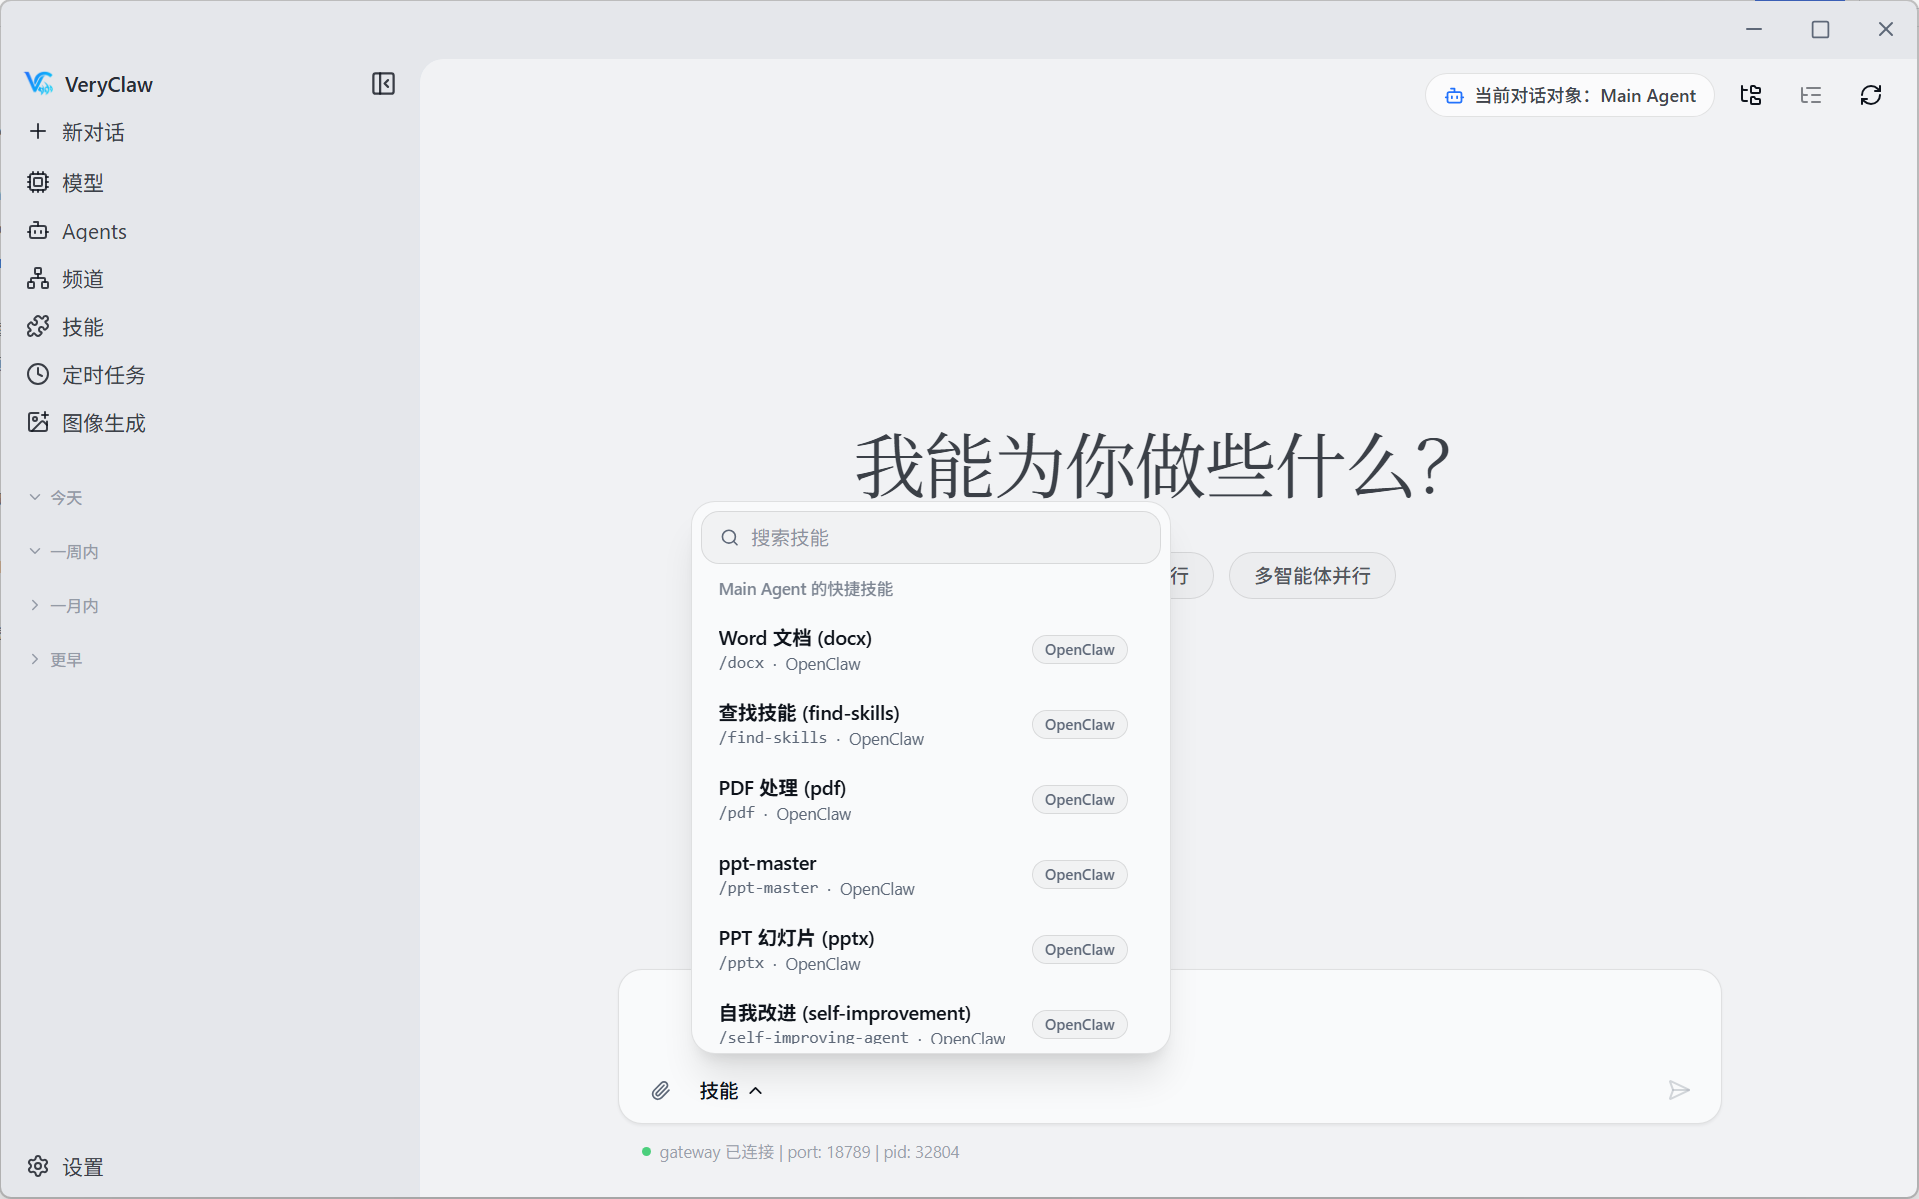
- 生态协同:配套的 VeryClaw 客户端支持自然语言指令驱动开发,AiiOnly 客户端则便于非编码场景下的模型调用,形成“开发-调试-部署”闭环。
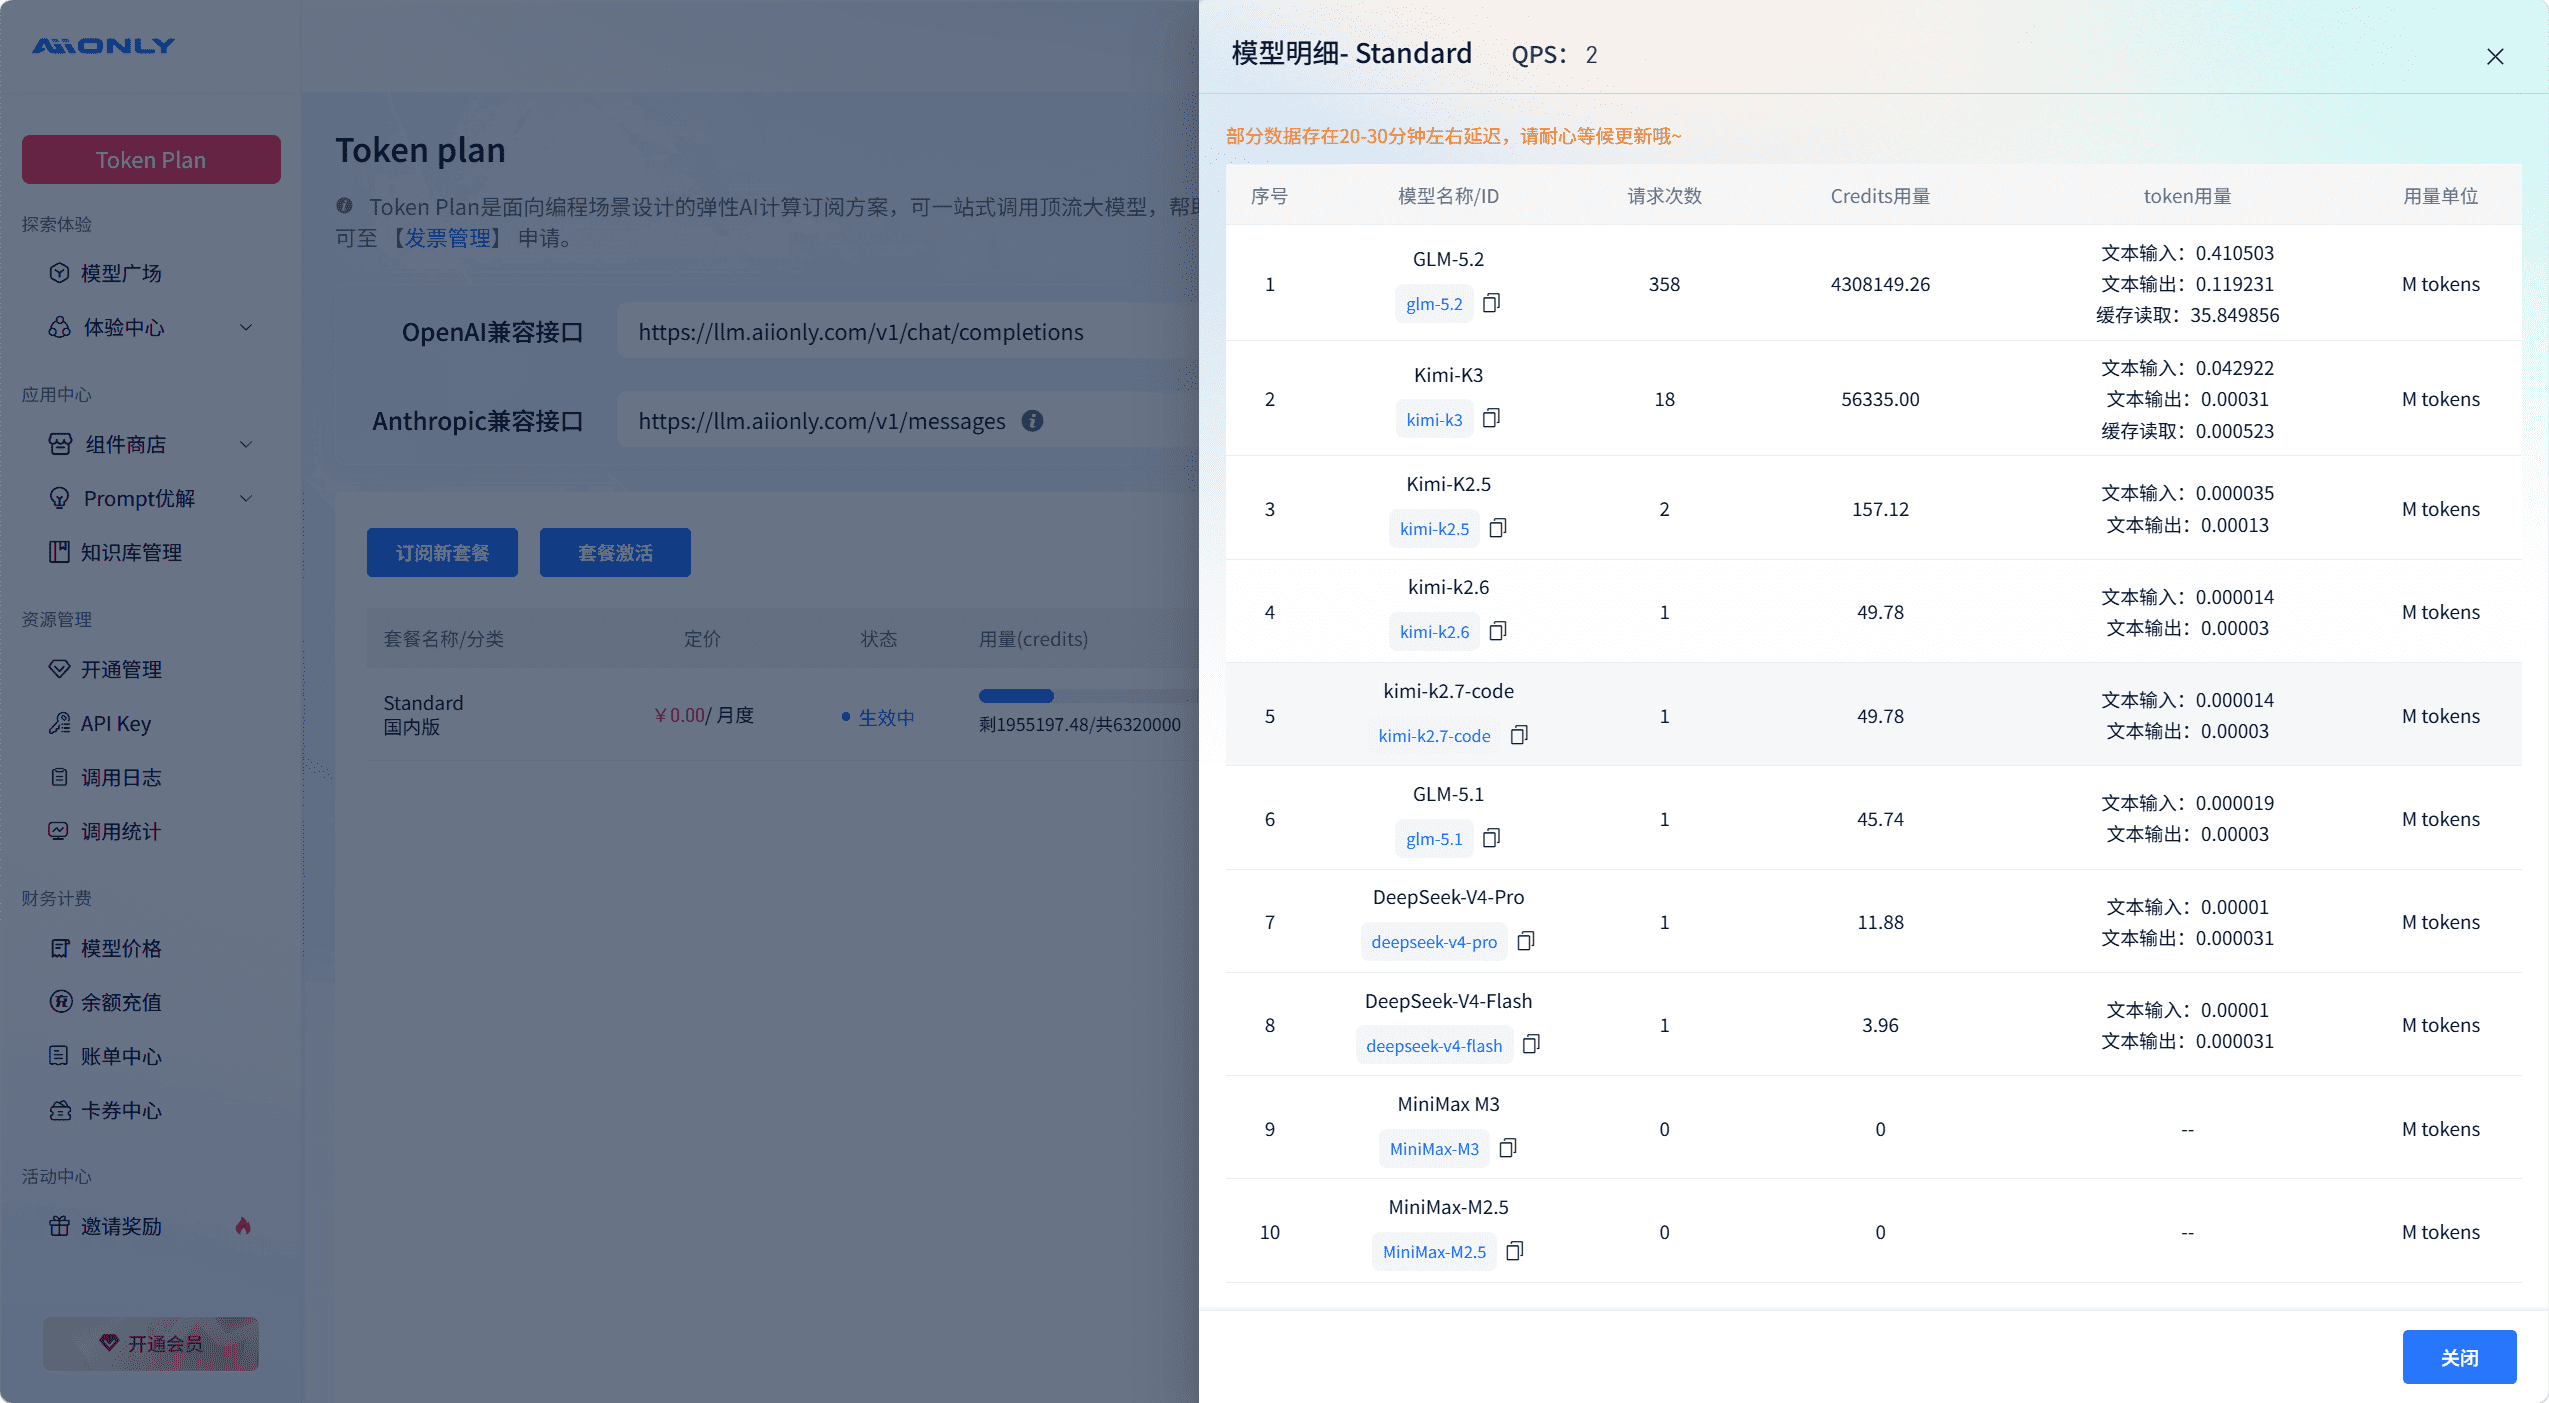
这种“一揽子”解决方案极大降低了个人开发者的试错门槛。开发者无需在初期就锁定单一模型,而是可根据任务特性动态选择最优引擎——例如用 DeepSeek 编写 SSE 解析逻辑,用 GLM-5.2 执行合同分析,所有调用均从同一 Credits 池扣除。
开发范式:从深度访谈到自动生成 SPEC
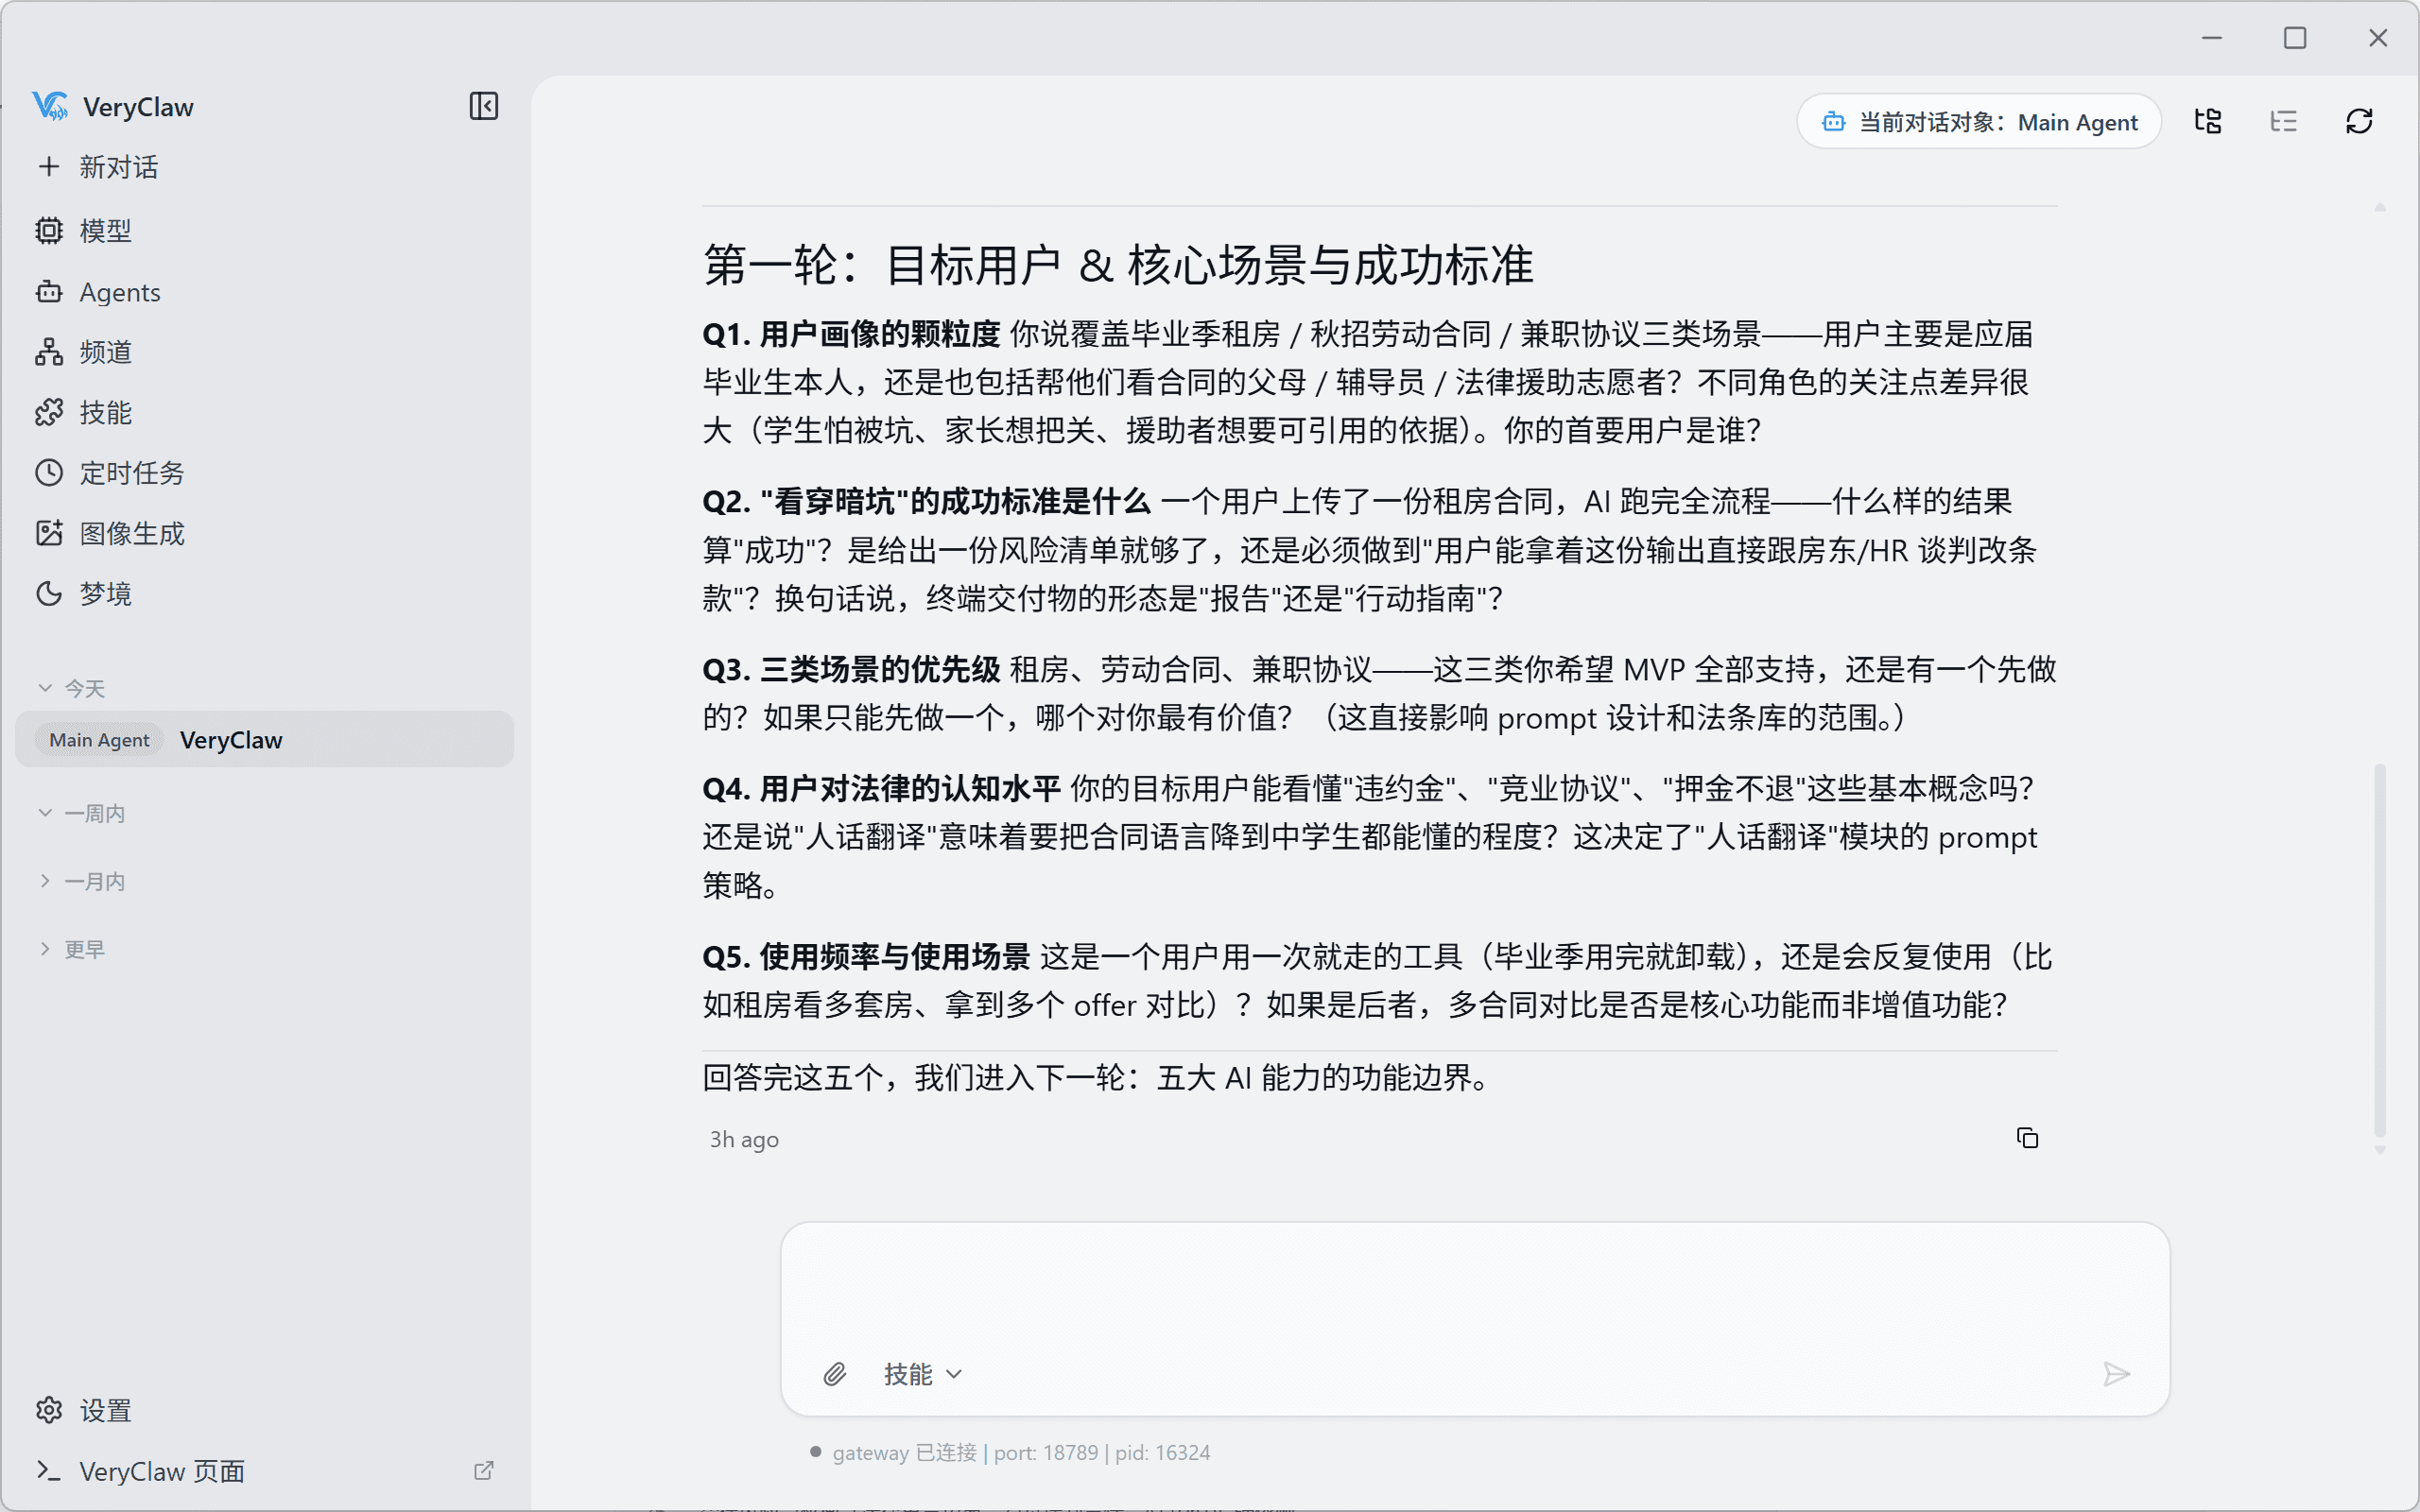
项目启动阶段最关键的决策是先明确需求,再生成代码。作者采用“苏格拉底式提问法”,让 AI 扮演产品架构师,对其初始模糊需求进行二十多轮追问,覆盖以下维度:
- 功能边界:单合同分析是否包含 OCR?多合同交叉比对的文档数量上限?
- 可靠性机制:如何防止模型编造《劳动合同法》第 XX 条?置信度如何量化?
- 数据安全:合同原文是否上传服务器?API Key 是否暴露于前端?
- 边缘处理:PDF 中文乱码、非合同文件误传、JSON 解析失败等异常如何兜底?
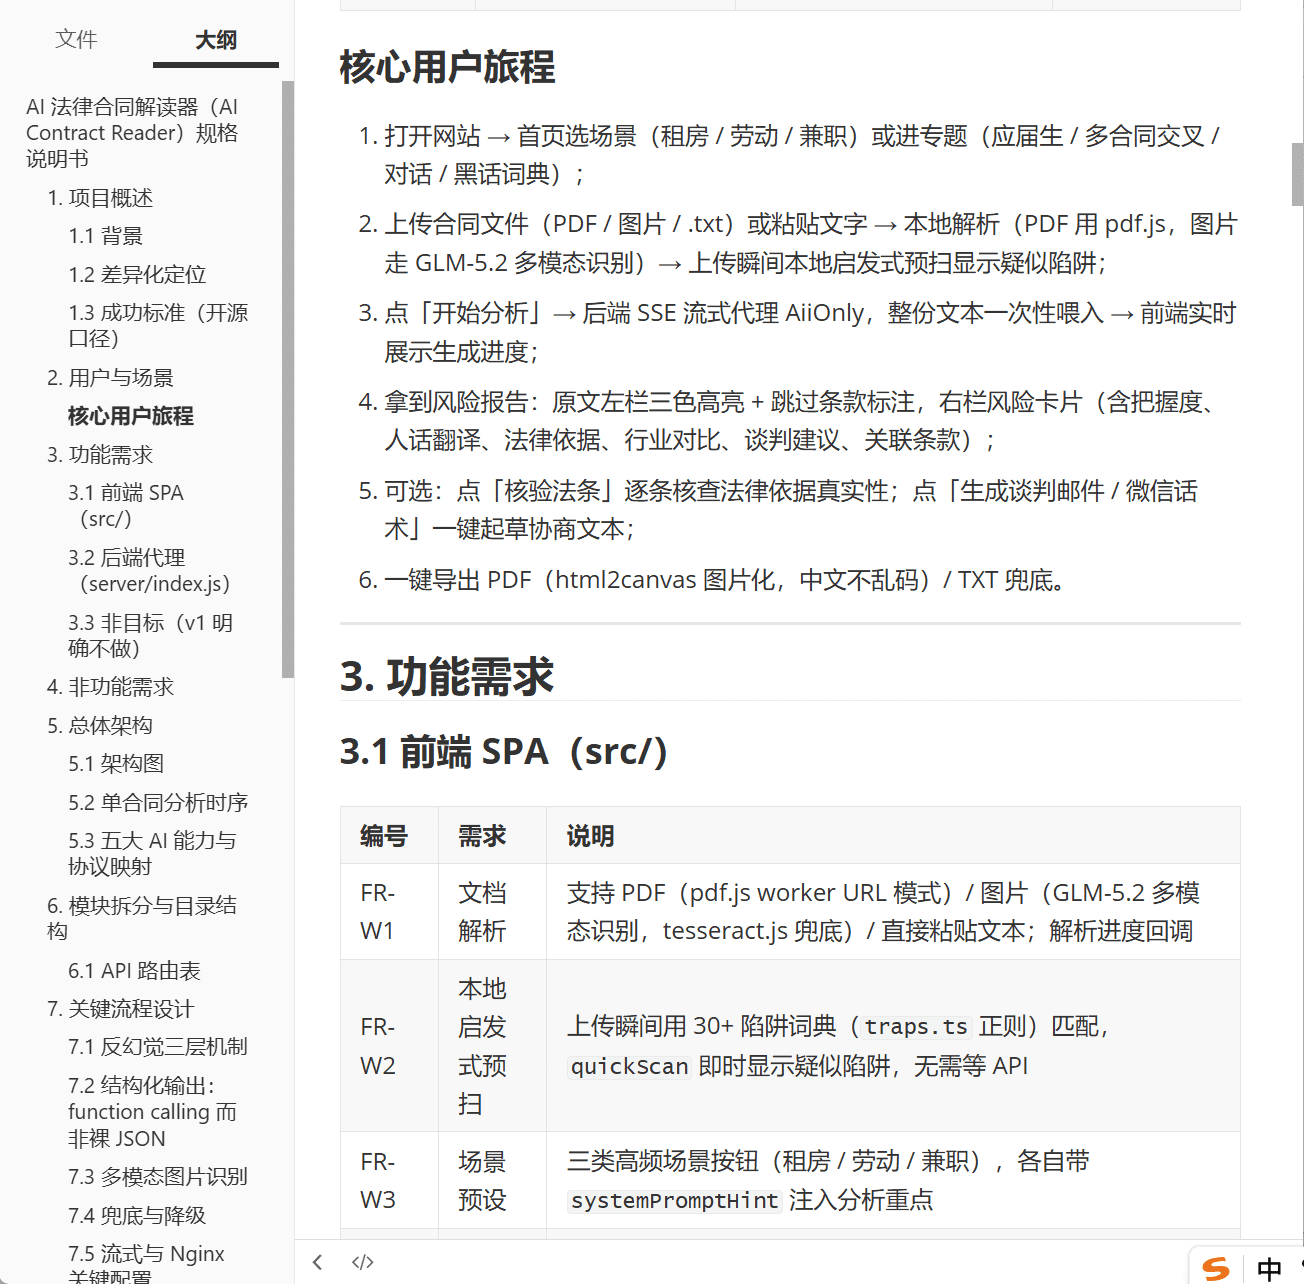
这些问题迫使开发者提前思考潜在风险,而非等到代码报错才被动修复。当所有疑问澄清后,AI 自动生成一份结构化 SPEC.md,包含:
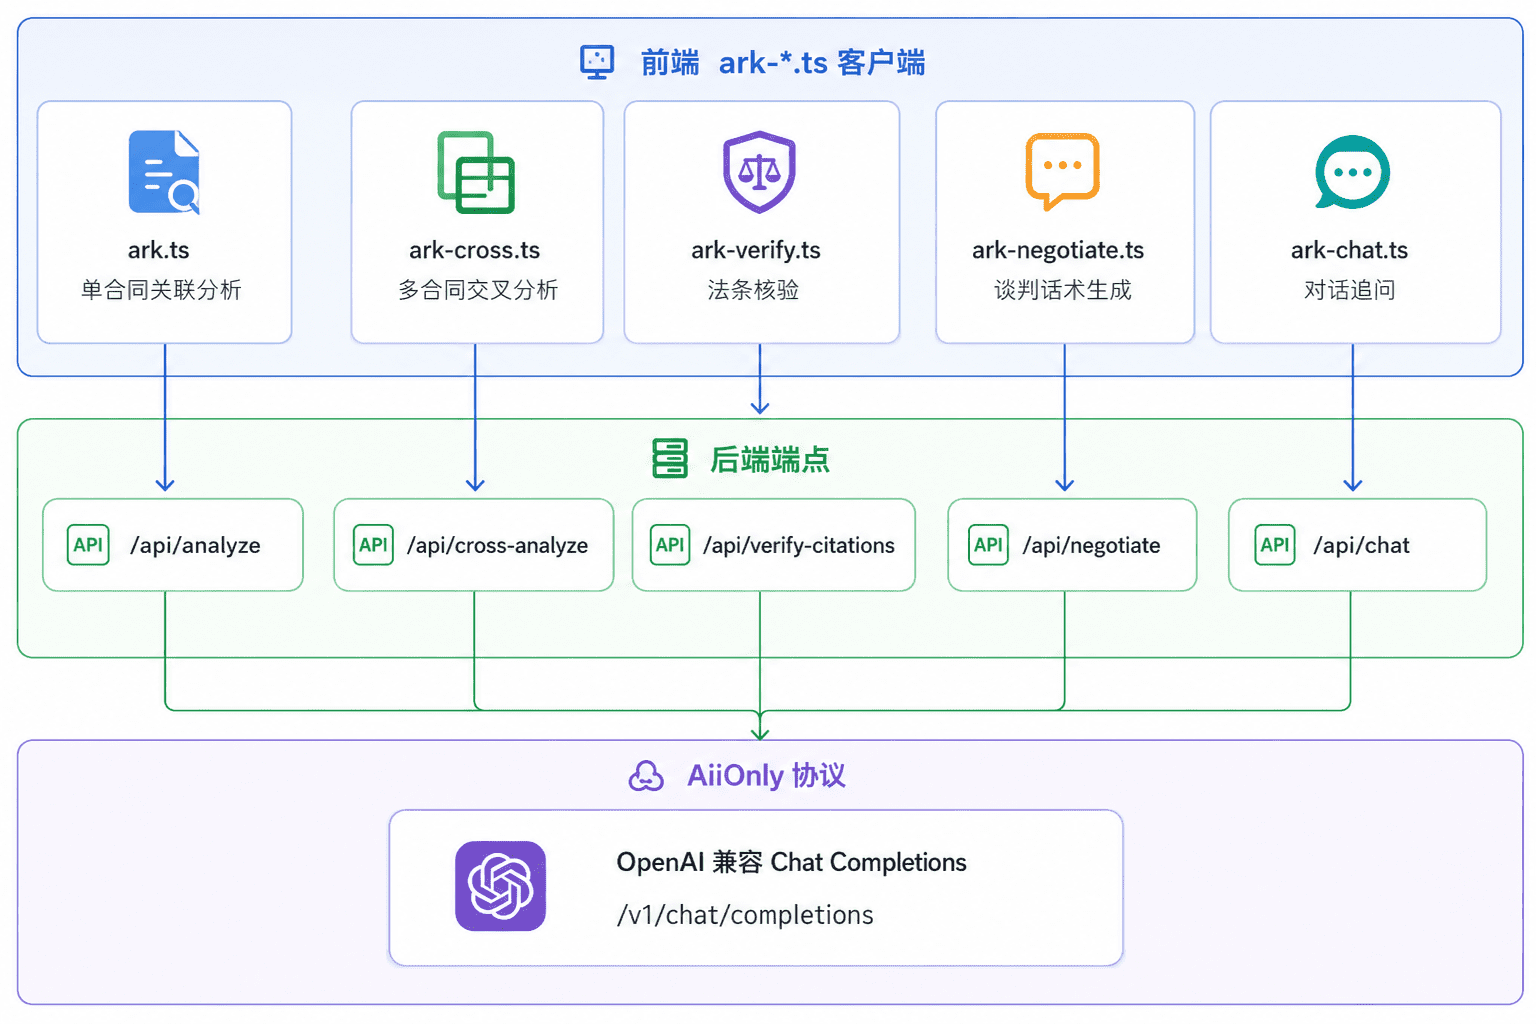
- 五大核心能力定义(单合同关联、多合同交叉、法条核验、谈判话术、对话追问)
- 非功能需求(SSE 超时设置、Credits 成本估算、并发策略)
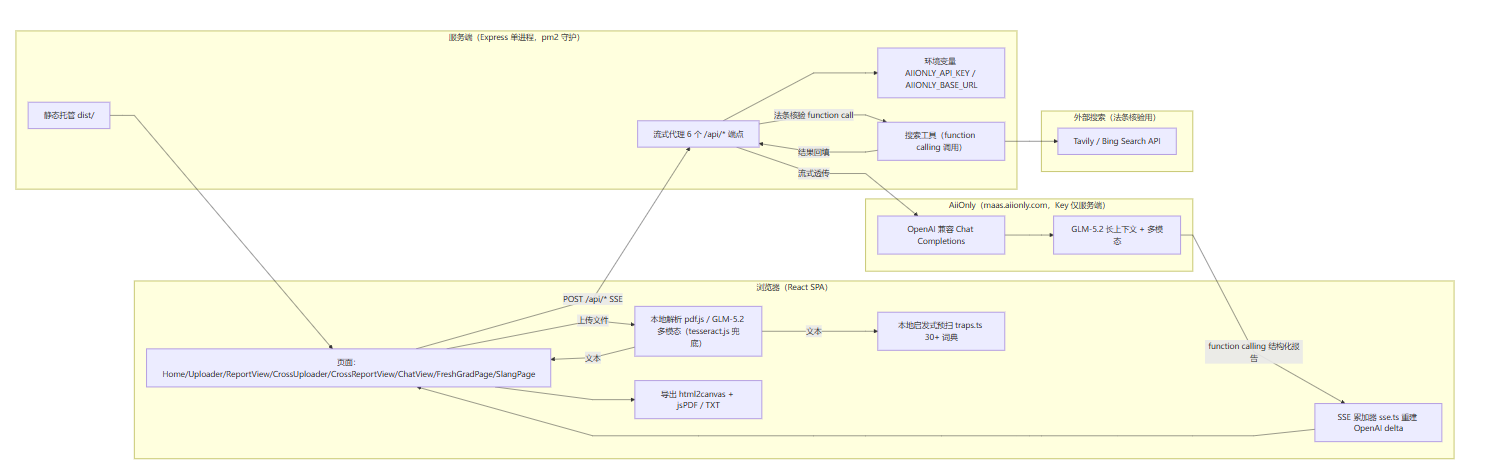
- 数据流架构图与模块依赖关系
- 验收标准(如“高风险条款必须附带可操作的修改建议”)
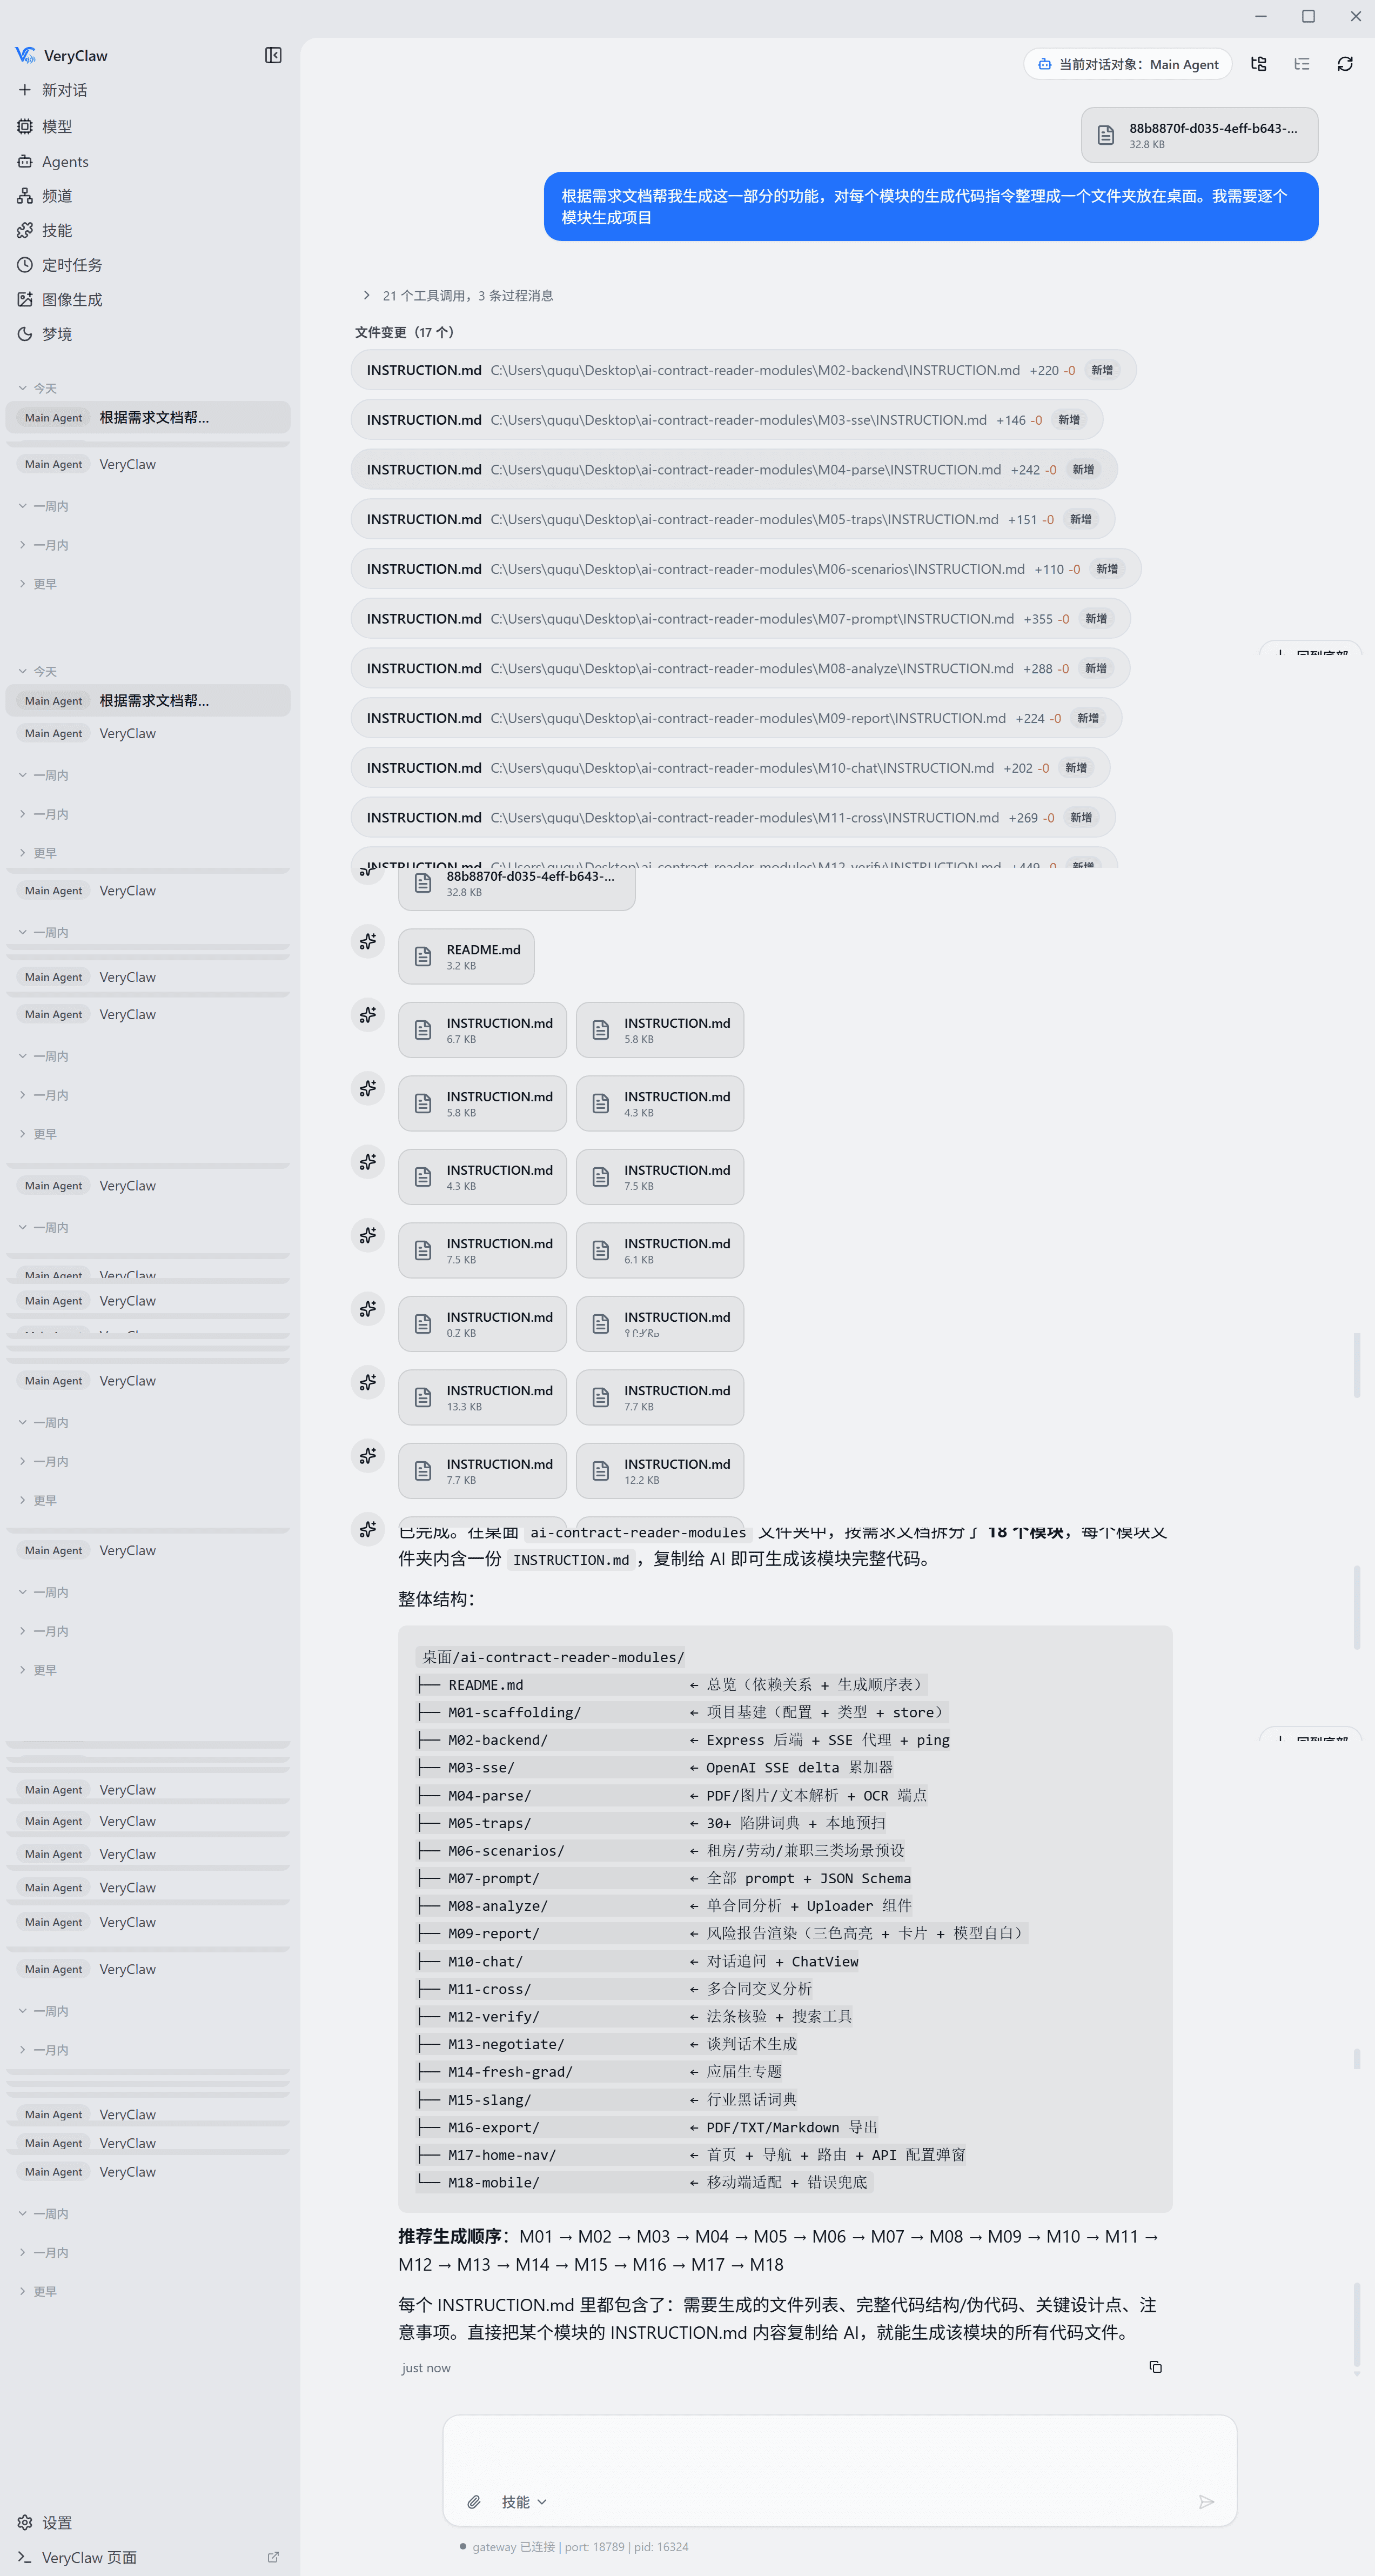
这份文档成为后续开发的唯一依据,确保模型生成的代码始终对齐产品目标。
技术实现:轻量架构下的关键设计
前后端分离与安全边界
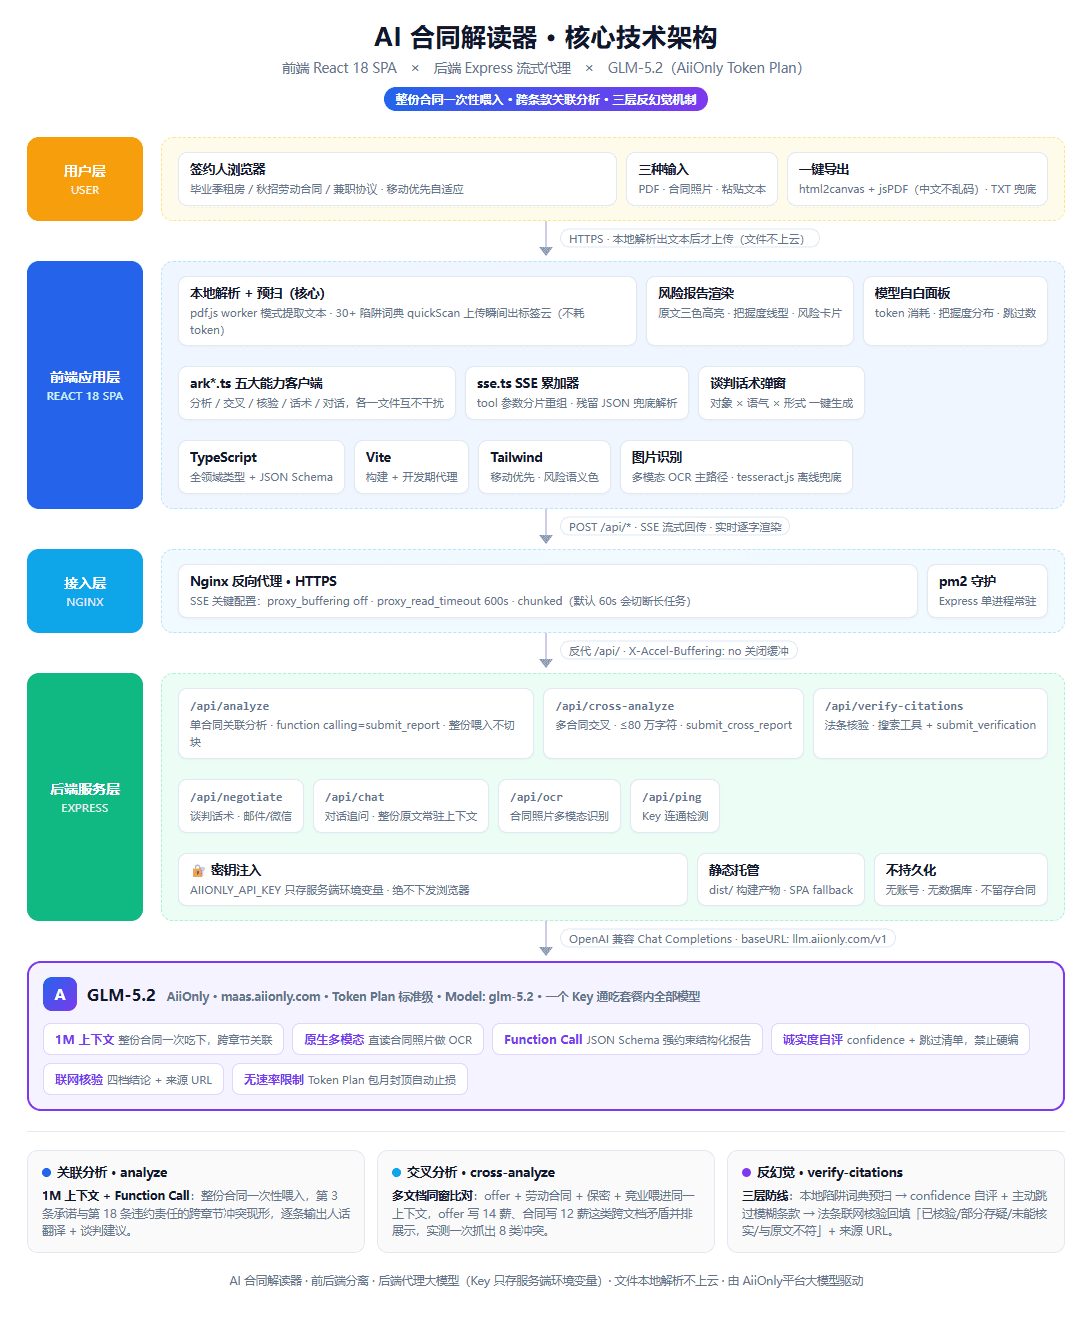
系统采用极简技术栈:前端 Vite + React 18 + Tailwind,后端仅一个 Express 进程。关键设计原则包括:
- 前端零密钥:所有请求经后端代理转发,API Key 仅存在于服务端环境变量,杜绝泄露风险。
- 本地解析优先:PDF 文件通过 pdf.js 在浏览器内转换为纯文本,原始文件永不离开用户设备。
- Nginx 调优:配置
proxy_buffering off和proxy_read_timeout 600s,确保长时 SSE 流不被中断。
五大 AI 能力的统一管道
尽管前端有五个独立功能入口(分析、交叉、核验、话术、对话),但后端均通过同一套 OpenAI 兼容协议调用 GLM-5.2。这种设计带来两大好处:
- 体验一致性:用户不会感知到不同功能背后的模型差异,响应速度与交互逻辑保持统一。
- 迁移零成本:若未来需更换模型(如升级至 GLM-6),仅需修改
model参数,无需重构任何业务逻辑。
反幻觉三层防御体系
法律场景对准确性要求极高,系统构建了递进式防错机制:
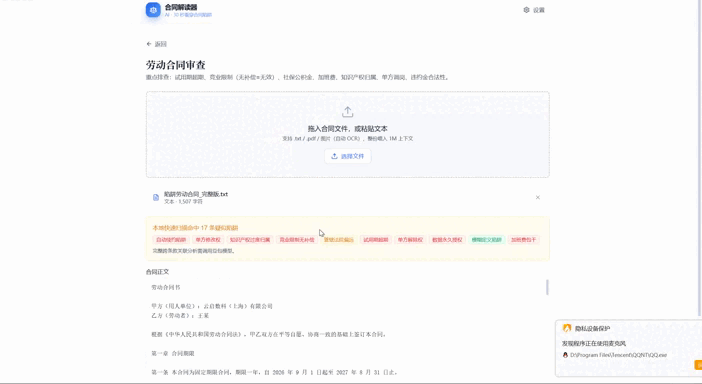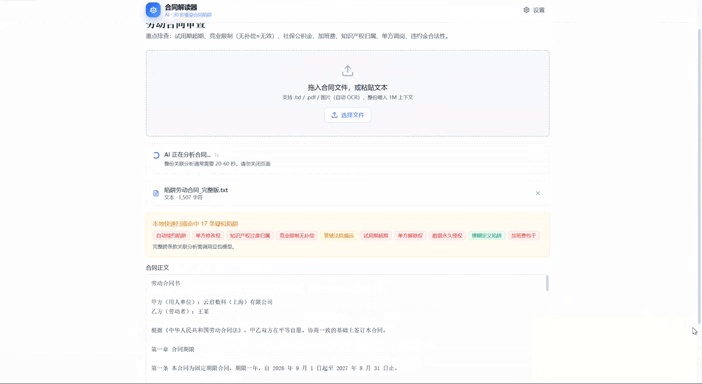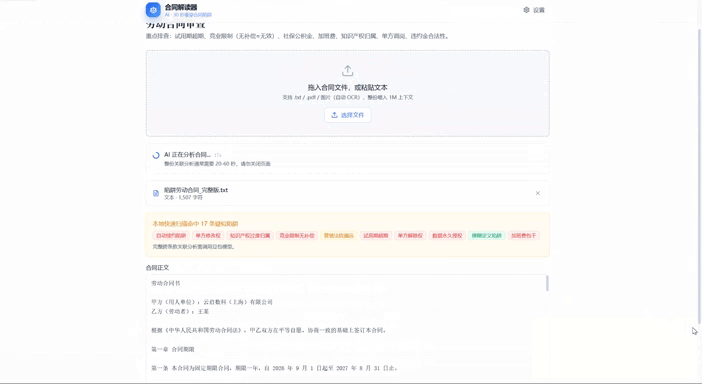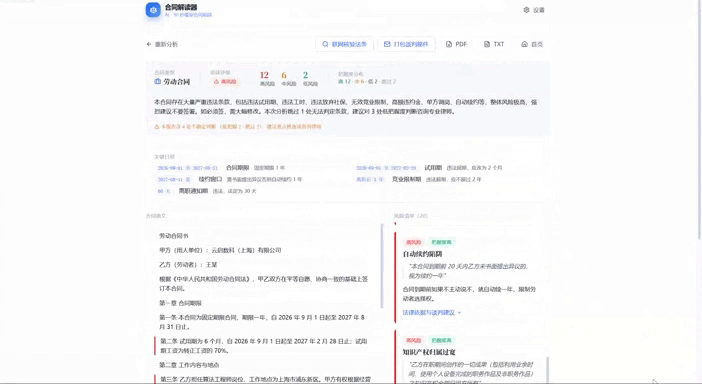
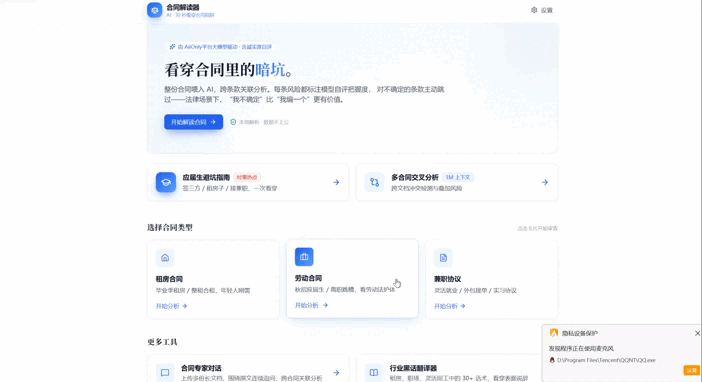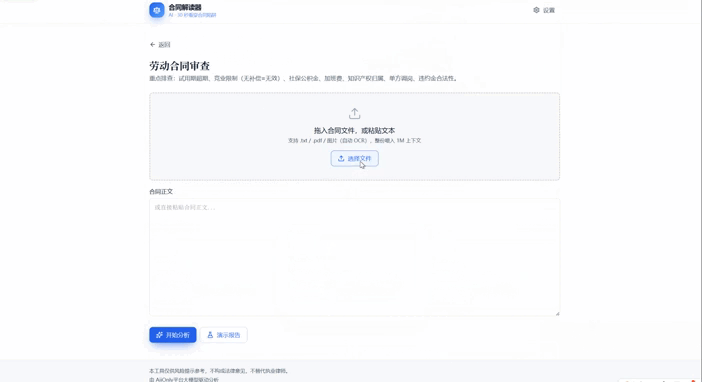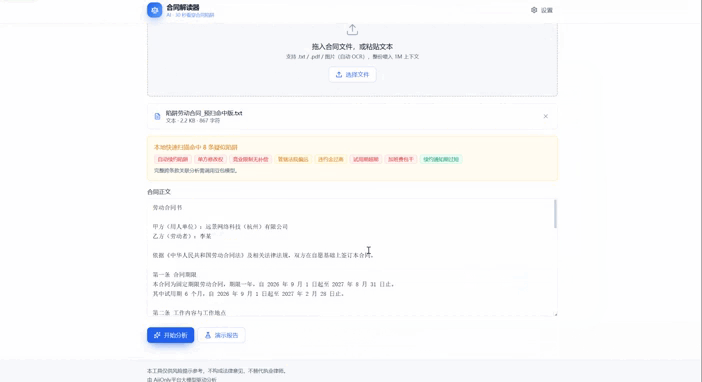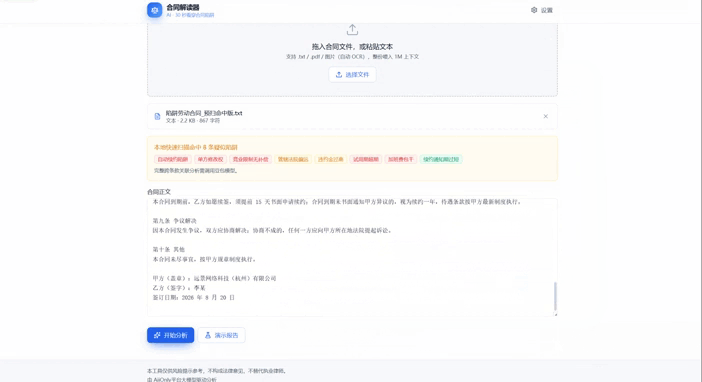
- 本地预扫:上传瞬间触发 30+ 条正则规则(如“单方修改权”“竞业无补偿”),即时标记可疑条款,不消耗任何 token。
- 置信度自评:System Prompt 强制模型为每条风险标注 confidence(high/mid/low),对信息不足的条款主动加入“跳过清单”并说明原因。
- 联网核验:报告生成后,自动调用 Tavily/Bing 检索每条引用的法条,返回四档结论(已核验/部分存疑/未能核实/与原文不符)并附来源链接。
这套机制确保系统宁可“说不知道”,也不“编造答案”,从根本上规避法律误导风险。
核心挑战:长上下文与流式结构化的平衡
1M 上下文的真实价值
许多平台宣称支持长上下文,但实际可能通过切块处理。本项目通过两种方式验证其有效性:
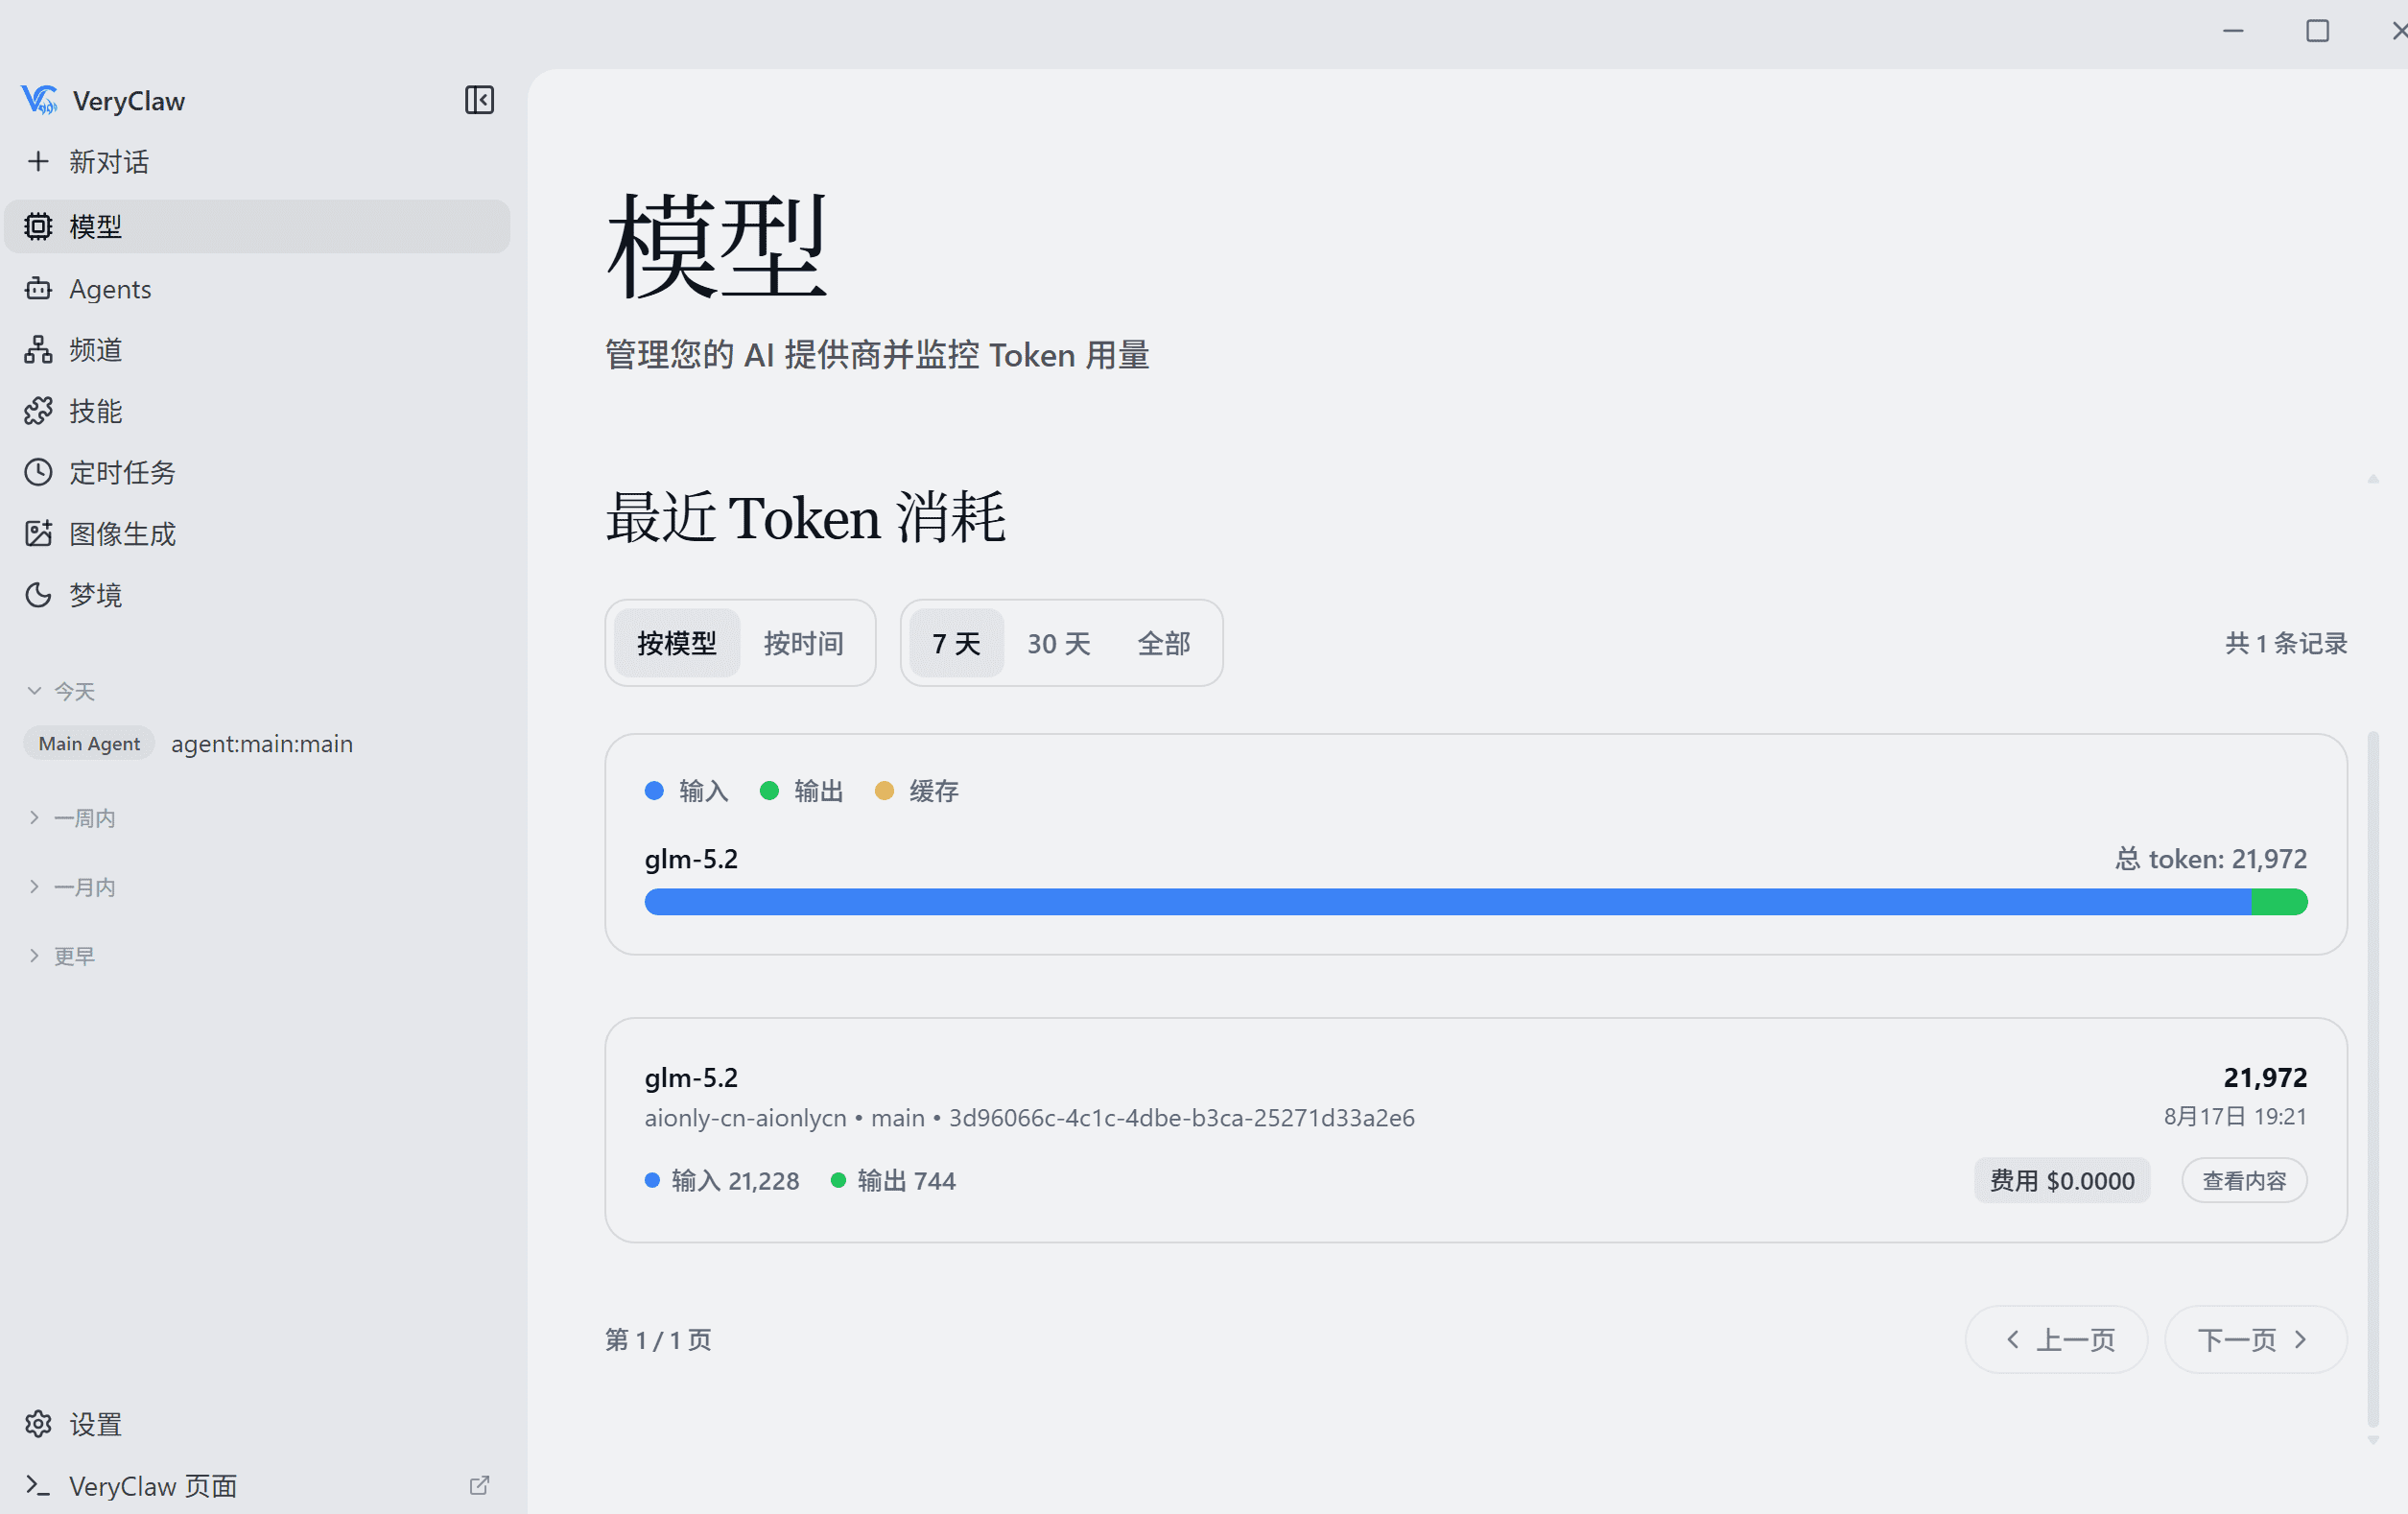
- 透传 usage 数据:前端可查看 input_tokens 数量,确认整份合同(实测达 12 万字)被完整载入。
- 跨条款关联结果:模型成功指出相隔数十页的条款矛盾,证明上下文窗口确实容纳了全文。
SSE 流式累加器的实现难点
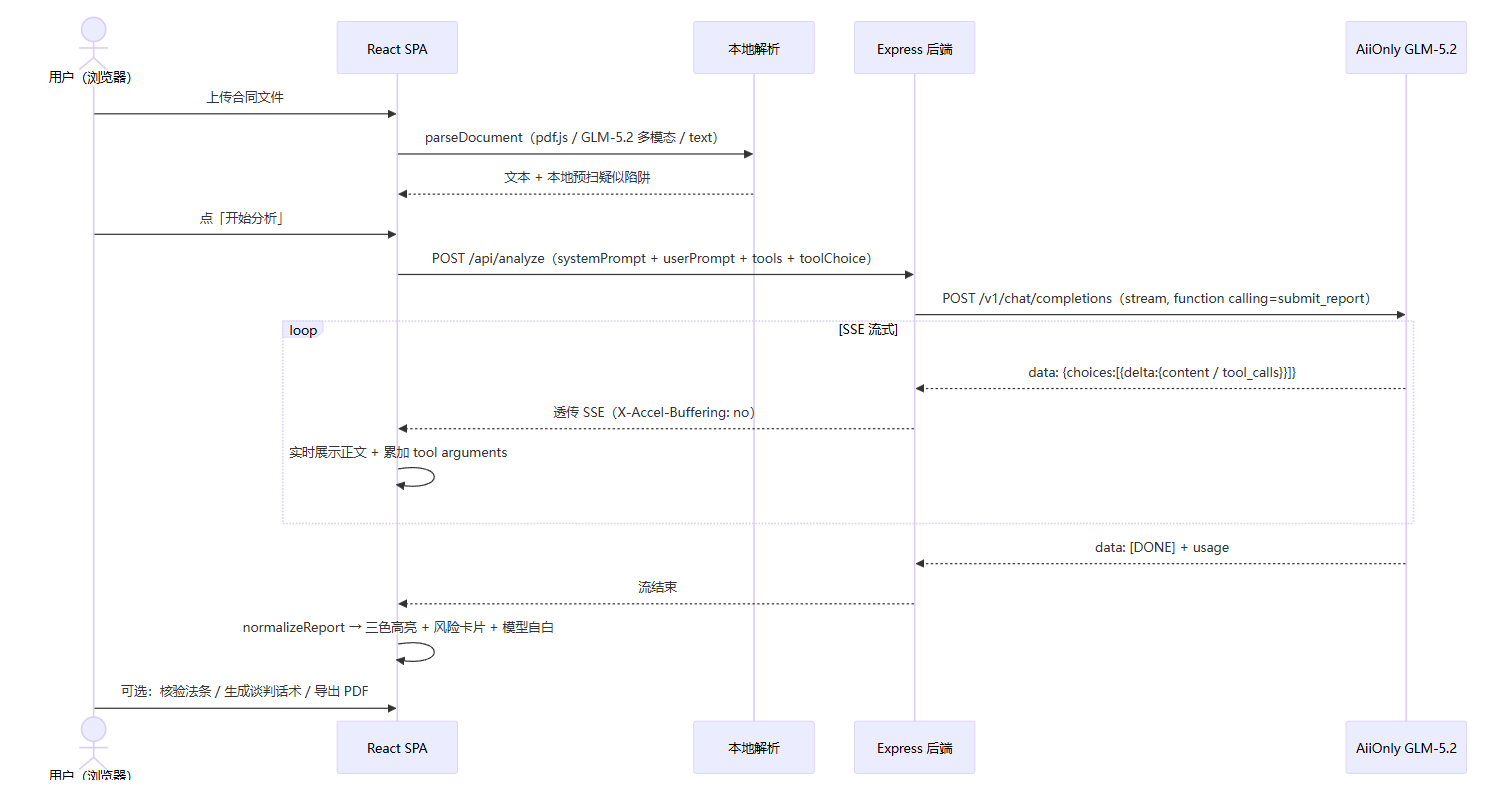
function calling 要求模型输出严格符合 JSON Schema,但在流式场景下,tool_use 的 input 字段以分片形式返回。若简单拼接字符串,极易因格式错误导致解析失败。
解决方案是构建智能累加器:
- 按
index聚合 content block,确保片段顺序正确 - 流结束时对残留片段进行容错解析(如补全缺失括号)
- 前端增加二次校验:非法枚举值降级为 mid,超长标题截断至 50 字
这一机制保障了即使模型输出略有偏差,前端仍能渲染出有效报告。
用户体验:从场景切入到行动闭环
首页设计:降低认知门槛
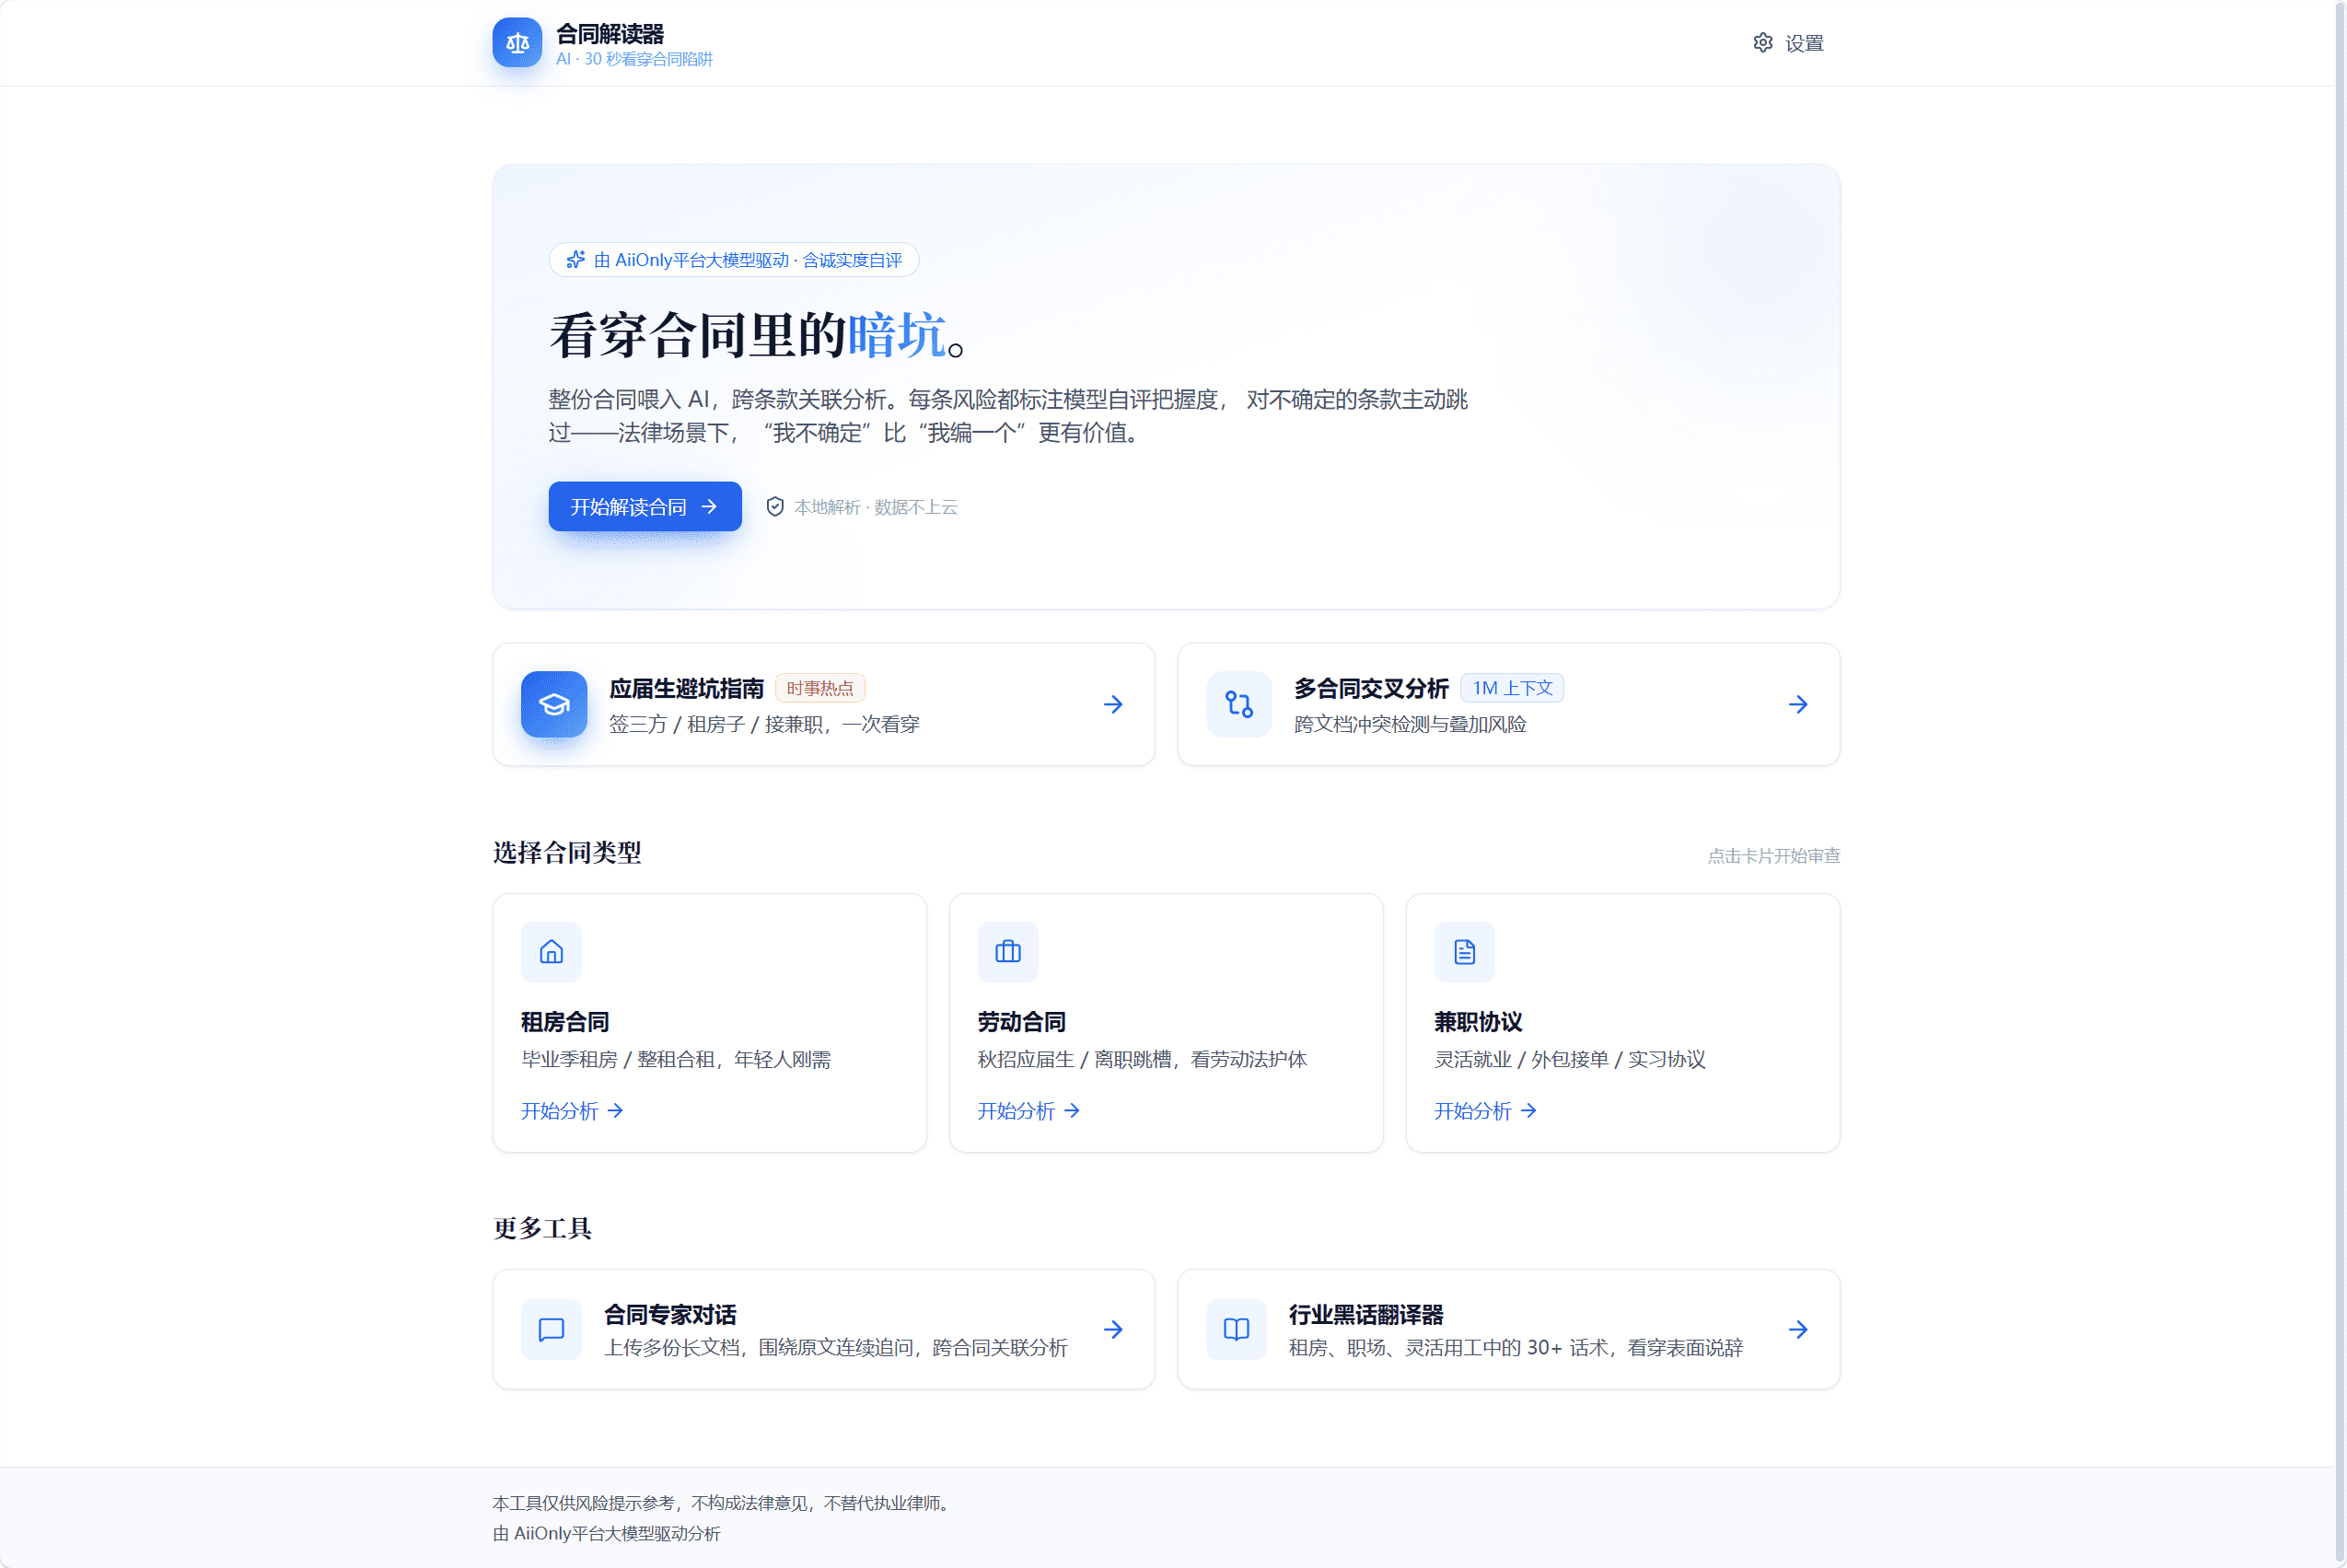
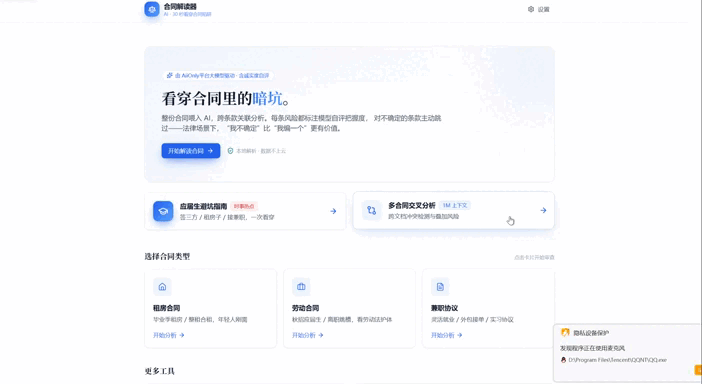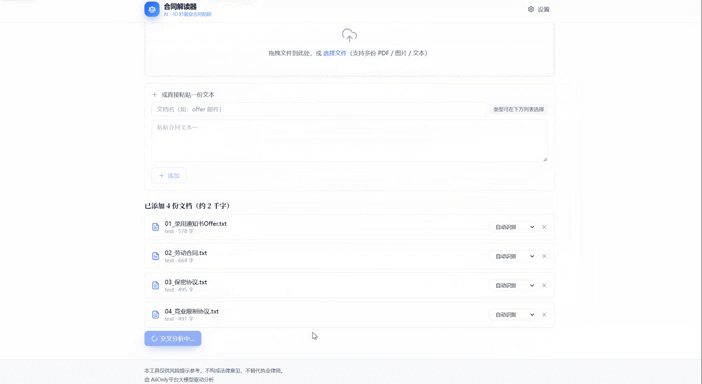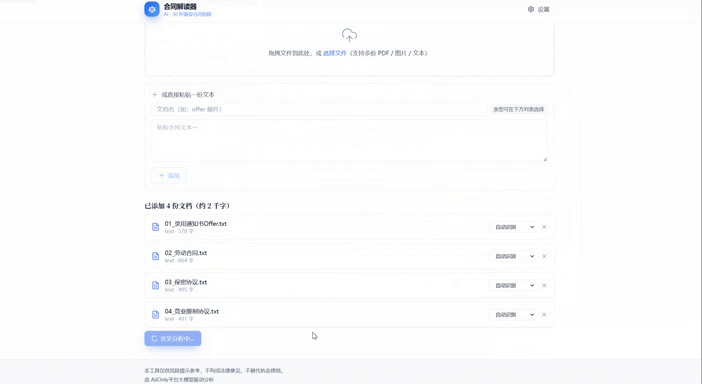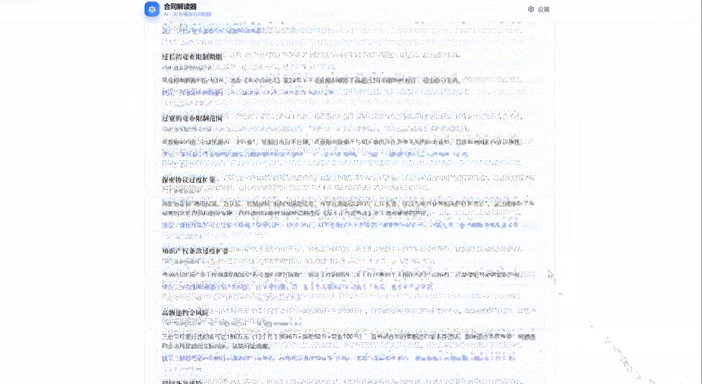
摒弃传统功能列表,首页直接按用户身份组织:
- 应届生专区:聚合租房、三方协议、兼职合同三大高频场景
- 多合同交叉分析:突出 1M 上下文能力,解决 offer 与劳动合同不一致等痛点
- 轻量工具入口:如“行业黑话翻译器”,将“弹性工作制”转译为“可能需随时加班”
报告呈现:透明化 AI 决策过程
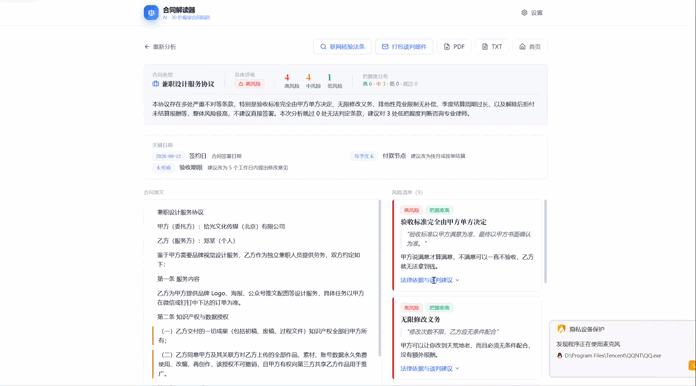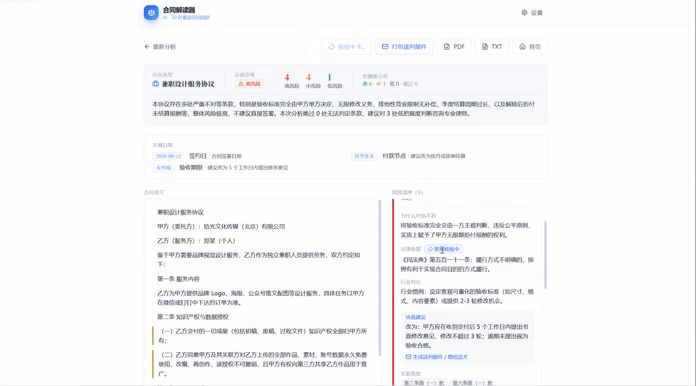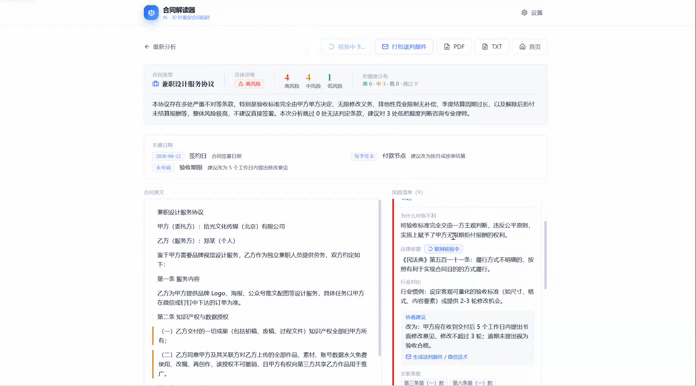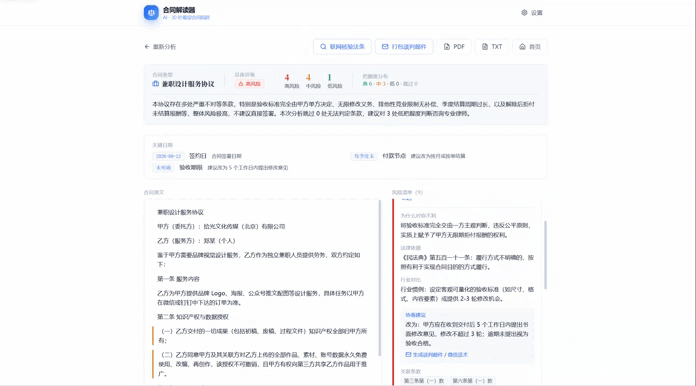
风险报告页采用三重可视化:
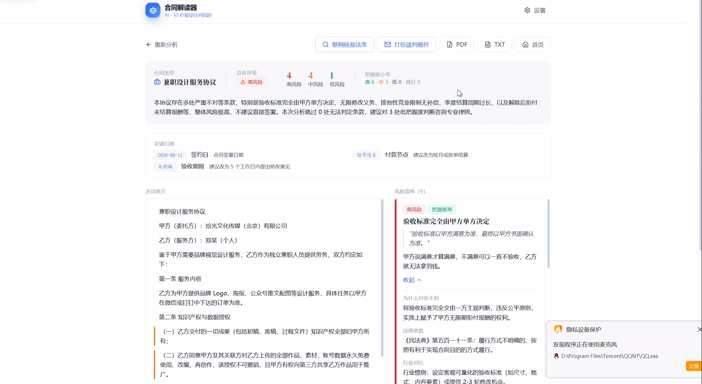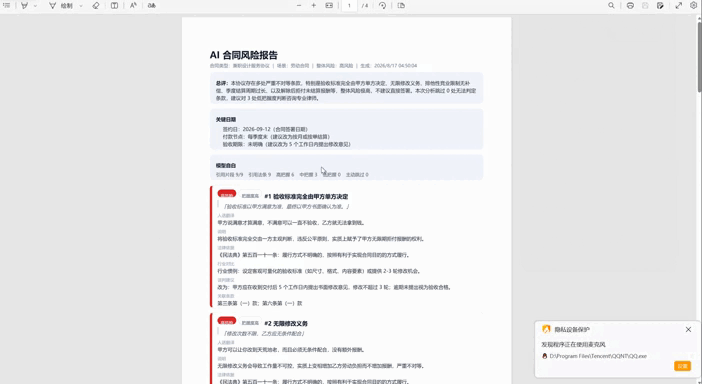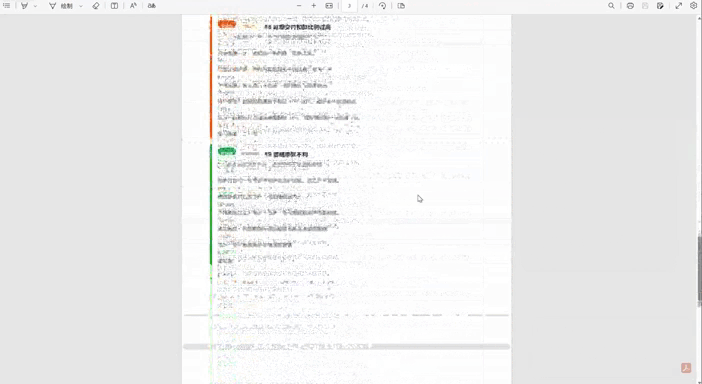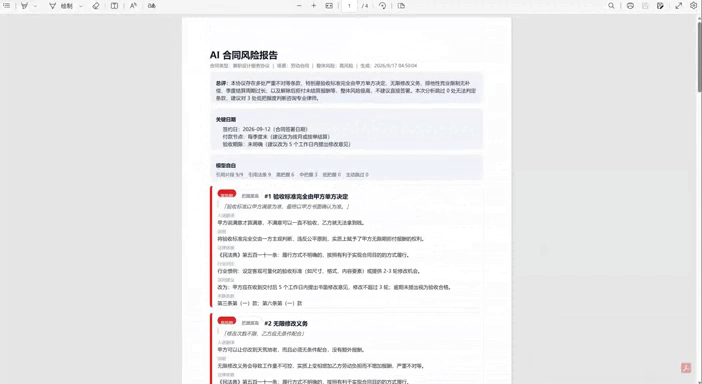
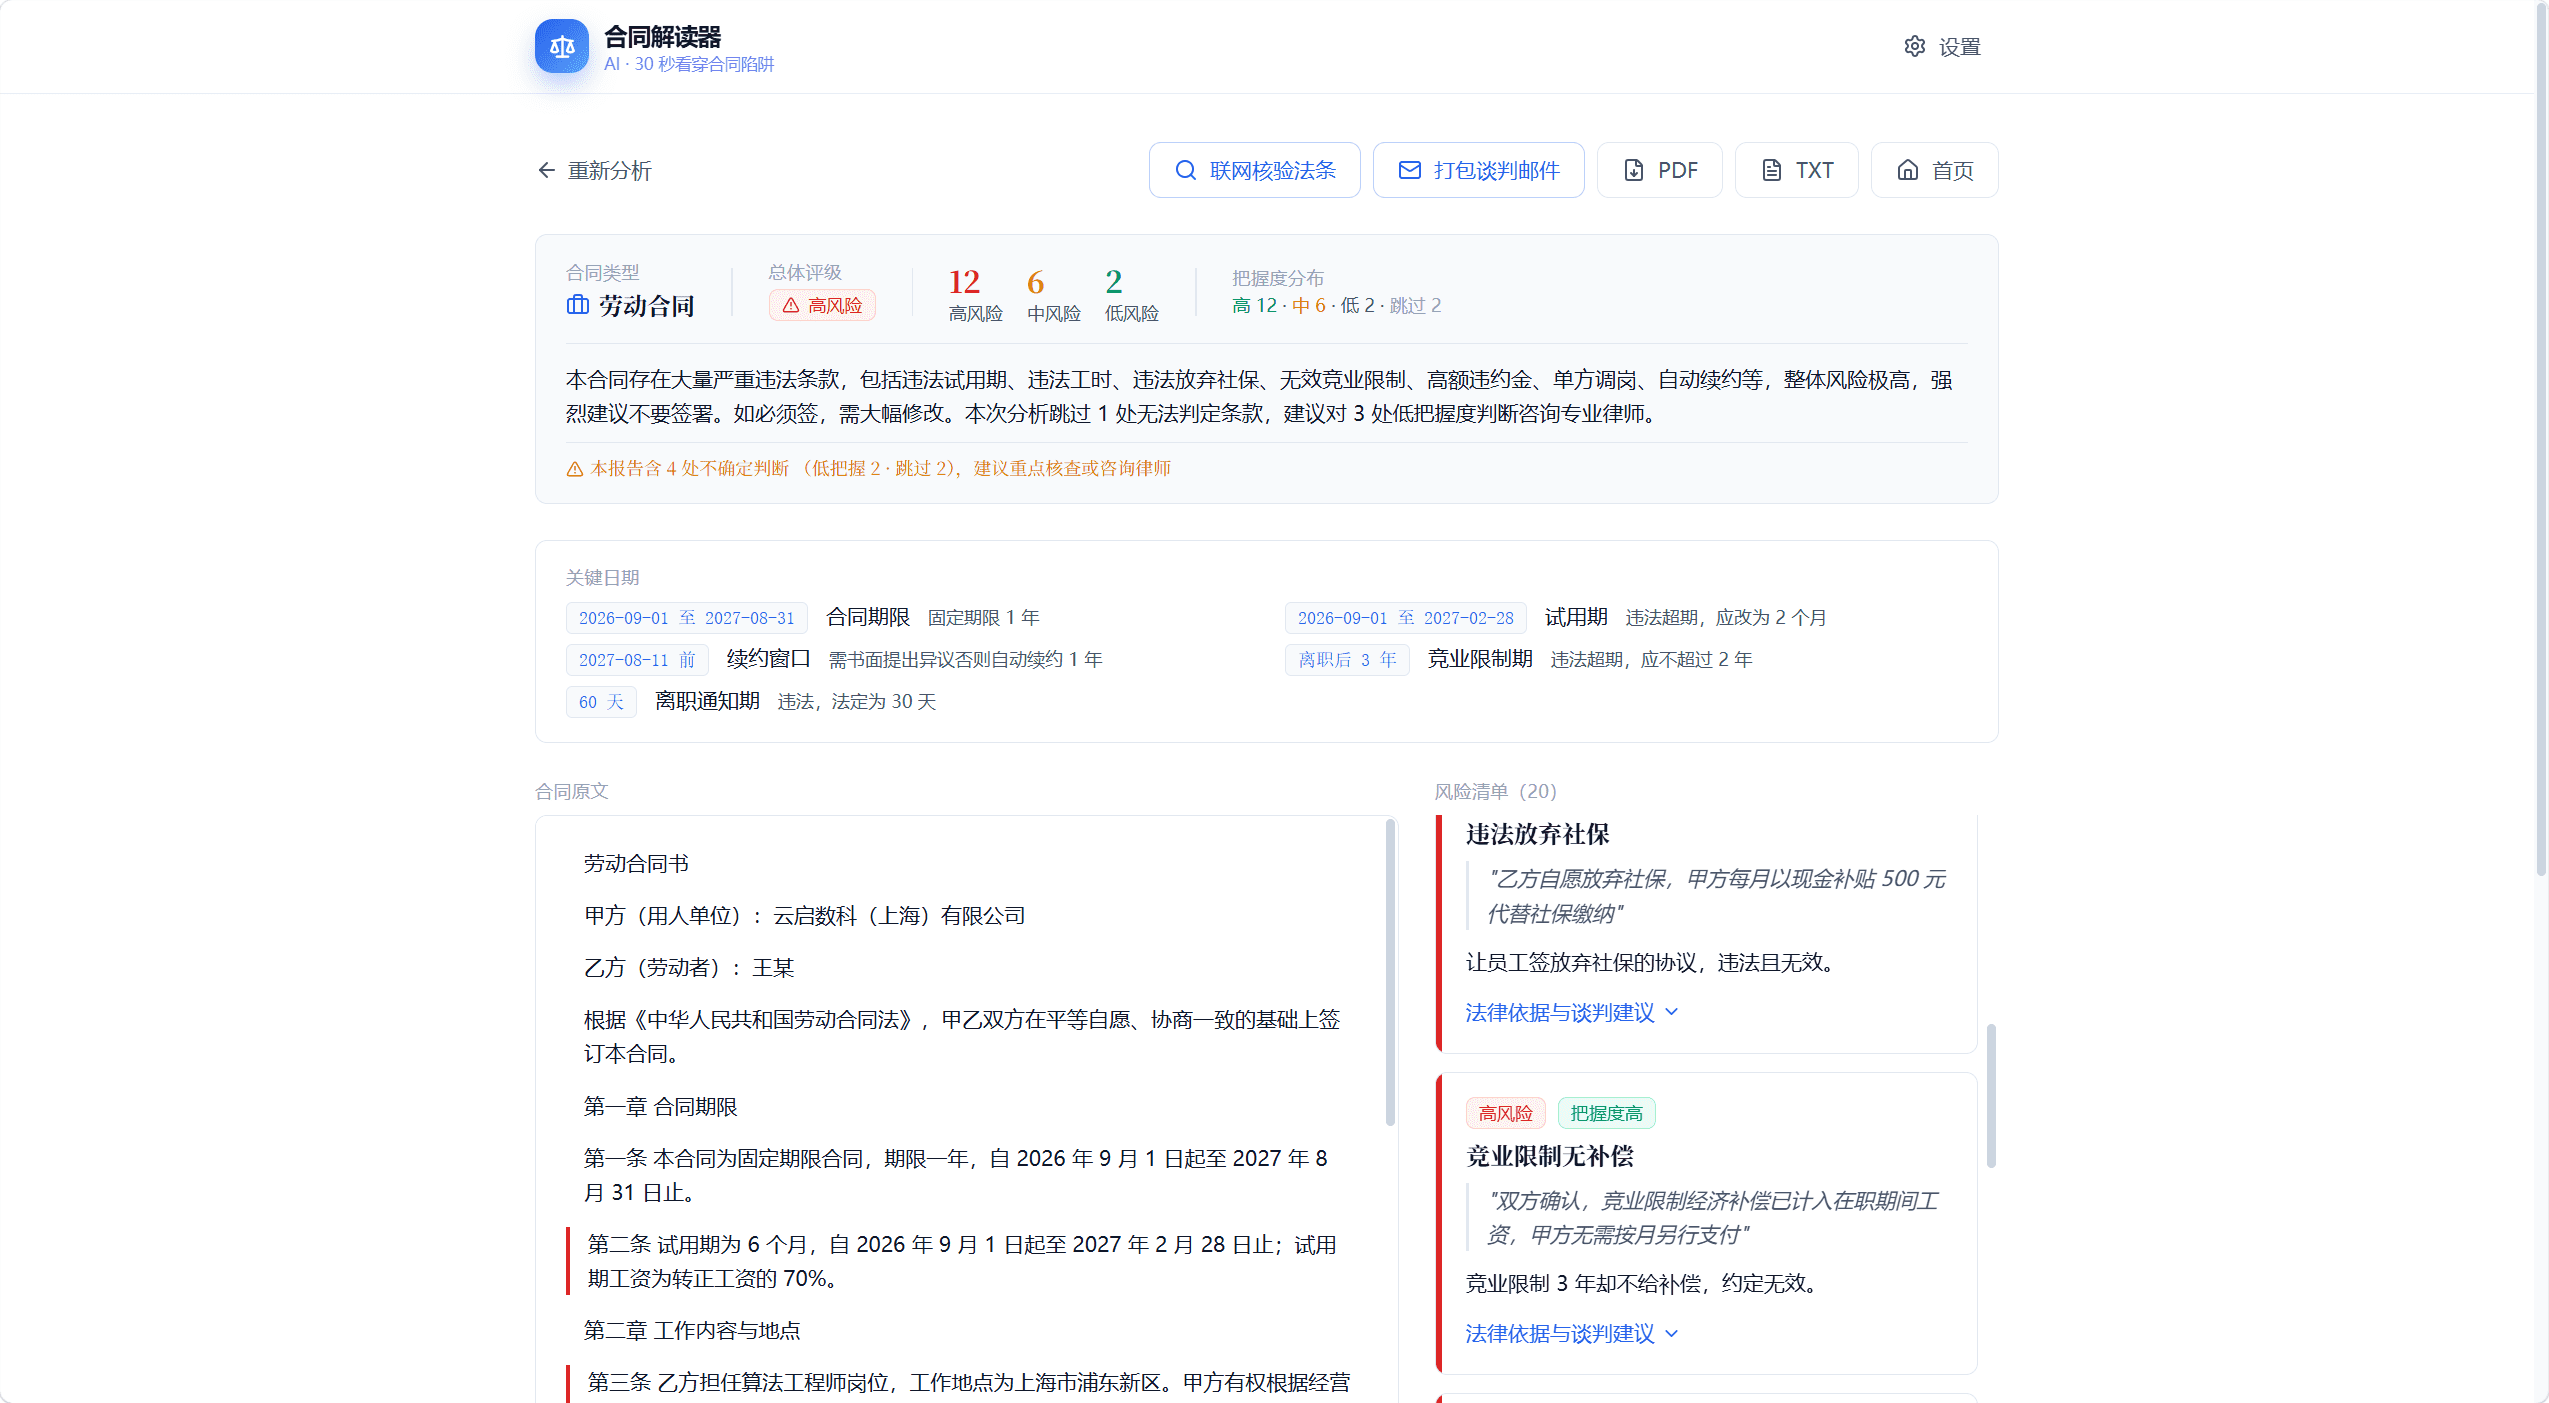
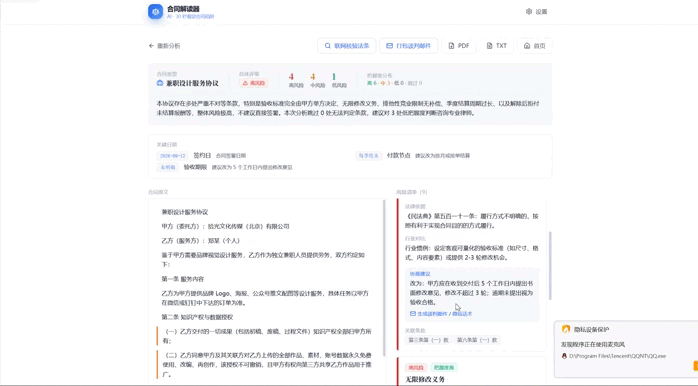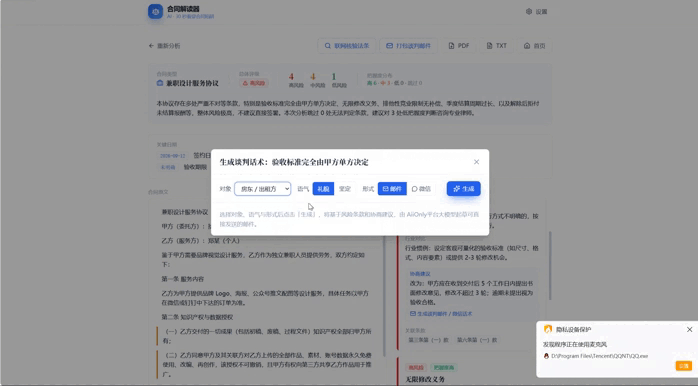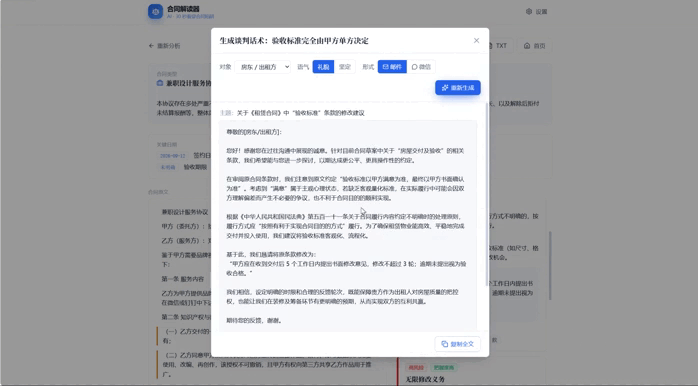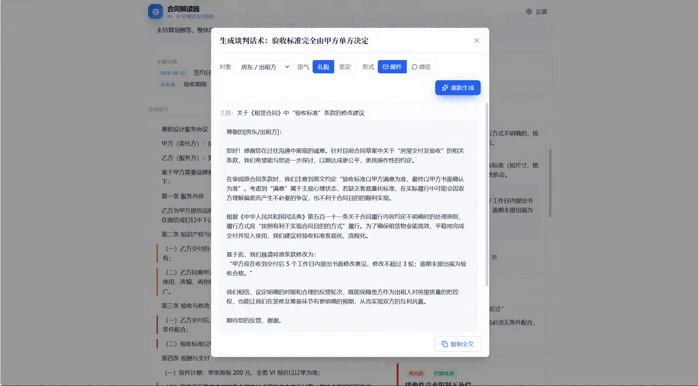
- 原文高亮:红/黄/绿三色标识风险等级,左侧色条线型(实线/虚线/点线)反映模型把握度
- 卡片详情:包含人话解释、法律依据、行业对比、具体修改建议(如“建议删除第 X 条”)
- 模型自白:展示引用片段数、法条数、置信度分布、主动跳过条数,增强可信度
行动转化:从发现问题到解决问题
工具不止于风险提示,更提供可执行方案:
- 谈判话术生成:选择对象(HR/房东)、语气(礼貌/坚定)、形式(邮件/微信),一键生成可直接发送的协商文本
- 移动端优化:微信话术自动切分为短句,避免大段文字影响阅读体验
- 多格式导出:支持 PDF 与 TXT,确保报告可离线留存
总结:个人开发者的 AI 应用新范式
该项目验证了一种高效可行的 AI 应用开发路径:
- 需求先行:通过 AI 辅助深度访谈,将模糊想法转化为可执行 SPEC,避免方向性返工。
- 平台赋能:利用 AiiOnly 等聚合平台的一站式能力,解决模型碎片化与成本不可控问题。
- 安全兜底:通过本地解析、密钥隔离、反幻觉机制,构建用户可信赖的产品基底。
- 体验闭环:从风险识别到行动建议,提供端到端解决方案,而非仅停留在信息展示。
对于拥有创意但受限于资源的个人开发者而言,这种“轻架构+强模型+严需求”的组合,或许正是将想法快速转化为真实价值的关键钥匙。