EASE:用证据锚定注意力,破解多模态RLVR中的感知信用分配难题
近年来,基于可验证奖励的强化学习(Reinforcement Learning with Verifiable Rewards, RLVR)已成为提升视觉语言模型(Vision-Language Models, VLMs)推理能力的标准范式。通过将最终答案是否正确作为奖励信号,模型能够在大量弱监督数据中自我优化。然而,这种“结果导向”的训练方式隐藏着一个根本性缺陷:它只告诉模型“答对了没有”,却从未说明“答案应从图像的哪个区域得出”。
在纯文本推理任务中,这一问题尚不突出——因为完整的推理链条以自然语言形式显式呈现于思维链(Chain-of-Thought)中,信用分配相对清晰。但在多模态场景下,关键证据的获取发生在不可见的“视觉感知”阶段。模型可能凭借语言先验、数据集统计偏差,甚至随机猜测输出正确答案,而实际上并未真正“看到”支撑该答案的视觉内容。这种“答对但看错”的现象,正是多模态幻觉(hallucination)的核心温床。
为系统性揭示这一盲区,研究者将其形式化为感知信用分配问题(Perception Credit Assignment Problem):当模型给出正确答案时,我们无法判断其成功源于对相关视觉证据的有效利用,还是依赖了非视觉捷径;反之,错误答案也无法区分是视觉感知失误还是后续推理失败。尤其在涉及计数、小目标定位、跨区域比较或复杂空间关系的任务中,此类歧义尤为致命——模型完全可以在忽略关键图像区域的情况下生成看似合理的文本响应。
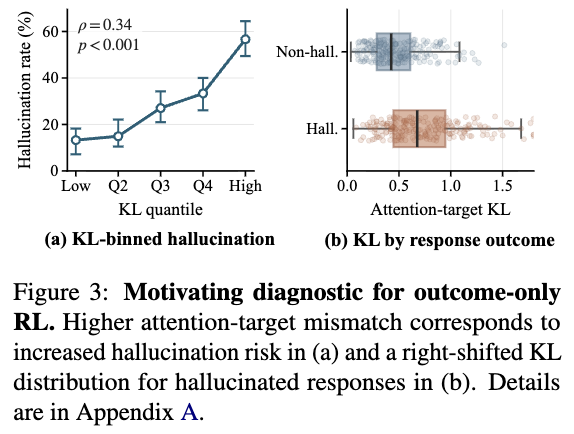
为验证该问题的现实存在性,团队首先对仅使用最终答案奖励训练的Qwen3-VL-4B模型进行了诊断分析。他们在HallusionBench-Image基准上计算每条回答对应的“回答token→视觉token”注意力分布与人工标注的证据区域目标分布之间的KL散度。结果显示:注意力与证据区域的错位程度与幻觉发生率呈显著正相关(Spearman相关系数ρ=0.34,p<0.001),且产生幻觉的回答其KL值整体右移。这一发现为后续方法设计提供了坚实的实证基础:单纯优化答案正确率不足以保证模型真正“看懂”图像,必须引入过程级监督信号。
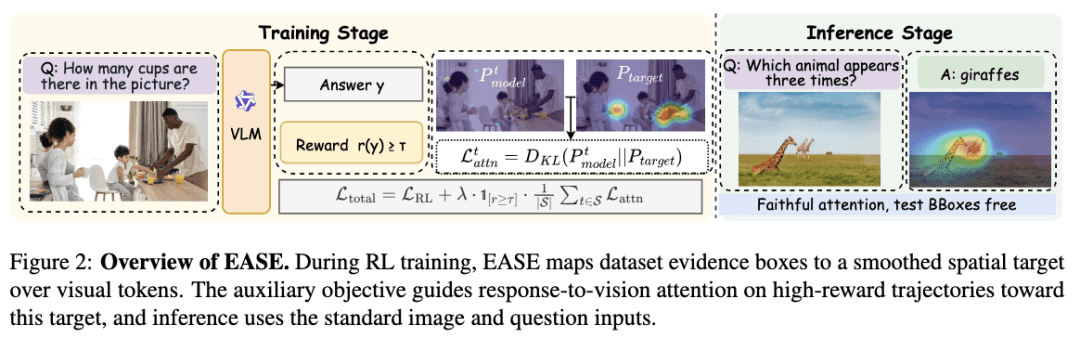
在此背景下,哈尔滨工业大学与北京中关村学院联合团队提出了EASE(Evidence-Anchored Spatial Attention Supervision)。其核心理念简洁而深刻:不仅要教模型“答什么”,更要教它“看哪里”。EASE通过将外部提供的证据标注转化为内部注意力机制的软性引导目标,在不改变模型推理流程的前提下,实现对视觉感知过程的精准调控。
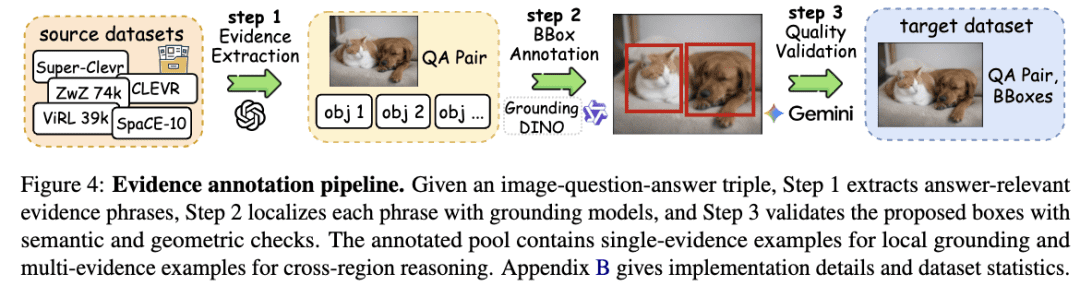
EASE的实现包含三个关键步骤:构建高质量证据标注、生成平滑注意力目标、实施奖励门控监督。
首先是证据标注流水线。训练样本被扩展为四元组(I, q, a, B),其中B为支撑答案a的证据边界框集合。这些标注仅用于训练,不参与模型输入。为确保质量,团队设计了一套三阶段自动化标注流程:首先,利用GPT-4.1-mini从“图像-问题-答案”三元组中抽取验证答案所需的最小可见实体短语;其次,借助Grounding DINO等开放词汇定位模型将短语映射为具体坐标框;最后,引入Gemini 2.5 Flash-Lite进行独立交叉验证,剔除空框、错位框或模糊框,避免单一模型偏差导致的自我循环。最终构建出覆盖ZwZ74K、CLEVR、Super-CLEVR、SpaCE10、ViRL39K等多个数据集的约127K高质量样本,并按单证据与多证据两类平衡采样,分别训练模型的局部接地能力与跨区域证据整合能力。
其次是软目标注意力分布的设计。不同于将证据框视为硬性0/1掩码的传统做法,EASE采用更鲁棒的概率建模策略:每个边界框被转换为一个二维高斯分布,其中心位于框的几何中心,标准差σ设定为使2σ恰好覆盖框宽或高的二分之一。这种设计使得概率质量集中于框内,同时对标注噪声、粗糙边界及跨越多个视觉token的物体边缘具有天然容错性。对于含多个证据的样本,各高斯分布被赋予相等权重进行混合,防止大面积区域主导监督信号,迫使模型均衡关注所有相关区域。此外,为保留必要的视觉上下文信息,目标分布中还混入10%的均匀背景噪声,避免将非证据区域的注意力强行压制至零。
第三步是奖励门控机制(Reward-Aware Gating)。EASE仅在原始验证器奖励达标的轨迹上施加注意力监督损失。这是因为错误回答所对应的注意力模式本身不可靠——若强行将其对齐到正确证据区域,相当于在学习“误导性的对齐”。因此,系统仅将高奖励轨迹视为“可靠的过程示范”,对其第⌊2L/3⌋层(语义中间层)的回答token对视觉token的条件注意力分布,计算其与证据目标分布之间的KL散度,并以此作为正则项加入总损失函数。消融实验充分验证了各组件的有效性:移除高斯软目标导致平均性能下降2.5分,取消奖励门控损失3.4分,省略背景平滑则损失2分。
值得注意的是,EASE在推理阶段完全零开销。所有证据标注均为特权训练信息(privileged information),训练完成后模型仍沿用标准VLM的“图像+问题”输入通路,输出格式与解码流程保持不变。这使其相较于需将坐标写入输出文本的方法(如Ground-R1、Point-RFT)更具工程友好性,也更容易嵌入现有RLVR训练栈。
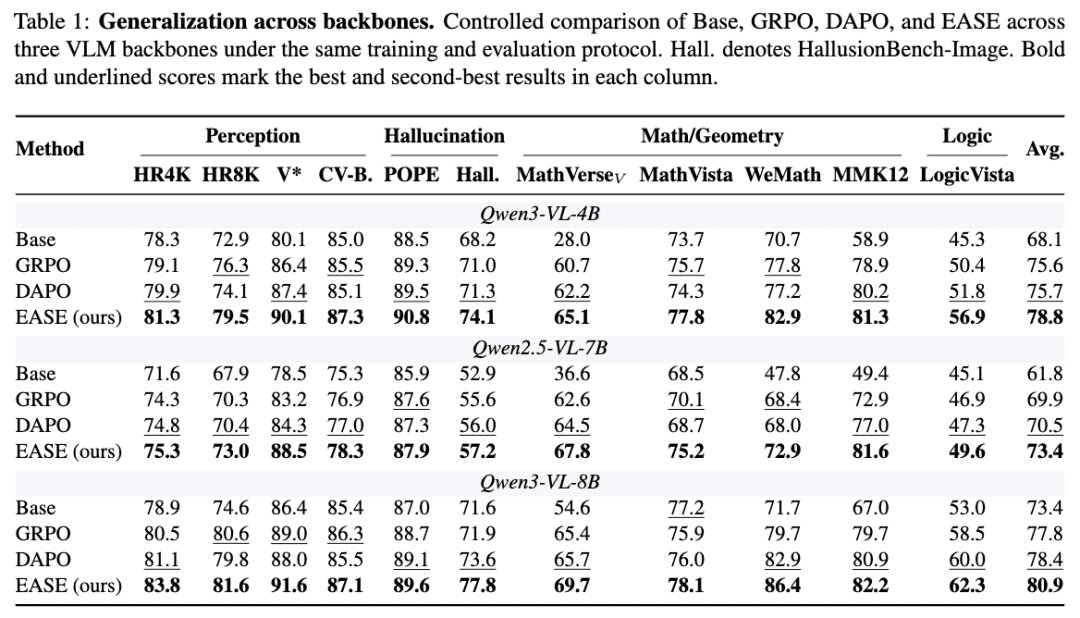
为全面评估EASE的有效性,研究团队在三大主流Qwen-VL基座(Qwen2.5-VL-7B、Qwen3-VL-4B、Qwen3-VL-8B)上开展了大规模实验,涵盖11个权威基准:包括感知能力测试(HR-Bench、V*、CV-Bench)、幻觉评估(POPE、HallusionBench-Image)、视觉数学推理(MathVista、MathVerse_V、WeMath、MMK12)以及逻辑推理(LogicVista)。在严格控制训练协议的前提下,EASE在所有基座的所有基准上均一致优于最强outcome-only基线DAPO。增益最为显著的任务集中在高度依赖视觉证据的领域:例如在Qwen2.5-VL-7B上,MathVista提升6.5分、WeMath提升4.9分、MMK12提升4.6分、V*提升4.2分,充分印证了方法设计与任务需求的高度契合。
进一步与当前公开的7B级多模态推理方法横向对比(包括ThinkLite-VL、VL-Rethinker、MM-Eureka、PAPO、VPPO、VGPO等),EASE-7B以66.0的平均分位居榜首,并在MathVista、MathVerse_V、WeMath、LogicVista四项关键指标上取得最优结果。
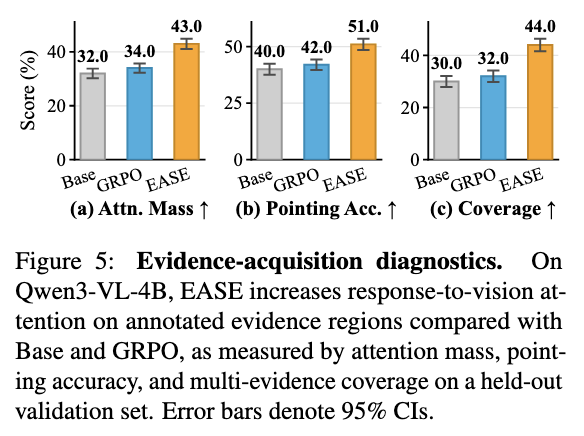
更重要的是,过程指标的分析揭示了性能提升的真实来源。EASE在三项诊断性指标上全面领先:证据注意力质量(Evidence Attention Metric, EAM)衡量注意力是否集中于证据区域;指向准确率(Pointing Accuracy)评估注意力峰值是否落在正确位置;多证据覆盖率(Coverage)则检验模型能否同时关注多个分散证据。这些指标的同步提升表明,EASE的增益并非来自答案正确率的表面优化,而是源于模型真正学会了“看向正确的地方”。
综上所述,EASE通过将外部证据标注内化为注意力监督信号,有效解决了多模态RLVR中的感知信用分配难题。它不仅提升了模型在各类视觉推理任务上的表现,更从根本上增强了其感知-推理的一致性,降低了幻觉风险。这一工作标志着多模态强化学习正经历从“结果验证”向“过程监督”的范式转变——正如文本推理中监督思维链一样,在多模态场景中,注意力本身即是一种可监督、且值得监督的过程信号。未来,如何进一步挖掘视觉感知过程中的可解释信号,并将其融入更广泛的对齐与安全框架,将成为推动VLM走向可靠智能的关键方向。