UniSteer:如何用两条人类演示让机器人学会拼豆?
近年来,视觉-语言-动作模型(Vision-Language-Action Model, VLA)凭借其强大的多模态理解与动作生成能力,已成为机器人操作领域的基础架构。这类模型通过大规模预训练,结合少量示范微调,已能稳定执行抓取、放置、堆叠等常见任务。然而,一旦任务涉及精密接触、微小容差或非标准物体位姿,其性能往往急剧下降。这种局限性凸显了一个关键问题:预训练提供的“大致可行”策略,距离“稳定可靠”的工业级操作仍有显著差距。

要弥合这一差距,真机强化学习(Real-world Reinforcement Learning)被视为必要路径。它允许机器人在真实环境中通过试错,逐步适应具体的物理特性、视角变化和接触动力学。但现实约束极为严苛——每一次失败不仅消耗宝贵的设备运行时间,还可能损坏物体、扰乱实验环境,甚至危及安全。因此,核心挑战并非“能否学习”,而是如何以最少的真实交互次数,实现策略的快速收敛。

一个直观的解决方案是引入人类干预:当机器人即将失败时,操作员接管并完成纠正动作。这种方法在传统机器人学习中已有应用,如DAgger算法。然而,当VLA采用流匹配(flow matching)这一前沿生成范式时,新的矛盾浮现:人类提供的是末端执行器的动作轨迹,而轻量化的强化学习优化目标却是初始高斯噪声。两者处于完全不同的表示空间,缺乏直接映射关系。换言之,人类知道“机械臂该怎么动”,却无法告诉模型“应该选哪个噪声”。
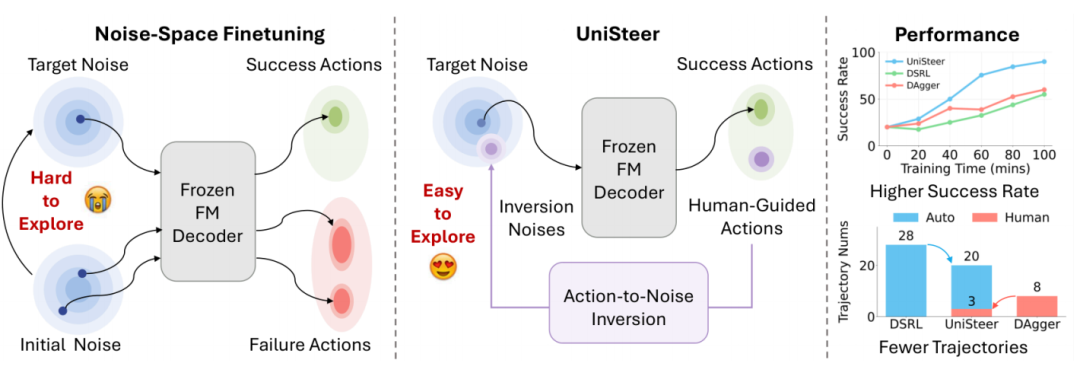
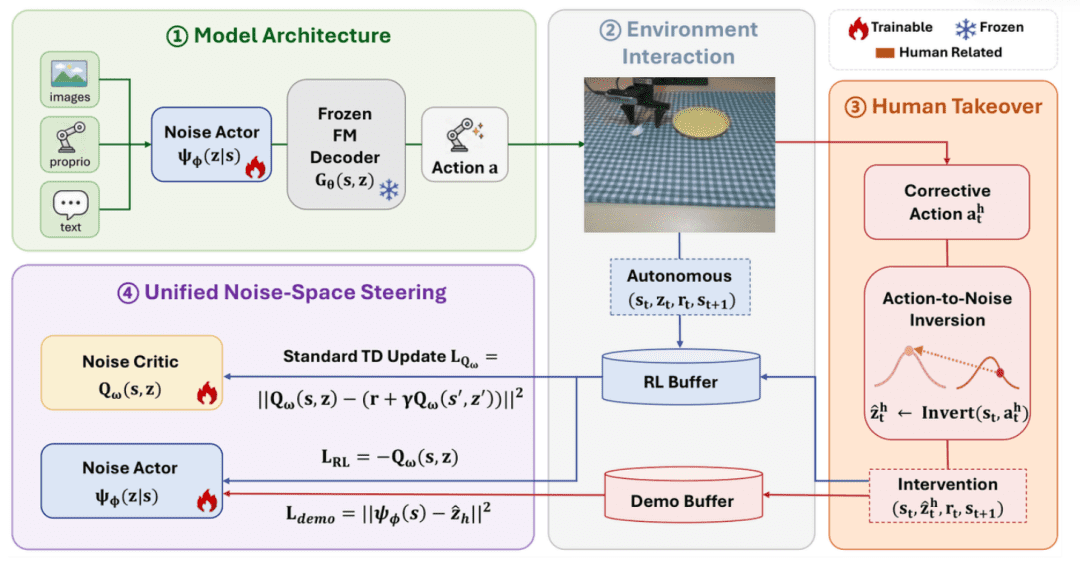
针对这一瓶颈,微软亚洲研究院、悉尼科技大学与清华大学联合提出 UniSteer(Unified Noise Steering)。该方法的核心创新在于构建了一个动作到噪声的近似反演机制,将人类纠正动作转化为对noise actor的有效监督信号,从而实现监督学习与强化学习在同一个轻量模块上的协同更新,同时保持预训练VLA动作解码器的冻结状态。
为验证其在高精度任务中的潜力,研究团队设计了一项极具挑战性的实验:机械臂拼豆。任务要求机器人逐颗夹取直径约5毫米的聚乙烯中空颗粒,并将其精准套入拼豆板上对应的柱状凸起。此过程对力度、姿态和释放时机均有极高要求——夹持过紧易导致颗粒弹飞,角度偏差超过几度便无法顺利嵌入,释放时的微小碰撞甚至可能推倒已放置好的豆粒。在如此苛刻的条件下,UniSteer仅依赖两条完整的人类演示轨迹作为在线学习阶段的数据预算,成功引导机械臂完成了包含16颗豆粒的微软Logo拼图。

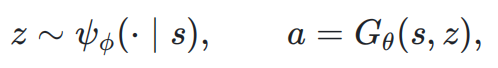
UniSteer的技术实现建立在对流匹配生成过程的深刻理解之上。当前主流VLA通常采用多步去噪机制:给定视觉观测、机器人状态和语言指令,模型首先采样一个初始噪声 $ z_0 \sim \mathcal{N}(0, I) $,再通过预训练的解码器 $ \phi_{\theta} $ 沿速度场逐步演化,最终输出动作序列 $ a = \phi_{\theta}(z_0, s, l) $。直接对整个VLA进行在线微调计算开销巨大,且梯度需穿越多步生成过程,训练极不稳定。因此,噪声空间强化学习成为更优选择:冻结 $ \phi_{\theta} $,仅训练一个小型noise actor $ \pi_{\psi}(s, l) $ 来预测初始噪声,再由冻结解码器生成动作。

尽管该设计显著降低了训练成本并保留了预训练先验,但其探索效率仍受制于稀疏奖励问题。若初始策略成功率极低,actor难以获得正向反馈,陷入无效探索。人类纠正本可打破这一僵局,但关键障碍在于:如何从人类提供的动作 $ a_{\text{human}} $ 反推出对应的初始噪声 $ z_0^{*} $?
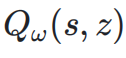
UniSteer的答案是逆向遍历流匹配的离散Euler求解过程。假设前向生成为: $$ z_{t+1} = z_t + \Delta t \cdot v_{\theta}(z_t, t, s, l) $$ 其中 $ v_{\theta} $ 为预训练的速度场。要从终点动作 $ a = z_T $ 回溯至 $ z_0 $,需在每一步求解: $$ z_t = z_{t+1} - \Delta t \cdot v_{\theta}(z_t, t, s, l) $$ 该方程右侧仍含未知量 $ z_t $,构成不动点问题。UniSteer利用速度场关于 $ z $ 的Lipschitz连续性,证明当步长 $ \Delta t $ 足够小时,映射为压缩映射,可通过迭代: $$ z_t^{(k+1)} = z_{t+1} - \Delta t \cdot v_{\theta}(z_t^{(k)}, t, s, l) $$ 快速收敛至唯一解。由此,从人类动作出发,逐层反演即可高效恢复出目标初始噪声 $ z_0^{*} $。

获得 $ z_0^{} $ 后,人类指导便能无缝融入训练流程。系统维护两个缓冲区:强化学习缓冲区存储自主执行的 $ (s, z, r, s') $ 样本;演示缓冲区则存入经反演得到的 $ (s, z_0^{}) $ 对。训练时,actor同时接受两项损失:
- 监督损失:在演示样本上最小化 $ | \pi_{\psi}(s, l) - z_0^{*} |^2 $,将策略拉向人类指示的高潜力区域;
- 强化学习损失:基于critic评估的状态-噪声价值,通过策略梯度进一步优化。

这种统一框架避免了传统方法中监督与强化学习修改不同模型组件的割裂问题。人类纠正不再仅用于行为克隆,而是为强化学习提供高质量的探索起点;强化学习则在此基础上,利用真实任务奖励进行精细化调整,形成“引导-优化”闭环。


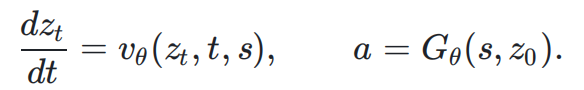
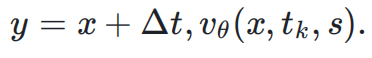


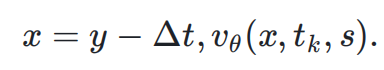
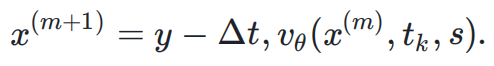

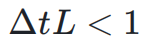

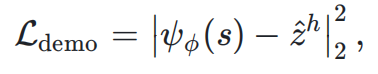
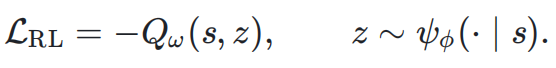

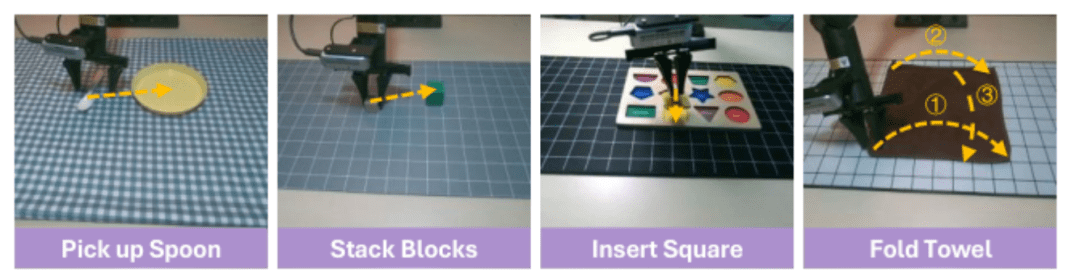
实验在AgileX Piper六自由度机械臂上展开,涵盖四项典型任务:拿勺子、堆叠积木、插入方块、折叠毛巾,分别对应抓取、精密装配与可变形物体操作。系统以30Hz频率接收侧视与腕部RGB图像、6D末端位姿及夹爪状态。所有实验均从同一预训练VLA出发,先用30条示范进行预热,再进入在线微调阶段。
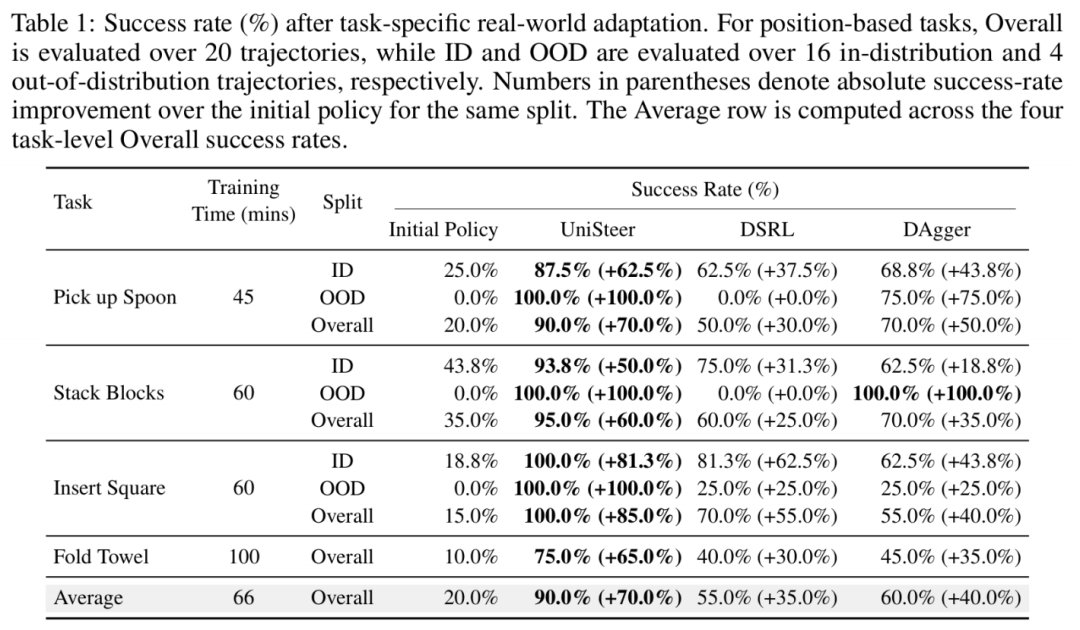
结果表明,UniSteer在平均66分钟的真机交互后,将四项任务的平均成功率从20%提升至90%。对比基线中,纯噪声空间强化学习(DSRL)仅达55%,而经典人工纠错算法DAgger为60%。更关键的是在分布外(OOD)测试中:初始策略在三项任务上成功率均为0%,UniSteer微调后全部达到100%;DSRL则分别为0%、0%、25%,DAgger为75%、100%、25%。这证明UniSteer不仅提升绝对性能,更显著增强了泛化能力。
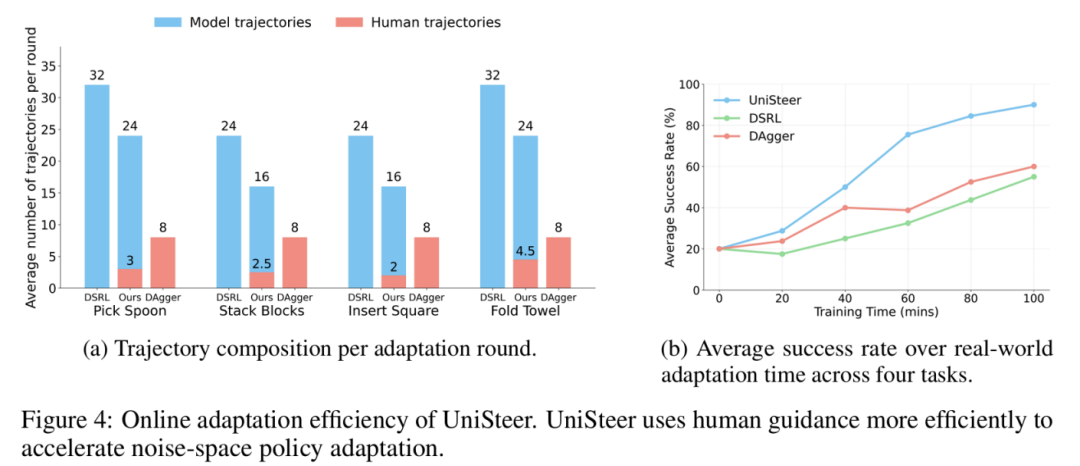
值得注意的是,UniSteer的人力投入远低于DAgger。后者每轮需固定收集8条完整人工轨迹,而UniSteer在更少人类干预下取得更优效果。同时,其使用的纯模型轨迹也少于DSRL,说明性能提升源于探索效率的质变,而非数据量的简单堆砌。
研究者还对比了其他噪声反演方案。一种是将噪声作为优化变量,通过梯度下降最小化重建误差;另一种是端到端反传动作误差至actor。实验显示,固定点反演在速度、精度与最终成功率上综合最优。例如在拿勺子任务中,固定点法耗时73秒、8/8成功;优化法耗时208秒、仅3/8成功;端到端反传则需193秒。这证实了UniSteer设计的高效性——它以较低计算成本,获得了与冻结VLA一致的噪声监督目标。
综上,UniSteer为VLA的真机适应提供了一条高效路径:无需更新庞大的预训练模型,不必依赖大量稀疏奖励探索,而是将人类在关键时刻的纠正,精准转化为噪声空间中的学习信号。从拼豆任务的成功到四项基准的显著提升,该方法展示了有限人类参与如何驱动策略的快速进化。随着VLA向更复杂、更精密的真实场景迈进,UniSteer所构建的“统一噪声接口”,或将成为机器人后训练不可或缺的基础设施。