Puffin-World:统一多模态模型如何通过原生3D世界状态实现物理感知与生成
近年来,生成式人工智能在图像与视频创作领域取得了显著进展,但多数系统仍局限于二维像素层面的外观建模。它们能生成视觉上逼真的画面,却缺乏对真实物理世界的深层理解——无法判断“上”在哪里,不清楚物体间的空间关系,更难以在任意视角下保持场景的一致性。这种局限性在需要长轨迹相机运动、极端旋转或从单张未校准图像出发的任务中尤为突出。为突破这一瓶颈,Puffin-World提出了一种全新的范式:将世界建模从单纯的外观生成,转向融合物理、几何与视觉的统一三维世界状态。
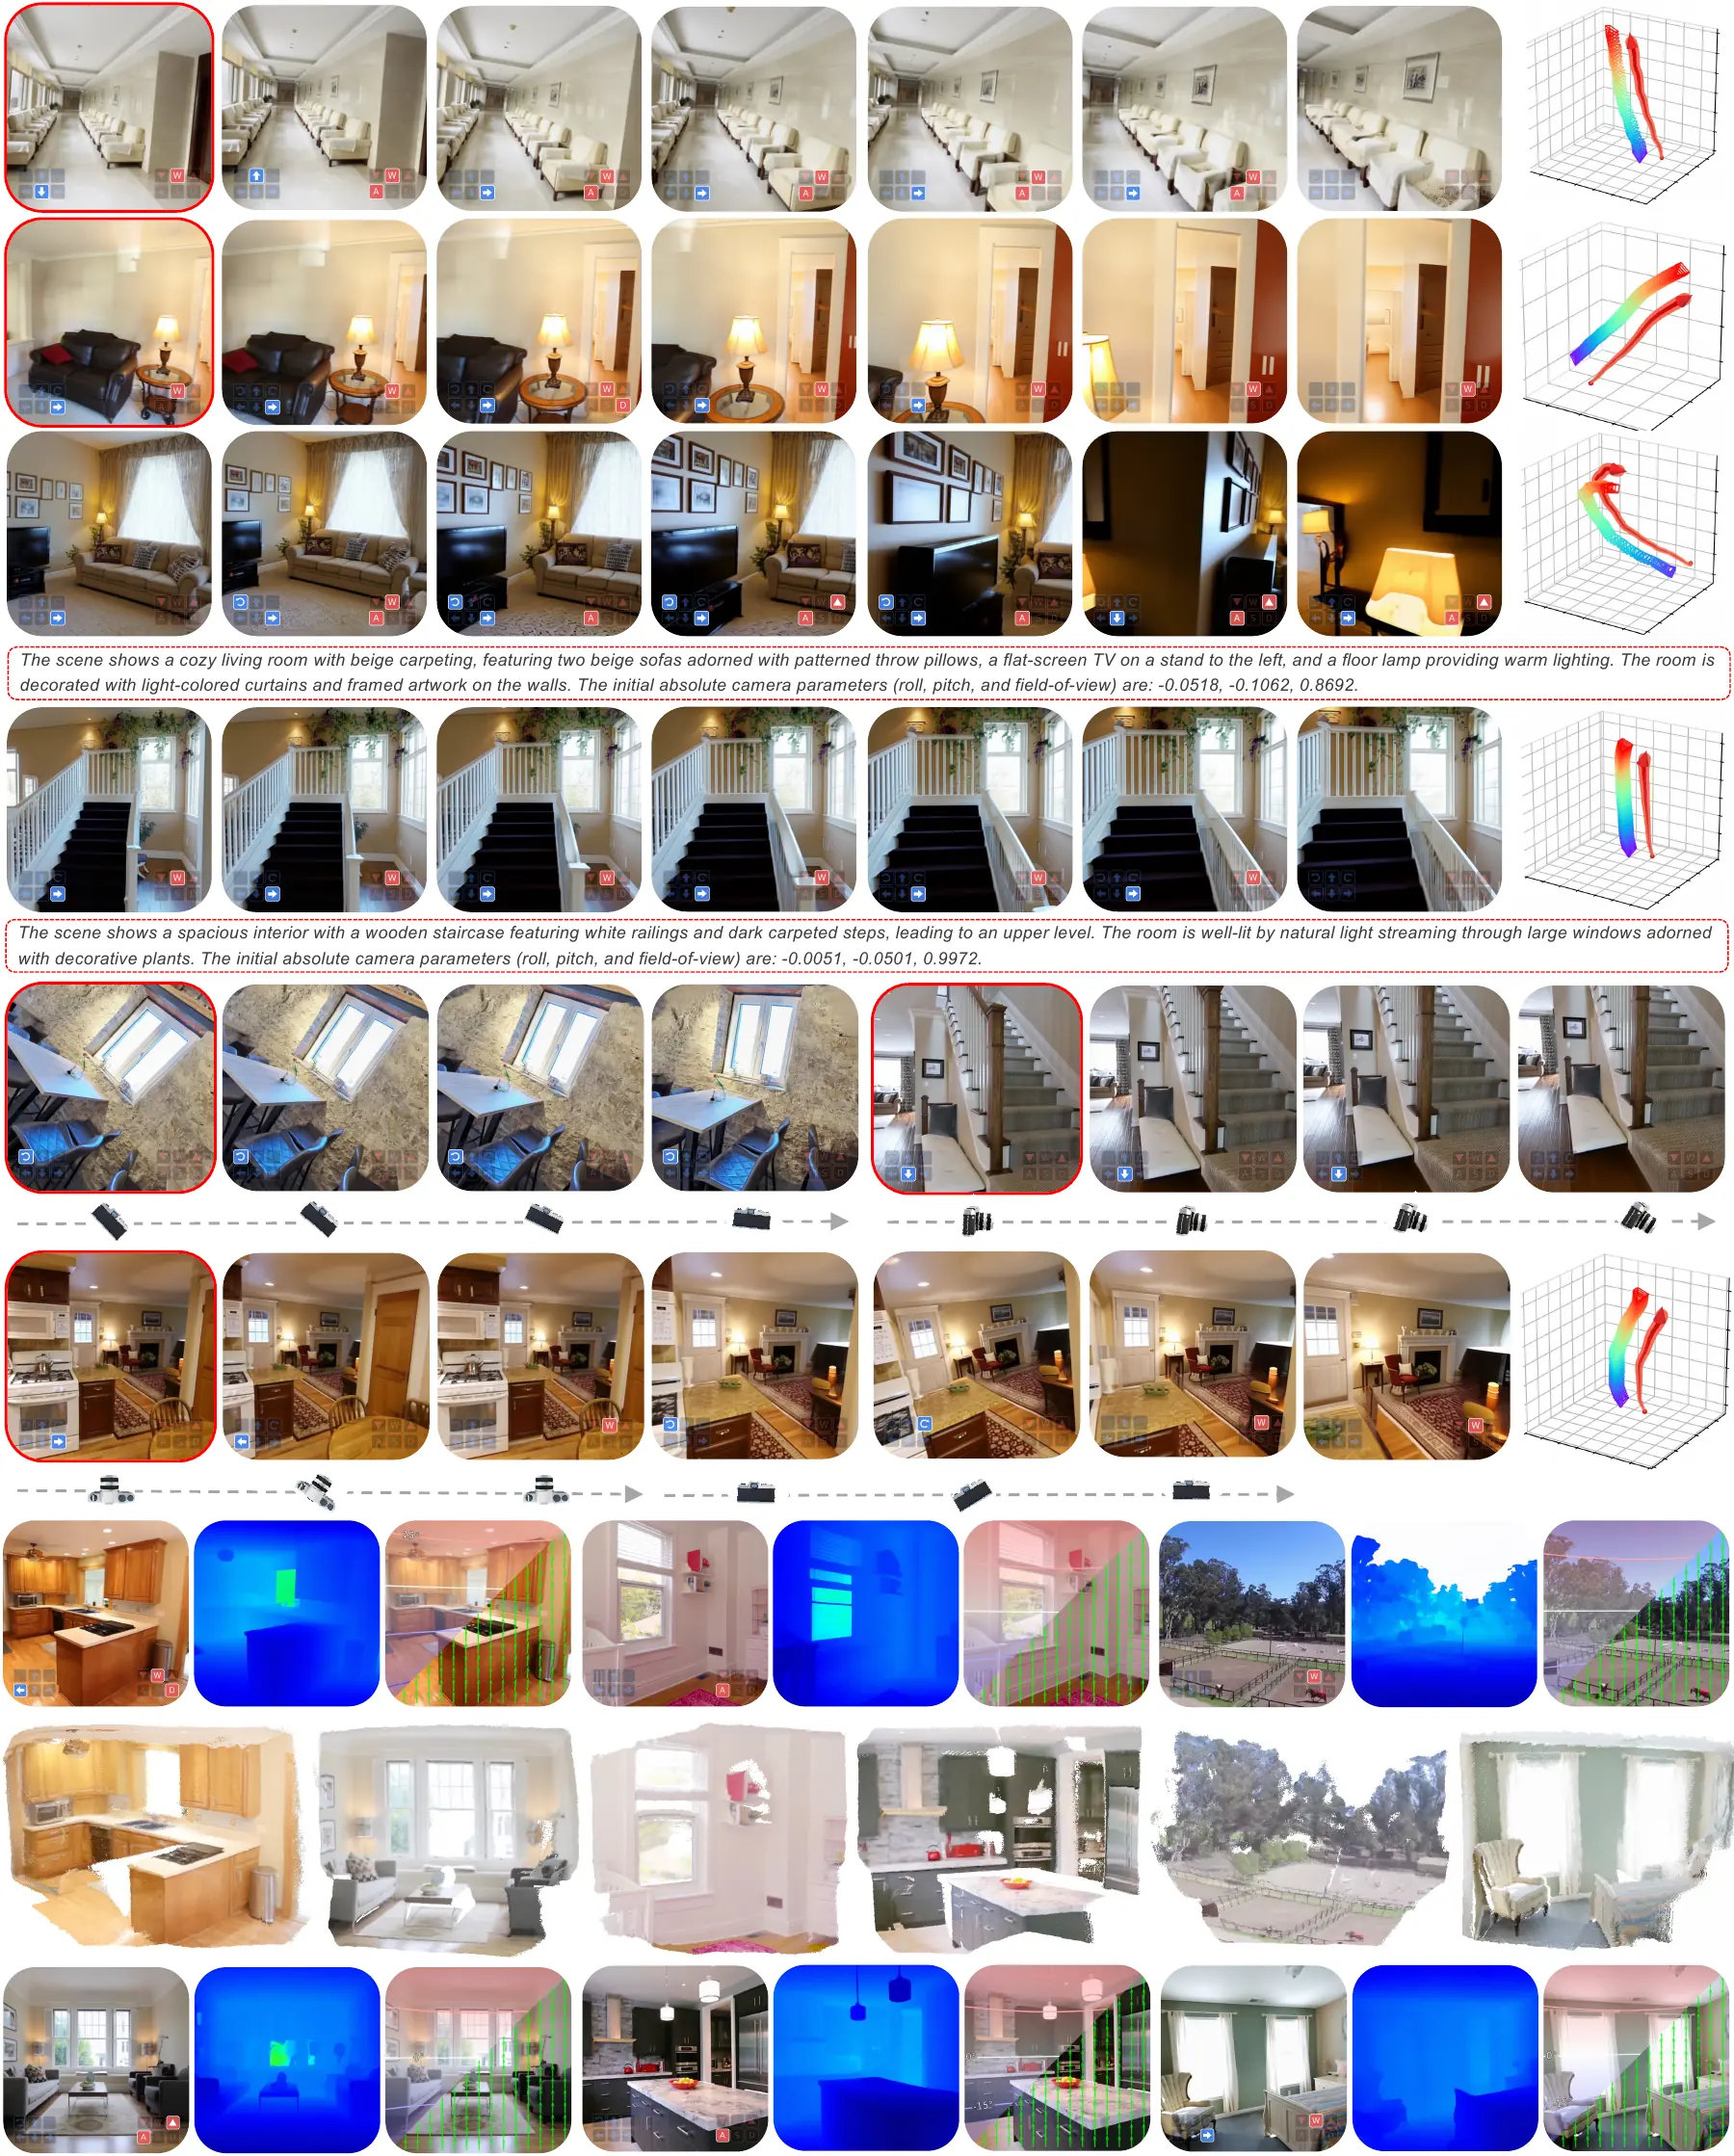
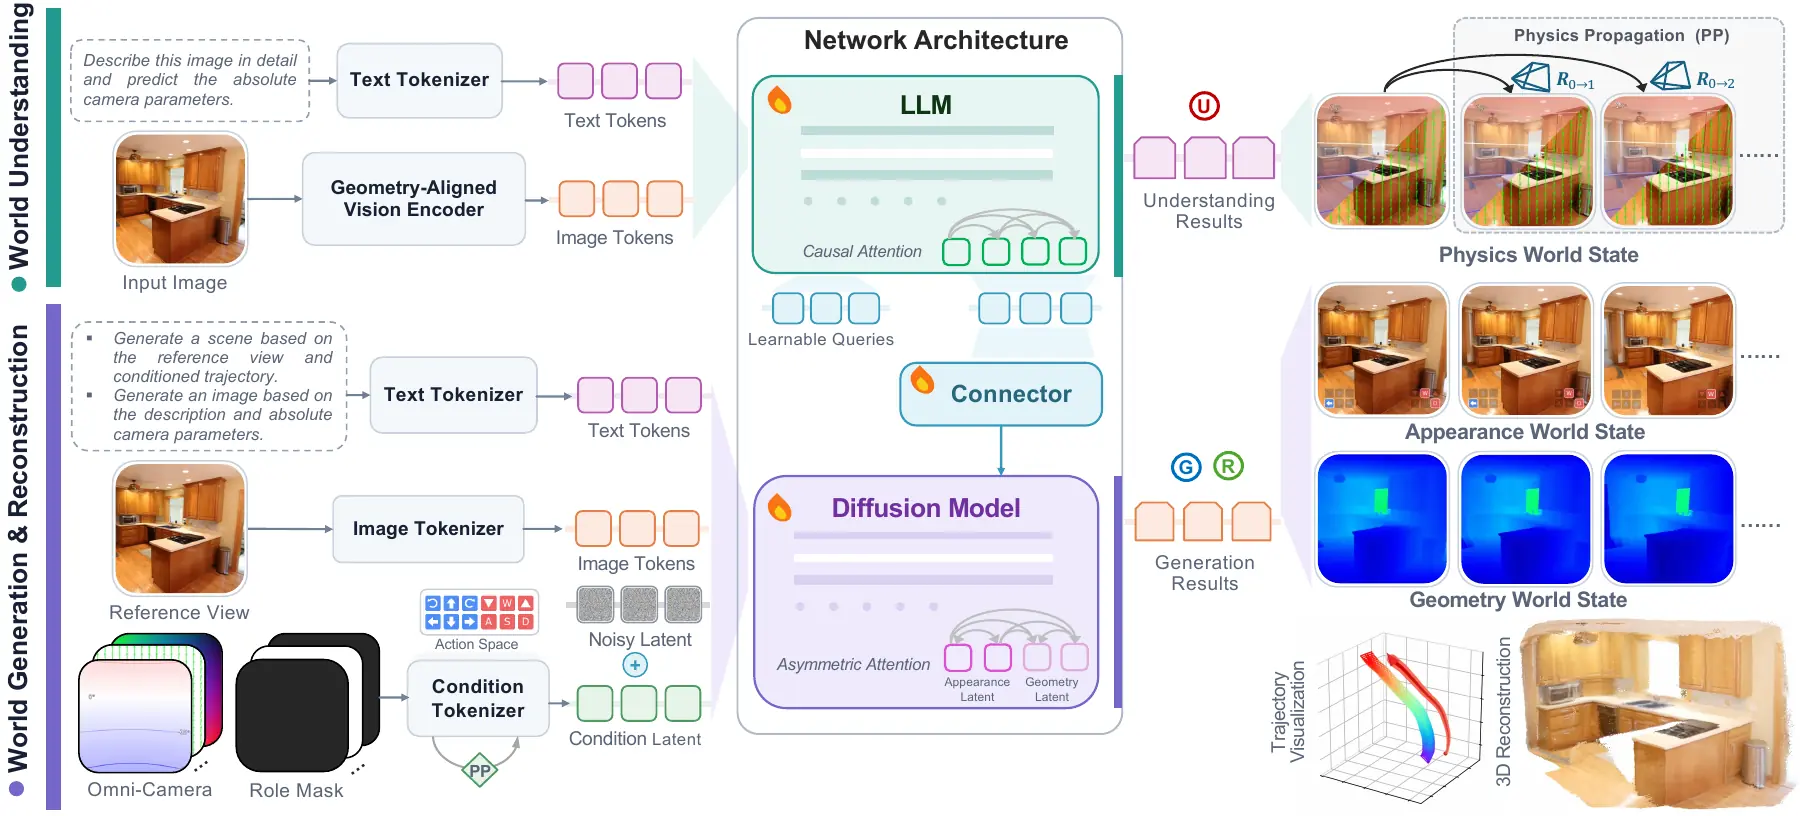
Puffin-World的核心创新在于其对“世界”的重新定义。传统方法通常将世界视为一系列RGB帧的序列,而Puffin-World则将其解构为三个相互耦合、缺一不可的原生状态。首先是物理世界状态,它通过重力场和纬度图来锚定观察与真实世界的绝对关系。重力场定义了场景中的“上”方向,确保无论相机如何旋转,生成的画面始终符合地球引力下的直觉;纬度图则编码了每个视线相对于水平面的仰角,为场景提供了全局的垂直参考系。其次是几何世界状态,以深度图的形式显式表现场景的三维空间结构。这不仅揭示了外观之下的实体布局,更为后续的多视图融合与3D重建提供了直接桥梁。最后是外观世界状态,即我们熟悉的RGB图像和视频序列,但它不再是孤立生成的产物,而是在物理与几何条件的共同约束下被联合生成,从而保证了视觉内容与底层世界状态的高度一致性。
要实现这三个状态的无缝协同,关键在于一个强大而灵活的相机表示法。Puffin-World提出的Omni-Camera正是为此而生。传统的相机表示法往往顾此失彼:相对表示(如位姿增量)擅长描述连续运动,却缺乏全局物理锚点;绝对表示(如经纬度)虽能定义重力方向,却难以从单目图像中获取,且不利于跨视图过渡。Omni-Camera巧妙地将两者融合,在每个像素位置上拼接了一个9维的密集条件向量。其中,3维的绝对分量包含一个二维的“上”向量和一个纬度角,用于物理锚定;6维的相对分量则包含射线的原点和方向,用于描述连续运动。这种设计使得单一模型能够同时胜任多种任务:从单张图像推断其在物理世界中的绝对朝向(相机到世界理解),根据文本提示和指定的物理相机参数生成新视图(相机可控文生图),以及基于一张参考图生成符合复杂轨迹的多视角图像序列。
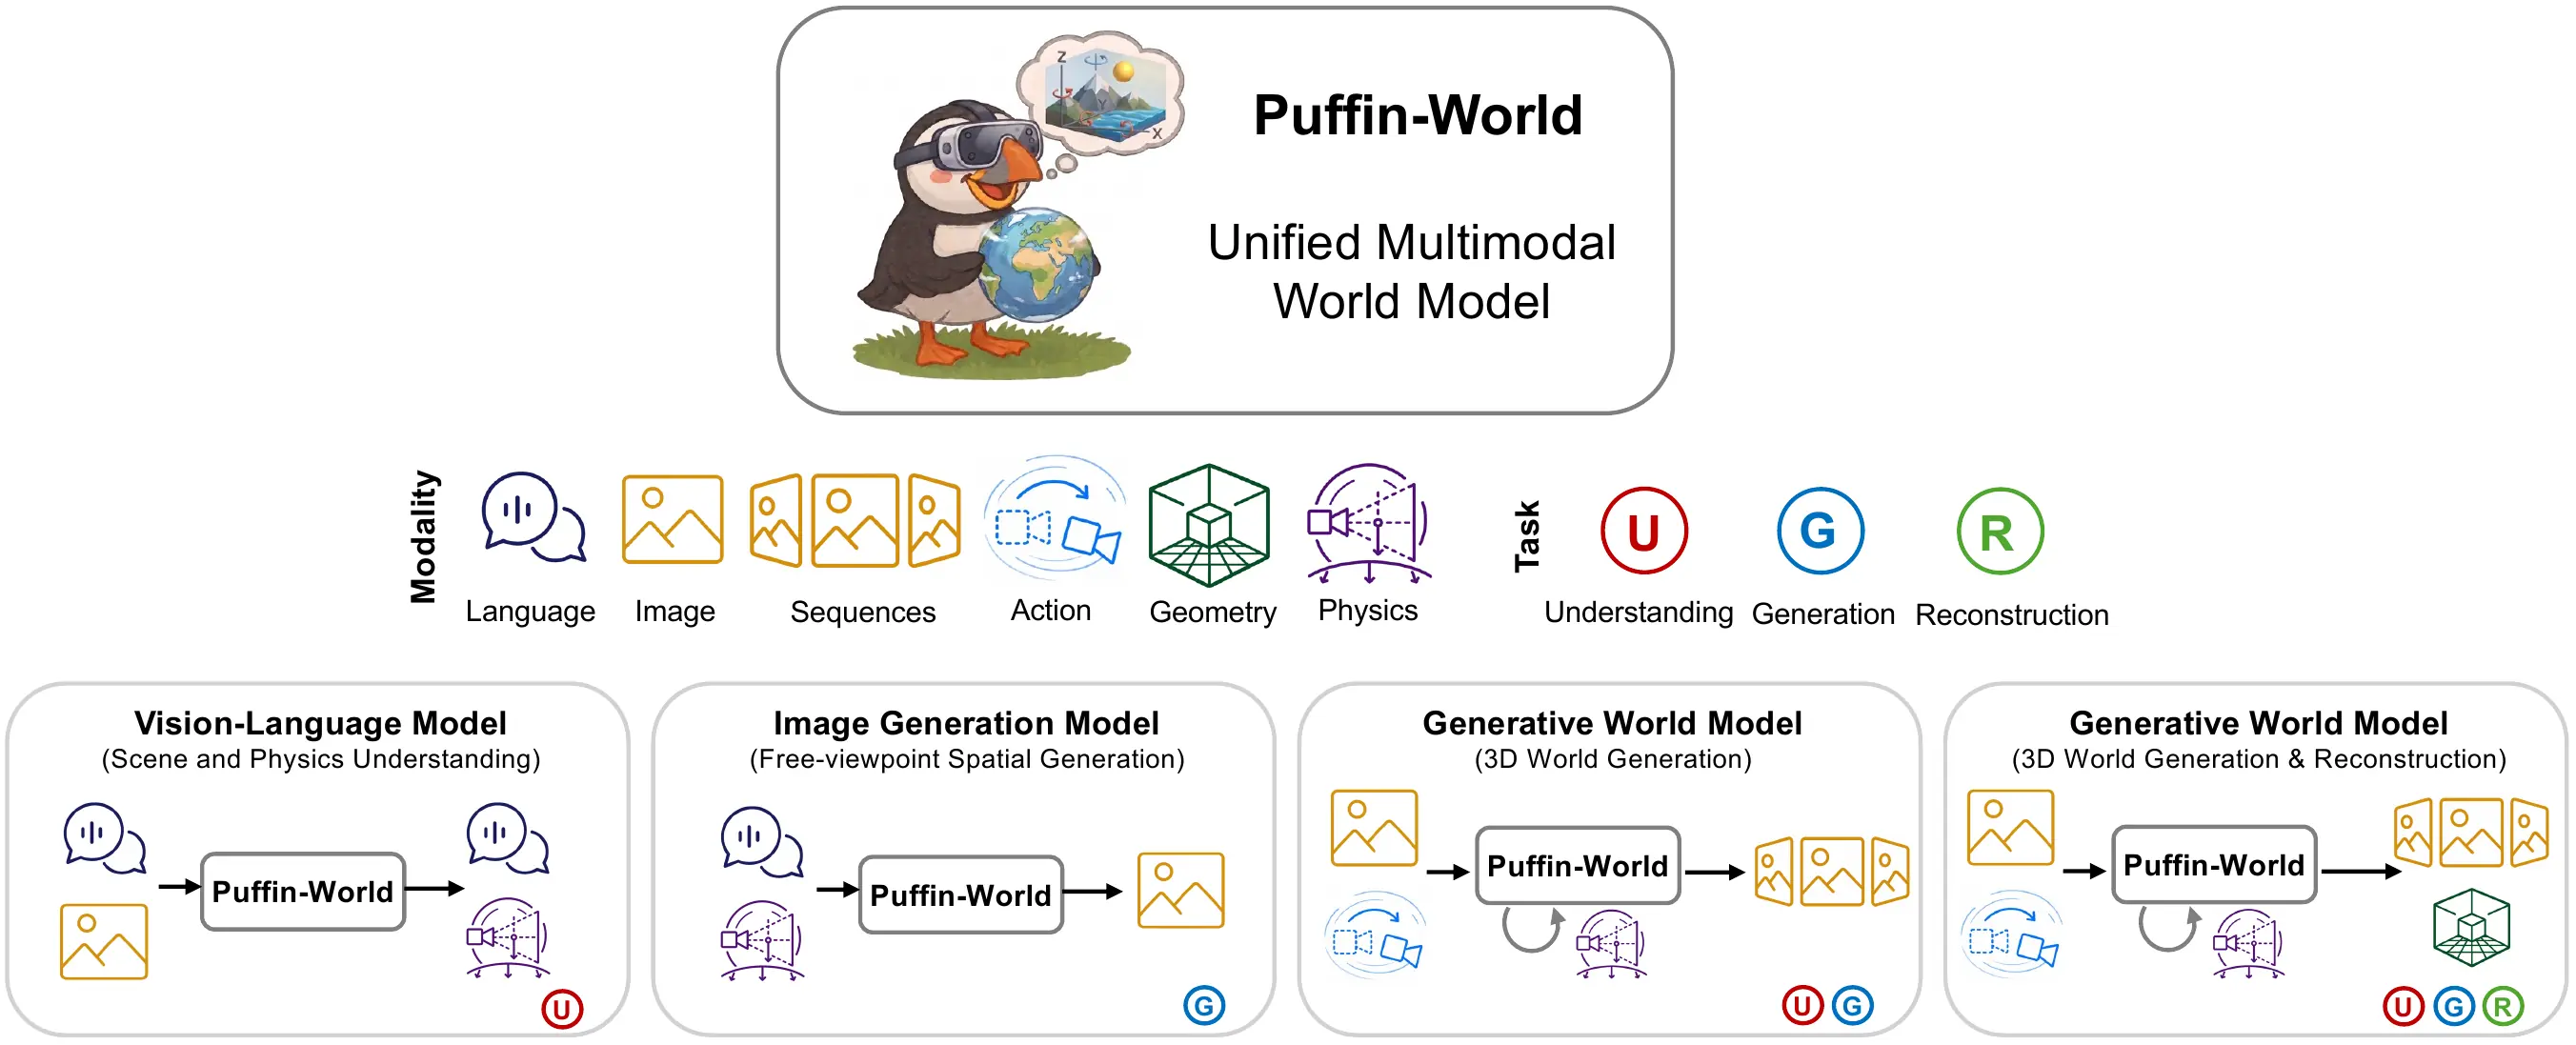
Puffin-World的统一性体现在三个层面。在表示层面,RGB图像和深度图共享同一个变分自编码器(VAE)的潜在空间,确保了外观与几何在特征层面的对齐;Omni-Camera则统一了绝对相机、相对运动、旋转和平移等多种相机操作;一个紧凑的角色掩码(role mask)则清晰标识了输入中的参考视图、目标视图、图像条件和几何视图等不同角色。在模态层面,一个经过几何对齐的视觉编码器与一个大型语言模型(LLM)协同工作,产生自回归的理解输出;这些语言模型的隐藏状态再通过可学习的查询和一个轻量级连接器,转化为扩散生成器的条件信号。这意味着理解与生成不再是割裂的流水线,而是同一模型的互补输出。在任务层面,模型的功能完全由输入组合决定——提供文本和目标相机,即可进行自由视点模拟;提供参考图像和轨迹,则可进行3D世界生成;若同时提供图像、文本和相机,则能完成联合的外观-几何重建。这种高度的灵活性使得Puffin-World成为一个真正的通用3D世界引擎。
物理知识的感知与传播是Puffin-World区别于其他模型的关键。给定一张图像,模型首先通过自回归序列建模的方式,推理出整体的场景线索(如地平线、垂直结构、前景构成等),进而预测出绝对的相机参数,包括滚转角(roll)、俯仰角(pitch)和垂直视场角(vertical FoV)。然而,仅靠初始感知不足以支撑长轨迹生成。Puffin-World引入了物理传播机制:将从参考视图中感知到的重力方向g₀,通过已知的相对旋转矩阵Rᵣₑₗ(t←0),传递到轨迹中的每一个未来视图t,得到该视图的绝对重力方向gₜ。这个过程确保了整个生成的轨迹都锚定在一个连贯的物理世界坐标系中。简而言之,相对运动告诉模型“相机怎么动”,而物理传播则告诉模型“新相机在真实世界中朝向何方”。
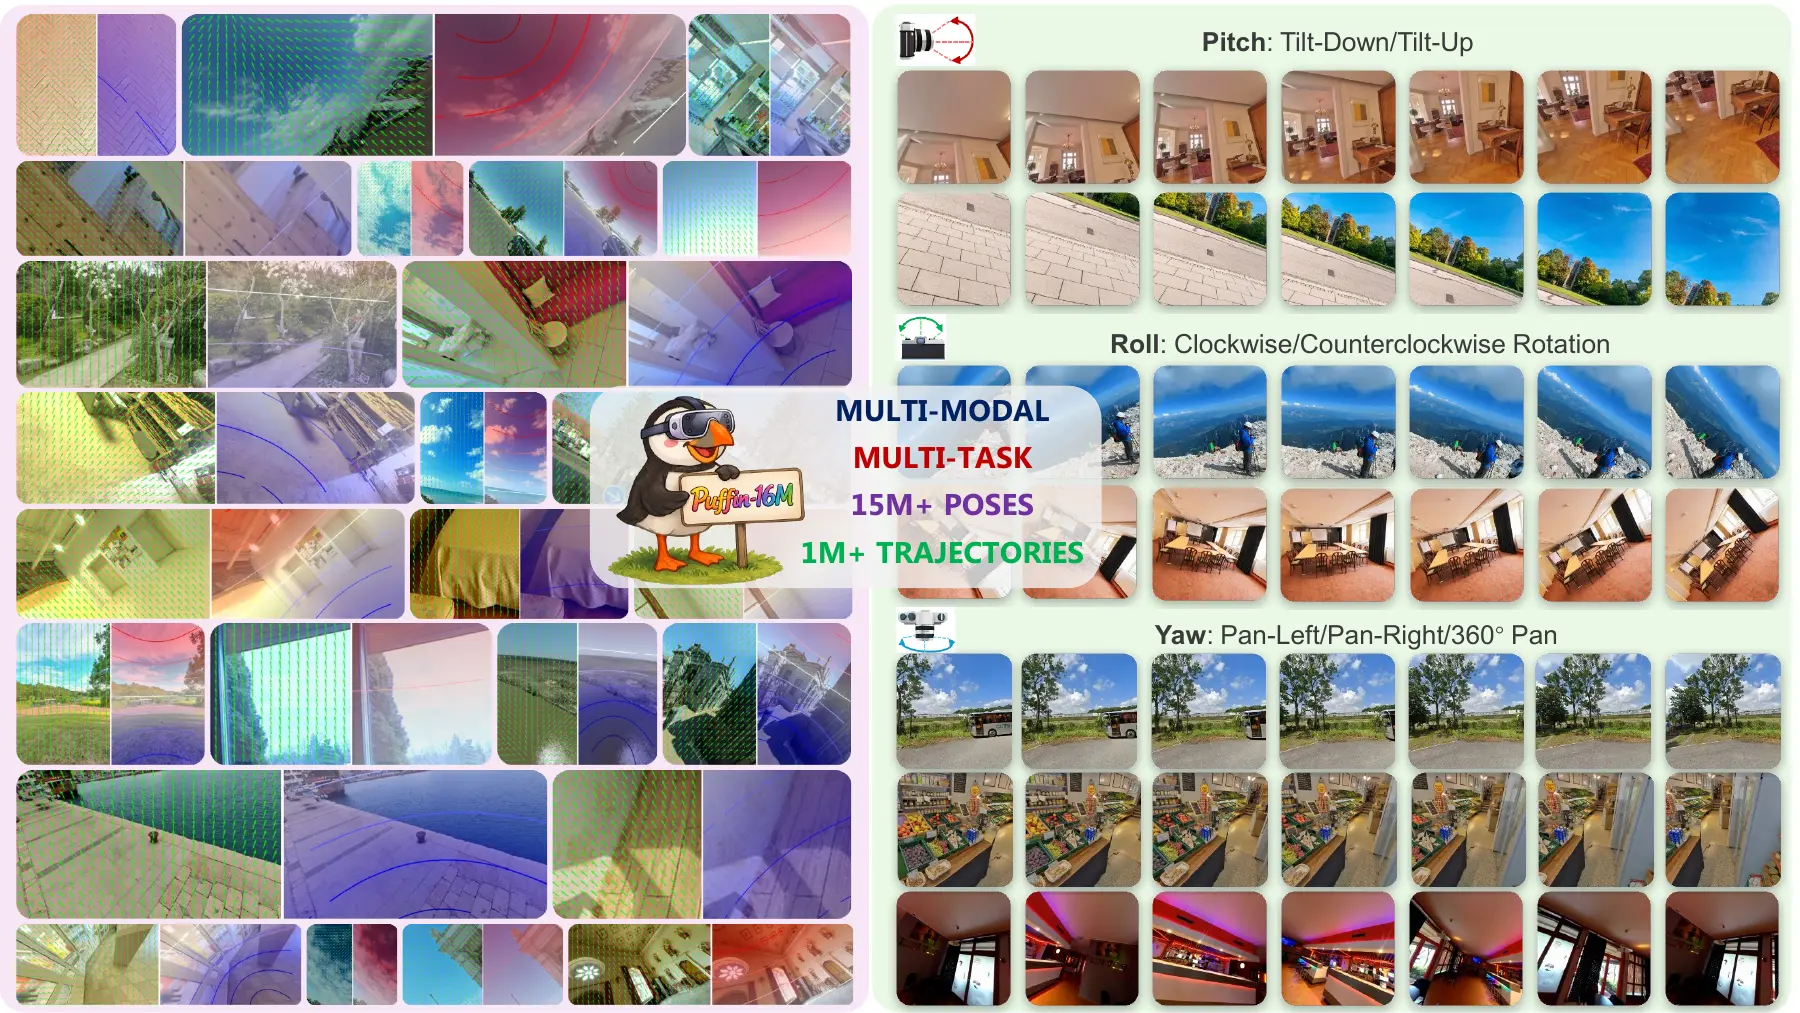
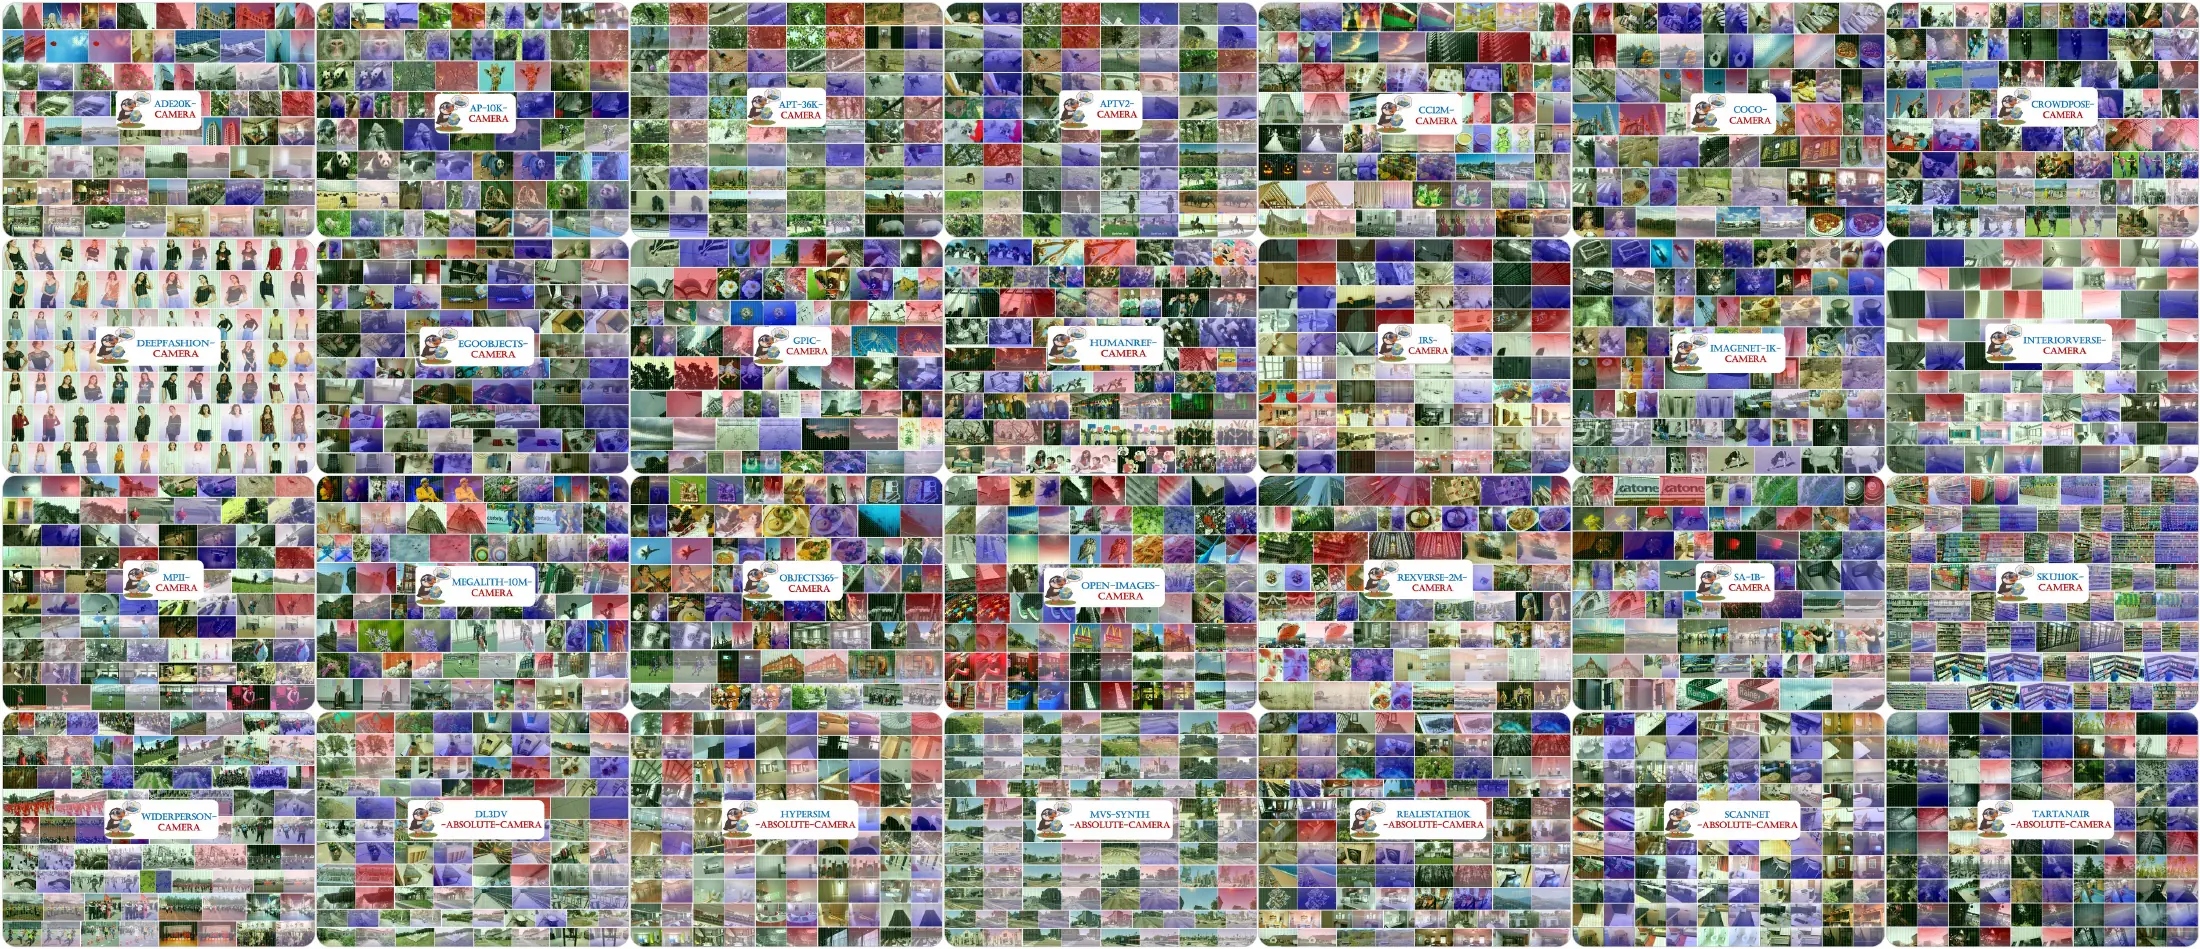
任何强大的模型都离不开高质量、大规模的数据支撑。现有公开的相机和3D数据集普遍存在严重的视角偏差:相机大多保持水平,俯仰角变化微小,运动以平移为主。这种数据分布无法训练出能应对任意探索视角的智能体。为此,研究团队构建了Puffin-16M数据集,包含两个互补子集。Puffin-Cam-15M由90万张源全景图渲染出1500万个视觉-语言-相机三元组,覆盖了从-45°到45°的滚转/俯仰角、20°到105°的垂直视场角以及多样化的宽高比,其标注文本不仅描述场景语义,还包含结构化的空间与物理推理。Puffin-Traj-1M则包含100万条连续轨迹,模拟了抬头/低头、顺时针/逆时针旋转以及完整的360°探索,同样覆盖了广泛的姿态范围。更重要的是,团队利用Puffin-World模型本身,为28个广泛使用的公共数据集(总计约4450万张图像)自动标注了绝对的滚转、俯仰和垂直视场角。这一举措极大地丰富了可用于训练和评估的物理感知数据,为社区研究视角偏差、构建多样化训练集以及为现有语料库注入重力感知能力提供了宝贵资源。

在实证结果方面,Puffin-World展现了全面的领先优势。在单图物理世界感知任务上,它在四个基准测试中均取得了最强的绝对相机参数估计性能,证明了其将单图理解转化为可靠物理感知的能力。模型不仅能输出标量参数,还能生成密集的透视场,直观地揭示整个场景中的重力和纬度信息。在自由视点空间模拟方面,Puffin-World能够精确响应文本提示和显式的相机规格,生成符合要求的视图,并在大视角变化下依然保持场景身份和视觉连贯性。最引人注目的是其3D世界生成与重建能力。无论是从文本还是从图像出发,模型都能生成沿长轨迹、经历极端旋转的多视角图像及其对应的深度图,并能直接将这些结果融合成一致的3D场景。可视化结果清晰地展示了对齐的外观、几何和物理状态如何共同构建出一个可信的虚拟世界。
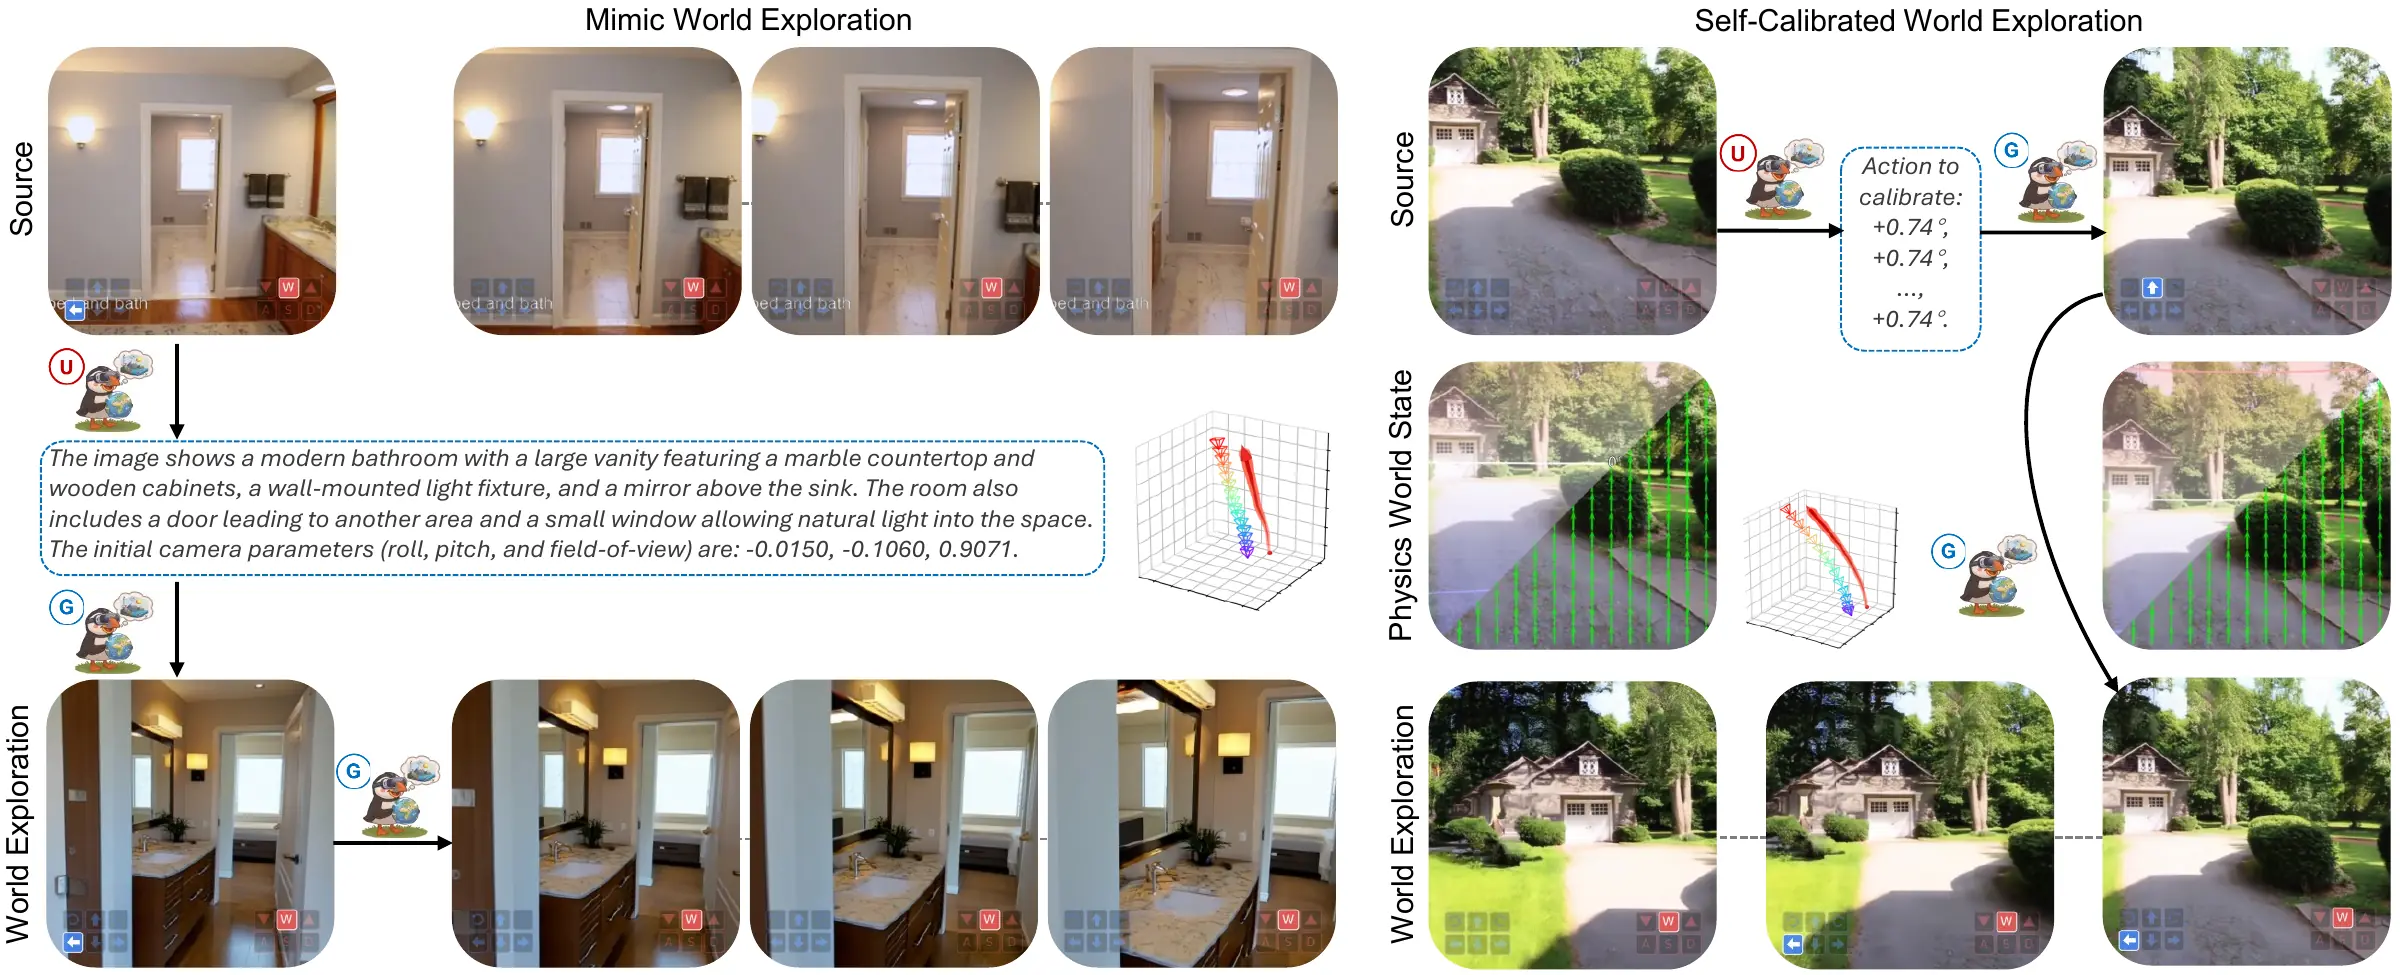
Puffin-World的真正潜力在于其多任务协同所催生的闭环行为。例如,“模仿世界探索”任务要求模型从一个共享的初始视点出发,遵循相同的预设相机轨迹,去扩展出不同的3D世界。这要求模型必须先准确理解初始视图的物理状态,再在此基础上进行一致的多视图生成。另一个例子是“自校准世界探索”:当输入是一个重力方向错位的观察时,模型能先推理出当前的物理状态,预测一个校正性的相机动作(如旋转),并想象出执行该动作后的目标观察。整个过程——感知、决策、生成——都在同一个模型内部完成,无需任何外部校准器或专用生成器。这种早期的闭环行为为交互式3D环境、虚拟现实、具身智能乃至更宏大的“世界-动作模型”(World-Action Models)奠定了坚实的基础。

总而言之,Puffin-World代表了世界模型发展的一个重要方向:从生成“看起来像”的像素,转向理解和构建“在物理上成立”的世界。通过将物理规律和几何结构作为原生状态显式建模,并借助Omni-Camera和Puffin-16M等创新工具实现规模化训练,该框架成功地将多模态统一从2D语义层面推进到了物理锚定的3D世界层面。尽管当前版本主要聚焦于静态场景,但其核心思想——即通过共享的物理和几何表示来连接感知、推理与生成——无疑为未来构建能真正感知、构建并与动态世界互动的智能体指明了一条切实可行的道路。