内化视觉思考:主动视频推理中的高效未来建模新范式
近年来,随着具身智能和人机交互系统的快速发展,智能体对环境的理解已不再局限于“此刻发生了什么”,而是迫切需要回答“接下来会发生什么”。这种能力被称为主动视频推理(Proactive Video Reasoning),其核心挑战在于:如何在事件尚未完成甚至尚未开始时,基于有限的视觉线索做出准确预测。这一需求广泛存在于服务机器人、自动驾驶、智能监控和AR/VR交互等场景中。

传统的监督微调(Supervised Fine-Tuning, SFT)方法通常仅要求模型根据当前视频片段生成文本描述或答案,缺乏对未来动态的显式建模。为弥补这一缺陷,研究者提出了视觉思维链(Visual Chain-of-Thought, Visual CoT)——先让模型生成一张“想象中的未来画面”,再基于该图像进行后续推理。这种方法在理论上具有直观优势:未来图像能直接编码物体位置、运动轨迹、交互关系和状态演变,为推理提供丰富上下文。
然而,实践表明,Visual CoT存在显著瓶颈。首先,生成高保真未来帧需要大量计算资源,导致推理延迟急剧上升。在Apple团队的实验中,Visual CoT的平均推理时间高达6.56秒,而纯文本SFT仅需约1.2秒。其次,生成的未来图像往往包含偏差或失真,这些误差会进一步污染后续的语言推理过程,反而降低整体性能。更关键的是,在许多实时应用场景中,即使预测最终正确,若响应滞后于事件发生,其实际价值也将大打折扣。
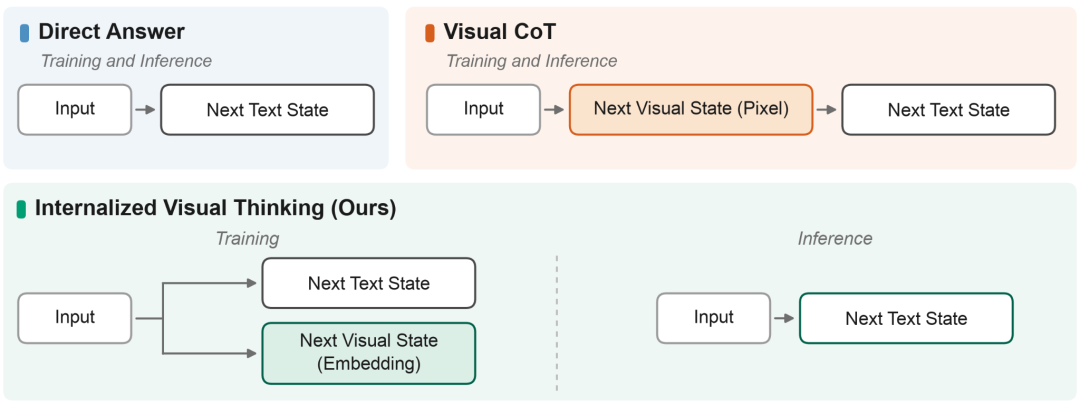
为破解这一困局,Apple研究团队提出了一种名为内化视觉思考(Internalized Visual Thinking, IVT)的新范式。其核心思想极为简洁却深刻:在训练阶段学习预测未来,但在推理阶段不再生成未来。换言之,IVT将“对未来世界的理解”内化为模型内部表征的一部分,而非依赖显式的中间图像生成。
具体而言,IVT在标准SFT的基础上增加了一个未来嵌入预测(Next-Embedding Prediction)任务。给定一段当前观测视频,模型不仅要输出正确的文本答案,还需同时预测未来视频帧在隐空间中的向量表示(latent embedding)。这一设计巧妙地绕过了像素级图像生成的高成本,转而利用紧凑的语义或结构化表征来传递未来信息。训练过程中,模型被迫从当前输入中提取运动趋势、物体状态变化、人-物交互意图等动态特征,并将这些信息融合进最终用于回答问题的内部表示中。
值得注意的是,IVT并非简单地将两个任务并行训练。研究发现,联合优化(joint optimization)至关重要。若采用两阶段策略——先单独训练未来预测分支,再进行语言微调——效果反而不如端到端联合训练。这说明,未来预测信号必须持续参与塑造模型的推理路径,而非仅作为辅助正则项。此外,数据混合比例也影响最终性能:保持未来预测任务在整个训练周期中的足够权重,有助于模型更深入地内化动态建模能力。
那么,应选择何种类型的未来表征?论文系统比较了多种视觉编码器,包括Flux-VAE、DINOv2和SigLIP2。结果显示,Flux-VAE表现最佳。尽管DINOv2等模型在语义理解上更强,但VAE保留了更多细粒度的空间结构、局部外观和短期动态信息,这些恰恰是预测近未来动作演化的关键。例如,在厨房操作场景中,锅中液体的晃动幅度、手部接近物体的速度、工具的姿态微调等细节,虽未必构成高层语义概念,却对判断“下一步是否会翻炒”或“是否即将关火”具有决定性作用。
另一个关键发现是:预测的时间跨度不宜过长。IVT在短期未来(如1-2秒后)预测任务中效果显著,但在更远期(如hop=3)的anticipation任务中收益有限。这是因为随着预测窗口扩大,未来的不确定性呈指数级增长——同一初始状态可能导向多个合理结果。此时,仅依赖视觉动态已不足以支撑准确预测,还需引入目标意图、长期上下文和程序性知识(procedural knowledge)。而当前IVT框架主要聚焦于视觉驱动的短期演化,尚未整合更高层的认知机制。
在三大主流视频理解数据集——Ego-Exo4D、Ego4D和EPIC-KITCHENS-100上的实验验证了IVT的有效性。研究覆盖两类任务:Early-event Prediction(在动作未结束时识别其类别)和Next-event Prediction(在动作发生前预测其内容)。共六组实验设置中,IVT在所有指标上均优于基线SFT;与Visual CoT相比,在三个Next-event Prediction任务中全部胜出,且在四个设置中总体表现更优。更重要的是,其推理效率几乎与SFT持平——平均仅1.22秒/样本,相较Visual CoT实现超过5倍加速。
这一成果的意义远超技术优化本身。它挑战了当前Chain-of-Thought范式的一个隐含假设:有效的中间推理必须显式呈现。无论是文本CoT生成推理步骤,还是Visual CoT绘制未来图像,主流做法都倾向于将“思考过程”外化为可观测的token或像素。IVT则证明,某些中间状态的价值在于其对模型内部表示的塑造作用,而非作为推理链的必经节点。这种“训练时思考、推理时直答”的模式,为资源受限的边缘设备和实时系统提供了新思路。
当然,IVT并非万能解。其局限性同样值得深思。首先,它依赖高质量的未来帧标注,这在真实世界数据中往往稀缺。其次,单一未来预测目标难以应对多模态未来(即一个输入对应多个合理结果)的场景。当前评估仍基于单参考答案和ROUGE-L等文本相似度指标,可能低估模型在开放预测任务中的潜力。未来工作可探索概率性未来表征、不确定性建模,或结合语言先验引导多分支预测。
此外,IVT开启了一个新的设计空间:是否可以在推理阶段有条件地激活轻量级未来建模?例如,对高置信度样本直接输出答案,仅在模型不确定时触发压缩的latent rollout(隐空间推演),而非完整图像生成。这种自适应策略有望在计算开销与预测精度之间取得更优平衡。
从更宏观视角看,IVT反映了AI系统设计哲学的一次微妙转向——从“模仿人类外显思维”走向“构建高效内隐认知”。人类在快速反应时往往并不“看见”未来画面,而是依靠内化的经验直觉做出判断。IVT正是试图赋予机器类似的“直觉”:通过训练阶段的深度模拟,将复杂的世界动态压缩为高效的内部表征,从而在关键时刻实现快速、准确的决策。
随着多模态大模型向具身化、实时化演进,如何在有限算力下实现前瞻性推理,将成为核心挑战。IVT提供了一条可行路径:不必执着于生成完美的未来图像,而是让模型学会“理解”未来如何从现在演化而来。这种内化而非外显的思考方式,或许正是通向真正高效智能体的关键一步。