API密钥泄露损失上万?AI开发者必知的7大安全防护策略
在人工智能技术快速渗透各行各业的今天,开发者借助各类AI平台(如OpenAI、DeepSeek、Dify、Coze等)构建智能应用已成为常态。然而,便利背后潜藏巨大风险——一旦API密钥意外泄露,攻击者可在数小时内耗尽你的信用额度,产生数千甚至数万元的账单。更严重的是,若数据库连接信息或支付密钥暴露,可能导致用户隐私大规模泄露或直接经济损失。这类事件并非危言耸听,而是频繁发生在缺乏安全意识的开发团队中。
敏感数据的本质:为何不能出现在前端
理解安全防护的第一步,是明确“敏感数据”的边界。在AI开发语境下,敏感数据主要包括四类:
- API密钥:用于调用AI模型、云服务或第三方接口的凭证;
- 数据库连接信息:包含URL、用户名、密码,可直接访问核心数据存储;
- 支付相关密钥:如Stripe、支付宝商户密钥,具备发起交易的能力;
- 云平台凭证:AWS、阿里云等的Access Key,可操控整个云资源。
这些数据的共同特征是:一旦被未授权方获取,即可直接造成经济损失或数据泄露。而前端环境(包括网页、小程序、浏览器插件)本质上是公开的——任何用户都能通过开发者工具查看源码、网络请求和本地存储。因此,将敏感数据置于前端,无异于将保险柜钥匙挂在门外。
策略一:环境变量——敏感配置的“保险箱”
环境变量是现代应用架构中管理配置的标准方式。其核心价值在于将代码与配置分离,使同一份代码能在不同环境中运行而无需修改。
以Node.js或Next.js项目为例,开发者应在项目根目录创建.env.local文件(该文件通常已被.gitignore排除):
OPENAI_API_KEY=sk-xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx
DATABASE_URL=postgresql://user:password@host:port/dbname
STRIPE_SECRET_KEY=sk_test_xxxxxxxxxxxxxxxxxxxxxxxx在代码中通过process.env读取:
const openai = new OpenAI({
  apiKey: process.env.OPENAI_API_KEY // 安全引用
});关键点在于:环境变量仅在服务端可用。即使攻击者获取前端代码,也无法看到实际值。此外,部署到Vercel、Render等平台时,必须在控制台手动配置同名环境变量,确保生产环境安全。
策略二:严格区分前后端可访问变量
以Next.js为例,框架提供了NEXT_PUBLIC_前缀机制来显式声明哪些变量可暴露给前端。例如:
NEXT_PUBLIC_API_BASE_URL=https://api.example.com
SECRET_OPENAI_KEY=sk-xxxxxxxx前端组件只能访问NEXT_PUBLIC_API_BASE_URL,而SECRET_OPENAI_KEY仅在API路由或服务端组件中可用。这种设计强制开发者思考“哪些信息真的需要传给浏览器”,避免无意中泄露敏感数据。
实践中常见错误是为图方便,将所有配置都加上NEXT_PUBLIC_前缀。这等于主动放弃安全防线。正确做法是:除非必要,绝不将任何密钥、密码或内部URL暴露给前端。
策略三:数据库行级安全(RLS)——防止“越权访问”
使用Supabase、PostgreSQL等支持行级安全的数据库时,仅靠API密钥保护远远不够。假设你的应用允许用户查看自己的订单,若未启用RLS,恶意用户只需修改请求中的用户ID,就可能看到他人数据。
启用RLS的步骤如下:
-- 1. 启用表的行级安全
ALTER TABLE orders ENABLE ROW LEVEL SECURITY;

-- 2. 创建策略:仅允许用户访问自己的订单
CREATE POLICY "User can view own orders"
ON orders FOR SELECT
USING (auth.uid() = user_id);
结合Supabase Auth,系统会自动将当前用户ID注入auth.uid()函数,确保数据隔离。即使API密钥泄露,攻击者也无法绕过这一层数据权限控制。
策略四:杜绝localStorage存储敏感信息
许多开发者习惯将JWT令牌、用户信息存入localStorage,因其简单易用。但这是高危行为——XSS(跨站脚本攻击)可轻易窃取其中内容。
例如以下代码:
// 危险!
localStorage.setItem('token', 'eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9...');
localStorage.setItem('user', JSON.stringify({ id: 123, email: 'user@example.com' }));一旦页面存在XSS漏洞(如未转义的用户输入),攻击者可通过注入脚本读取这些数据。更安全的做法是使用HttpOnly Cookie:
// Next.js API路由中设置
res.setHeader(
  'Set-Cookie',
  `token=${jwt}; HttpOnly; Secure; SameSite=Strict; Path=/; Max-Age=3600`
);
HttpOnly属性确保JavaScript无法访问该Cookie,极大降低XSS窃取风险。Secure标志则强制仅通过HTTPS传输,防止中间人攻击。
策略五:为API密钥设置使用额度上限
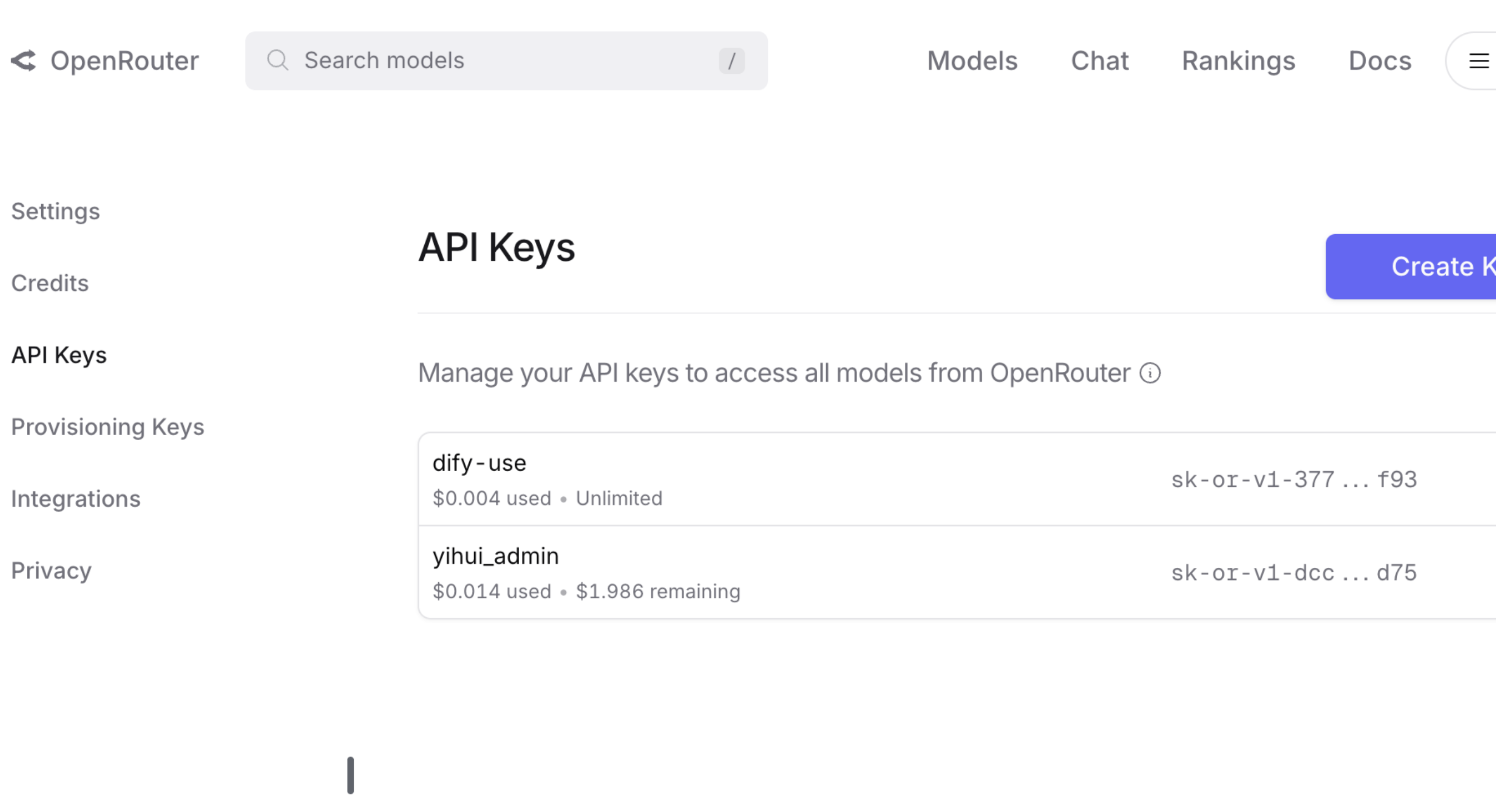
即便采取了上述措施,仍需考虑“万一泄露”的兜底方案。主流AI平台(如OpenRouter、Anthropic、Azure OpenAI)均提供API密钥额度限制功能。
以OpenRouter为例,可在密钥管理页面设置:
- 每日/每月消费上限(如$50);
- 每分钟/每小时请求次数限制;
- 允许调用的模型白名单。
这样,即使密钥泄露,攻击者的滥用行为也会在达到限额后自动停止,将损失控制在可接受范围内。建议所有生产环境密钥均启用此功能。
策略六:自动化安全检查与CI/CD集成
人为疏忽难以完全避免,因此应引入自动化工具。例如:
- 使用
git-secrets或truffleHog扫描提交历史,防止密钥误上传; - 在CI流程中加入
dotenv-linter检查.env文件格式; - 部署前运行自定义脚本验证环境变量是否齐全。
一个简单的GitHub Actions检查示例:
- name: Check for secrets in code
  run: |
    if grep -r "sk-[a-zA-Z0-9]{48}" . --exclude-dir=.git; then
      echo "ERROR: Hardcoded API key detected!"
      exit 1
    fi
此类检查能在代码合并前拦截高危操作,形成最后一道防线。
策略七:建立部署前安全检查清单
在每次上线前,团队应逐项核对以下清单:
- 所有API密钥、数据库密码均通过环境变量注入,代码中无硬编码;
-
.env、.env.local等文件已加入.gitignore,未提交至仓库; - GitHub仓库公开可见性已确认,无意外泄露;
- Supabase/PostgreSQL表已启用RLS,并配置合理策略;
- 前端未使用
localStorage存储令牌或敏感用户数据; - 所有AI平台API密钥均已设置消费额度上限;
- 生产环境部署平台(如Vercel)已正确配置环境变量。
该清单应作为发布流程的强制环节,可集成到项目文档或Jira发布模板中。
结语:安全是持续的过程,而非一次性任务
AI开发的安全防护并非复杂技术难题,而是工程习惯与风险意识的体现。从环境变量的正确使用,到数据库权限的精细控制,再到客户端存储的谨慎选择,每一环都需开发者主动思考“如果这段代码被公开,会带来什么后果”。
技术在演进,攻击手段也在升级。今天的最佳实践可能明天就需调整。因此,保持对安全动态的关注,定期审计代码与配置,才是应对未来风险的根本之道。毕竟,在AI驱动的应用生态中,安全不是成本,而是信任的基石。