Code World Model:用可执行代码构建真正持续演化的开放世界
近年来,随着扩散模型和自回归视频生成技术的飞速发展,AI已经能够根据文本、动作或交互指令生成高度逼真的连续画面。然而,一个关键问题始终悬而未决:逼真的画面是否等同于一个真正‘活着’的世界?
在传统视频世界模型中,系统的核心任务是预测“下一帧是什么”。这种范式虽然在短期视觉连贯性上表现优异,却难以处理那些发生在镜头之外、跨越数小时甚至数天的因果链条。例如,当玩家在游戏中刺杀一位领主后离开城市,理想的世界应能自动推演出权力真空引发的政治动荡、贸易路线变更、NPC关系重组等一系列连锁反应。而当玩家数周后重返该城,系统不仅要呈现一幅“看起来合理”的画面,更需准确还原这段时间内发生的逻辑演变过程。
遗憾的是,现有模型大多仅从RGB视频中学习表层模式,缺乏对底层规则、实体关系和事件历史的显式建模能力。视觉数据本身是结果而非机制——它记录了“发生了什么”,却隐藏了“为什么发生”以及“接下来会怎样”。这种信息缺失在长时间尺度下尤为致命,导致生成内容虽短期合理,长期却逻辑断裂、因果混乱。
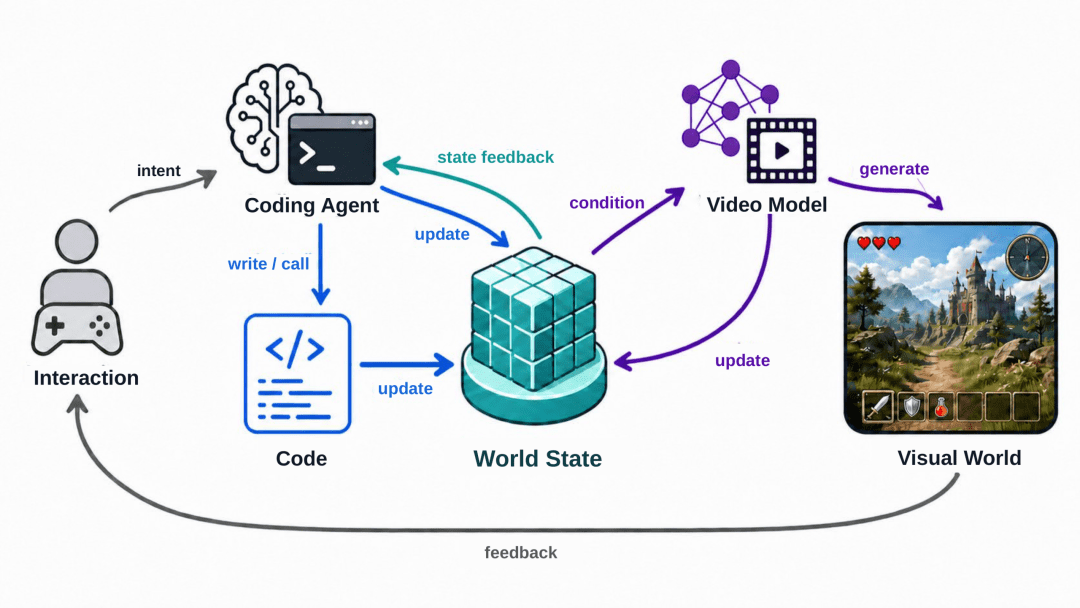
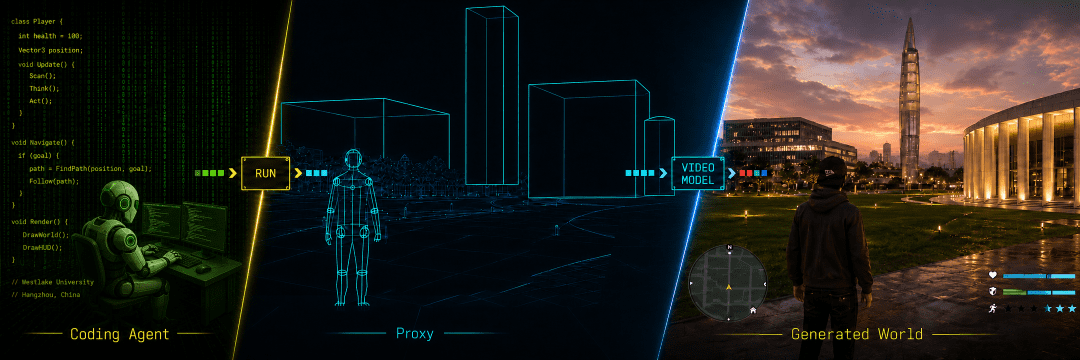
针对这一根本性挑战,西湖大学通用人工智能实验室(AGI Lab)提出了一种全新架构——Code World Model(CWM)。该模型不再依赖单一视频生成器承担全部世界建模职责,而是将系统拆解为两个互补模块:Coding Agent 负责世界逻辑的推理与演化,视频模型则专注于高保真视觉实现。这种分工不仅提升了系统的可解释性与可控性,更为构建真正持续运转的开放世界提供了可行路径。
世界演化与视觉呈现的解耦:从黑盒预测到白盒执行
Code World Model 的核心思想在于将“世界如何变化”与“世界如何被看见”分离。传统方法试图让视频模型从像素流中反推出隐藏规则,这如同要求一个人仅通过观看电影片段来重建整个剧本、角色动机和物理定律——效率低下且极易出错。
CWM 则引入 Coding Agent 作为“世界大脑”。它接收当前世界状态(包括实体属性、关系网络、事件日志、规则库等),结合新的用户交互或环境事件,决定哪些机制需要激活、修改或组合。更重要的是,Agent 并非仅输出状态快照,而是生成或调用可执行代码来驱动世界演化。这些代码可以是预定义的游戏逻辑模板,也可以是Agent根据情境动态编写的脚本片段。
例如,当玩家在魔法学院触发“召唤坐骑”动作时,Coding Agent 可能调用一段飞行生物生成函数,并修改角色移动模式、碰撞检测规则及环境光照参数。这段代码随后在后台持续运行,即使玩家切换场景,坐骑仍会在原地徘徊、消耗体力或与其他NPC互动。规则不再是静态设定,而是可被Agent动态修改并持续生效的活系统。
与此同时,视频模型的角色被重新定义:它不再负责推理因果,而是作为一个高保真渲染器,将由代码维护的世界状态转化为视觉观察。这种解耦使得高层推理(低频、复杂)与底层执行(高频、确定)各司其职,显著提升了系统的效率与可复现性。
Proxy:连接逻辑世界与视觉空间的可编程桥梁
然而,如何将结构化的世界状态高效传递给视频模型?直接使用文本描述(如“角色A在(10,5)位置面向北”)虽语义清晰,但难以精确控制逐帧的空间关系、遮挡和相机运动。而构建完整3D场景又过于昂贵且限制创意自由。
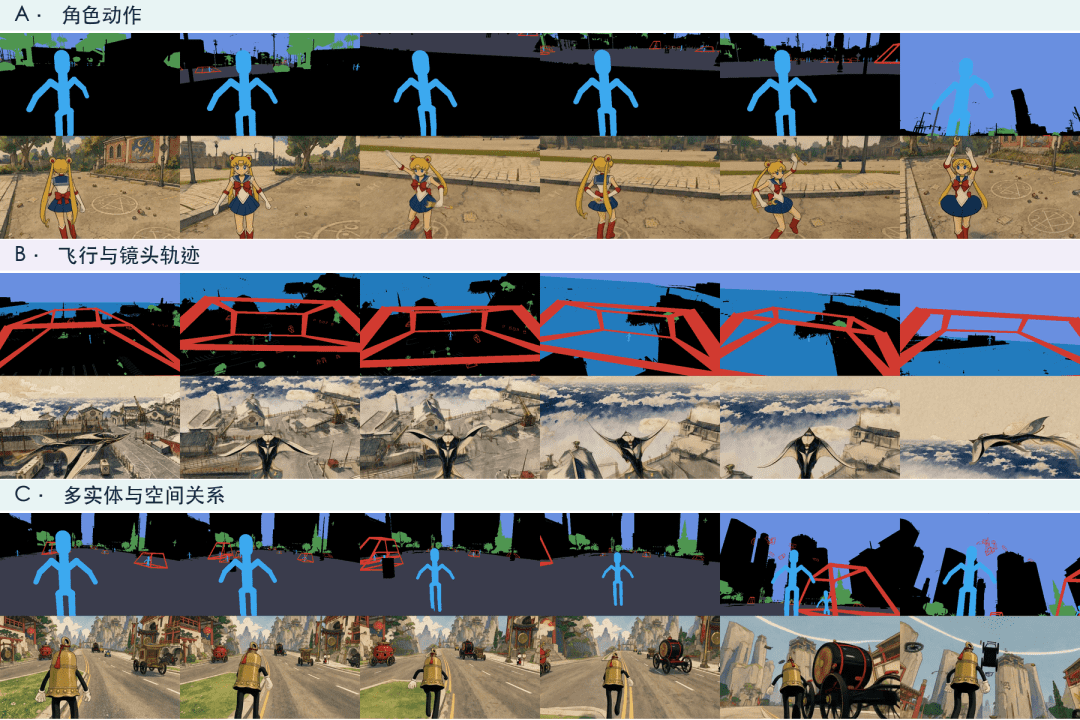
为此,研究团队设计了 Proxy ——一种由世界状态确定性编译而成的粗粒度视觉条件。Proxy 不追求美观,仅保留当前观察必须遵守的最小几何与运动约束,例如:
- 实体中心位置与包围盒尺度
- 关键姿态(如人形骨架的关节点)
- 相机轨迹与视角参数
- 遮挡关系与空间层级
- 运动方向与速度向量
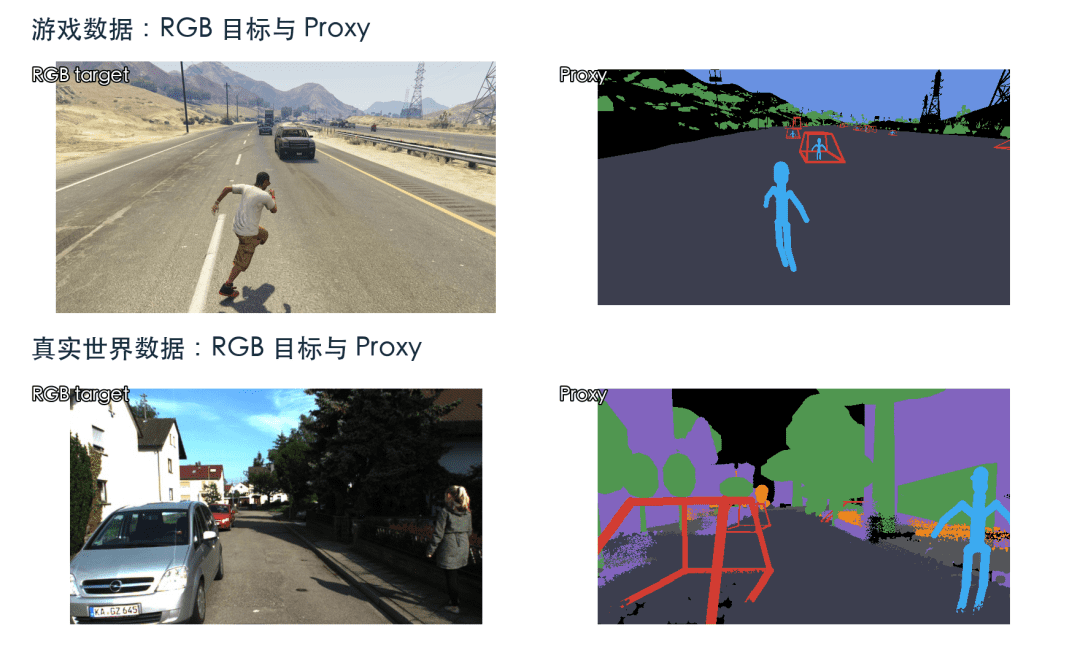
这些信息以低分辨率(通常为目标视频的1/4)的图像形式呈现,包含深度图、语义ID图和运动场。Proxy 的优势在于:它既比纯文本更具空间精度,又比完整3D资产更轻量灵活。更重要的是,所有Proxy元素均可追溯至Coding Agent维护的世界状态,确保整个“状态→条件→视觉”通路是可检查、可寻址、可局部修改的白盒系统。
实验表明,Proxy 在提供足够约束的同时,额外计算开销有限。在1344×768分辨率的视频生成中,Proxy仅需336×192的token空间,约为原始视觉token的1/16,使得训练与推理成本可控。
数据构建:游戏与真实世界的统一接口
要训练视频模型理解Proxy,必须获得严格对齐的RGB-Proxy数据对。研究团队巧妙利用游戏引擎的天然优势:在运行《GTA V》时,同步记录RGB画面与底层状态数据(如实体坐标、相机参数、碰撞信息)。这些状态数据可被反复编译为不同粒度的Proxy,无需重新采集视频,极大提升了数据利用效率。
更值得关注的是,该框架也为真实世界视频预留了入口。在KITTI-360数据集上的验证显示,通过离线进行相机位姿校准、3D语义重建和物体标注,同样可生成Proxy。视频模型接收到的仍是标准的RGB+Proxy+文本三元组,无需额外定义动作标签或物理模型。这意味着,同一套架构可同时处理合成数据与真实数据,为未来跨域世界建模奠定基础。
原型系统基于约5.6小时的GTA V游戏视频(9,420个5秒片段)进行训练,采用LoRA微调MiniMax-H3 Ref2VA视频模型。推理阶段,GPT-5.6 Sol作为Coding Agent,结合游戏引擎代码模板动态生成世界演化脚本;GPT Image 2则依据首帧Proxy和文本提示生成外观锚点,确保角色身份与风格一致性。
长时序生成与动态世界修改:迈向真正的开放性
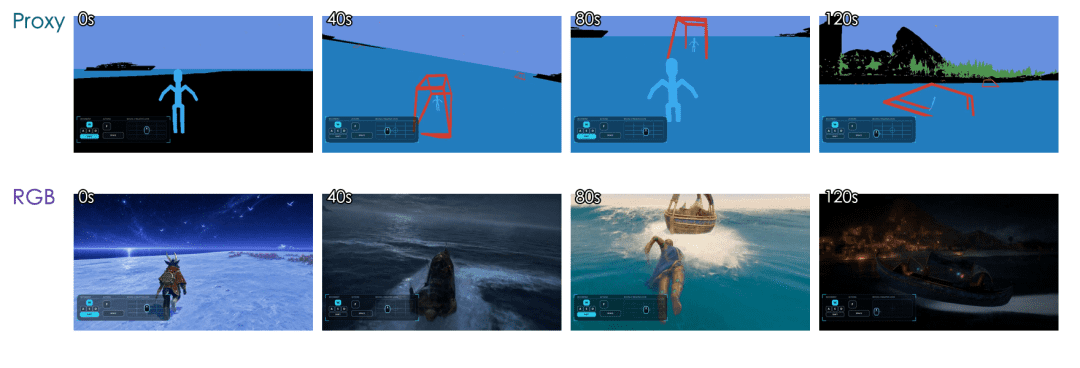
在长序列生成方面,CWM采用滑动窗口策略:每124帧为一窗口,重叠34帧以保证局部连续性,同时复用首帧外观锚点维持全局身份。由于Proxy贯穿整个时间轴,即使视觉风格周期性切换(如昼夜交替、天气变化),实体轨迹、相机运动和空间关系仍由持续演化的世界状态保障。
项目演示中,角色可在海底港口召唤飞行坐骑,在姜饼村落切换骑乘模式,或在雪夜山村触发新的社交互动。这些行为不仅改变当前画面,更通过代码修改了世界后续的运行逻辑。用户不再只是“观看者”,而是能真正“改变世界规则”的参与者。
范式革新:从画面生成到系统构建
Code World Model 的真正突破,不在于提升视频质量或控制精度,而在于重构了开放世界建模的基本范式。它指出:通往可持续、可推理、可交互的开放世界,不能仅靠扩大视频预测模型,而需将可执行代码重新置于世界演化的核心。
这一思路对多个领域具有深远影响:
- 游戏与虚拟世界:开发者可构建能自主演化的NPC社会,支持玩家长期干预与后果追踪;
- 具身智能训练:机器人可在具备真实物理规则与社会逻辑的环境中学习长期规划;
- 自动驾驶仿真:交通流、行人行为和突发事件可基于因果规则动态生成,而非预设脚本;
- AI叙事系统:故事世界能根据用户选择持续演化,形成真正分支且逻辑自洽的剧情网络。
尽管当前系统仍处早期阶段,依赖游戏引擎提供的结构化状态,但其核心理念——用代码承载知识,用Proxy桥接逻辑与视觉,用Agent实现动态修改——为通用开放世界建模指明了新方向。未来,随着语言模型推理能力的增强与真实世界状态估计技术的进步,Code World Model有望从虚拟走向现实,成为连接AI想象与物理世界的重要基础设施。
最终,一个真正“活着”的世界,不应只是连续生成的画面,而应是一套能被理解、被修改、被执行并持续留下后果的运行系统。Code World Model 正是在这条道路上迈出的关键一步。