DELE-w0.5如何重构世界模型?具身智能的新范式解析
近年来,具身智能领域正经历从“模仿”向“理解”的关键跃迁。传统机器人系统往往依赖大量示范数据或预设规则,在面对未见过的环境扰动时极易失效。而最新发布的 DELE-w0.5 模型,则通过一种全新的世界建模范式,展现出令人瞩目的鲁棒性与目标一致性——当微波炉门被意外关闭,机器人并未僵化执行原定抓取-放置流程,而是主动重新开门;当门缝狭窄,它甚至跳过把手操作,直接用爆米花包装袋推开障碍。这些行为并非预编程,而是模型在训练中习得的“目标条件下的行为重组”能力。
这种能力的核心,源于对“世界模型”本质的重新思考:机器人真正需要预测的,不是环境变化的每一帧视觉细节,而是动作执行后所达成的物理状态结果。DELE-w0.5 正是基于这一理念构建,其技术路径与当前主流的视频生成式世界动作模型(WAM)形成鲜明对比。
视频生成为何成为控制瓶颈?
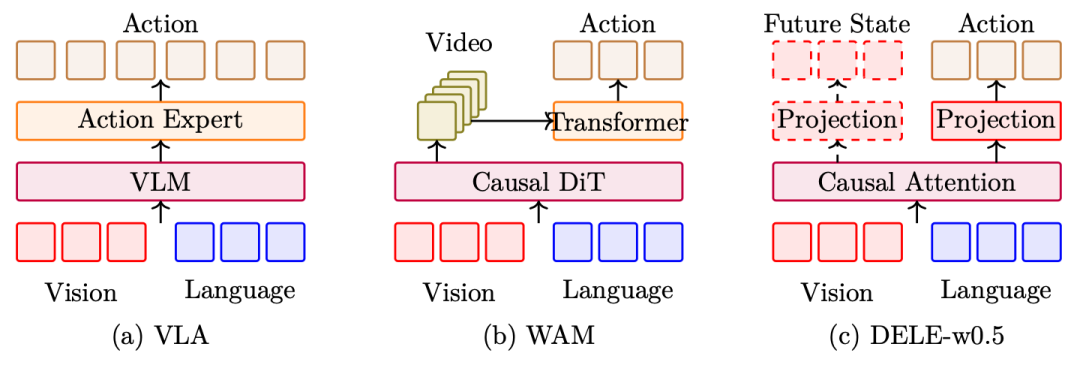
当前机器人基础模型主要分为两类:视觉-语言-动作模型(VLA)与世界动作模型(WAM)。VLA 直接映射当前观测与语言指令到动作输出,结构简洁但缺乏对环境动态的显式建模。而 WAM 则试图通过预测未来视频轨迹来学习物理规律,理论上能提供更丰富的时空先验。
然而,视频生成在机器人控制中存在根本性错配。以“打开冰箱取可乐”为例,控制系统关心的是:门是否完全开启?可乐是否被稳定抓取?冰箱是否最终关闭?这些是离散的、结果导向的状态节点。但视频生成模型却被迫还原从关门到开门过程中机械臂每一微秒的姿态、光影变化、物体反光等高维视觉信息。这些中间帧不仅计算开销巨大——多帧 latent 表示远大于动作序列本身——而且包含大量与任务无关的冗余细节。
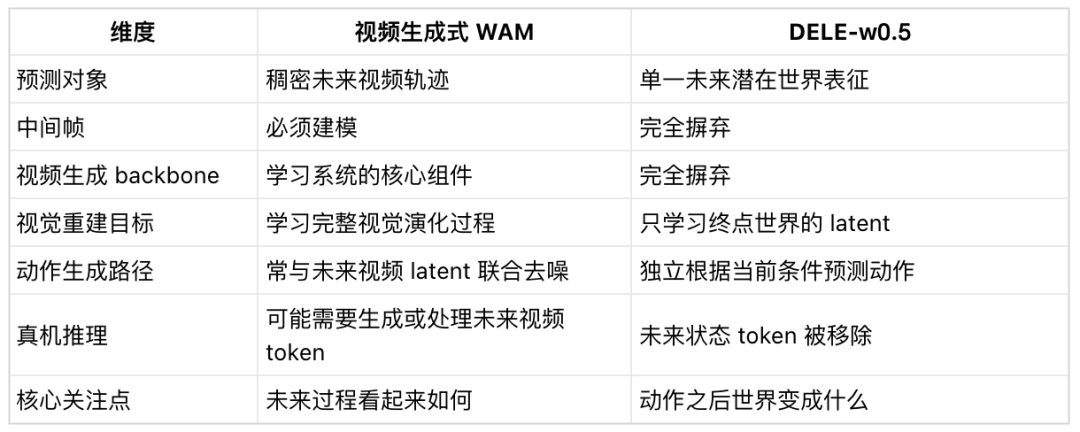
更严重的是,视频生成速度直接限制了控制循环频率。在扩散模型框架下,生成一段连贯视频需多轮去噪迭代,导致机器人无法实时响应环境变化。即便采用稀疏 token 或少步采样等优化手段,只要视频轨迹仍是核心建模目标,这一瓶颈就难以根除。
DELE-w0.5 的核心创新:结果导向的世界表征
DELE-w0.5 提出一个关键问题:对于机器人控制,世界模型真正需要预测什么? 答案是:动作完成后的世界状态,而非过程。
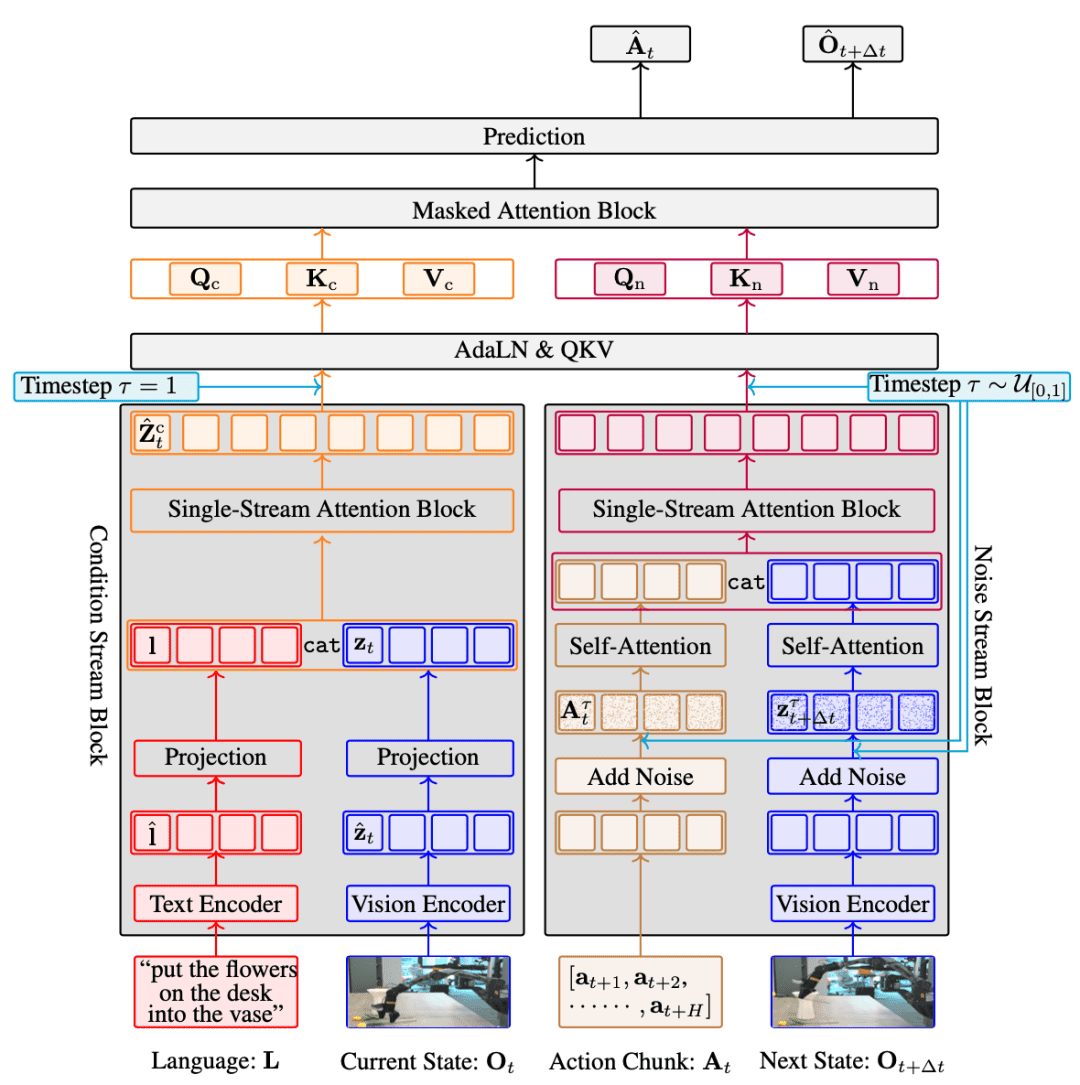
具体而言,模型在训练阶段联合学习两个目标:一是生成长度为60的动作序列(针对 Astribot S1 双臂机器人,每步含14维控制信号),二是预测该动作序列执行完毕后环境的未来世界表征。这一表征并非生成图像,而是由 DINO-v3 对未来观测进行编码得到的 latent 向量,蕴含物体位置、机械臂构型、空间关系等关键物理信息。
这种设计带来三重优势:
- 信息紧凑性:仅保留与任务结果相关的状态信息,剔除视觉过渡噪声;
- 计算高效性:避免高维视频生成,显著降低显存占用与推理延迟;
- 目标对齐性:迫使策略学习“动作→结果”的因果映射,而非“动作→视觉过程”的相关性。
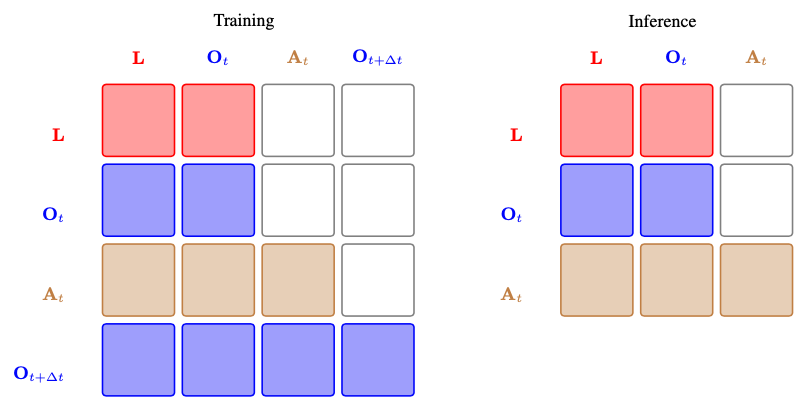
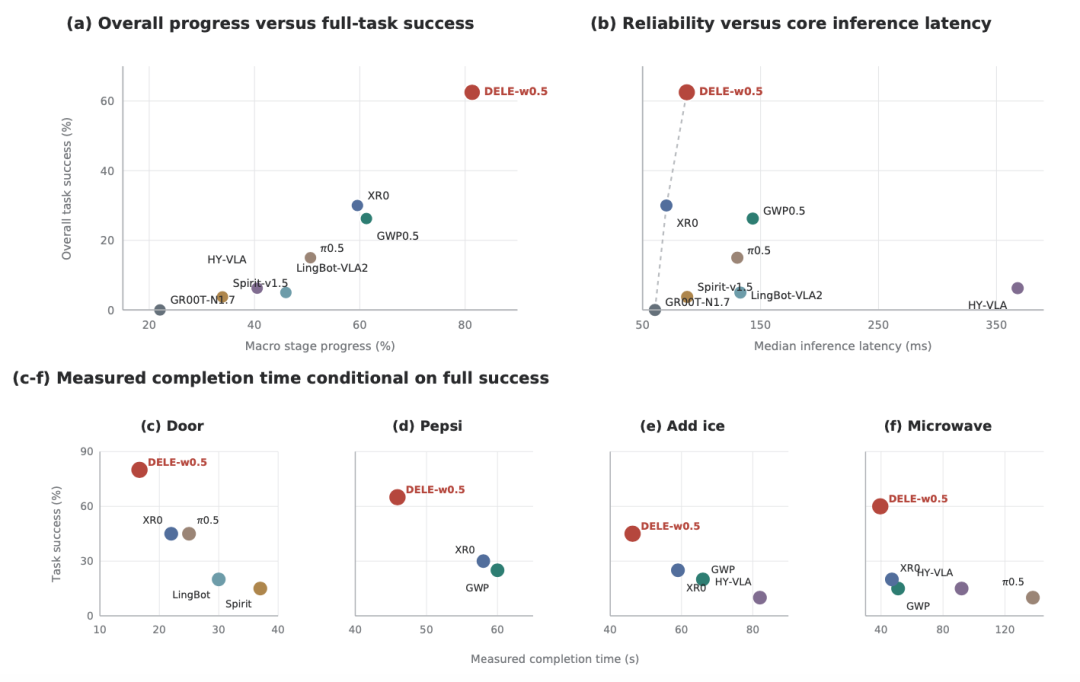
值得注意的是,未来世界表征仅在训练阶段作为监督信号存在。进入推理时,该分支被完全移除,模型仅依据当前语言指令、多视角图像(头部+双腕部)及本体状态直接输出动作。这使得控制链路极大简化,实测在 RTX 4090 上推理延迟中位数仅为87.5毫秒,优于多数现有模型。
双流架构与非对称注意力机制
为实现上述目标,DELE-w0.5 采用精心设计的双流 Transformer 架构。整个系统包含两条信息流:
- 条件流:处理语言指令(经 Qwen3 编码)与当前视觉观测(经 DINO-v3 编码),融合为统一的上下文表征;
- 噪声流:接收加入噪声的动作序列与未来世界表征,通过 Flow Matching 同时进行动作去噪与状态去噪。
关键创新在于非对称注意力掩码的设计。在训练过程中:
- 动作 token 可访问语言、当前视觉及自身历史,但无法读取未来世界表征 token,防止“作弊”;
- 未来世界表征 token 则可读取语言、当前视觉及完整动作序列,学习“给定这些动作,环境将变成什么样”。
这种不对称性确保了动作生成路径虽不直接依赖未来状态,但其底层表征仍通过共享参数受到“动作后果”的隐式约束。换言之,模型在学习“做什么”的同时,也在学习“做了之后会怎样”,从而建立起更强的因果推理能力。
真机验证:长程任务中的阶段保持能力
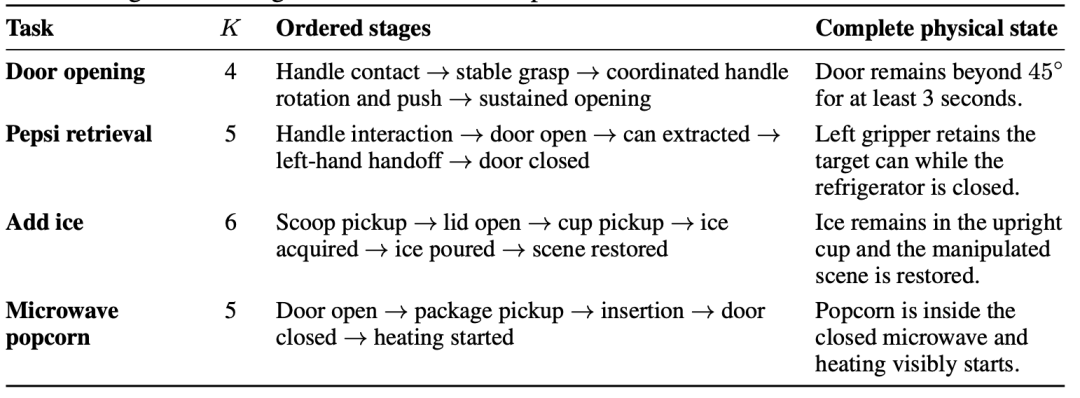
理论优势最终需经真实世界检验。研究团队在 Astribot S1 上设置了四项复杂长程任务:开门、冰箱取可乐、杯中加冰、微波炉加热爆米花。每项任务包含多个子阶段,且后一阶段依赖前一阶段的成功状态(如取可乐需先开门,加冰需先取冰铲并定位杯子)。
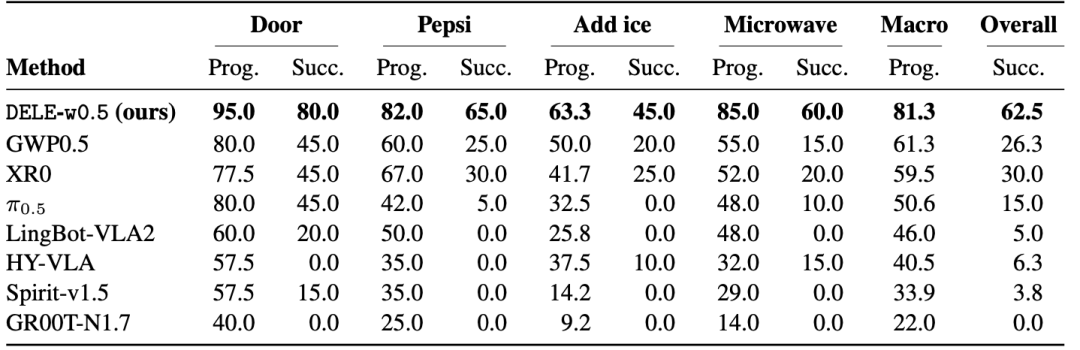
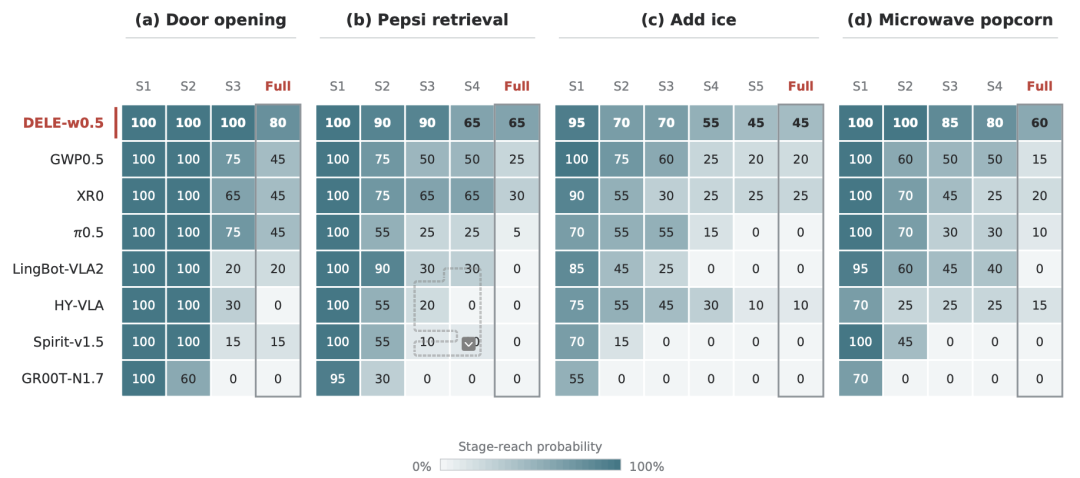
在640次严格对照实验中(8种方法×4任务×20次),DELE-w0.5 以 62.5% 的完整任务成功率大幅领先最强基线 XR0(30.0%),平均有序阶段进度达81.3%,比次优模型高出20个百分点。分任务来看:
- 开门任务:80%成功率,所有测试均完成推门动作,失败多因门未完全开启;
- 冰箱取可乐:65%成功率,18次成功取出可乐,失败集中于双手交接与最终关门;
- 杯中加冰:45%成功率,作为最长任务(涉及工具使用、倾倒、复位),仍显著优于基线;
- 微波炉任务:60%成功率,每次均能完成放置,12次成功启动加热。
数据揭示一个关键现象:性能差距主要出现在任务后半程。多数基线模型能在初期完成简单操作(如抓取把手、打开冰箱),但在多阶段衔接处频繁失败——例如开门后无法协调推门力度,或取物后忘记关门。而 DELE-w0.5 凭借对“最终状态”的持续关注,更有效地保持了阶段性成果,将中间进展转化为完整成功。
跨场景泛化:不依赖固定背景的鲁棒性
除任务性能外,DELE-w0.5 还展现出出色的 zero-shot 跨背景能力。在未经微调的情况下,模型成功在办公桌、会议室等不同光照、材质与布局环境中执行微波炉与加冰任务。这表明其学习到的并非特定场景的视觉记忆,而是通用的物理交互规律与目标状态表征。
这种泛化能力源于两点:一是 DINO-v3 视觉编码器本身具备强泛化性;二是未来世界表征聚焦于物体关系与状态,而非像素级细节。当桌面从木质变为玻璃,只要“杯子直立”“冰块落入”等核心状态不变,模型即可正确执行。
对具身智能发展的启示
DELE-w0.5 的意义远超单一模型性能提升。它挑战了“世界模型必须生成视频”的固有范式,提出了一条更契合机器人控制本质的路径:以行动结果为中心,而非以视觉过程为中心。
这一思路对具身智能未来发展具有深远影响:
- 计算效率与部署可行性:去除视频生成负担,使复杂策略可在消费级GPU上实时运行,加速落地;
- 数据利用效率:无需采集密集视频标注,仅需任务成功/失败的状态标签即可训练;
- 跨本体迁移潜力:世界表征可抽象为通用物理状态,便于在不同机器人平台间迁移策略;
- 安全与可解释性:明确的状态目标比黑箱视频更易验证与干预。
当然,62.5%的成功率距离工业级99%的可靠性仍有差距。未来工作需在更开放环境、更多样物体、更复杂交互中持续验证该范式的上限。但毫无疑问,DELE-w0.5 已为具身智能开辟了一条值得深入探索的新路径——在这里,智能不是对世界的完美复现,而是对目标状态的坚定抵达。