Mac被OpenAI扫货背后:苹果与英伟达如何共筑AI算力新生态?
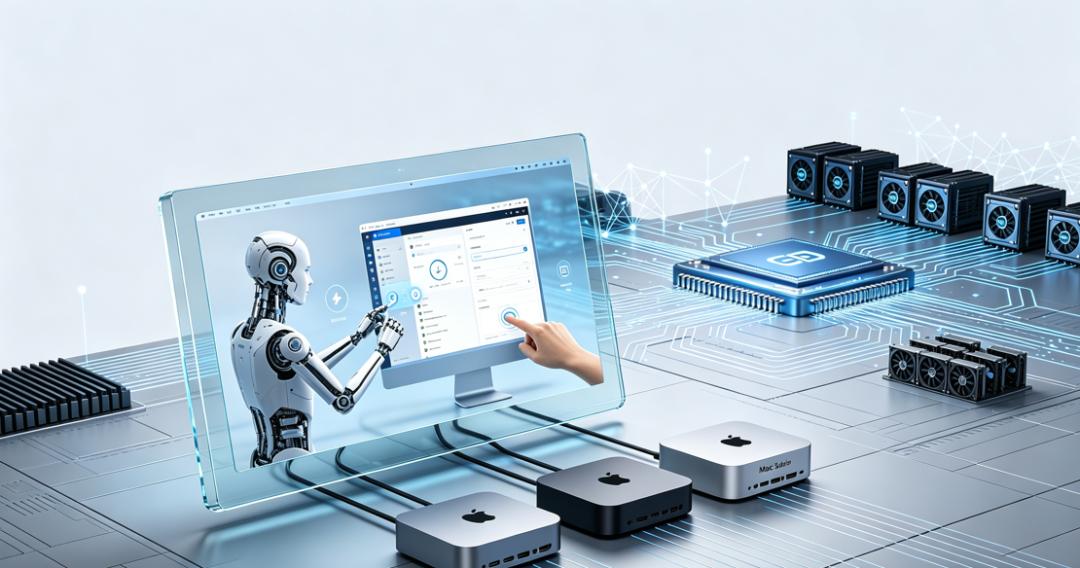
当数万台Mac mini悄然进入OpenAI的数据中心机房,拆去屏幕与键盘,仅保留主机本体作为AI智能体的“训练工位”时,一场关于AI算力格局的误读也随之蔓延。舆论场中,“苹果正在抢走英伟达生意”的叙事甚嚣尘上,仿佛一场你死我活的替代战争已然打响。然而,若跳出非此即彼的二元框架,便会发现这并非一场零和博弈,而是一次AI产业精细化分工下的自然协同。
AI的发展已从单纯的文本生成迈向具身智能(Embodied AI)的新阶段。GPT-5或GPT-6这样的基座模型固然强大,但它们如同只会说话的“理论家”,无法真正操作计算机完成实际任务。而OpenAI正在构建的,是能够自主打开Excel整理数据、切换浏览器检索信息、甚至调试代码的“数字实习生”——这类AI智能体必须在真实操作系统环境中反复试错,才能跨越仿真与现实之间的“虚实鸿沟”。
斯坦福大学《2026 AI Index Report》指出,仿真环境下任务完成率高达89.4%的智能体,一旦部署到真实系统中,成功率可能骤降至不足30%。这一断崖式下跌揭示了纯软件仿真的局限性:操作系统内核行为、图形界面响应延迟、文件系统权限机制等细节,难以在虚拟环境中完全复现。因此,最直接有效的解决方案,就是将AI智能体置于真实的macOS环境中进行强化学习。
这就引出了一个关键问题:为何必须是Mac?答案藏在苹果软硬件的高度封闭性之中。macOS的最终用户许可协议(EULA)明确禁止在非苹果硬件上运行其操作系统,且其底层虚拟化机制(如Apple Virtualization Framework)对非Apple Silicon芯片支持极为有限。这意味着,若要训练一个能熟练操作Mac系统的AI智能体,唯一合规且高效的方式,就是使用真实的Mac设备。
更进一步,苹果M系列芯片的统一内存架构(Unified Memory Architecture, UMA)在此场景中发挥了意想不到的优势。传统x86+独立GPU架构中,CPU与GPU拥有各自独立的内存空间,数据交换需通过PCIe总线搬运,不仅延迟高,还消耗额外带宽。而在M系列芯片中,CPU、GPU、神经网络引擎(Neural Engine)共享同一块高带宽内存池。以Mac Studio为例,配备512GB统一内存的机型可提供高达1.2TB/s的内存带宽,使得大型语言模型可在本地完整加载并进行微调,无需频繁与外部存储交互。
这种架构特别适合强化学习中的策略优化任务——智能体在执行操作后需即时评估结果并更新内部参数,低延迟、高吞吐的内存访问能力极大提升了训练效率。这也解释了为何不仅OpenAI,连Anthropic等公司也通过AWS的EC2 Mac实例租用Mac mini集群,用于类似用途。
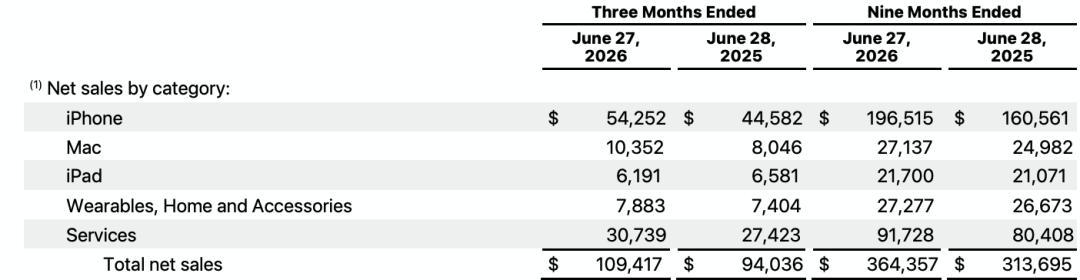
值得注意的是,这场“Mac热潮”对苹果而言近乎一场意外之喜。据前苹果AI产品营销经理Todd Dailey透露,公司内部并未专门规划企业级AI训练市场,也缺乏对接此类需求的工程团队。Mac业务的爆发式增长——单季度营收达103亿美元,同比增长29%,成为苹果硬件板块增速最快的产品线——更多是市场需求自发驱动的结果。
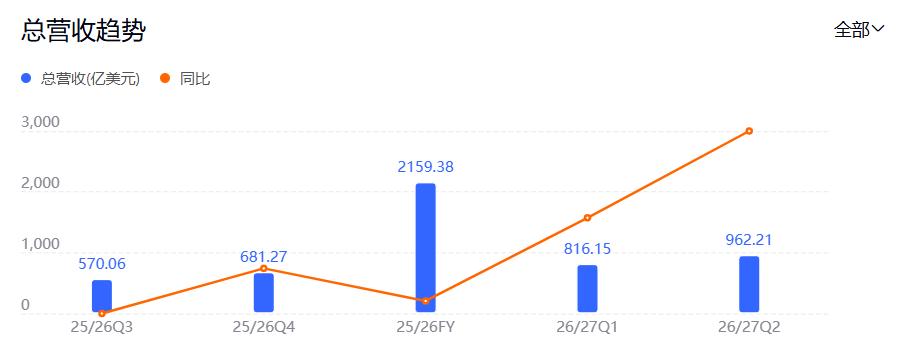
反观英伟达,其在AI算力领域的统治地位依然坚不可摧。2027财年第二季度财报显示,公司营收高达962亿美元,同比增长106%,净利润近600亿美元,毛利率维持在75%的惊人水平。在全球高端AI GPU市场,英伟达仍占据80%-85%的份额,CUDA生态更是构筑了难以逾越的护城河。几乎所有主流AI框架——PyTorch、TensorFlow、JAX——都深度依赖CUDA进行加速,开发者生态、工具链、库函数的积累已近二十年。
更重要的是,英伟达提供的不仅是芯片,而是一整套AI基础设施解决方案。从DGX超级计算机到AI Enterprise软件套件,再到NVIDIA AI Foundry服务,其产品矩阵覆盖了从模型预训练、微调到部署的全生命周期。OpenAI用于训练GPT系列大模型的万亿级token数据处理,依然运行在由数千颗H100 GPU组成的集群之上,这是Mac完全无法承担的任务。
因此,将苹果与英伟达的关系理解为“中央电站”与“家用发电机”的互补更为贴切。英伟达负责构建AI世界的“主干电网”——训练千亿参数基座模型,提供稠密算力;而苹果则在“终端用电”环节发挥作用——支持智能体在真实环境中的交互训练、端侧推理与个性化微调。二者所处的算力层级、任务类型与技术路径截然不同。
即便英伟达推出DGX Spark等紧凑型桌面AI设备,其目标也是补全边缘计算节点,而非取代终端设备。同样,苹果也无意进军数据中心GPU市场。其近千亿美元的现金储备更可能投向M系列芯片的持续迭代与供应链优化,而非挑战CUDA生态。
从产业演进角度看,AI算力正走向分层异构的新范式。未来不会存在一种“万能芯片”通吃所有AI任务,而是根据场景需求选择最优组合:超大规模预训练依赖英伟达GPU集群;强化学习与真实环境交互依赖Mac等封闭终端;边缘推理可能由高通、联发科或苹果自研NPU承担;而专用AI ASIC则在特定领域(如自动驾驶、语音识别)发挥极致能效比。
这种分工不仅提升整体效率,也降低了AI开发门槛。初创公司无需自建GPU集群,即可通过云服务租用Mac实例训练智能体;大模型厂商则可专注于核心算法创新,将环境适配交给终端生态。苹果的策略本质上是“卖出方向盘”——不争做AI模型的领头羊,而是确保自家硬件成为AI应用的最佳载体,从而通过硬件溢价、服务订阅(如Apple Intelligence)实现价值捕获。
OpenAI采购Mac的举动,标志着AI已从“对话时代”迈入“行动时代”。智能体不再满足于回答问题,而是要动手做事。这一转变催生了对真实操作系统环境的刚性需求,而苹果凭借其独特的软硬件整合能力,恰好填补了这一空白。
综上所述,Mac的热销并非对英伟达的威胁,而是AI产业链条延伸的自然结果。在浩瀚的AI浪潮中,没有唯一的赢家,只有各司其职的协作者。英伟达掌控着算力的核心区,苹果则在交互的“最后一公里”开辟新战场。二者共同构筑了一个多层次、高效率的AI基础设施生态,推动整个行业向更复杂、更实用的智能体时代迈进。
未来,随着AI Agent在办公自动化、软件测试、客户服务等场景的落地,对真实终端环境的需求将持续增长。苹果或许会顺势推出面向企业市场的Mac服务器版本,优化远程管理与集群调度能力;而英伟达则继续在稀疏激活、混合专家(MoE)架构、光互联等前沿领域突破算力瓶颈。这场看似对立的“算力争夺”,实则是AI生态走向成熟与多元的必然体现。