世界模型训练完就退场?这种“反骨”设计让机器人更高效
近年来,具身智能领域对世界模型(World Model)的依赖日益加深。传统范式中,世界模型如同机器人的“脑内沙盘”,在执行任务时不断预测未来状态以指导决策。然而,这种在线推理机制带来了显著的计算负担——每一次动作选择都需展开多步模拟,导致延迟增加、能耗上升,尤其在工业场景下,这些开销会随着设备规模呈指数级放大。
正是在这一背景下,光象科技联合清华大学李升波教授课题组提出了一种极具颠覆性的思路:让世界模型只在训练阶段发挥作用,部署时彻底“退场”。这项名为 Phi-WM 1.0 ActEffect(简称 ActEffect)的技术,不仅没有削弱机器人能力,反而在多个高难度基准测试中实现了性能跃升。其核心理念在于:利用动作可能引发的物理后果作为监督信号,反向优化策略,而非依赖执行阶段的持续推理。
模仿学习的局限与后果反馈的引入
当前主流的通用机器人策略多基于视觉-语言-动作(VLA)架构。这类模型通过大量人类演示数据学习“看到什么、听到什么指令、就做出什么动作”。训练目标通常是让模型输出的动作尽可能接近示范动作。然而,动作相似 ≠ 结果正确。在真实物理环境中,微小的动作偏差可能导致完全不同的结果——夹爪闭合时机差0.1秒,零件可能滑落;手腕角度偏转2度,插接过程便卡死。
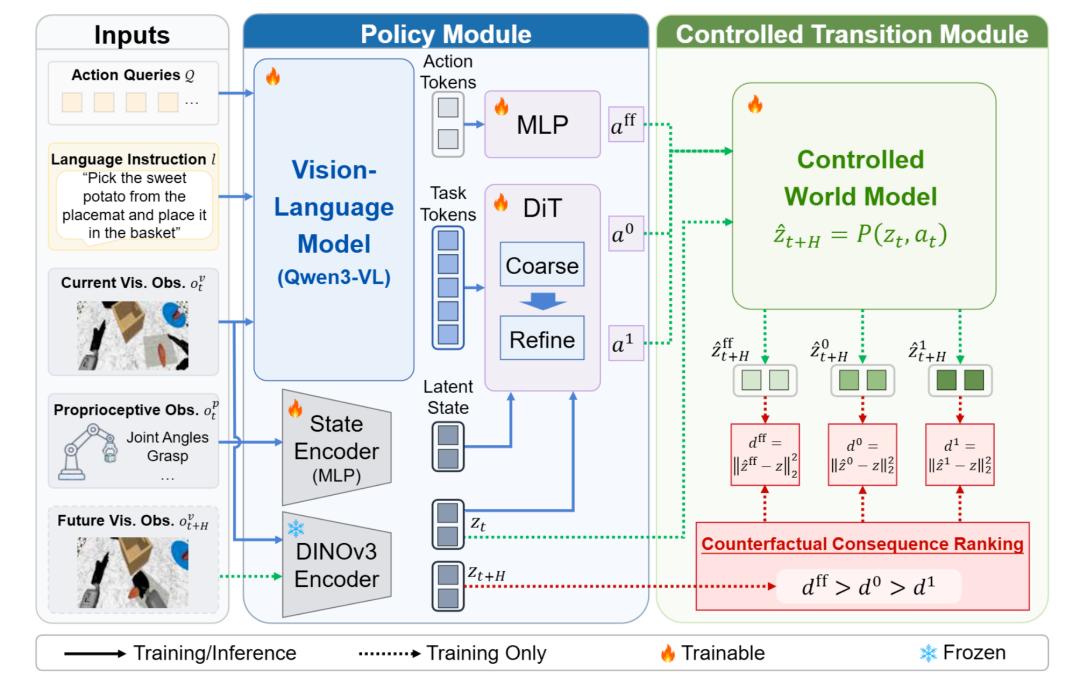
ActEffect 的突破点正在于此。它不再满足于“模仿动作”,而是追问:“这个动作会导致什么?”为此,系统设计了一个三阶段动作生成流程:
- 第一版:来自前馈分支的“直觉反应”,快速但粗糙;
- 第二版:由 MIP(Motion Inference Proposal)动作头生成的粗略提案;
- 第三版:在粗提案基础上精修后的最终执行动作。
这三份动作提案均完整可执行,且共享相同的初始状态,为后续的后果比较提供了公平基础。值得注意的是,传统扩散或流匹配策略在训练过程中会产生大量带噪中间状态,难以直接用于世界模型评估。而 ActEffect 通过结构化设计确保每一份提案都是物理可行的完整动作序列。
受控世界模型:只看画面与动作,不读指令
接下来登场的是 受控世界模型(Controlled World Model)。它的任务非常明确:给定当前视觉状态和一份动作提案,预测执行该动作后场景将如何变化。关键在于,该模型完全忽略语言指令。例如,无论指令是“挪开杯子”还是“清理桌面”,只要机械臂施加相同的推力,杯子的运动轨迹就应一致。这种设计剥离了语义干扰,使模型专注于学习纯粹的物理因果关系。
更进一步,ActEffect 并不要求世界模型生成逼真的未来图像,而是将预测结果映射到 冻结的 DINOv3 视觉特征空间 中。DINOv3 是一种强大的自监督视觉编码器,能有效捕捉物体位置、姿态及场景结构的变化。通过在该特征空间中衡量预测与真实未来的距离,系统避免了图像生成带来的计算复杂性和模式崩溃风险,真正实现了“物理原生”的建模方式。
排序损失与梯度截断:防止模型“作弊”
仅有预测还不够,关键是如何将差异转化为有效的学习信号。ActEffect 引入了一种 排序损失(Ranking Loss)机制:要求精修提案的预测结果比粗提案更接近真实未来,而粗提案又优于前馈提案。这种层级式监督迫使策略不断改进动作质量。
但若无约束,模型可能通过“让差答案变得更差”来人为拉大差距,从而“作弊”获得更高分数。为此,系统对排序损失实施了 梯度截断(Gradient Clipping)——仅允许优化方向朝向真实未来,禁止通过恶化其他提案来提升相对排名。这一设计确保了训练过程的稳定性和有效性。
最终,所有关于“后果”的知识都被编码进策略网络的权重中。部署时,受控世界模型和未来观测分支被完全移除,仅保留轻量化的 MIP 动作头完成粗提案与精修。机器人无需再进行任何未来展开或候选搜索,执行链路极大简化。
实验验证:从仿真到真实场景的跨越
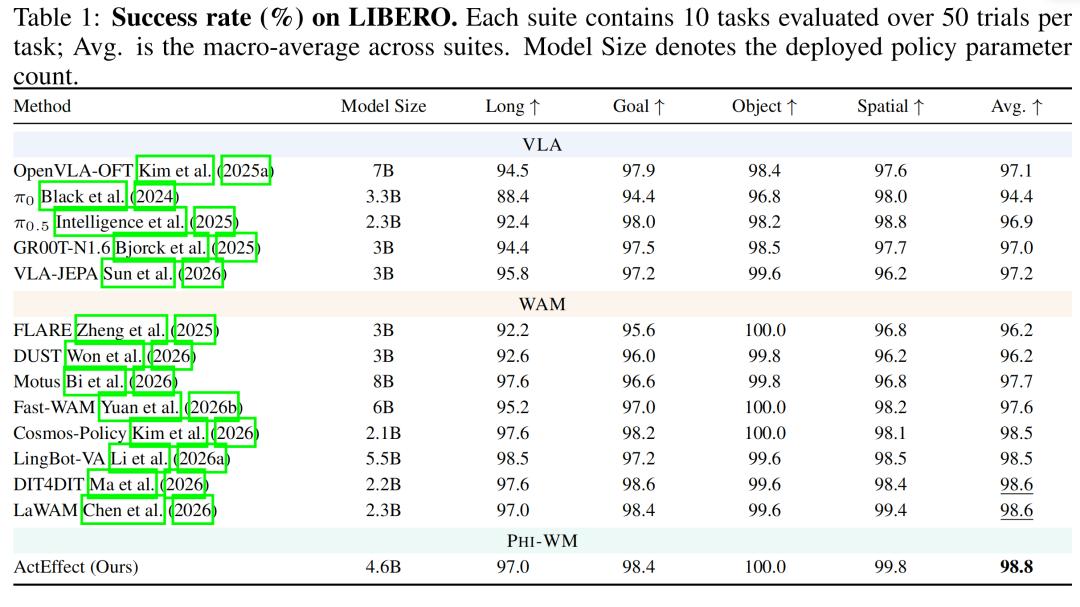
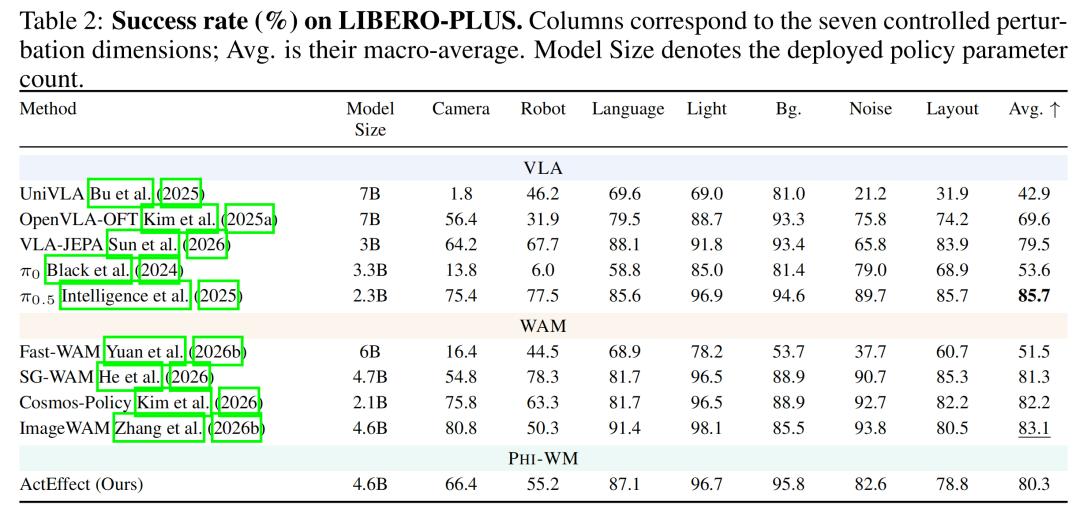
在标准基准测试中,ActEffect 展现出强劲实力。在 LIBERO(包含四组单臂多任务桌面操作)上,其平均成功率达 98.8%,略高于 DiT4DiT 的 98.6%。更重要的是,在引入七类分布偏移的 LIBERO-PLUS 上,ActEffect 以 80.3% 的成功率大幅领先 Fast-WAM 的 51.5%,证明其对环境扰动具有更强鲁棒性。
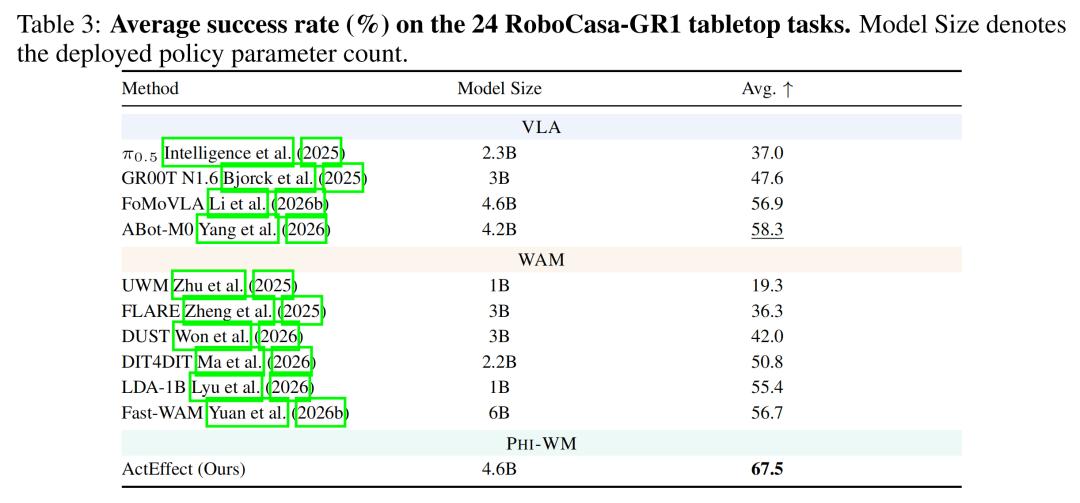
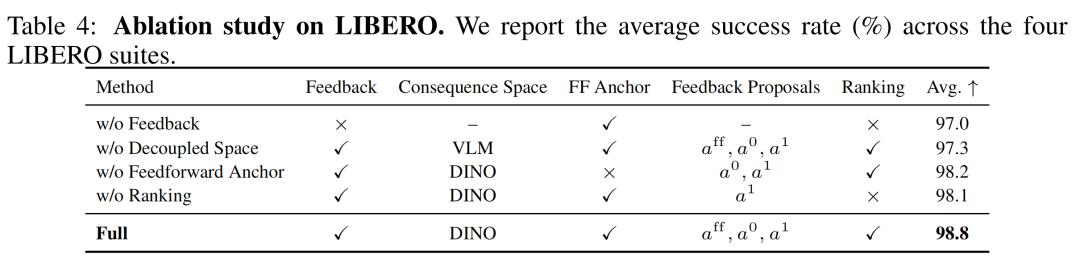
挑战更大的是 RoboCasa-GR1,该任务要求控制拥有双臂、灵巧手和腰部自由度的 GR-1 人形机器人,在 29 维动作空间 中完成 24 项复杂操作。在此高维、高自由度场景下,ActEffect 仍取得 67.5% 的平均成功率,比第二名 ABot-M0 高出 9.2 个百分点。消融实验进一步验证了各组件的有效性:移除后果反馈后,LIBERO 成功率降至 97.0%;替换 DINOv3 为 VLM 特征空间,成绩回落至 97.3%;去掉排序损失,则降至 98.1%。
工业落地的现实考量:成本、稳定与可复制性
为何要让世界模型“退场”?答案藏在工业部署的账本里。在实验室,多一层推理只是算力消耗;但在汽车工厂,每一毫秒延迟都可能影响产线节拍,每一块额外 GPU 都意味着数万元成本。当方案扩展至数百台设备时,累积开销将极其可观。
ActEffect 的设计恰好规避了这一痛点。它在训练阶段“榨取”演示数据中的隐含监督信号,使策略提前内化对动作后果的理解,从而在执行阶段无需携带沉重的世界模型。这种“训练重、部署轻”的范式,更契合工业系统对 低延迟、高可靠、易维护 的要求。
光象科技已将该技术应用于真实场景。在 2026 ATC 展会上,其 Phi-Bot X1 机器人在蔚来汽车焊接上下料工位连续运行 21.5 小时,零失误、零中断。目前,公司正围绕散乱件上下料、复杂曲面质检等高价值工位推进商业化,与多家头部车企建立合作。其团队兼具学术前沿研究与汽车产业工程经验——创始人张涛曾主导高德地图空间感知引擎,技术已进入汽车量产体系;联合创始人李升波长期深耕自动驾驶与具身智能,多项成果实现产业转化。
具身智能的终极考场:不是演示,而是交付
过去两年,机器人演示视频层出不穷:叠衣服、开瓶盖、听长指令……但客户关心的从来不是几十秒的精彩表演,而是 一年365天、每天24小时的稳定运行。验收标准包括节拍达标率、定位精度、安全冗余、故障恢复速度等硬指标。更关键的是,同一套能力能否快速迁移到新车型、新零件、新工位?部署周期是否可控?人力节省能否覆盖硬件投入?
ActEffect 的价值正在于此。它通过训练阶段的后果反馈提升策略鲁棒性,同时削减部署端算力需求,使得规模化复制更具经济可行性。虽然真机大规模验证仍在进行中,但其在仿真中的成功已为工业落地提供了有力支撑。
未来,VLA、WAM 等技术将持续演进,但客户不会为技术名词买单。他们只关心:机器人能否按时交付?能否扛住产线压力?能否快速复制?账能不能算平?ActEffect 这个“反骨”的世界模型,已在训练场交出答卷。真正的考验,是在轰鸣的车间里,日复一日地顶住节拍、误差与不确定性。