VLA-Corrector:如何让机器人学会在出错时及时停手?
近年来,视觉-语言-动作(Vision-Language-Action, VLA)模型在具身智能领域取得了显著进展。这类系统能够理解自然语言指令、解析视觉输入,并生成连续的动作序列以完成复杂任务。然而,在实际部署中,一个长期被忽视的问题逐渐浮出水面:当环境发生突发变化时,机器人往往无法及时响应,而是继续执行早已过期的动作计划。

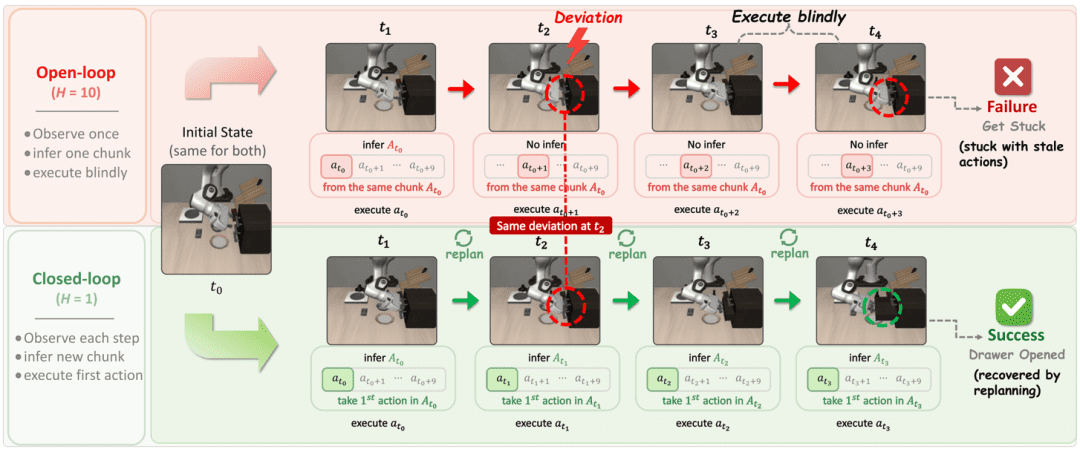
这种现象并非源于感知缺失——相机仍在工作,画面持续输入;也非模型能力不足——VLA本身具备强大的推理能力。问题的核心在于当前主流架构所依赖的 action chunk 机制。为了降低计算开销,VLA通常在一次推理中生成未来H步的动作(称为一个chunk),随后机器人按序执行这些动作,直到下一次推理周期开始。这种方式虽然提升了执行连贯性并减少了模型调用频率,却在执行过程中制造了一段 “开环盲区”:在此期间,系统对环境变化完全“失聪”,即使目标被移动、物体滑落或路径受阻,机器人仍会机械地完成预设动作,最终导致任务失败。
浙江大学ACES实验室OmniAI团队与阿里巴巴达摩院联合提出的 VLA-Corrector,正是针对这一结构性缺陷的创新解决方案。其核心理念并非彻底摒弃action chunk,也不是强制每一步都重新规划(那将极大增加计算负担),而是引入一种 轻量级、事件驱动的动态纠错机制,让系统在关键时刻“睁眼”并做出调整。
开环盲区的本质:效率与鲁棒性的权衡困境
Action chunk 的设计初衷是合理的。以当前流行的π0.5模型为例,若将动作视界(horizon)H设为10,意味着每10个控制步才调用一次VLA模型。实验数据显示,这可将策略调用次数减少约4倍,显著提升运行效率。然而代价同样明显:在MetaWorld基准测试中,当H从1增至10时,平均任务成功率从64%骤降至不足49%。尤其在抓取、插入、对齐等高精度操作阶段,微小的初始偏差会在后续动作中被不断放大,最终导致不可逆的失败。
更关键的是,环境扰动具有不可预测性。人类操作者在碗被突然移走时会本能暂停、重新观察并调整动作;而传统VLA系统却因处于chunk执行期内,无法中断当前序列。这种“闭眼执行”的特性使其在动态、非结构化的真实场景中表现脆弱。
因此,问题的关键不在于寻找一个“最优H值”,而在于 识别何时当前动作序列已不再可信。VLA-Corrector的回答是:不需要每次都重规划,但必须在动作失效的那一刻拥有接管权力。
VLA-Corrector架构:监测—打断—纠正的三步闭环
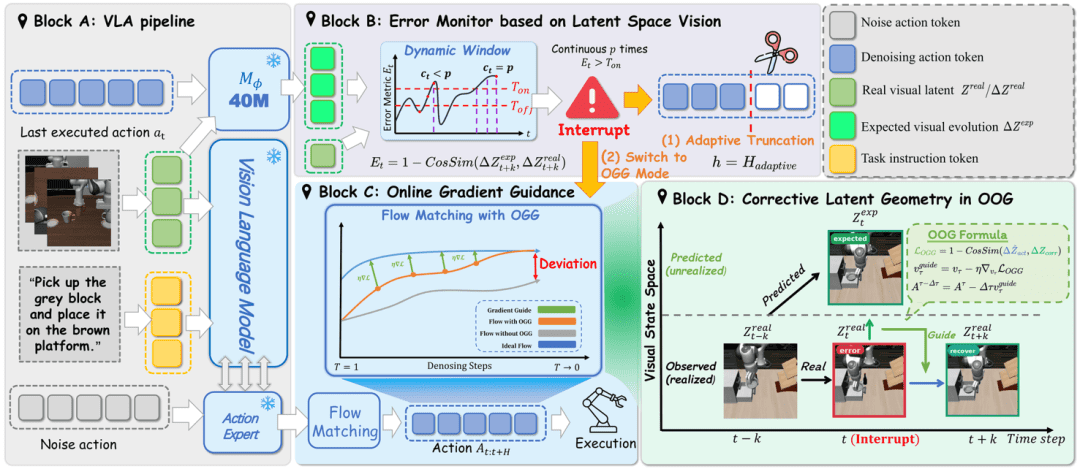
VLA-Corrector并未改动原有VLA主干网络的权重,而是在推理链路之外构建了一条独立的 旁路校正通道,仅增加约40M参数,实现了极低的计算开销。整个机制可分为三个紧密衔接的阶段:
第一阶段:Latent-space Vision Monitor(LVM)进行偏差检测。LVM并不直接比较像素级图像差异,而是在VLA编码器输出的高维潜在空间(latent space)中学习“预期视觉动态”。具体而言,给定当前状态和即将执行的动作,LVM预测下一帧视觉特征应发生的残差变化。在线运行时,系统持续对比 预测残差 与 实际观测到的视觉特征变化。由于潜在空间过滤了光照、背景等无关干扰,该方法能更精准地捕捉与任务相关的动态异常,如物体位移、接触失败或轨迹偏移。
第二阶段:基于多条件判断的智能打断机制。单一帧的偏差可能是噪声所致,因此VLA-Corrector引入了 动态阈值、迟滞窗口和连续步验证 三重保障。只有当偏差持续超过阈值、且在连续多个控制步中稳定存在时,系统才会判定当前chunk已“过期”,并立即清空动作队列中尚未执行的部分。这种设计有效避免了因瞬时抖动导致的误中断,确保打断行为仅发生在真正需要干预的关键时刻。
第三阶段:Online Gradient Guidance(OGG)引导恢复推理。简单地重新调用VLA可能再次生成无效动作,尤其当环境已严重偏离原始假设时。为此,OGG将LVM检测到的视觉偏差转化为梯度信号,在下一次VLA推理时 仅对首个动作进行梯度引导,将其推向更有利于状态恢复的方向。这种轻量级引导不改变整体策略分布,却能显著提升恢复成功率。
通过上述机制,VLA-Corrector实现了 事件触发的自适应动作视界:在平稳搬运阶段,系统可维持较长chunk以提升效率;一旦进入易错操作(如抓取、插入),则随时准备切回短视野甚至单步闭环。实验显示,83.7%的动作截断恰好发生在这些高风险阶段,证明了其判断的精准性。
实验验证:成功率提升的同时降低计算开销
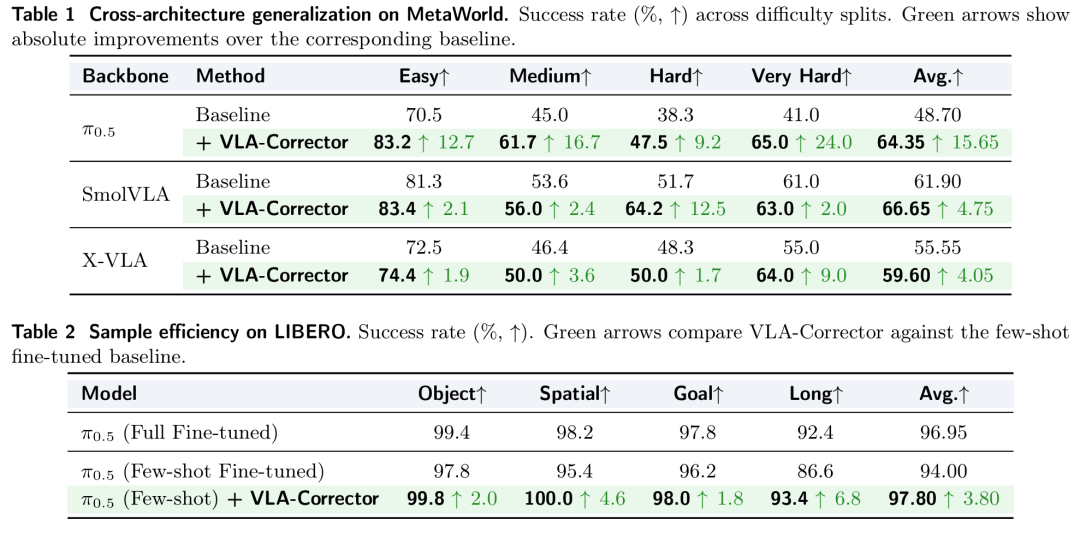
在多个基准和真实机器人平台上,VLA-Corrector展现出卓越性能。在MetaWorld环境中,为π0.5模型集成Corrector后,平均任务成功率从48.70%提升至64.35%;在难度最高的“Very Hard”子集上,提升幅度高达24个百分点。更令人惊讶的是,这一提升并非以增加计算为代价。以SmolVLA为例,在H=10的设定下,成功率从61.90%升至73.00%,而平均策略调用次数反而从19.27次降至15.64次。原因在于:及时丢弃过期chunk避免了在错误轨迹上浪费整段动作,从而减少了无效推理。
在真实AgileX PiPER机械臂上的九项任务中,平均成功率从55.6%跃升至73.3%。特别在人为扰动测试中(如任务中途移动目标物体),成功率从40.0%大幅提升至68.3%,充分验证了其在动态环境中的鲁棒性。此外,在LIBERO基准上,仅使用few-shot微调的VLA-Corrector模型达到97.8%的成功率,甚至超过了fully fine-tuned baseline的96.95%,显示出其强大的泛化与纠错能力。
系统级启示:大模型提计划,小模型做审计
VLA-Corrector的价值不仅在于技术实现,更在于其带来的 系统设计范式转变。传统思路倾向于通过更大规模的模型或更频繁的重规划来提升可靠性,但这在资源受限的真实机器人上难以落地。而Corrector提出了一种分工明确的协作模式:大模型负责高层次动作规划,轻量级校正器负责实时审计与风险拦截,执行层保留紧急叫停权。
这种架构更贴近人类认知机制——我们不会每毫秒都重新思考整个动作,但在察觉异常时会立即暂停并调整。它承认了“完美预测”的不可行性,转而聚焦于 错误检测与快速恢复,这正是具身智能走向实用的关键一步。
当然,VLA-Corrector并非万能。其恢复能力仍受限于基础VLA策略的上限,无法解决模型本身不具备的技能。但它的核心贡献在于 有效抑制了开环盲区中错误的指数级放大,大幅降低了从失败中恢复的难度。正如论文所强调的:“机器人未必需要永远不出错,但它必须学会不把错误继续做完。”
未来,这一思路可进一步扩展至多模态感知融合、跨任务知识迁移等领域。例如,将触觉或力反馈纳入LVM的监测维度,或利用历史纠错经验优化OGG的引导策略。无论如何,VLA-Corrector为构建高效、可靠、适应性强的具身智能系统提供了一个极具启发性的新方向。