VLAct:让每条机器人数据学得更值的VLA预训练新范式
近年来,视觉语言动作模型(Vision-Language-Action Models, VLA)被视为通向通用机器人智能的关键路径。受大语言模型成功经验启发,研究者普遍希望通过扩大数据规模、增加模型参数和提升算力来推动性能边界。然而,机器人领域的数据获取存在天然瓶颈——每一条轨迹都需在真实或高保真仿真环境中由机器人执行,涉及硬件损耗、人力遥操作与时间成本,无法像互联网文本那样“爬取”海量样本。面对几乎无限的任务-物体-机器人组合空间,单纯依赖数据扩展(Data Scaling)难以为继。

在此背景下,StarVLA团队提出了一种新思路:与其一味追求更多数据,不如让每一条已有数据“学得更值”。他们发布的 VLAct(Vision-Language-Action with Transferable representations)框架,将预训练目标从“训练一个强策略”转向“构建一个高迁移性的表示底座”,在仅使用16张GPU和完全开源数据的前提下,实现了多项SOTA结果,并在跨机器人迁移任务中展现出惊人效率。
传统VLA预训练的隐性陷阱:表示坍缩
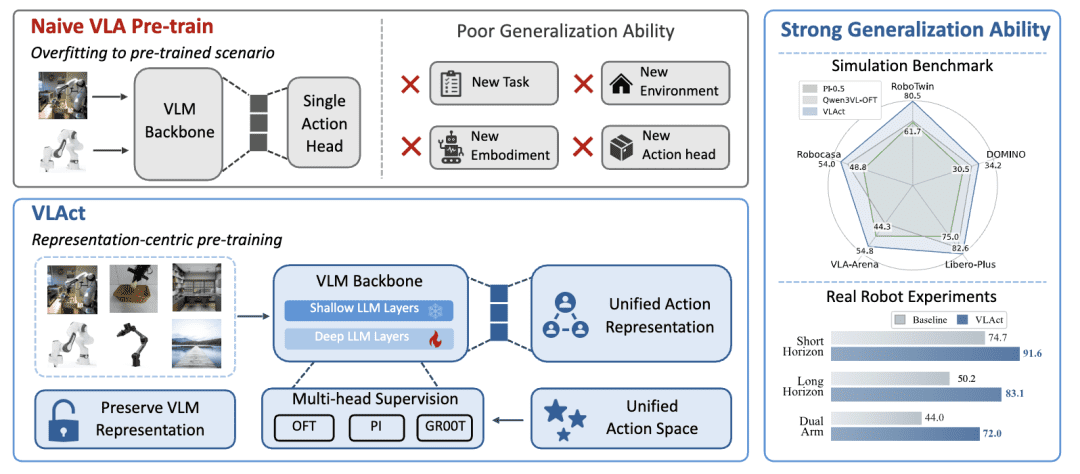
当前主流VLA模型通常以现成的视觉语言模型(VLM)为基础,在其顶部附加一个动作预测头(Action Head),如OFT、PI或GR00T等架构,再利用机器人轨迹数据进行continued pre-training。直观来看,若下游任务中该Action Head的表现提升,便认为预训练成功。但VLAct团队通过实验发现,这一假设存在严重漏洞。
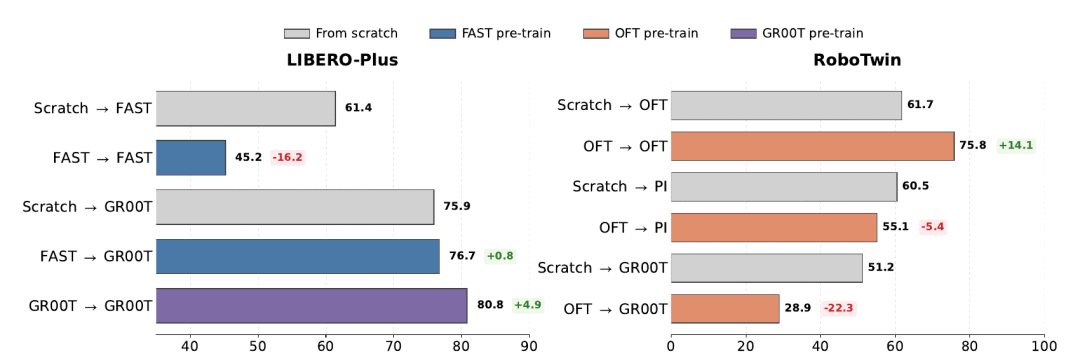
以RoboTwin基准为例,当使用OFT Head进行预训练后,若下游继续采用OFT,成功率可从61.7%提升至75.8%;然而,若将同一Backbone换用PI Head,性能反而从60.5%下降至55.1%;更极端的是,切换至GR00T Head时,成功率暴跌至28.9%。这表明:Backbone在单一Head监督下学到的特征表示,高度适配特定解码器结构,却丧失了跨Head的通用性。
论文将此现象称为 “head-specific representation collapse”(头特异性表示坍缩)。本质上,Backbone与Action Head协同优化过程中,会逐渐将视觉-语言信息编码为最便于当前Head读取的形式,例如特定维度对齐、局部特征强化等。这种“定制化”表示虽利于当前策略,却牺牲了可迁移性——一旦更换Head、任务或机器人本体,原有知识难以复用。
VLAct的核心设计:三重机制保障表示通用性
为破解上述困境,VLAct并未引入复杂的新架构,而是在continued pre-training阶段实施三项关键策略,确保Backbone学习到更具物理意义和跨域适应性的表示。
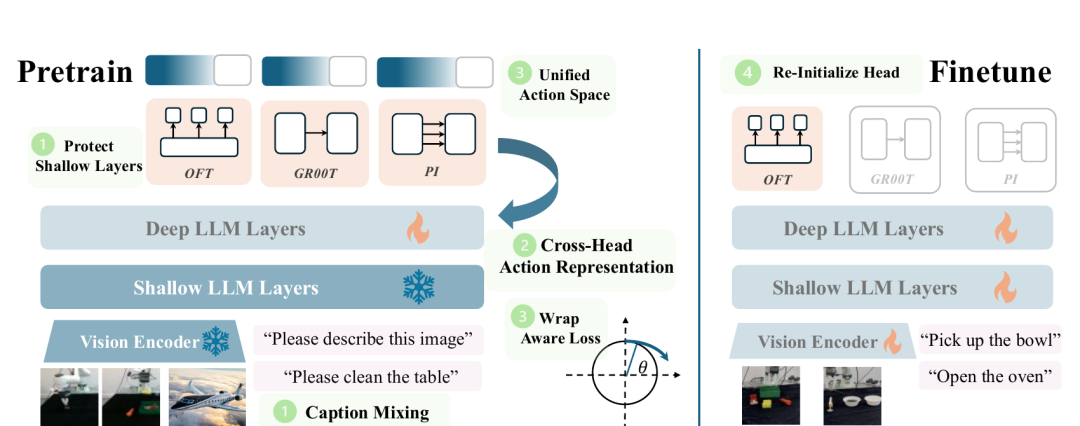
第一,保留VLM原始先验。机器人动作学习不应以牺牲基础视觉语言理解为代价。VLAct在训练中冻结Vision Encoder的大部分参数,并对LLM的浅层进行轻度更新,同时混入图像描述(Caption)数据。此举迫使模型在学习动作的同时,维持对物体属性、场景语义和指令理解的原始能力,避免“遗忘”通用知识。
第二,多头连续动作监督。VLAct在预训练阶段同时挂载OFT、PI和GR00T三种主流Action Head,要求它们共享同一个Backbone并预测同一套动作序列。由于不同Head对输入表示的偏好各异(如OFT关注轨迹平滑性,PI强调离散动作逻辑,GR00T侧重运动学约束),Backbone必须学习一种“折中”且信息丰富的中间表示,才能同时满足多方需求。值得注意的是,这些预训练Head在下游任务中会被完全丢弃,用户可自由初始化适合自身机器人的新Head,从而彻底解耦预训练与部署阶段的架构依赖。
第三,部分统一的动作语义空间。不同机器人本体(Embodiment)的动作维度存在共性与差异。例如,“夹爪开合”在Franka、AgileX或GR-1上具有相似物理含义,但关节自由度、运动范围和坐标系定义各不相同。VLAct对此采取“求同存异”策略:对语义一致的动作维度(如夹爪状态)进行标准化映射,而对本体特异性维度(如关节角)则保留原始编码。这种部分统一既促进了跨机器人知识迁移,又尊重了硬件差异,避免强行对齐导致的信息失真。
实验验证:高效迁移与跨域泛化
VLAct基于Qwen3-VL-4B底座,在LIBERO-Plus、RoboTwin 2.0、RoboDojo及RoboCasa-GR1等多个基准上进行了系统评估。
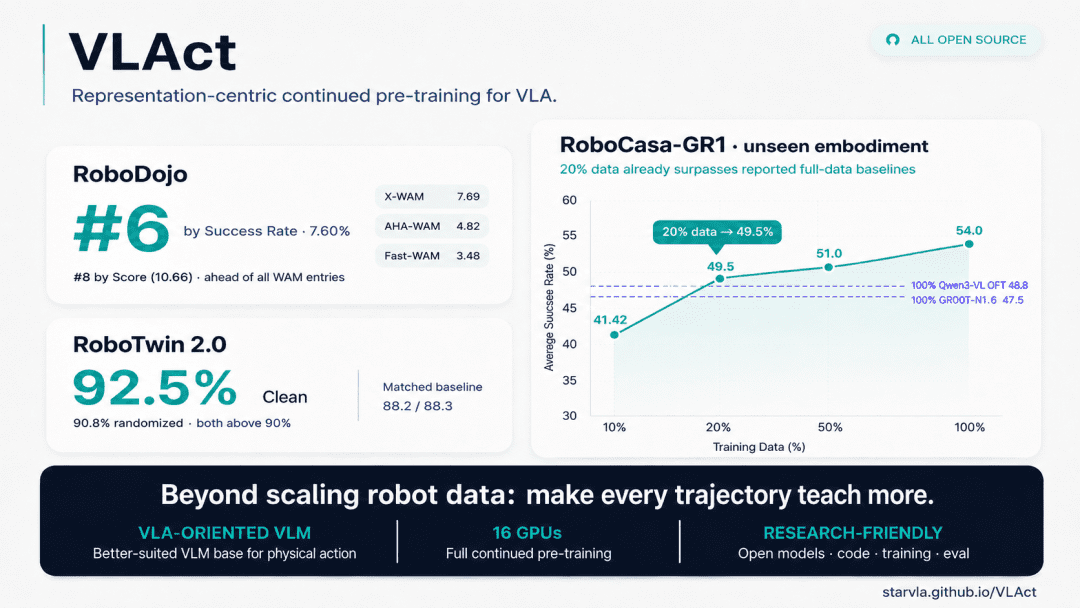
在LIBERO-Plus(涵盖日常家居操作任务)上,VLAct达到82.6%的成功率,显著优于同类方法。在更具挑战性的RoboTwin 2.0(双臂协同操作)中,其在Clean设置下成功率高达92.5%,Random设置下也达90.8%,证明其在复杂动作协调中的鲁棒性。
RoboDojo作为综合性机器人评测平台,VLAct取得10.66分和7.60%的成功率,超越所有明确标注为World Action Model(WAM)的参赛模型,表明其能力不仅限于特定仿真环境,具备广泛适用性。
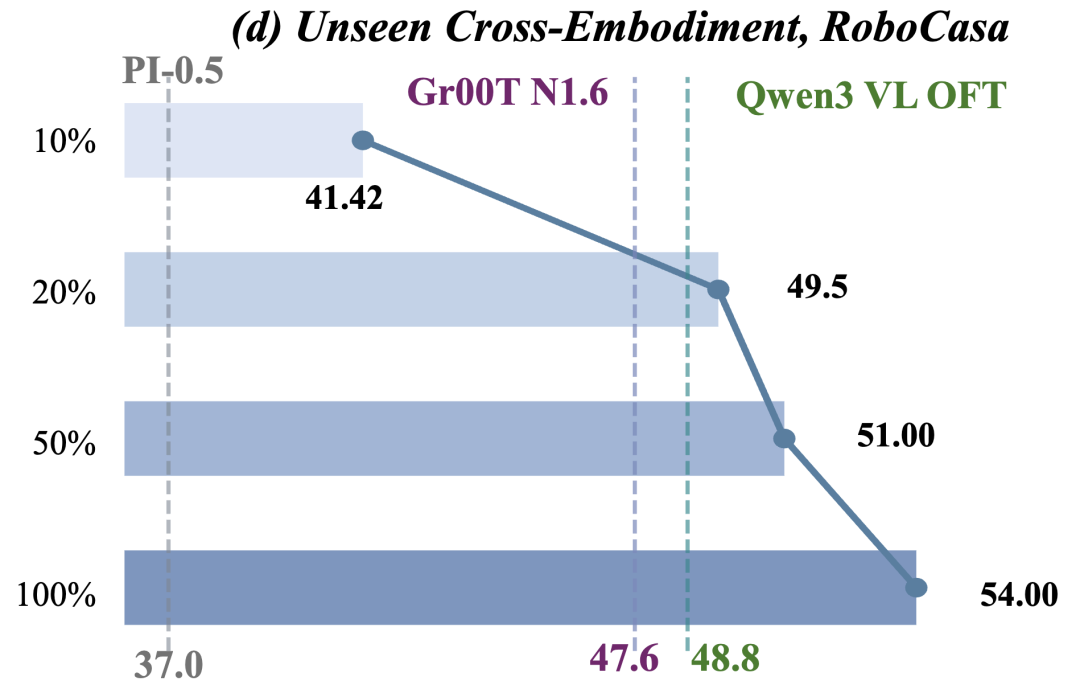
更关键的测试来自跨机器人迁移。在RoboCasa-GR1任务中,GR-1人形机器人从未出现在VLAct的预训练数据中——模型仅接触过Franka、AgileX等机械臂轨迹。令人惊讶的是,仅使用20%的GR-1下游微调数据,VLAct便达到49.5%成功率,超过NVIDIA GR00T N1.6和Qwen3VL-OFT使用100%数据的基线;当数据增至全量时,性能进一步提升至54.0%。这一结果强有力地证明了VLAct所学表示的高迁移价值。
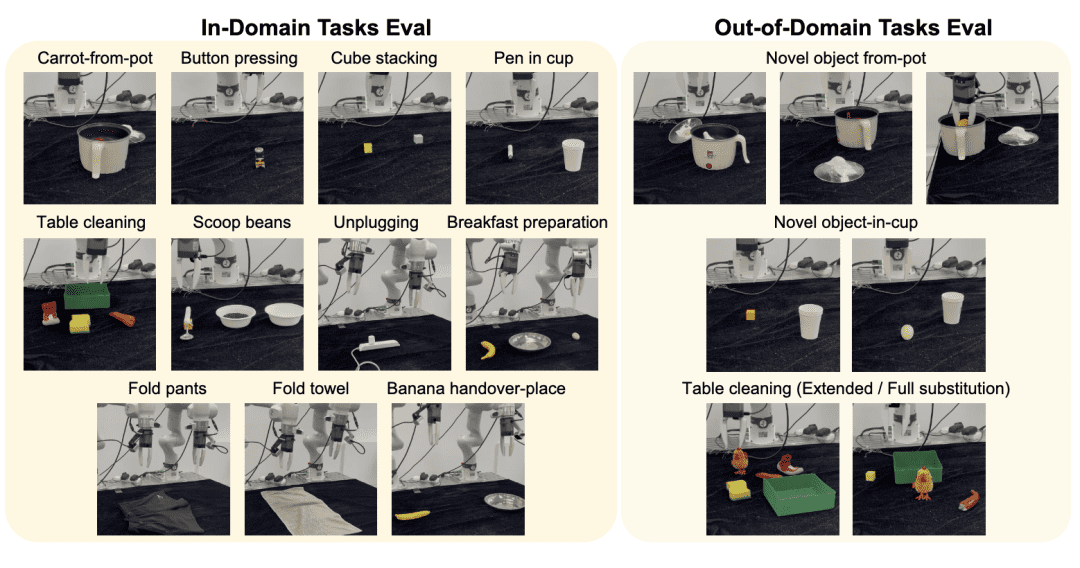
此外,团队还在Franka真机上验证了短时序、长时序、双臂协同及OOD(Out-of-Distribution)场景下的表现,涵盖新物体操作与完全替换任务组件等挑战,均展现出稳定性能。
超越数据规模:开启VLA的“表示效率”新维度
VLAct并非否定数据的重要性,而是指出:在机器人领域,数据效率(Data Efficiency)与表示质量(Representation Quality)应成为与数据规模并行的优化轴。由于真实世界无法被穷尽采样,模型必须从有限数据中提炼出可泛化的物理常识、动作语义和跨模态关联。
传统Scaling Law强调“更多即更好”,而VLAct倡导“更聪明地学习”。它通过架构无关的预训练范式,将VLM底座转化为一个面向物理世界的通用知识容器,使得后续针对任意机器人、任务或策略的微调都能站在更高起点。
值得一提的是,整个训练过程仅需16张GPU,且完全依赖公开数据集(如RoboSet、Bridge、DROID等),极大降低了研究门槛。模型权重、Checkpoint、数据处理脚本及训练Pipeline均已开源,为学术界和工业界提供了一个轻量、高效且可复现的VLA研究基座。
对未来机器人学习的启示
VLAct的成功揭示了一个重要方向:VLA的发展不应仅是“更大模型+更多数据”的线性延伸,而需深入思考表示学习的本质。如何让模型从有限交互中归纳出可迁移的物理规律?如何在保持通用感知能力的同时注入动作先验?这些问题的答案,或许比单纯扩大数据集更能推动机器人走向真实世界的部署。
随着开源生态的完善,VLAct有望成为新一代VLA研究的标准底座。其“表示为中心”的预训练理念,也可能启发其他具身智能领域,如自动驾驶、无人机控制等,重新审视数据利用效率与知识迁移机制的设计。
最终,让每一条昂贵的机器人轨迹都“学有所值”,不仅是技术优化,更是对资源稀缺现实的理性回应。在通往通用机器人的道路上,VLAct迈出了从“量”到“质”的关键一步。