AI「心电感应」突破:Mostik如何用隐藏状态桥接大小模型?
在人工智能领域,衡量模型智能的标准正经历一场静默但深刻的变革。传统基准测试依赖预设问题与标准答案,而新一代挑战如Kaggle上的ARC-AGI-3,则将AI置于一个无规则、无提示的陌生二维世界中,要求其自主探索、建模并解决问题。这种设定更接近人类面对未知时的认知过程,也因此被视为检验“真正智能”的试金石。正是在这一高难度竞技场上,一家名不见经传的俄罗斯初创公司——Mostik,以惊人速度冲至排行榜前列,引发业界广泛关注。
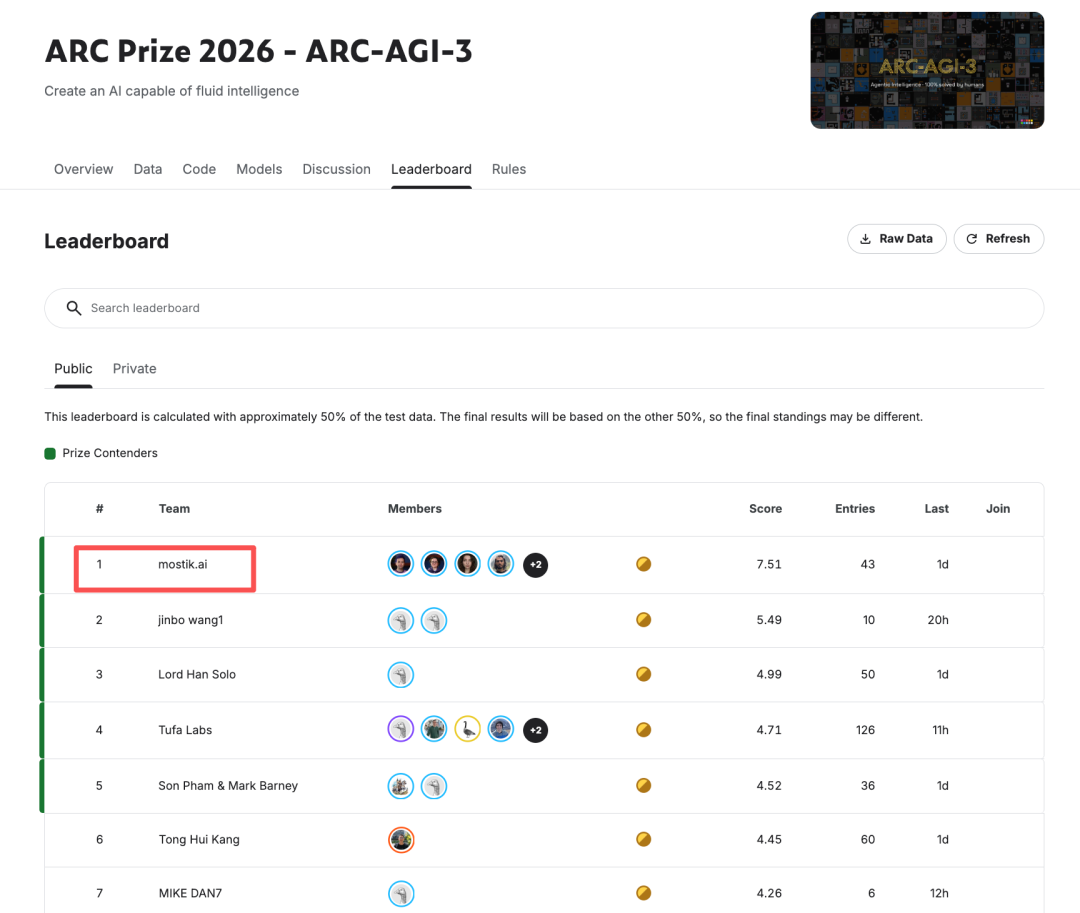
Mostik的崛起不仅因其竞赛成绩,更源于其背后一项颠覆性的技术理念:让AI模型跳过低效的文字交流,直接在数学空间中“心电感应”。这一构想看似科幻,却建立在对当前AI协作模式根本缺陷的深刻洞察之上。
传统多智能体系统的“钥匙孔瓶颈”
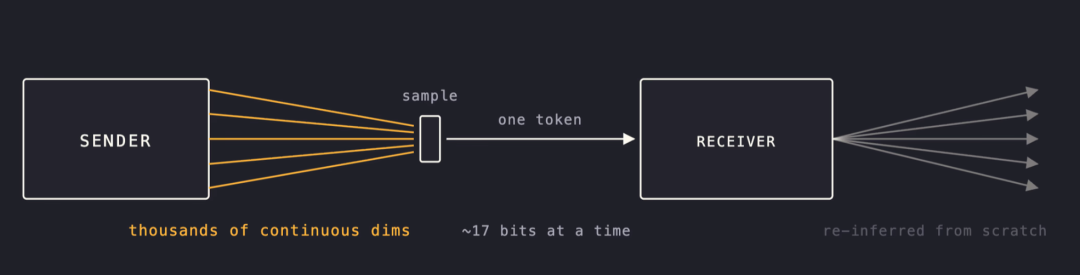
当前主流的多智能体协作方式,本质上是“文本接力”。一个模型生成一段文字输出,另一个模型将其作为输入继续处理。这种方式直观且易于实现,却存在致命的信息损耗。Mostik团队在其官方博客中用一组数据揭示了这一问题的严重性:当一个语言模型生成一个token(词元)时,其内部会激活数百个隐藏层,产生近百万个浮点数值,总信息量接近2MB。然而,最终输出的仅是从约15万个候选词中选出的一个词元,所携带的有效信息不足17比特。
这意味着,模型在高维空间中构建的丰富语义表征、对上下文的深层理解、甚至对后续内容的预判,几乎全部在输出瞬间被丢弃。Mostik形象地将此比作“一个在上千维空间思考的系统,只能通过钥匙孔与外界对话”。这种信息压缩不仅浪费了大量计算资源,更限制了协作智能的上限。无论是编程智能体、模型委员会,还是复杂的推理链系统,都难以逃脱这一“钥匙孔瓶颈”。
隐藏状态:被忽视的AI“潜意识”
过去,人们常将模型的隐藏状态视为临时计算的中间产物,认为只有最终输出的文本才是“成品”。然而,近年来的可解释性研究不断推翻这一认知。例如,在英语冠词选择任务中,模型必须提前预知后续名词才能正确使用“a”或“an”。研究人员发现,Qwen-3在实际输出“accountant”之前数个位置,其内部已形成对该词的稳定表征。类似地,Anthropic的研究显示,Claude 3.5 Haiku在写诗时,会先在内部确定押韵词,再反向构建前文。
这些现象表明,大模型在“落笔”前已进行大量隐式规划。其内部状态不仅包含当前词的预测,还承载着对未来的预期、对概念的暂存,甚至未被言明的逻辑链条。当这些信息被迫压缩为线性文本时,协作的另一方无法还原原始意图,导致效率低下甚至误解。因此,Mostik的核心洞见在于:AI之间真正需要共享的,不是答案本身,而是形成答案的过程。
构建“小桥”:跨模型隐藏状态的翻译器
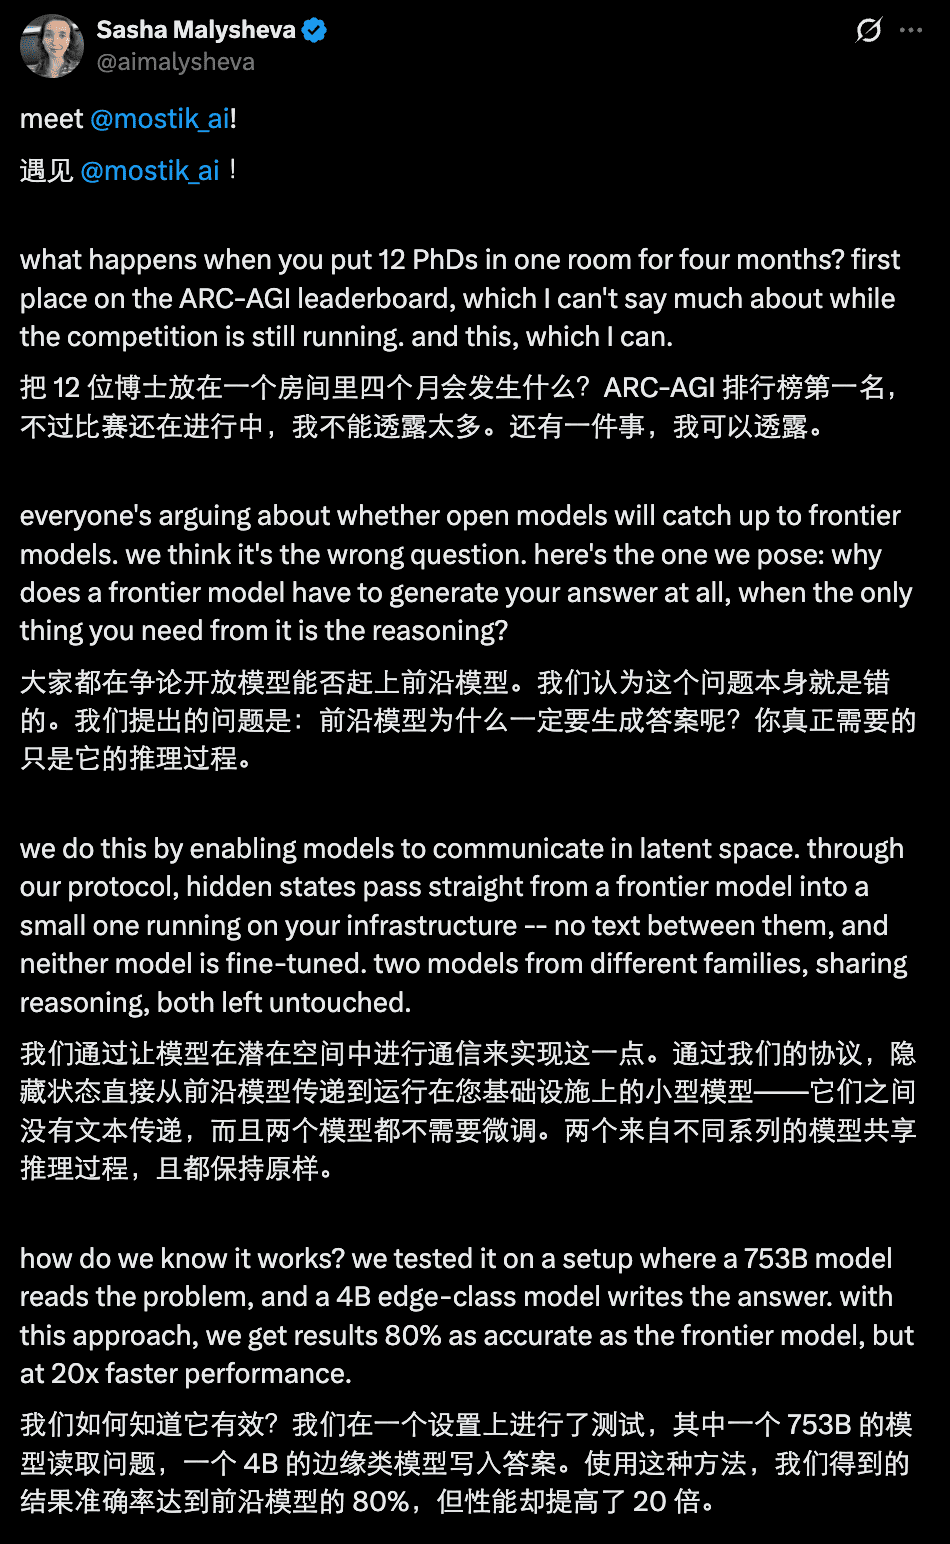
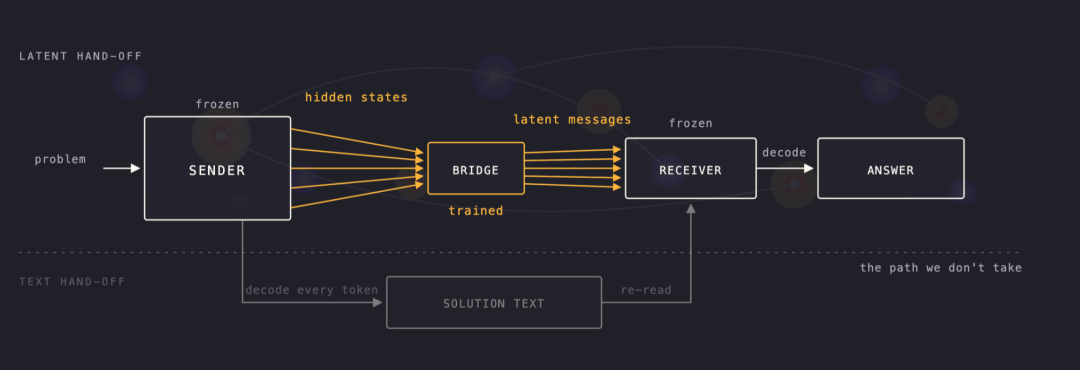
Mostik的解决方案简洁而巧妙:在两个冻结的预训练模型之间,训练一个轻量级的“桥”(bridge)模块,用于转换和传递隐藏状态。以GLM-5.2(7530亿参数)与Qwen-3.5(40亿参数)为例,大模型负责读取问题并完成初步推理,随后将其最后一层的隐藏状态输入“桥”;“桥”将其映射到小模型的表示空间,Qwen-3.5则基于此状态直接生成最终答案。
这一设计的关键在于无需修改任一模型的原始权重。由于不同模型由不同团队开发,其内部几何结构差异巨大——同一概念在各自向量空间中的位置可能毫无关联。Mostik团队,尤其是首席科学家、菲尔兹奖得主Stanislav Smirnov,专注于研究这些高维空间的拓扑特性。他们发现,尽管模型能力增强不会自动对齐内部表征,但不同模型间仍存在可学习的局部同构结构。通过监督学习,“桥”能够学会在这两种异构空间之间建立可靠的映射关系。
性能与成本的双重突破
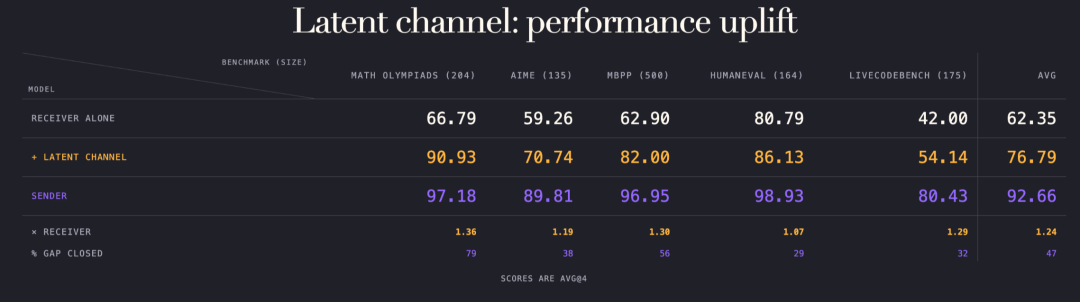
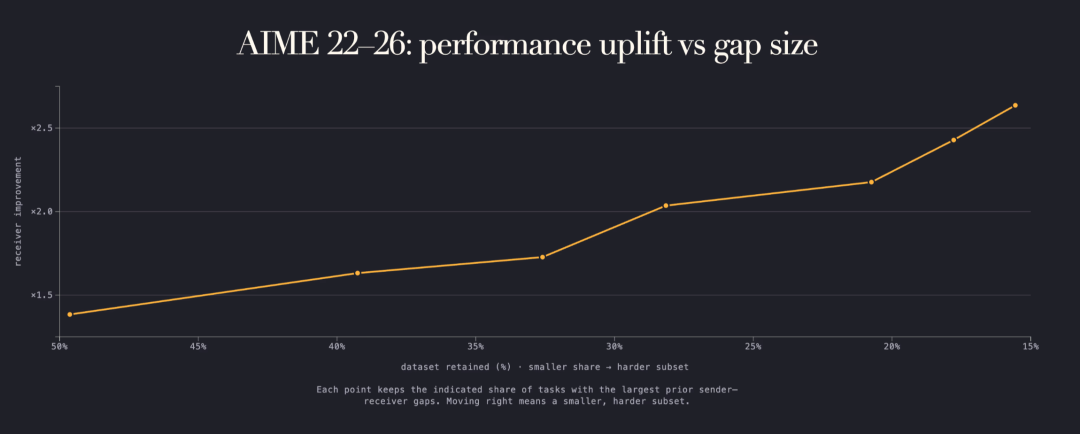
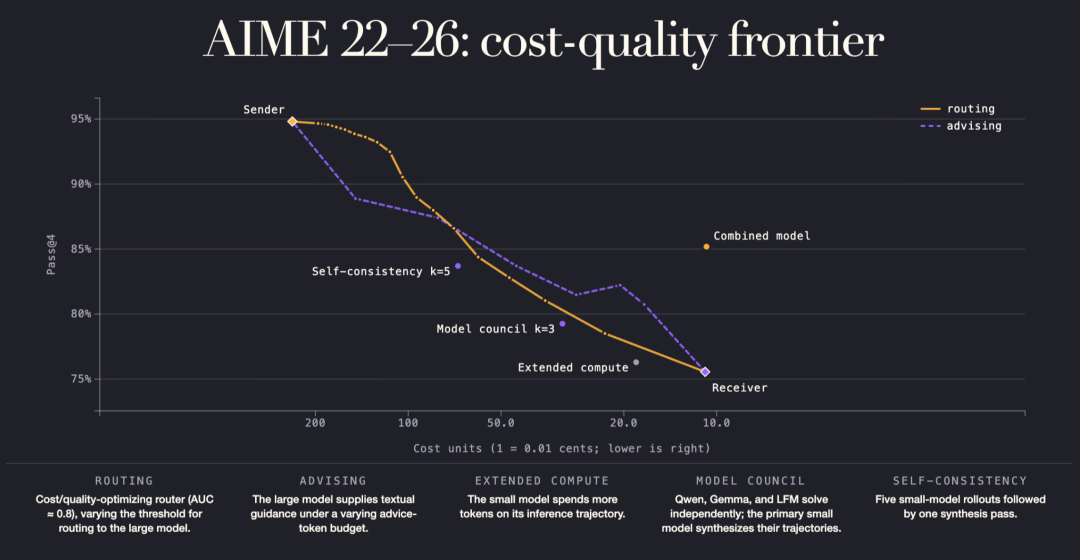
实验结果令人振奋。在ARC-AGI-3相关任务上,采用“桥接”方案的Qwen-3.5整体准确率提升约25%,在高难度子集中甚至达到原性能的两倍,相当于弥补了与GLM-5.2之间50%的能力差距。更关键的是成本效益:整个混合系统的计算开销仅为GLM-5.2独立完成任务的1/20。若与一个性能相当的中型模型相比,算力消耗也节省了60%。
这种优势源于任务分工的优化。大模型擅长并行处理输入(“读”),而小模型承担串行生成(“写”)——后者通常更耗时且昂贵。“桥接”让昂贵的大模型仅做高价值判断,将繁琐的文字输出交由廉价的小模型执行,实现了资源的最优配置。
交接时机:越早越好
Mostik进一步对比了“隐藏状态交接”与“文本交接”在不同推理阶段的效果。结果显示,在任务早期(大模型尚未输出任何文字时)进行状态传递,性能增益最为显著,最高领先文本方案10个百分点。随着大模型生成更多文本,两种方法的差距逐渐缩小,但隐藏状态方案始终维持优势。这印证了早期内部状态已包含丰富语义信息,而文本在此时尚为空白。
超越协作:通往可解释性的新路径
除提升性能外,Mostik认为“桥”还为AI可解释性研究提供了独特工具。传统方法依赖分析模型输出的思维链(Chain-of-Thought),但模型可能隐藏真实推理逻辑,或绕过监控生成误导性解释。而“桥接”过程提供了三个可观测节点:发送端原始状态、桥转换后的状态、接收端行为输出。通过记录三者,研究人员可追踪信息流动,并通过干预特定特征观察行为变化,从而建立因果关联。
例如,若修改桥输出中的某个维度后,小模型持续改变某类决策,则可推断该维度与该决策强相关。这种方法比将隐藏状态“翻译”成人类语言更可靠,因为它不依赖可能失真的自然语言解释器,而是直接验证因果效应。
未来方向:从推理协作到联合训练
目前的“桥”建立在已训练好的模型之上。Mostik的下一步计划是将这一机制前置至训练阶段。其一为增强型知识蒸馏:教师模型在学生生成每个token时,实时提供隐藏状态指导,而非仅在最终输出后打分。初步实验显示,此法可在相同预算下训练出更接近教师能力的学生模型。其二为专业化模块集成:通用大模型可外挂针对特定领域(如生物、法律、代码)训练的小模型,通过隐藏状态通道即时调用专业能力,避免重训整个系统。
更重要的是,该架构天然支持多模型扩展。一座“桥”可连接多个模型,形成动态协作网络。这预示着一种新的AI发展范式:强大智能不再依赖单一超大规模模型,而是由一群各有所长的模型高效协同而成。
开源生态的新机遇
对开源社区而言,Mostik的方案极具吸引力。当前开源模型多为中小规模,难以与闭源巨模型竞争。但若能通过“桥”接入更强模型的内部表征,其竞争力将大幅提升。这或将重塑AI能力的评价标准——不再唯参数论,而更看重协作效率与接口开放性。
当然,挑战依然存在:不同架构(如Transformer与Mamba)间的桥接稳定性、桥的训练成本、跨公司模型的接口开放意愿、以及隐藏状态的安全传输等问题,尚无成熟解决方案。但Mostik已提出一个无法回避的问题:如果大模型内部蕴含的信息远超其文本输出,我们为何还要强迫AI用如此低效的方式“交谈”?
或许,下一代强大的AI系统,将不再是孤独的超级大脑,而是一群沉默却默契的合作者——它们无需言语,事情已然办妥。