智象发布具身世界模型 HiDream-O1-Embodied,登顶 RoboColiseum 扰动适应榜单
具身世界模型:从像素模拟走向物理行动
过去几年,Genie、Sora 和 WorldLabs 等系统把视觉世界模型推到了新高度。它们能生成逼真的视频,甚至模拟复杂场景的动态演化。但仔细看会发现,这些模型本质上仍是统计意义上的视觉模拟器——擅长排列像素,却不理解物理规律或因果逻辑。
真正的跃迁正在发生。具身世界模型(Embodied World Models)成为全球 AI 大厂的新焦点。这类模型不再满足于“看懂”世界,而是要“在世界中行动”。它直接与物理世界的规则对齐,把视频生成能力转化为动作控制能力。比如:一个球被抛出后如何下落?机器人抓杯子时液体会不会洒?捏生鸡蛋需要多大力?这些看似简单的问题,背后是对物理规律的本质抽象,也是连接数字仿真与现实操作的关键桥梁。
谷歌、英伟达、特斯拉已纷纷布局,或打造仿真训练平台,或自研机器人基座模型。而在这场技术竞速中,中国团队也在快速跟进。
智象发布 HiDream-O1-Embodied,登顶 RoboColiseum 扰动适应榜
近日,智象未来(HiDream.ai)正式发布具身世界模型 HiDream-O1-Embodied。该模型延续其“原生全模态”技术路线,强化机器人在物理环境中的感知、预判与执行能力,目标是实现更高阶的物理交互。
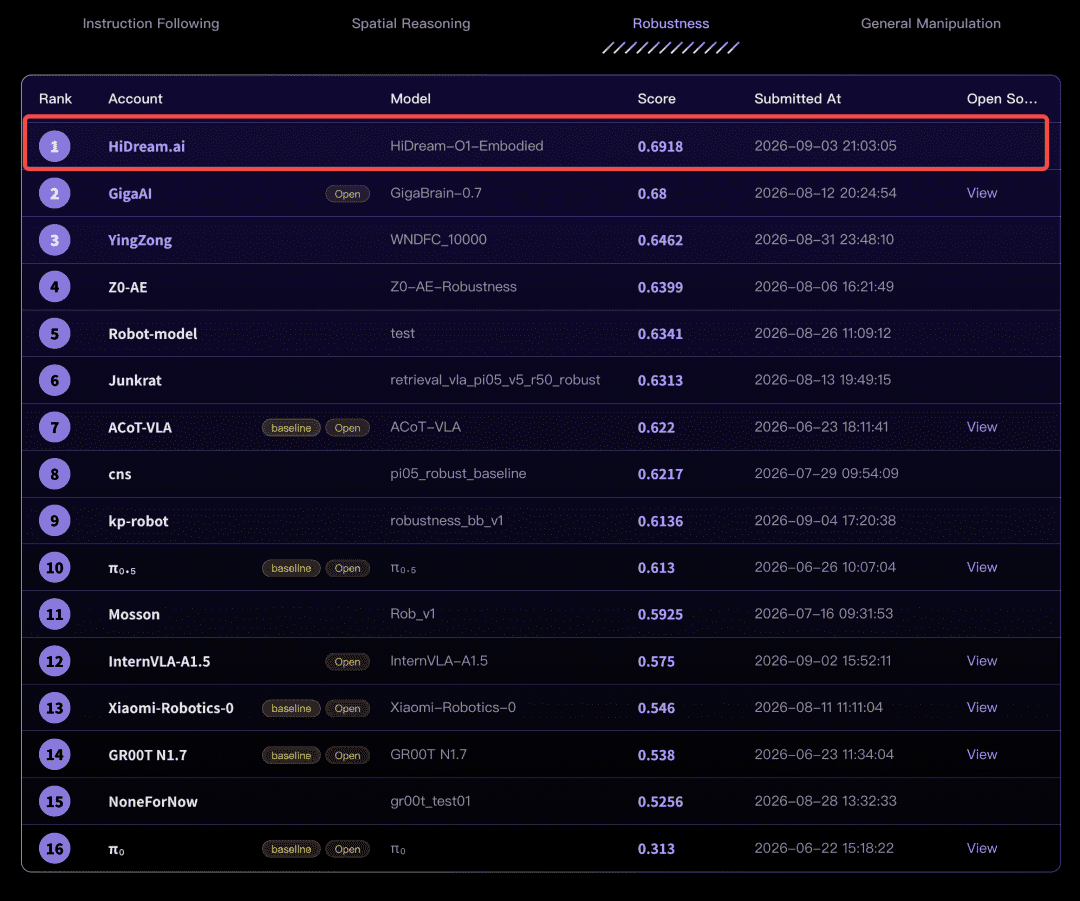
发布同期,HiDream-O1-Embodied 首次参与具身智能评测平台 RoboColiseum 的评估,并在最具挑战性的 Robustness(扰动适应) 子榜单中以平均分 0.692 登顶第一。
智象未来 CTO 姚霆表示:“我们相信,完整的世界模型基座必须同时具备全模态表达、因果推演与物理世界构建三大核心能力。HiDream-O1-Embodied 的发布,标志着我们的技术战略从‘模拟世界’迈向‘真实世界’的关键一步。”
RoboColiseum:不在温室里考试,而在意外中检验真本事
RoboColiseum 是一个常态化具身智能仿真评测平台,旨在通过高保真仿真环境,构建与真实机器人表现高度一致的评估体系。平台面向全球开放,设有四大能力维度:指令跟随、空间理解、扰动适应与通用操作,共包含 78 个高保真任务。
其中,扰动适应被公认为最难的一环。它通过改变背景、光照、材质、机器人初始状态、相机位置、图像质量,甚至对指令进行多样化改写,来测试模型在非理想条件下的稳定性与泛化能力。
这不像实验室里的标准测试,更像是在真实世界中应对各种“意外”——比如突然的光线变化、部分视野被遮挡、物体表面反光干扰等。能在这种环境下稳定完成任务,才说明模型真正具备了落地潜力。
HiDream-O1-Embodied 能在这一维度登顶,得益于其原生全模态底座和三项关键技术突破。
语言理解:穿透字面,直达意图
传统机器人系统对语言指令的理解往往停留在关键词匹配层面。说“把杯子拿过来”能执行,换成“给我拿个杯子”或“杯子递我一下”,就可能失效。
HiDream-O1-Embodied 则构建了一个覆盖多元动词、句式与表达方式的等价指令空间。它不被具体措辞束缚,而是聚焦用户的真实意图。无论指令如何变换,模型都能准确解析并执行对应动作。
这种能力不是靠规则硬编码,而是通过大规模多模态对齐训练实现的。语言、视觉与动作在统一表征下深度融合,让模型学会“听懂话外之音”。
视觉感知:多视角协同,避免单点失效
在真实环境中,机器人的视觉输入从来不是完美的。相机可能偏移,标定会漂移,单路画面可能被遮挡或受干扰。如果系统只依赖一个固定视角,一旦该视角失效,整个任务就会中断。
HiDream-O1-Embodied 采用多视角协同感知机制。它综合来自不同摄像头的信息,让各视觉通道相互补充、交叉验证。即使某一视角暂时不可用,模型仍能基于其他视角重建场景理解,继续执行任务。
这种设计让系统从“一处失灵、全局崩溃”转变为“局部受限、整体仍可运行”,显著提升了鲁棒性。
高容错机制:在不完美中学会稳定
大多数模型训练依赖“干净数据”——清晰图像、标准视角、无遮挡场景。但现实世界充满噪声:光照突变、镜头污损、信号延迟、物体部分遮挡……这些都是日常。
HiDream-O1-Embodied 在训练阶段就主动引入大量非理想条件。模型反复面对不完整、不稳定的信息,并学习如何从有限线索中做出可靠判断。这种训练策略让它不仅追求“理想状态下的最优解”,更重视“复杂环境中的持续可用性”。
例如,在“pick block shape”任务中,机器人需根据指令(如“右臂拿起桌面上的三棱柱”)完成抓取。测试故意加入光影晃动、局部遮挡和纹理混淆等干扰。结果显示,HiDream-O1-Embodied 多数情况下能一气呵成完成“识别—定位—抓取”,操作扎实,感知精准。
模型 + 数据:打造“真实基座 + 生成增强”飞轮
这种抗干扰能力并非凭空而来,其背后是一套创新的数据生产范式:真实基座 + 生成增强。
高质量具身数据极其稀缺。智象选择与诺亦腾合作,利用其高精度真人动作捕捉数据作为“真实基座”。在此基础上,借助原生全模态能力,对单段真实动作进行百倍级精细化扩增。
扩增不是随意生成,而是在严格遵守物理约束的前提下,变换背景、光照、物体形态等变量,产出海量符合物理规律的训练样本。模型既是“考生”,也是“出题人”——它根据自身短板主动生成针对性数据,形成模型与数据互相驱动的增长飞轮。
这种闭环机制,让 HiDream-O1-Embodied 在面对现实扰动时展现出超常的鲁棒性。
原生全模态矩阵逐步成型
值得注意的是,HiDream-O1-Embodied 并非孤立产品。不到一个月前,智象刚发布交互式世界模型 HiDream-O1-World,并在 WBench 评测基准的 Navi 分榜中以 80.9 分登顶。
两者分工明确:交互式世界模型解决“理解与推演”,让 AI 在数字世界中掌握空间、时间、运动与物体关系;具身世界模型解决“操作与执行”,让 AI 在物理世界中完成真实任务。二者互补,共同支撑原生全模态世界模型的发展。
从 HiDream-O1-Image(图像生成)到 HiDream-O1-World(交互推演),再到 HiDream-O1-Embodied(物理执行),智象正逐步构建覆盖视觉、交互、具身的模型家族矩阵。这不仅是技术能力的横向扩展,更是内生进化能力的体现。
世界模型的下一场竞争在物理世界
具身智能的核心,是让 AI 真正踏入现实,在充满不确定性的物理环境中持续学习与自适应。从早期的符号推理,到数据驱动的大模型爆发,再到如今面向实体交互的具身范式,通用人工智能正完成从虚拟走向现实的关键演进。
AI 不再只是“看懂世界”,而是要“在世界中行动,在交互中成长”。这场演进的主战场,终将落在真实物理场景之中。而中国企业,显然已准备好参与这场竞争。