Looped Transformer 真的有效吗?清华与字节新研究用公平实验给出答案
不靠堆参数,靠“多跑一遍”:Looped Transformer 的争议
过去几年,大模型能力提升几乎等同于“做大”:更多参数、更多数据、更多算力。但最近,一种新思路开始冒头——与其不断加层,不如让已有的层再跑一遍。这就是 Looped Transformer。

普通 Transformer 每一层只执行一次,而 Looped Transformer 会把中间某些层重复执行多次。这样,模型在不增加参数的情况下,获得了更深的计算路径。听起来很聪明,也确实在推理、数学等任务上展现出潜力。
但一个关键问题一直悬而未决:这些收益,到底是循环结构本身的功劳,还是仅仅因为多算了几次、实际上用了更多算力?
如果只是后者,那 Looped Transformer 就没什么特别——你完全可以拿省下的算力去训练一个更宽或更深的普通模型。要回答这个问题,必须做公平比较:控制住算力、参数量和 KV cache 这三个变量。
清华大学、字节跳动 Seed 团队在论文《SMELT》中,首次做到了这一点。
公平比较怎么做?
公平实验的核心在于同时对齐三个维度:
- 每 token FLOPs:决定训练和推理成本;
- 总参数量:约束模型的知识容量;
- KV cache 大小:限制可服务的上下文长度。
难点在于,Looped 架构天然会增加 FLOPs(因为重复计算),但又不增加参数。所以,直接对比不公平。
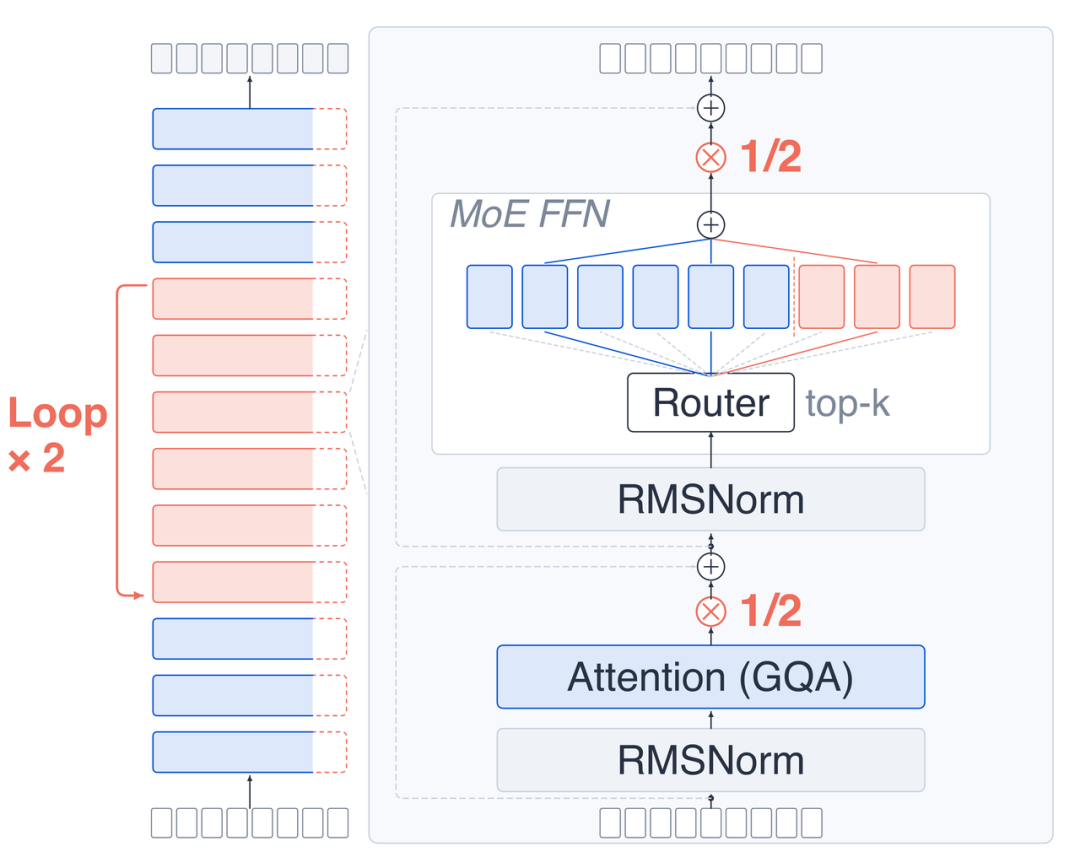
论文的解法很巧妙:用 稀疏 MoE(Mixture of Experts) 把参数量和计算量解耦。具体操作分三步:
- 缩窄或变浅模型,以抵消 Loop 带来的额外 FLOPs;
- 增加专家数量,补回被缩掉的总参数量;
- 调整注意力配置(比如 GQA Ratio 或 Head Dim),让 KV cache 大小保持一致。
这样一来,一对基线模型和 SMELT 模型就在完全相同的预算下运行,差异只在于是否使用循环。
最佳循环配方长什么样?
在小规模模型上,团队系统搜索了循环策略的三个关键变量:循环哪部分层、执行深度与宽度的比例、循环几次。
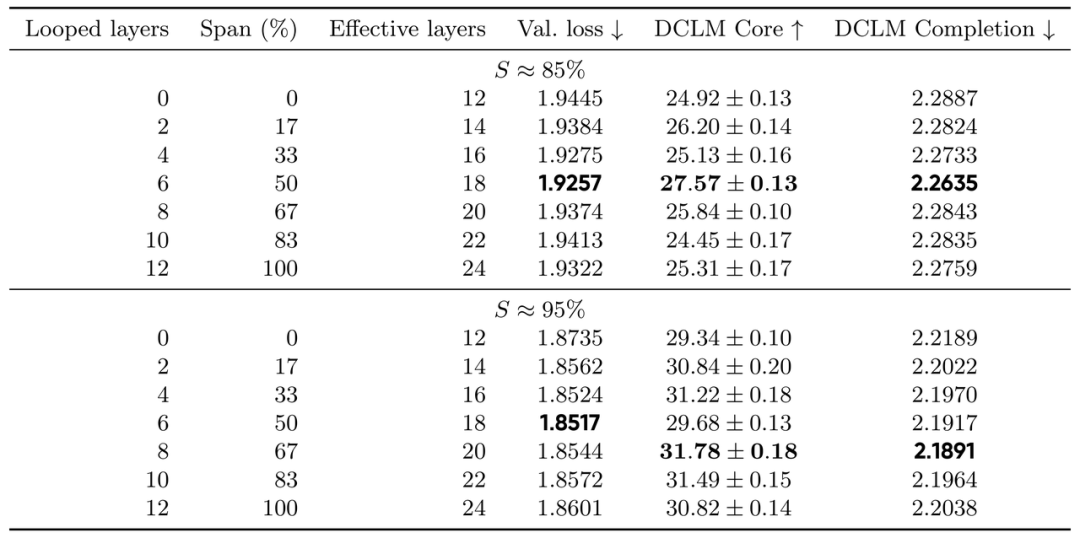
循环中间 50% 的层效果最好
他们尝试从 0%(不循环)到 100%(全循环)的不同比例,发现中间约一半的层循环时,验证损失最低。这说明模型首尾的层可能承担特殊功能——开头负责输入编码,结尾负责输出预测——保留独立参数比参与共享更有利。
Looped 模型更适合“更深”的配置
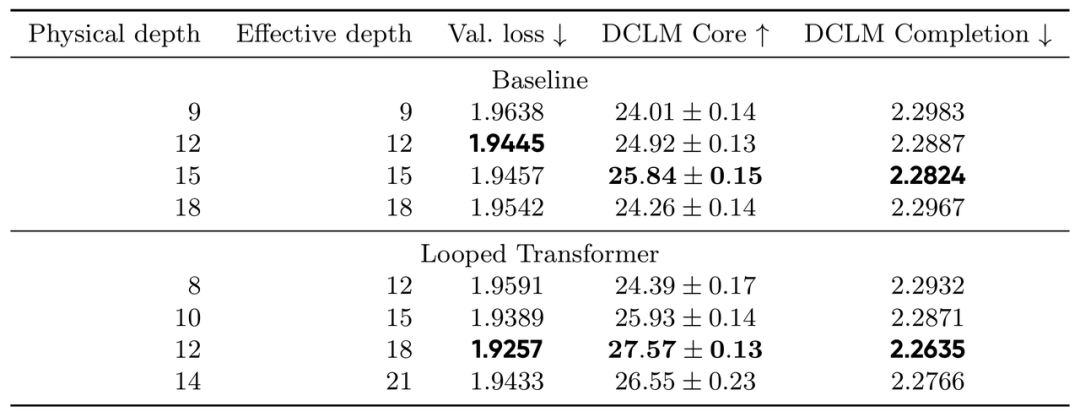
固定循环 50% 的层后,团队比较了不同“执行深宽比”(即实际执行的深度与模型宽度之比)。结果发现,Looped 模型的最优深宽比明显高于非 Looped 模型。
原因可能是:循环带来的额外深度不引入新参数,同一组共享参数能同时接收“浅层”和“深层”的梯度信号,反而更容易训练出有效表征。
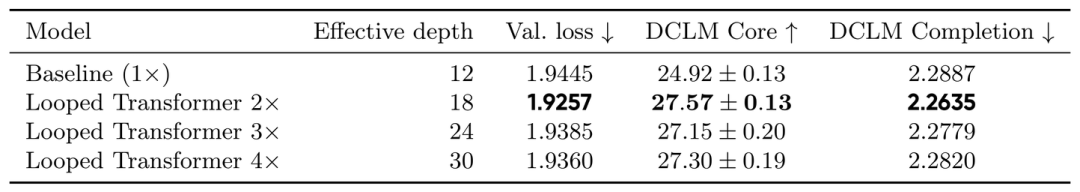
循环两次就够了,再多反而退步
在 FLOPs 严格匹配的前提下,循环次数越多,模型就必须缩得越窄。实验显示,循环两次时性能达到峰值;三次或四次时,模型因过窄而性能下降。
综合这三条,团队将最终方案命名为 SMELT:在稀疏 MoE 模型中,将中间 50% 的层循环执行两次,并采用更大的执行深宽比。
Scaling Law 证明:SMELT 确实更高效
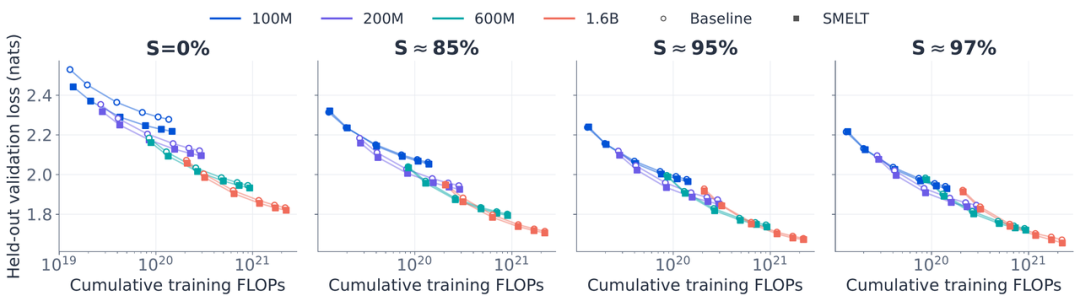
为了验证 SMELT 是否在更大规模上依然有效,团队将其扩展到四个激活参数规模(100M / 200M / 600M / 1.6B),并在每个规模下设置四种稀疏度(通过增加专家数提高总参,最大达 54B),共训练了 16 对匹配模型。
结果很清晰:在全部 16 种配置中,SMELT 的验证损失都低于基线。
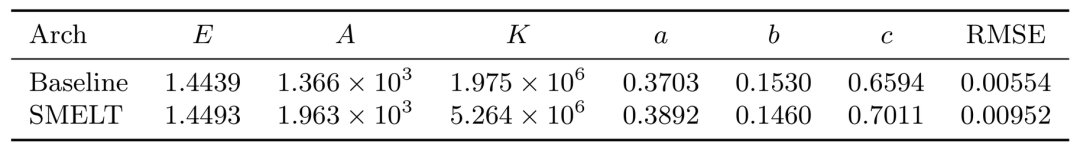
进一步,他们为两种架构分别拟合了 Chinchilla 式的 Scaling Law。拟合结果显示,SMELT 的容量指数(a)和数据指数(c)均大于基线,意味着它的损失随算力和数据增长下降得更快。
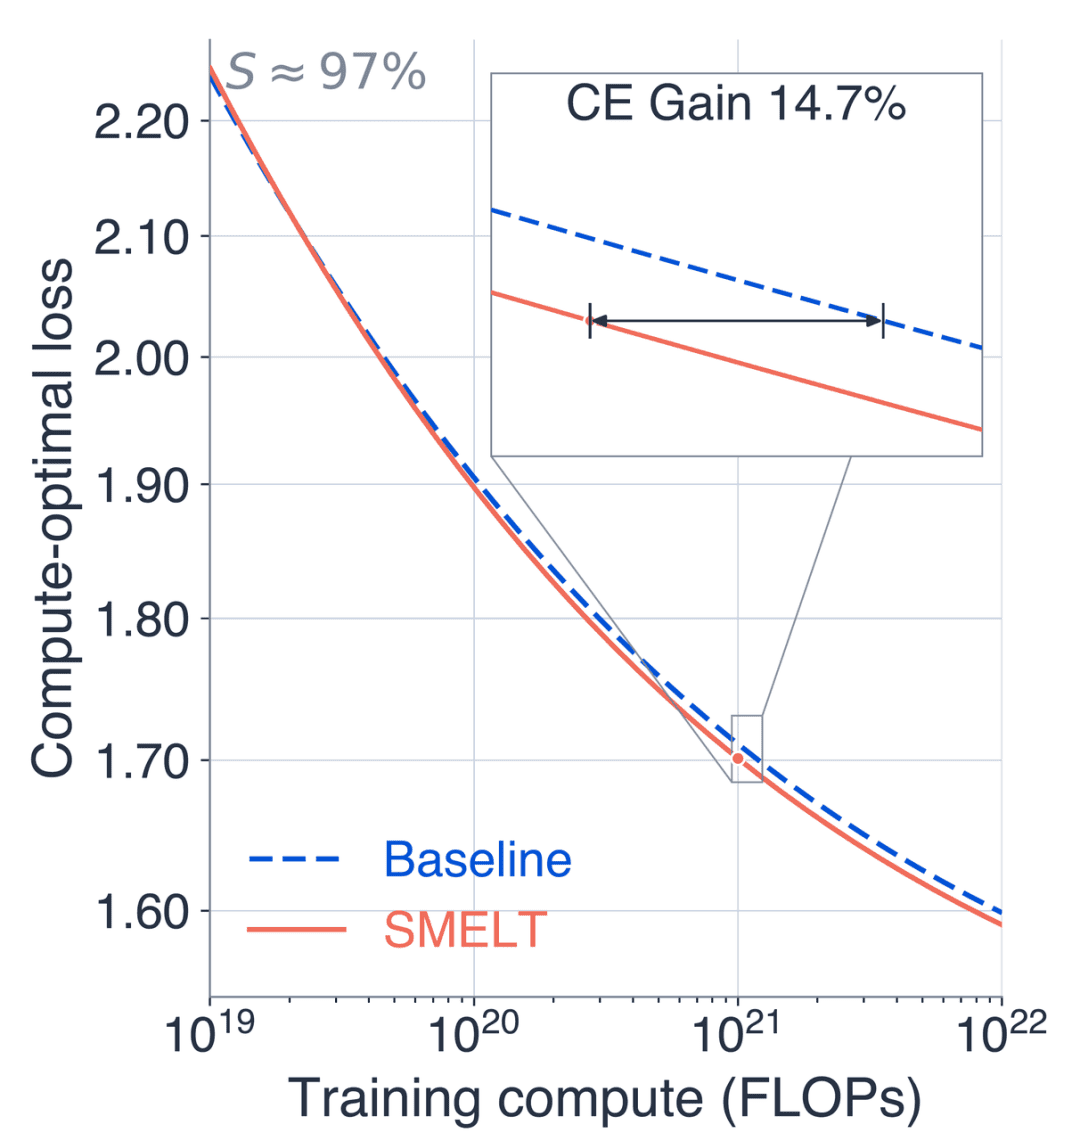
在计算最优前沿上,SMELT 达到相同损失所需的训练算力始终更少,节省幅度在 6.8% 到 18.0% 之间,且随算力预算增大而扩大。例如在 10²¹ FLOPs 规模下,可节省 14.7% 的训练计算量。
下游任务:不只是 loss 低,能力也更强
更令人意外的是,SMELT 的优势不止体现在验证损失上。
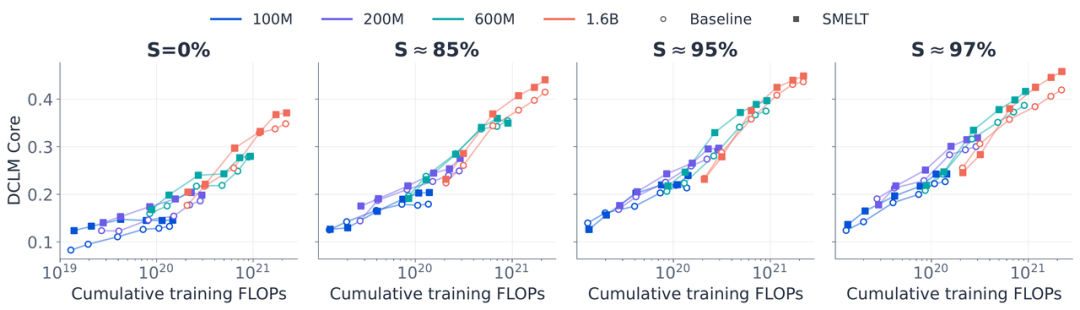
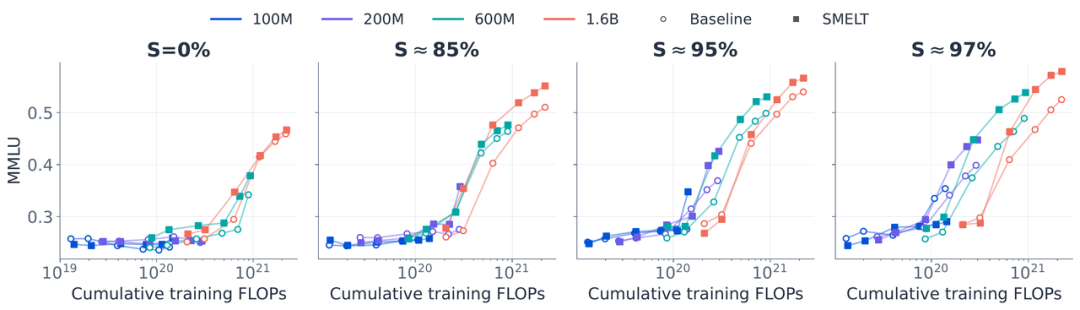
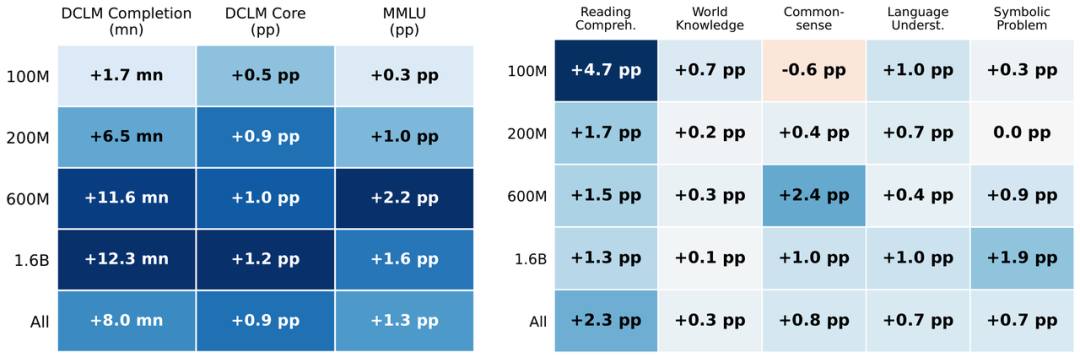
在 DCLM 和 MMLU 等下游任务评测中,SMELT 在 96 组配置中的 83 组上取得更高分数,在 MMLU 明显高于随机水平的 30 组中,29 组胜出。
关键来了:团队先用基线模型拟合了“验证损失 vs. 下游分数”的关系曲线,再把 SMELT 的数据点画上去。结果发现,即使验证损失相同,SMELT 的下游分数也普遍更高,且差距随模型规模增大而拉大。
这说明,循环带来的不仅是更优的损失,还是一种更高质量的内部表征。
哪些任务受益最多?
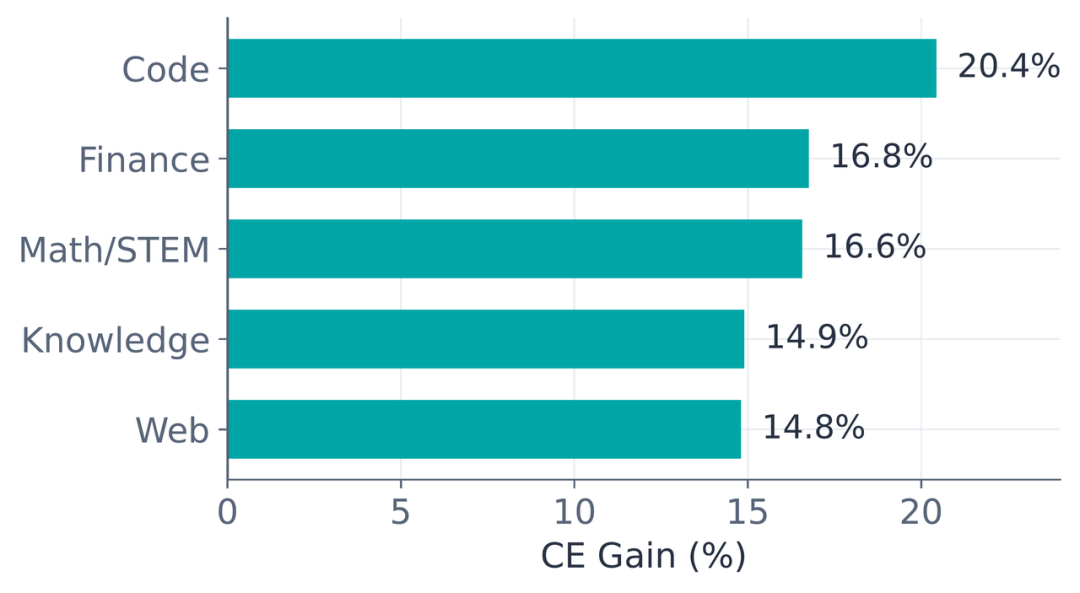
分析显示,SMELT 的收益在不同任务上分布不均:
- 领域差异:结构化程度越高的数据,收益越大。代码任务领先,金融、数学/STEM 次之,普通网页文本最低。
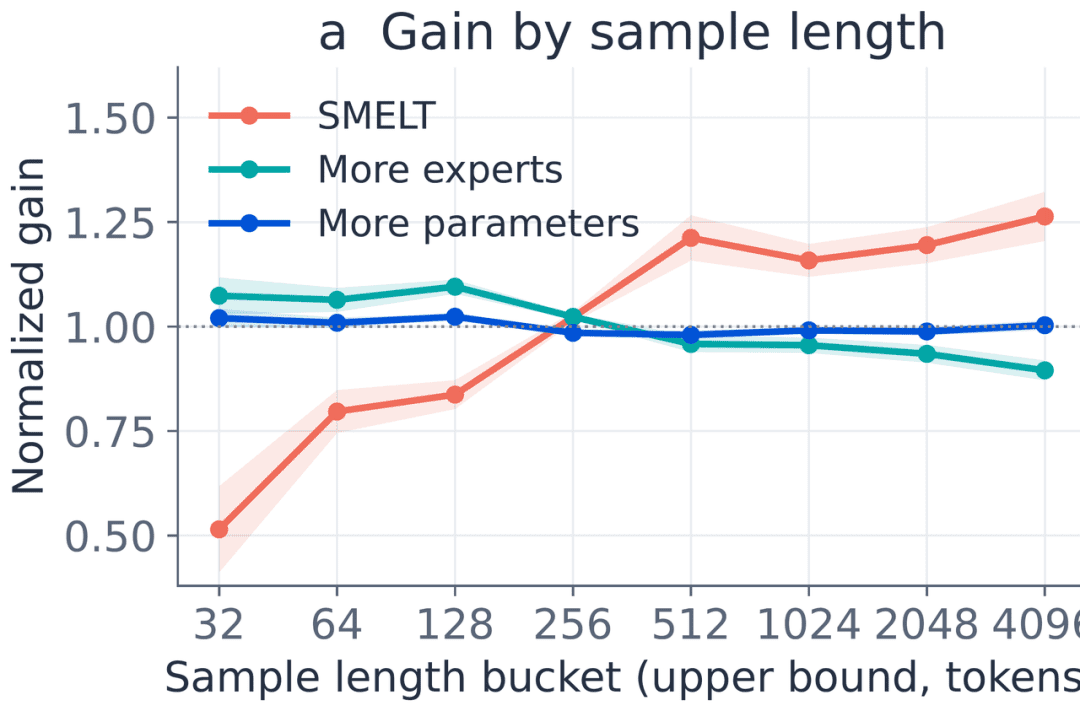
- 长度效应:长文本的收益显著高于短文本。值得注意的是,单纯增加专家数并不会产生这种长度偏好,说明这是循环机制特有的性质。
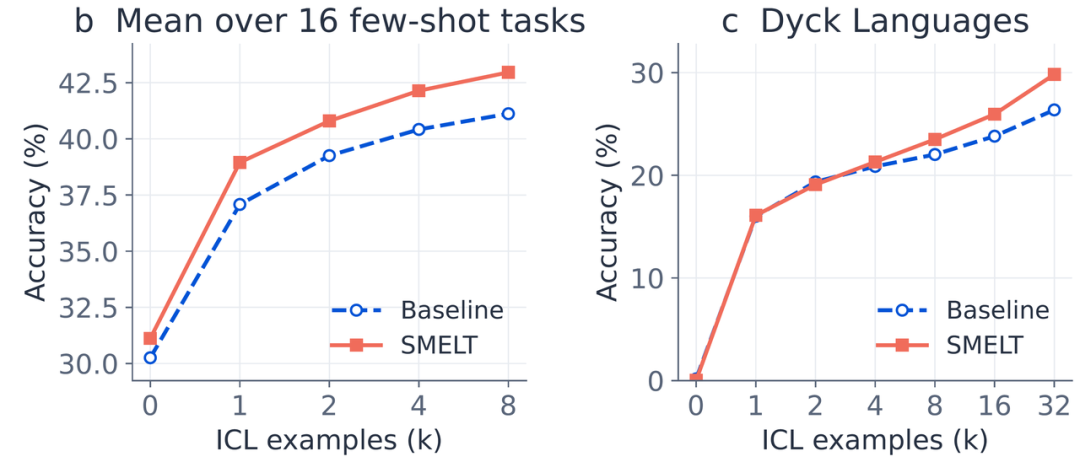
- 示例依赖:在需要 in-context learning 的任务中,给出的示例越多,SMELT 优势越明显。在 Dyck Languages(括号匹配)这类高度依赖示例的任务上,提升尤为突出。
循环内部发生了什么?
为了理解循环为何有效,团队从三个角度分析了第二次执行与第一次的差异。
专家路由:复用+探索
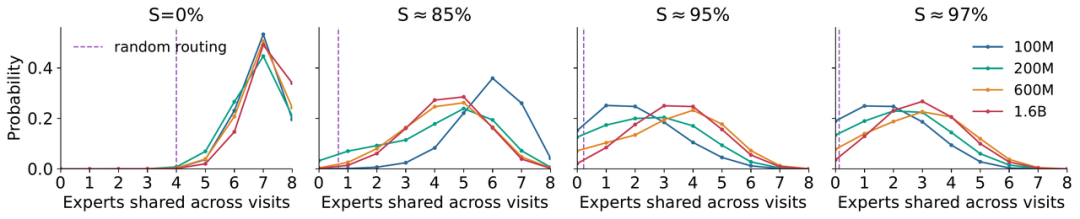
在 MoE 设置下,第二次执行会复用第一次的部分专家,同时选择一些新专家。两次选中的专家集合重叠度远高于随机水平,说明模型在“巩固已有知识”的同时也在“探索新路径”。
残差流:更大、更不同的更新
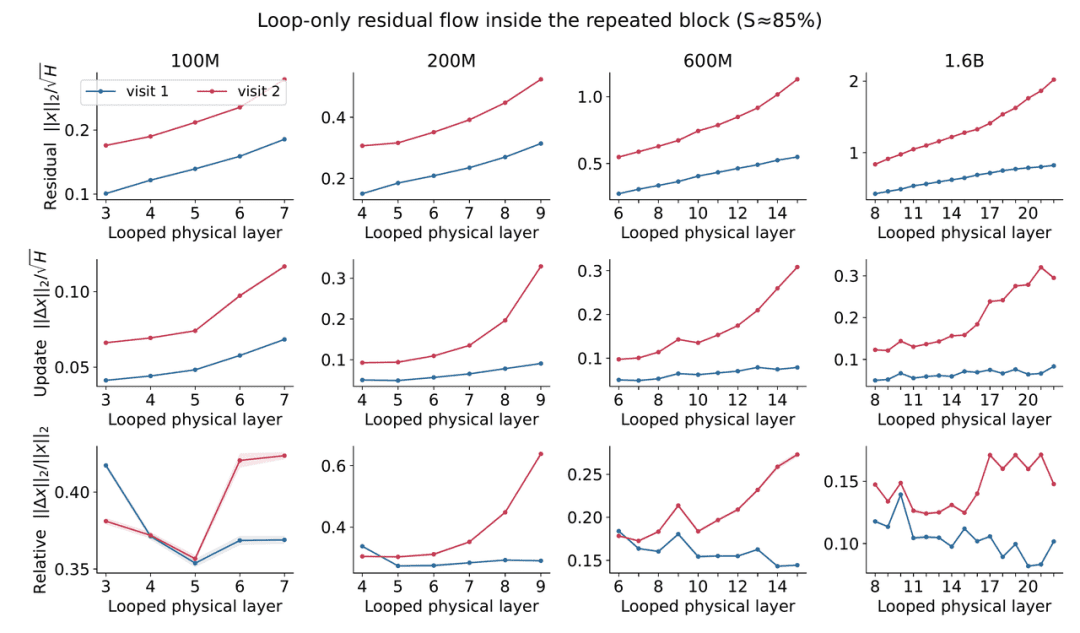
第二次执行向残差流写入的更新幅度整体大于第一次。虽然两次更新方向有一定重叠,但并不相同——说明第二次不是简单重复,而是在第一次基础上做更大幅度的修正。
注意力:看同一处,读不同内容
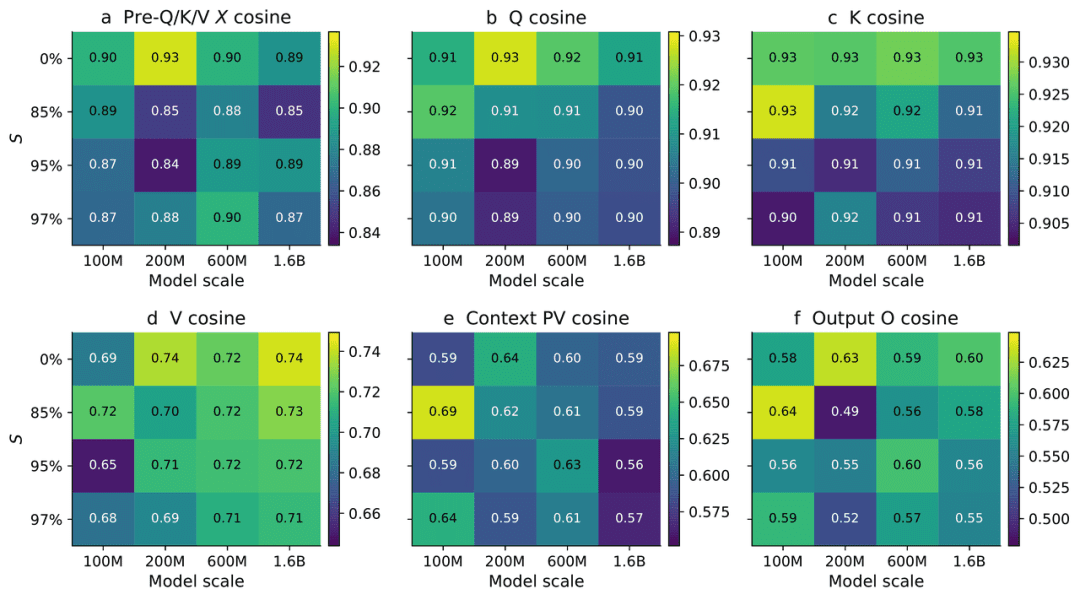
两次执行中,Query 和 Key 的余弦相似度高达 0.89–0.93,说明模型关注的位置基本一致。但 Value 及其后续输出变化更大。换句话说,第二次“看向同一处”,但“读到的内容”已经不同。
Dyck 任务中的典型案例
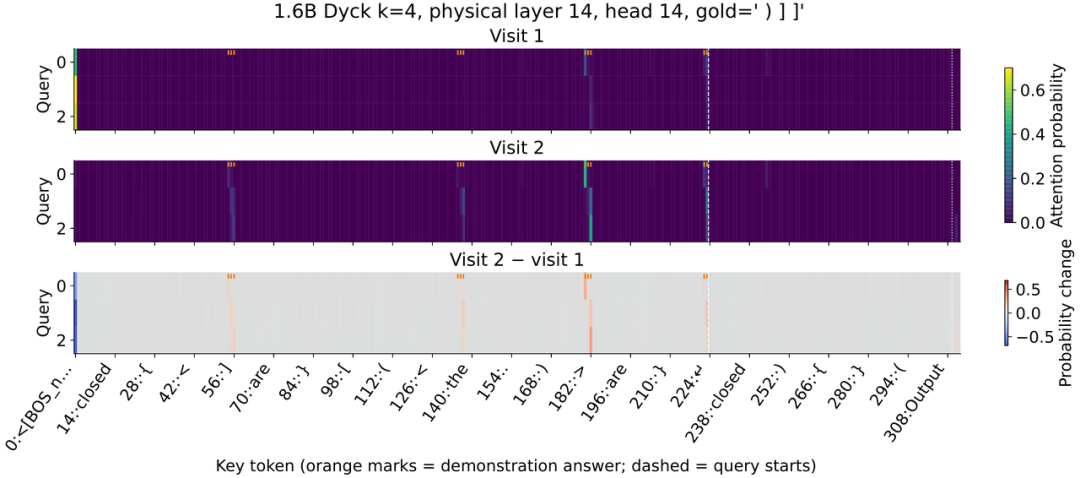
在 Dyck language 任务中,模型需从示例中定位答案位置。研究发现,关键注意力头在第一次执行时主要关注 BOS(起始符),而第二次执行则将注意力转移到示例中的答案位置。
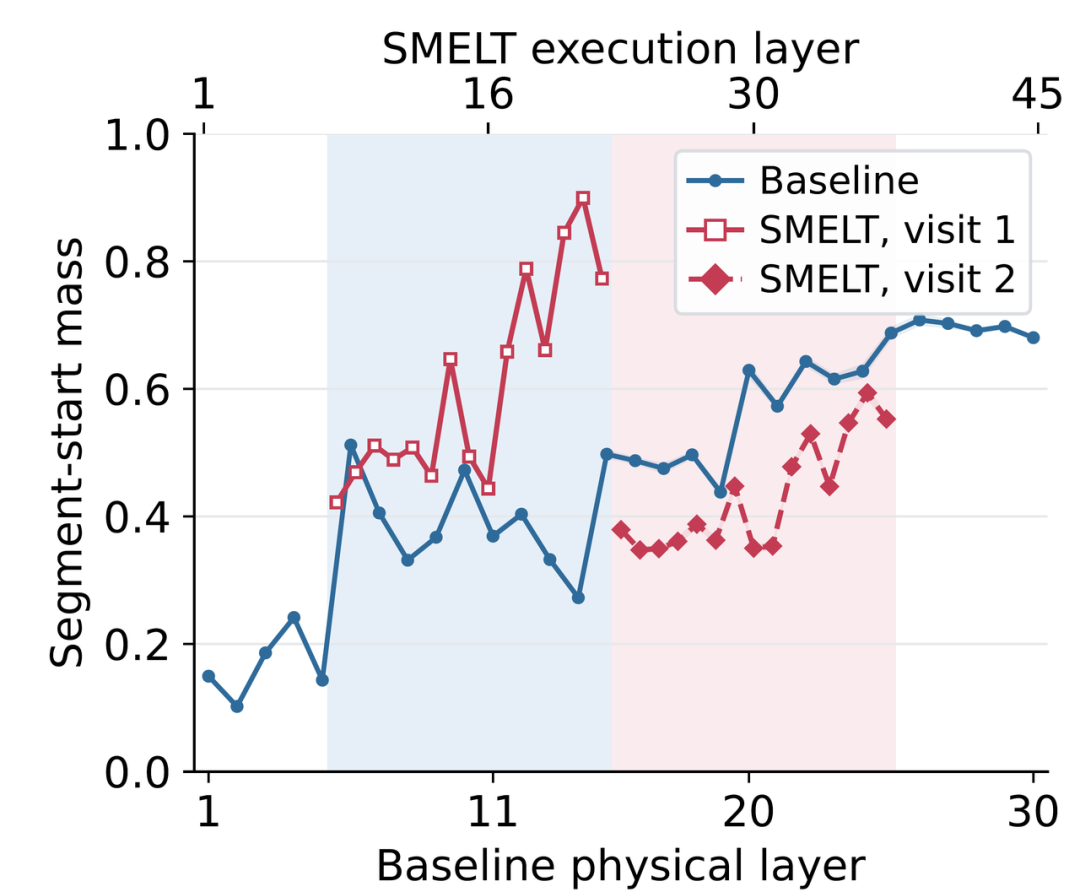
此外,普通模型的 attention sink(注意力汇聚点)会随深度增强,但 SMELT 却呈现相反趋势:第二次执行后,attention sink 反而减弱。这暗示第一次已建立初步表征,第二次不再依赖 sink,转而聚焦实际内容检索。
结论与局限
这项工作在严格控制预算的前提下,从 Scaling Law、下游任务和机制分析三个层面一致证明:Looped Transformer 的优势并非来自额外算力,而是循环架构本身带来的表征质量提升。
当然,研究也有局限:消融实验规模有限,且未涉及实际推理延迟、内存占用等系统效率优化。未来,这套预算匹配方案和 SMELT 配方有望成为 Looped 架构研究的标准实验设置,推动更公平的架构探索。