GPT-6 Astra 背后的空间推理机制:模型内部真有一张三维地图吗?
模型真的在“看”空间吗?
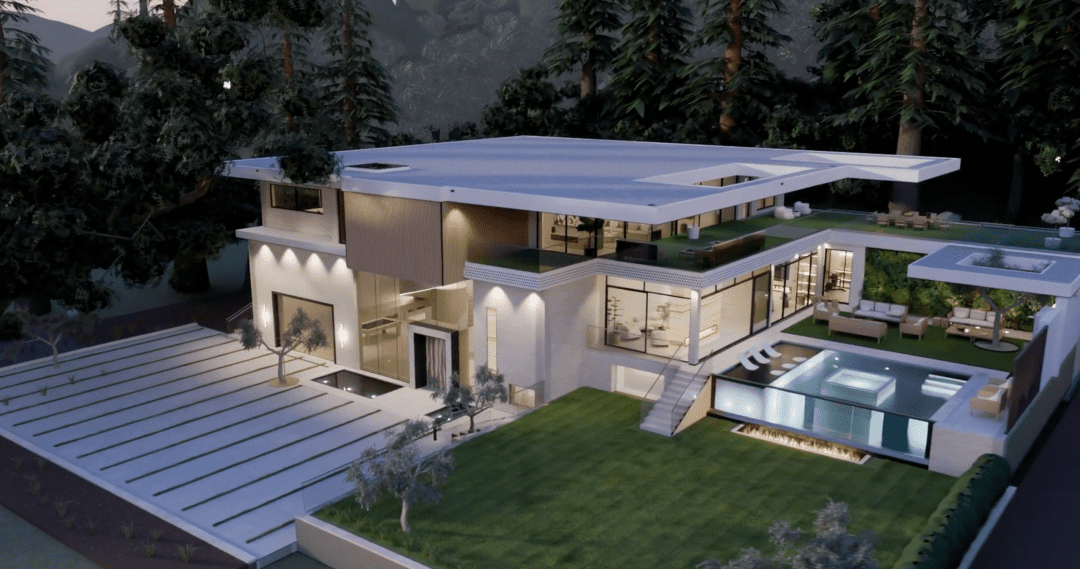
最近,一段 GPT-6 Astra 的演示视频刷屏:它能根据几张房源照片,在 Blender 里自动搭建出带家具和庭院的完整住宅模型,再一键导入 Unreal Engine 5,让人能走进房间、打开柜门,甚至操作咖啡机。整个过程流畅得不像 AI,倒像一个熟练的 3D 美术师。

但热闹背后,一个更根本的问题浮出水面:当模型说“沙发在电视左边”时,它真的在脑子里构建了一个三维场景吗?还是仅仅识别了某种图像模式,然后套用语言模板?
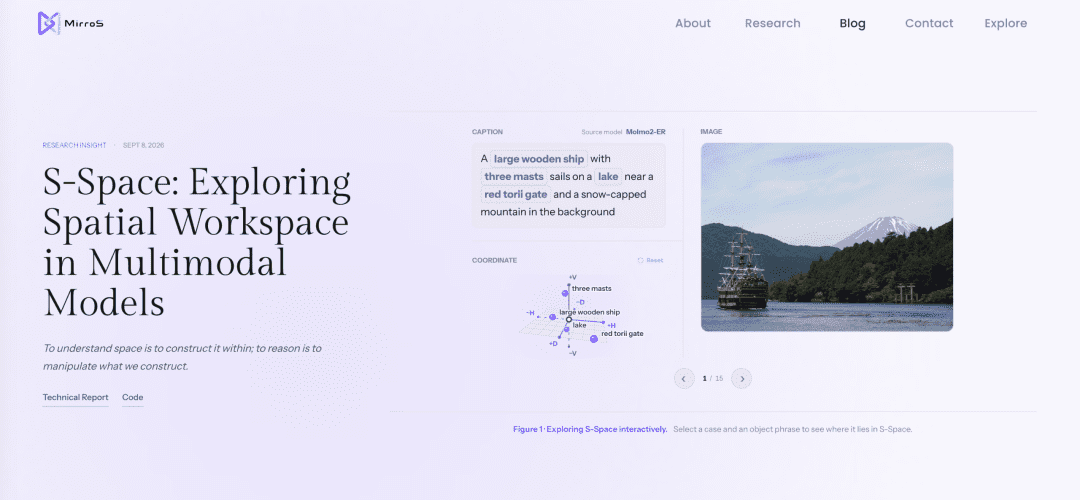
MirroS 团队的新研究给出了部分答案。他们发现,多个主流多模态模型(包括 Qwen 系列)的内部,存在一个稳定的低维结构,能线性编码物体的空间位置。研究者把它命名为 S-Space(Spatial Workspace,空间工作区)。
S-Space:一张藏在模型里的内部地图
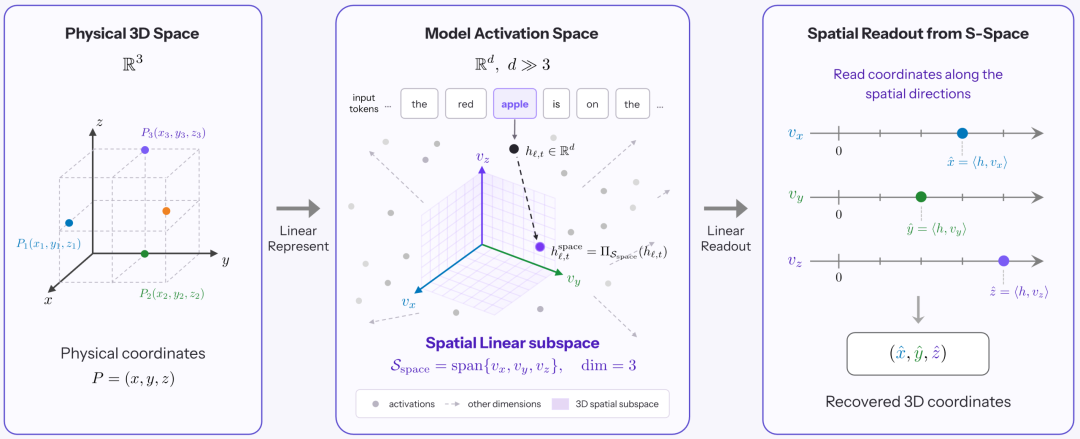
S-Space 的发现思路很巧妙。研究者假设:当模型处理一张图片并输出“杯子在书左边”时,杯子和书对应的 token 隐藏状态中,可能已经写入了它们在某个共享坐标系中的位置。
为了验证,团队用自然场景图像构造空间问题(比如“哪个物体在最左边?”),然后利用答案的梯度反向找出三个正交方向:水平(左-右)、垂直(上-下)和距离(近-远)。这三个方向张成的子空间,就是 S-Space。
实验结果令人惊讶。从 S-Space 中读出的数值,与物体的真实连续坐标高度相关。更关键的是,这套结构极其稳定:
- 它能泛化到训练时从未见过的数据分布;
- 即使问题改成问颜色(比如“沙发是什么颜色?”),依然能从同一组坐标轴中读出空间位置;
- 在多视图输入中,只要提示指定“视图 1”,S-Space 就会动态锚定到对应视角。
这意味着 S-Space 不是临时拼凑的产物,而是一个持续存在的内部工作区——就像 Anthropic 在 Claude 中发现的 J-space(语言工作区)一样,但专注处理空间信息。
干预实验证明:S-Space 是因果性的
光能读出坐标还不够。也许 S-Space 只是个“记分牌”,记录比分但不参与比赛?
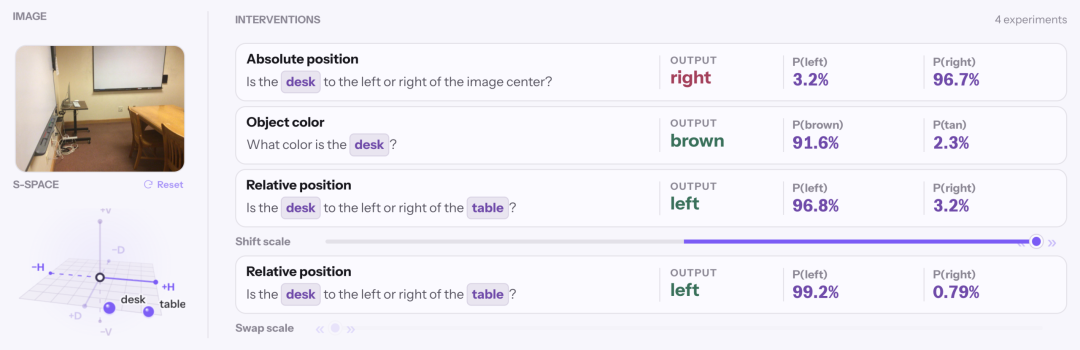
研究者做了个大胆实验:在不改变原始图像和问题的前提下,直接交换两个物体在 S-Space 中的坐标。比如把 A 和 B 的左右位置对调,其他一切保持不变。
结果,模型的语言输出立刻跟着变了:“A 在 B 左边”变成了“A 在 B 右边”。而对颜色、材质等无关属性的判断几乎不受影响。
这说明 S-Space 不只是可被外部解码的副产品,而是因果性地参与了模型的空间推理。模型内部确实存在一个可以被读取、写入和操纵的空间工作区。
抽象概念也被“放”进空间
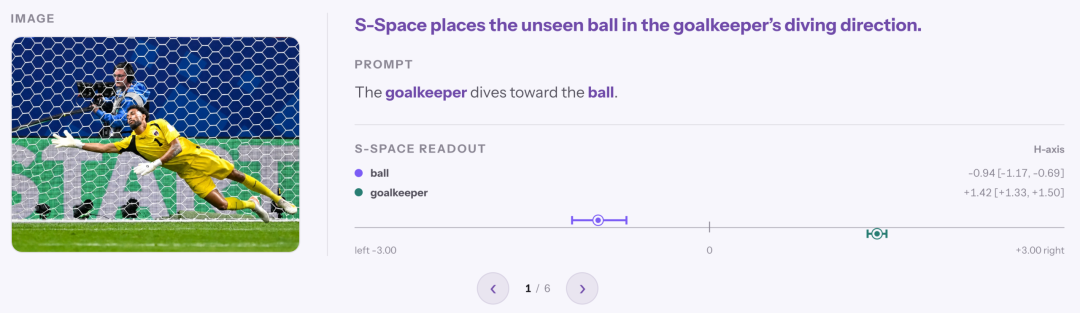
更有趣的是,S-Space 的边界超出了物理世界。研究者发现,模型能根据守门员扑救的方向,推断出画面外足球的位置——这说明空间表征可以延伸到视野之外。
甚至抽象概念也会被映射进来。比如“socialist”(社会主义者)这类词,因为语言中“政治左翼”的隐喻,会被放在 S-Space 水平轴的左端;而“你”——也就是观察者自身——总是出现在距离轴的近端。
这种现象暗示,S-Space 的形成可能源于预训练中对空间语言的学习。为了准确预测“左”“右”等词,模型必须把视觉实体与相对位置绑定,并让语言系统能调用这些信息。久而久之,这种压力就在内部组织出了稳定的空间轴。
坐标系混淆:语言带来的陷阱
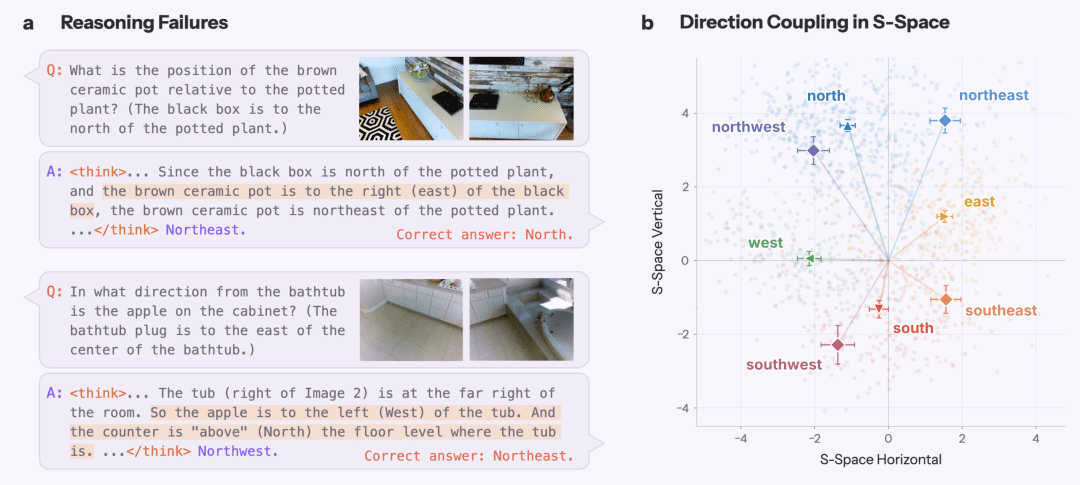
但语言在教会模型描述空间的同时,也埋下了隐患。研究发现,S-Space 中的物理空间和语言隐喻空间发生了耦合。
一个典型例子是基本方位与图像相对方向的混淆。在 Qwen 的 S-Space 中,“east”(东)与画面“右”对齐,“west”(西)与“左”对齐,“north”(北)对应“上”,“south”(南)对应“下”。这种映射符合常见地图惯例,在多数情况下有用。
可一旦题目采用另一套参照系,问题就来了。MMSI-Bench 中有个例子:题目已明确给出“北”的方向,但模型仍把画面中的“右”理解为“东”,最终答出“东北”而非正确答案“北”。
S-Space 让这种错误变得可见:基本方位和图像方向共享了部分表征特征,导致模型误把画面线索当作绝对坐标。它没先判断题目用的参照系,而是直接套用了默认的地图式坐标。
视角旋转:感知有了,计算还不稳
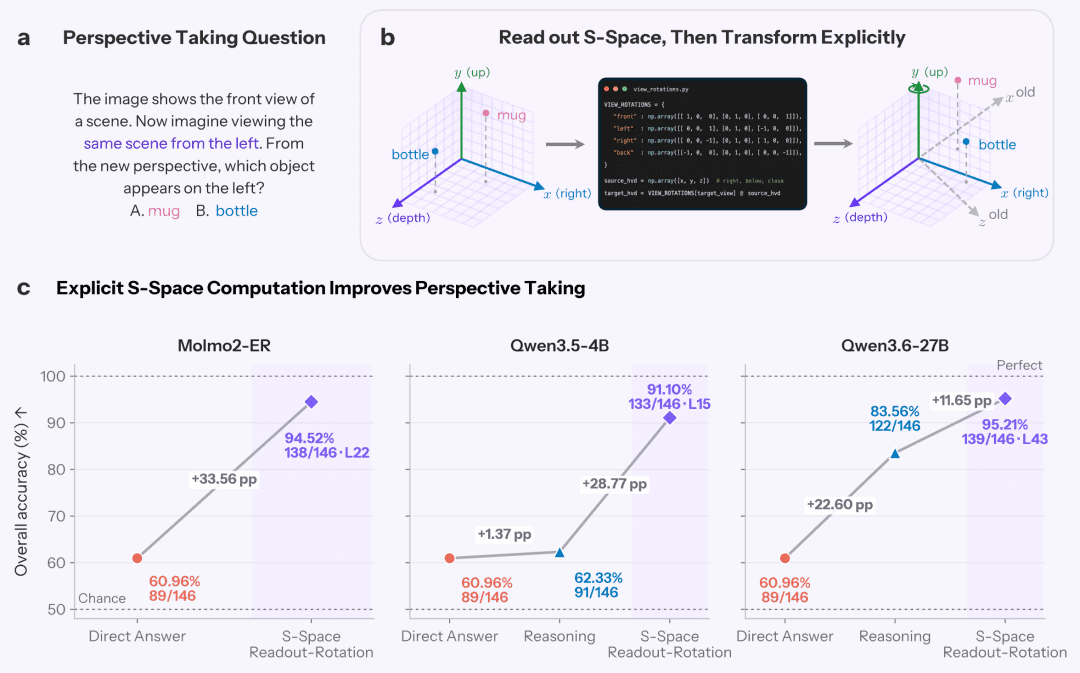
除了坐标系混淆,空间推理还有另一道坎:视角变换。给模型一个正面场景,让它想象从左侧看时两个物体的相对位置,这需要把已有坐标准确旋转到新视角。
研究团队用 SpinBench 测试了这一点。以 Qwen3.6-27B 为例,直接回答的准确率只有 60.96%;加入思维链(CoT)后提升到 83.56%。追踪推理过程发现,物体在 S-Space 中的坐标确实会随思维链逐步向目标视角旋转——早期接近原始视角,后期才慢慢对齐。
但这仍不够可靠。于是研究者做了一次“解耦”实验:先从 S-Space 读取物体的相对坐标,再在模型外部用固定旋转矩阵处理,最后按确定性规则作答。
结果,准确率飙升至 95.21%,远超思维链的表现。这个差距揭示了一个关键事实:模型内部已有足够精确的空间表征,但缺乏稳定变换这些坐标的计算机制。
从 Scaling 到机制设计
这项研究的意义,远不止解释一个 demo。它提供了一种比最终准确率更细的诊断方式:把“有没有正确表征”和“会不会使用表征”分开讨论。
前者依赖丰富的视觉与具身经验,可能随数据规模自然涌现;后者则需要专门机制——比如显式坐标变换、物理仿真、记忆模块、规划算法或工具调用。
从 Anthropic 的 J-space 到现在的 S-Space,可解释性正从“事后归因”转向“科学观测”。它帮我们看清模型内部重建了怎样的世界,也指明哪些能力光靠 Scaling 解决不了。
对走向物理世界的 AI 来说,Scaling 依然重要。但接下来更关键的问题或许是:模型在内部构建了怎样的空间?又需要什么,才能对这个世界进行可靠的变换、推演和行动?
毕竟,理解空间,不只是把它看见。
而是在内部构建它,并学会改变它。