DeepSeek 大模型 API 降价:V4-Flash 输入价格回调,输出仍为涨价前两倍
DeepSeek 再次调整 API 定价
9 月 9 日晚间,DeepSeek 开放平台发布公告,宣布对 V4-Flash 系列大模型 API 进行新一轮价格调整。这次不是涨价,而是部分回调——输入价格基本回到 8 月中旬涨价前的水平。
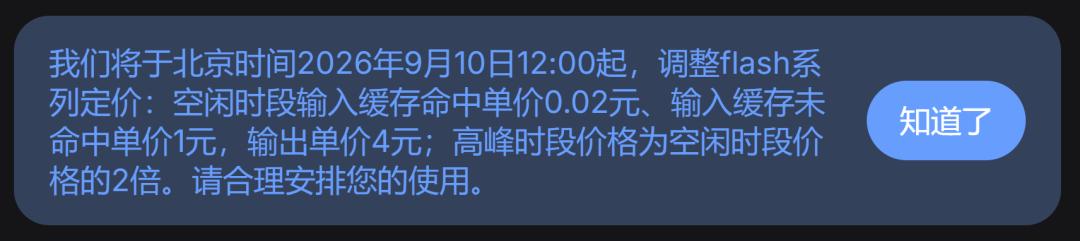
具体来看,空闲时段的定价为:
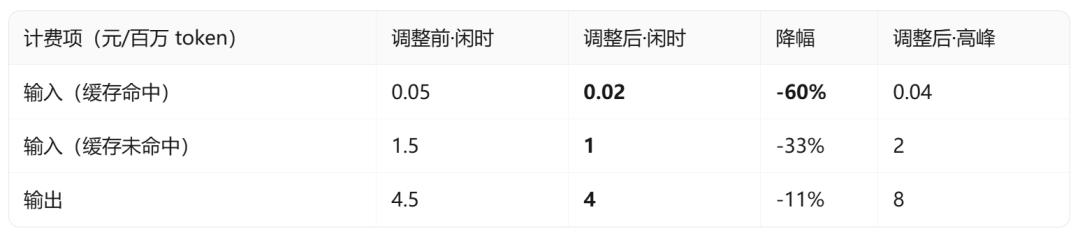
- 输入(缓存命中):0.02 元 / 百万 token
- 输入(缓存未命中):1 元 / 百万 token
- 输出:4 元 / 百万 token
高峰时段价格为空闲时段的两倍,即缓存命中 0.04 元、未命中 2 元、输出 8 元。官方明确,高峰时段指北京时间周一至周五的 9:00–12:00 和 14:00–18:00,其余时间均为空闲时段。
值得注意的是,此次调价仅涉及 V4-Flash 系列,定位更高的 V4-Pro 价格保持不变。新价格于 9 月 10 日中午 12 点正式生效。
和涨价前比,到底降了多少?
要理解这次降价的实际意义,得先回顾一下 8 月 17 日那次涨价。
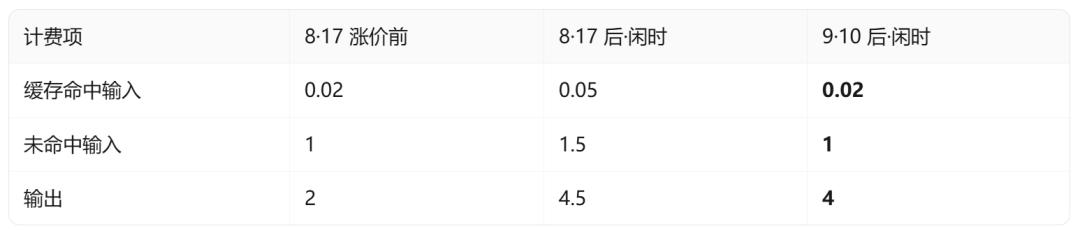
涨价前,V4-Flash 是统一价:缓存命中 0.02 元、未命中 1 元、输出 2 元(单位均为元 / 百万 token)。8 月涨价后,三项全部翻倍,变成 0.04 / 2 / 4 元。而这次调整,把输入两项拉回了涨价前,唯独输出维持在 4 元(空闲)和 8 元(高峰)。
换句话说,如果你的应用主要消耗输入 token,尤其是缓存命中率高,那这次确实算“回到解放前”。但如果你的场景重度依赖模型生成(比如长文本创作、代码生成),输出成本仍是涨价前的两倍,高峰时段甚至达到四倍。
用户实际感受取决于三个变量:缓存命中率、输入输出比例、任务是否能安排在非高峰时段。像 Agent 循环调用、固定系统提示词、长上下文复用等场景,缓存命中率通常很高,因此受益明显。而纯生成类任务,降价带来的缓解有限。
缓存机制是关键
DeepSeek 的 API 设计中,缓存是一个核心优化点。当用户重复发送相同或高度相似的 prompt 时,系统会尝试命中缓存,从而大幅降低输入成本——从 1 元降到 0.02 元,差了 50 倍。
这也解释了为什么社区对这次降价反应普遍乐观。不少开发者反馈,在实际使用中,尤其是构建智能体(Agent)或带记忆的对话系统时,缓存命中率经常超过 80%。这意味着大部分输入请求按 0.02 元计费,整体成本接近涨价前水平。
不过,缓存效果高度依赖应用设计。如果每次请求都带大量动态变量(比如实时数据、用户个性化信息),缓存命中率就会下降,成本优势也随之减弱。
同日上线临时内测模型
就在降价公告发布前一天,DeepSeek 在官方交流群透露了一个彩蛋:V4.1 Flash 中间版本开启内测。
这个模型名为 deepseek-v4.1-flash-expires-on-0910,base_url 与现有 API 一致,每账号限流 20 并发,计费暂时沿用 V4-Flash 标准。名字里的 “expires-on-0910” 明确表示,该模型将在 9 月 10 日自动下线——恰好与降价生效日重合。
据官方介绍,V4.1 Flash 在架构上做了升级,推理速度更快,同时通过工程优化进一步压低了推理成本。此外,它还支持原生多模态能力,虽然这次内测并未开放相关接口。
有开发者猜测,这次临时内测可能是为正式版 V4.1 铺路。如果新版本能在保持性能的同时显著降低成本,配合当前的分时定价策略,DeepSeek 或许能在竞争激烈的 API 市场中重新抢占份额。
降价背后的算力压力
回看 8 月那次涨价,DeepSeek 给出的理由是“更合理地调配资源,鼓励用户错峰使用”。但外界普遍认为,根本原因在于 V4-Flash 0731 版本性价比太高,吸引了大量全球用户调用,导致算力资源紧张。
事实上,自发布以来,DeepSeek V4 系列凭借低价和高性能,在国内外开发者社区积累了不错的口碑。尤其是在开源模型推理成本居高不下的背景下,其 API 成为不少创业团队和独立开发者的首选。
但高负载也带来了运维压力。有用户反映,8 月涨价后,高峰期偶尔会出现请求排队或延迟上升的情况。这次通过分时定价+缓存激励的方式,既缓解了成本压力,又保留了核心用户的使用体验。
用户该怎么应对?
对于正在使用 DeepSeek API 的开发者,这次调整意味着需要重新评估自己的调用策略:
- 检查缓存命中率:通过日志或监控工具查看实际命中情况。如果低于预期,考虑优化 prompt 结构,将动态部分与静态部分分离。
- 错峰调度任务:非实时性任务尽量安排在夜间或周末执行,可直接节省一半费用。
- 控制输出长度:在不影响功能的前提下,通过 temperature、max_tokens 等参数限制生成长度,避免不必要的输出开销。
- 关注 V4.1 动态:虽然临时内测版已下线,但正式版可能很快推出。新模型若真如宣传所说“成本更低”,或许会带来新一轮价格调整。
不是所有场景都“回血”
需要提醒的是,这次降价并非普惠式福利。对以输出为主的场景——比如小说生成、报告撰写、代码补全——成本依然比 8 月前高出一倍。这类用户可能需要权衡:是继续忍受高成本,还是切换到其他模型(如 Claude Sonnet、Gemma 2B API)做混合调用。
另外,分时定价也增加了使用复杂度。自动化系统需要额外逻辑来判断当前是否处于高峰时段,并动态调整调用策略。对小型团队来说,这可能带来额外的开发负担。
行业进入精细化运营阶段
DeepSeek 的这次调整,反映出大模型 API 市场正从“烧钱换用户”转向“精细化运营”。早期靠低价吸引流量的策略难以为继,厂商开始通过技术优化(如缓存、量化、蒸馏)和定价机制(如分时、用量阶梯)来平衡成本与体验。
类似做法在云计算领域早已常见。AWS、阿里云等平台长期采用按需、预留、Spot 实例等组合定价。如今,大模型 API 也在走向同样的路径。
对用户而言,这意味着不能再简单比较“每百万 token 多少钱”,而要结合自身 workload 特征做综合测算。一个在纸面上更贵的模型,如果缓存效率高、推理速度快,实际总成本可能反而更低。
下一步看 V4.1 正式版
目前,社区最关心的是 V4.1 Flash 正式版何时发布。如果新模型真如内测版所暗示的那样,在保持性能的同时进一步降低推理成本,DeepSeek 或许会再次调整定价,甚至将输出价格也拉回涨价前水平。
毕竟,在当前竞争格局下,谁能提供“又好又便宜”的服务,谁就能留住开发者。而开发者生态,正是大模型长期价值的核心所在。
短期内,9 月 10 日之后的调用量和用户反馈,将成为观察这次降价效果的关键指标。如果高峰时段负载明显下降、空闲时段利用率提升,说明分时策略奏效;反之,则可能需要进一步优化。
无论如何,对用户来说,多一种选择、多一分灵活性,总不是坏事。