AgentVLN:用轻量VLM做机器人导航,边端实时运行还能自我纠错
让机器人听懂人话,没那么简单
你对机器人说:“穿过走廊,在窗户旁边找把椅子。”听起来很简单,但对机器来说,这句话背后藏着一连串难题:走廊在哪?窗户和椅子的空间关系是什么?当前视角有没有被挡住?该先往左还是往右?靠近目标时怎么不撞上去?

这就是视觉语言导航(Vision-and-Language Navigation, VLN)的核心挑战——把一句自然语言指令,变成机器人在真实世界中连续、安全、准确的行动序列。过去很多方法试图用一个庞大的端到端模型直接从图像和语言预测动作,结果要么精度不够,要么计算太重,根本跑不动在机器人本体上。
AgentVLN 的思路不一样。它不指望一个模型搞定一切,而是让视觉语言模型(VLM)当“大脑”,只负责高层认知:理解任务、分析环境、决定调用哪个技能。具体的建图、避障、移动、定位,则交给专门设计的模块来干。这种分工,更像人自己走路——看到环境,想好路线,迈步,再根据反馈调整。
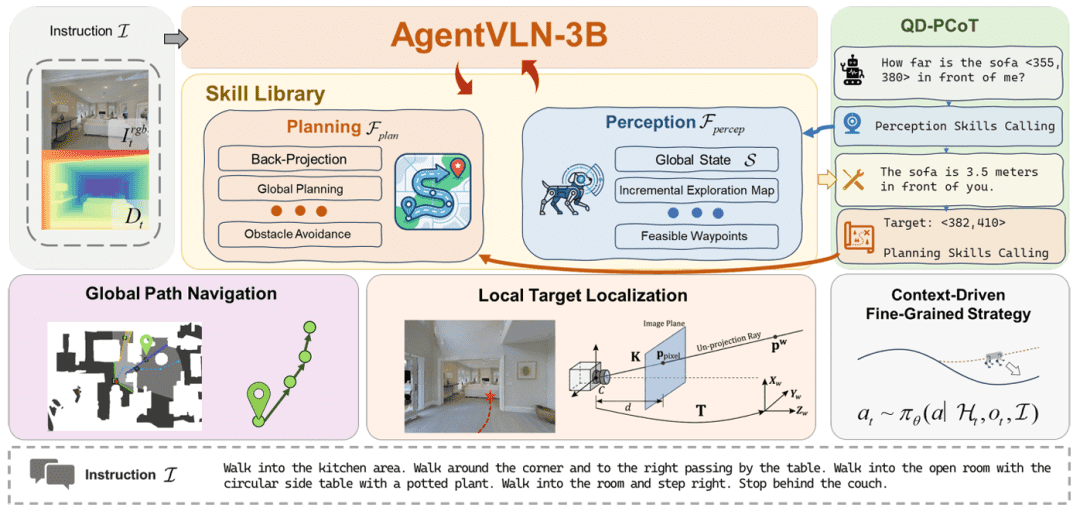
VLM 当大脑,技能库当手脚
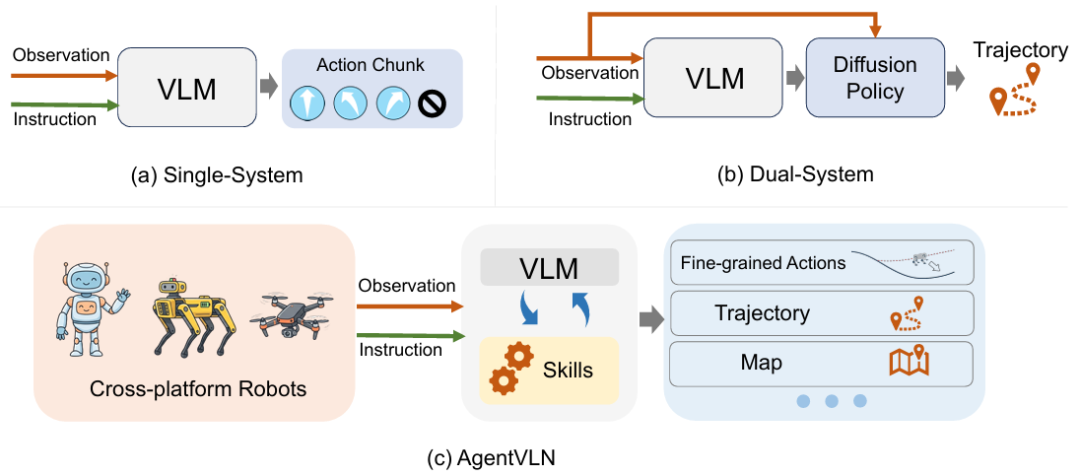
AgentVLN 的架构可以概括为:VLM Agent → Skill Calling → SLAM/Perception → Robot Navigation。
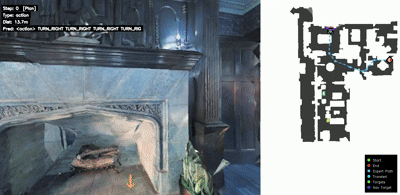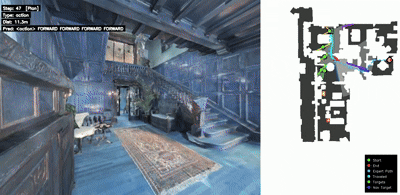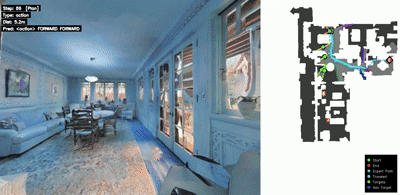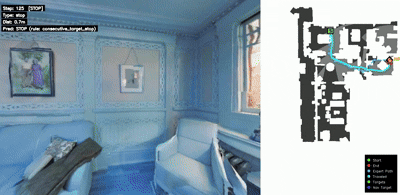
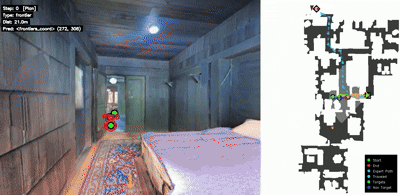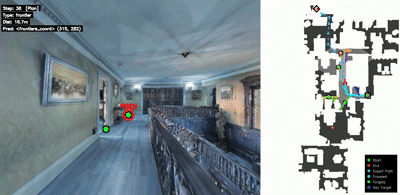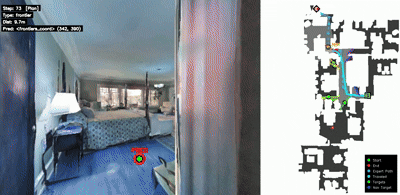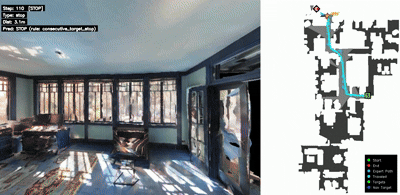
这里的 VLM 不直接输出“前进0.5米”这种底层控制指令,而是判断:“我现在需要构建地图”“前方有障碍,得绕行”“目标可能在右侧,调用深度感知”。这些决策会触发对应的技能模块,比如 SLAM 模块负责建图,路径规划模块生成候选点,运动控制模块执行移动。
关键在于,这套技能库是插件式的。同一个 AgentVLN “大脑”,换一套底层技能,就能适配四足机器狗、轮式底盘甚至人形机器人。不需要重新训练大模型,只要技能接口对得上,就能快速迁移。这大大降低了在不同平台上部署的门槛。
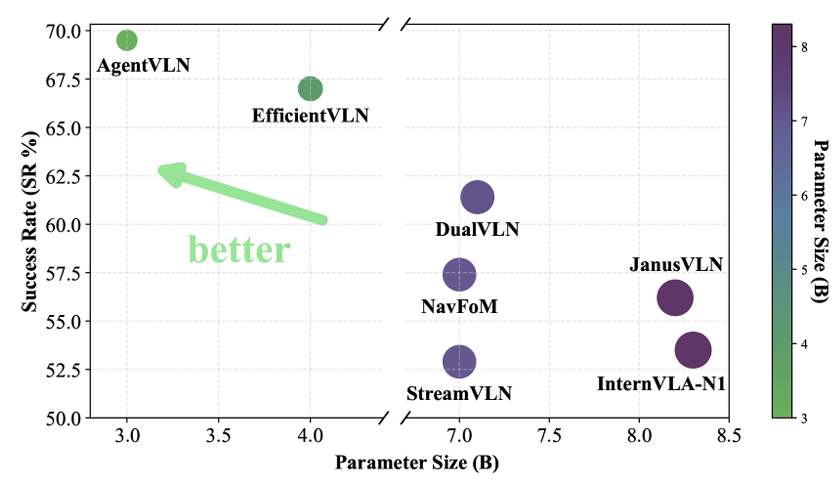
更重要的是,整个系统只用了 Qwen2.5-VL-3B 这样一个 30 亿参数的轻量模型,没堆参数,也没加复杂的三维视觉网络。最终能在 Jetson 这类边缘设备上实时运行——这对实际机器人应用至关重要。
把三维世界“翻译”成VLM看得懂的二维提示
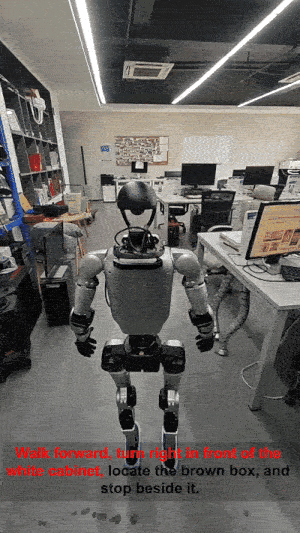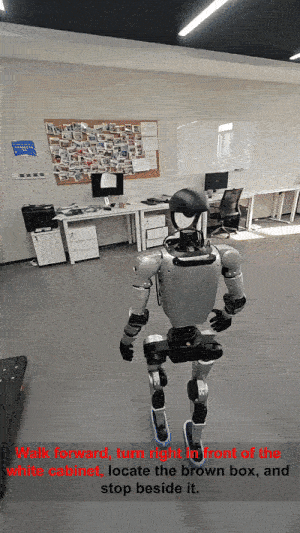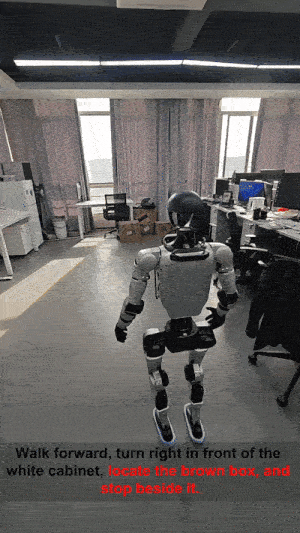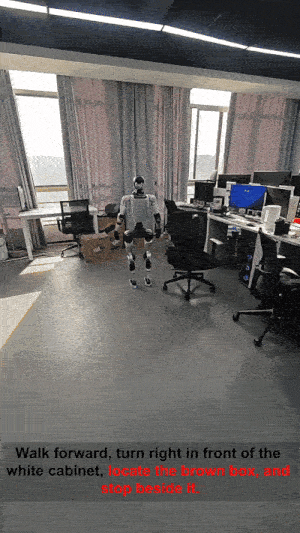
VLM 擅长理解二维图像里的语义,比如“这是窗户”“那是椅子”。但机器人要导航,必须知道“往哪个方向走”,这涉及三维空间坐标。如何把这两个世界连起来?
AgentVLN 提出了 跨空间表示映射机制(Cross-space Representation Mapping)。具体做法是:先让感知技能(比如基于SLAM)在三维空间里算出几条可行的路径点;然后利用相机内参,把这些三维点反向投影到当前摄像头拍到的二维图像上。
这样一来,原本需要模型直接预测一个精确三维坐标的开放性问题,就变成了:“在图像里,哪个投影点最符合‘窗户旁边的椅子’这个描述?” VLM 只需在熟悉的视觉空间里做选择,选完后再把结果映射回三维,交给控制模块执行。
这个转换很聪明。它避开了让 VLM 直接做复杂几何推理的短板,转而发挥其强大的视觉语义匹配能力。实验也证明,这种方式比端到端回归坐标更稳定、更准确。
遇到遮挡或偏差,机器人会自己“找补”
现实环境从来不会那么理想。家具可能挡住视线,光线变化会让特征失效,轮子打滑会导致定位漂移。如果机器人只会一条路走到黑,小误差累积起来,最后可能完全迷路。
AgentVLN 加入了 上下文驱动的自我纠错机制。当它发现:当前视野里找不到和指令匹配的目标,或者走着走着环境和预期对不上,就不会硬往前冲。相反,它会主动执行探索动作——比如原地转个身、左右扫视、后退几步重新观察。
这些细粒度的探索行为,不是预设的固定策略,而是由 VLM 根据当前状态动态决定的。比如,如果指令提到“窗户”,但正面看不到,模型可能会判断“窗户可能在侧面”,于是触发“向右转90度”的技能。这种基于上下文的调整,显著减少了长距离导航中的失败率。
不懂就问:主动调用感知技能补信息
更进一步,AgentVLN 还让机器人学会了“知道自己不知道什么”。这靠的是 Query-Driven Perceptual Chain-of-Thought(QD-PCoT) 机制。
举个例子:VLM 看到图像里有一把椅子,但不确定它离自己有多远。这时候,它不会瞎猜一个距离,而是生成一个查询:“前方椅子距离我有多远?” 然后主动调用深度感知模块(比如RGB-D相机或单目深度估计)获取具体数值。
拿到反馈后,模型更新自己的空间认知,再决定下一步动作。整个过程变成:主动提问 → 获取信息 → 更新认知 → 决策行动。
这种设计有效缓解了纯二维视觉中的深度歧义问题。实验显示,加入 QD-PCoT 后,导航成功率明显提升,而且没增加任何模型参数——只是改变了信息获取的方式。
轻量模型也能跑赢大模型
很多人觉得,要做复杂任务就得上大模型。但 AgentVLN 证明,合理的架构设计比盲目堆参数更有效。
它在 R2R-CE 和 RxR-CE 这两个主流 VLN 基准上都取得了当前最好的成绩,而核心模型只有 3B 参数。相比之下,不少竞品依赖 7B 甚至更大的 VLM,还得搭配额外的三维处理网络,根本没法在机器人本体上跑。
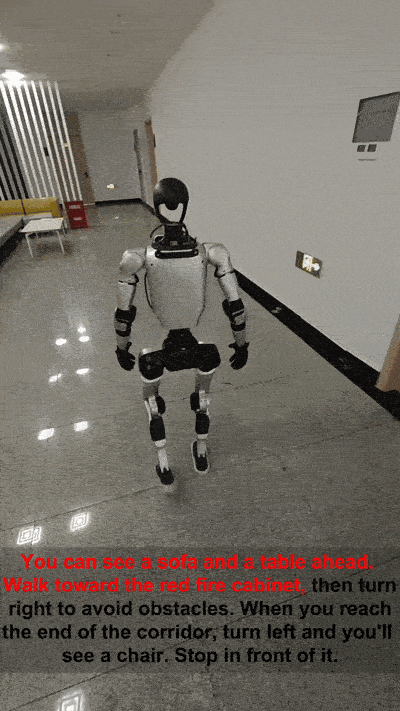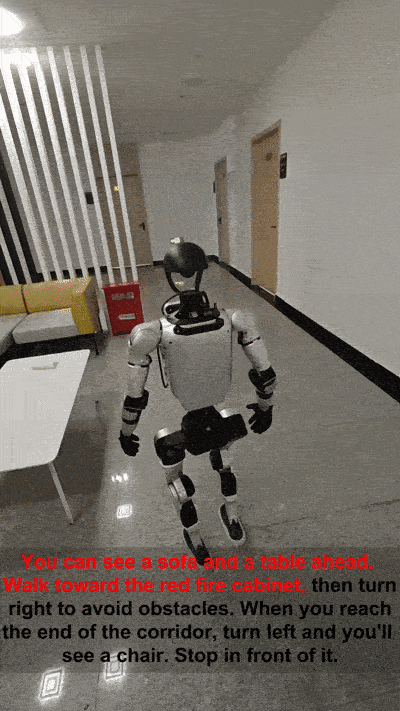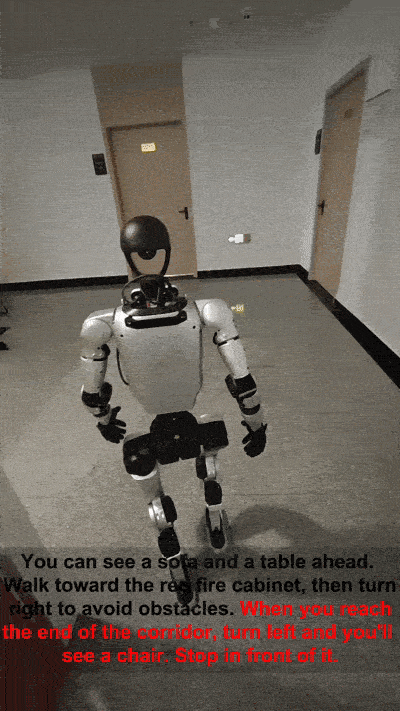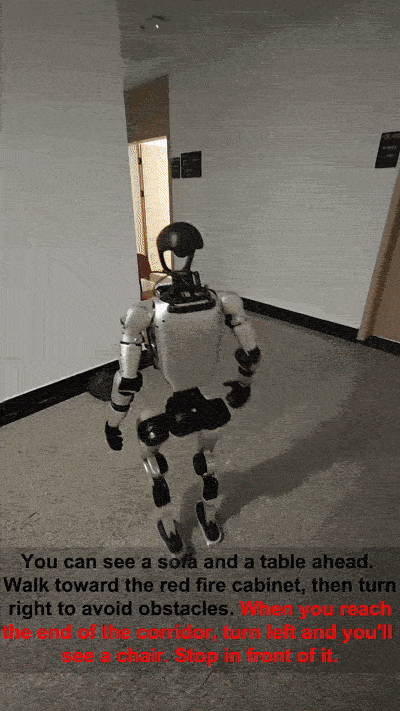
研究团队真的把系统装到了四足机器狗和人形机器人上。机器人通过普通摄像头看环境,调用本地部署的感知技能建图、规划,再由 VLM 大脑指挥行动。整个流程延迟可控,能应对动态变化的室内场景。
导航之外,是一种新的智能体范式
AgentVLN 的意义,不止于提升导航指标。它展示了一种更实用的机器人智能体构建思路:大模型负责“想”,专用模块负责“做”。
这种“VLM-as-Brain + 技能库”的模式,未来可以扩展到更多任务。比如,让 VLM 理解“把桌上的杯子放进洗碗机”,然后调用抓取、开门、放置等操作技能。只要底层技能足够可靠,上层的认知就可以复用。
随着大模型推理能力增强,以及机器人感知、运动、操作技能持续完善,我们或许真能看到机器人从“被编程执行”走向“理解目标、自主规划、主动学习”的阶段。AgentVLN 是朝这个方向迈出的扎实一步——不用云端,不靠巨量参数,就在机器人自己的“脑子”里,完成复杂任务的理解与执行。