谷歌 DeepMind 发布 AlphaGenome Atlas:预测人类基因组所有单碱基变异影响
98% 的基因组曾是“暗物质”,现在有了预测地图
人类基因组大约有 30 亿个 DNA 碱基对,但长期以来,科学家真正理解的只有其中负责编码蛋白质的约 2%。剩下的 98% 被称为“非编码区”,过去常被误认为是“垃圾 DNA”。实际上,这些区域包含大量调控元件——它们决定基因在何时、何地、以何种强度开启或关闭。问题在于,要搞清楚某个 DNA 字母的改变(即单核苷酸变异)会不会破坏这些调控功能,传统方法既慢又贵。
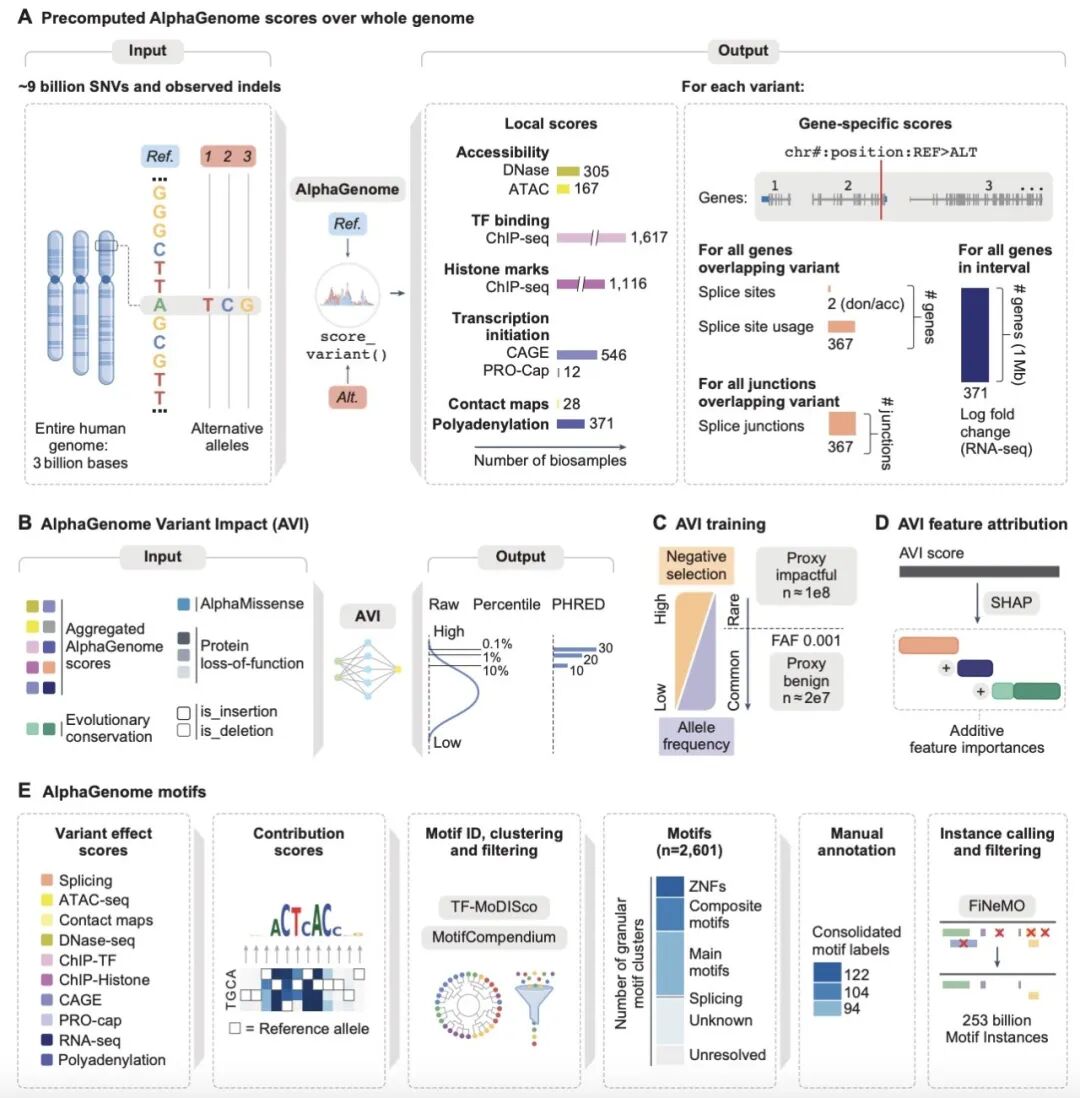
去年,谷歌 DeepMind 推出了 AlphaGenome 模型。它能接收长达 1 兆碱基的 DNA 序列作为输入,预测数千种分子层面的功能轨迹,分辨率精确到单个碱基对。这些预测涵盖基因表达水平、转录起始位点、染色质是否开放、组蛋白修饰状态、转录因子结合情况、染色质三维接触图谱,以及 RNA 剪接的具体位置和强度。
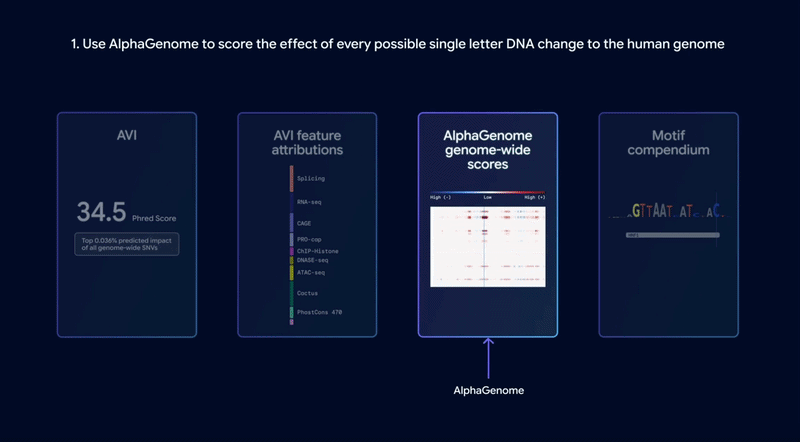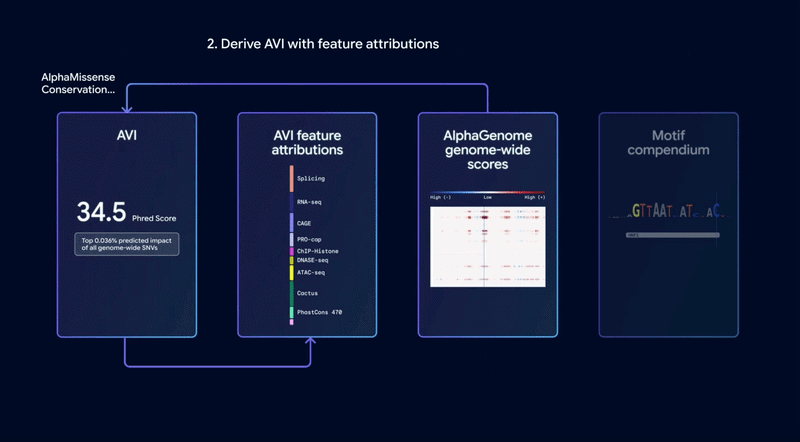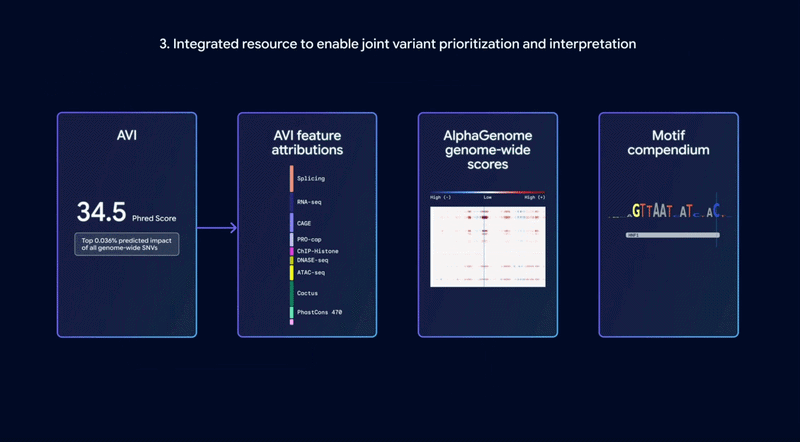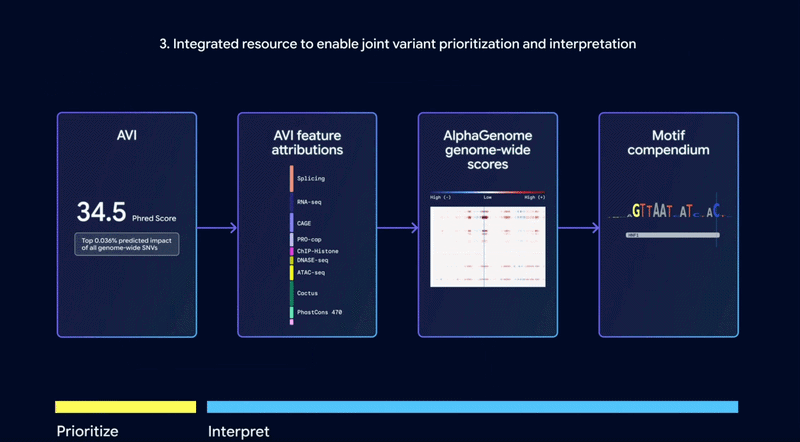
现在,DeepMind 更进一步,发布了 AlphaGenome Atlas ——一个预计算了人类基因组中所有可能单字母变异影响的数据库。团队用 AlphaGenome 对全部 90 亿种单核苷酸替换(即 A/T/C/G 四种碱基在每个位置上的相互替换)进行了模拟,生成了一个体积达 1PB(100 万 GB)的数据集。作为对比,2022 年轰动学界的 AlphaFold 蛋白质结构数据库约为 30TB,AlphaGenome Atlas 的规模是其 30 多倍。
一个评分,让复杂数据变得可用
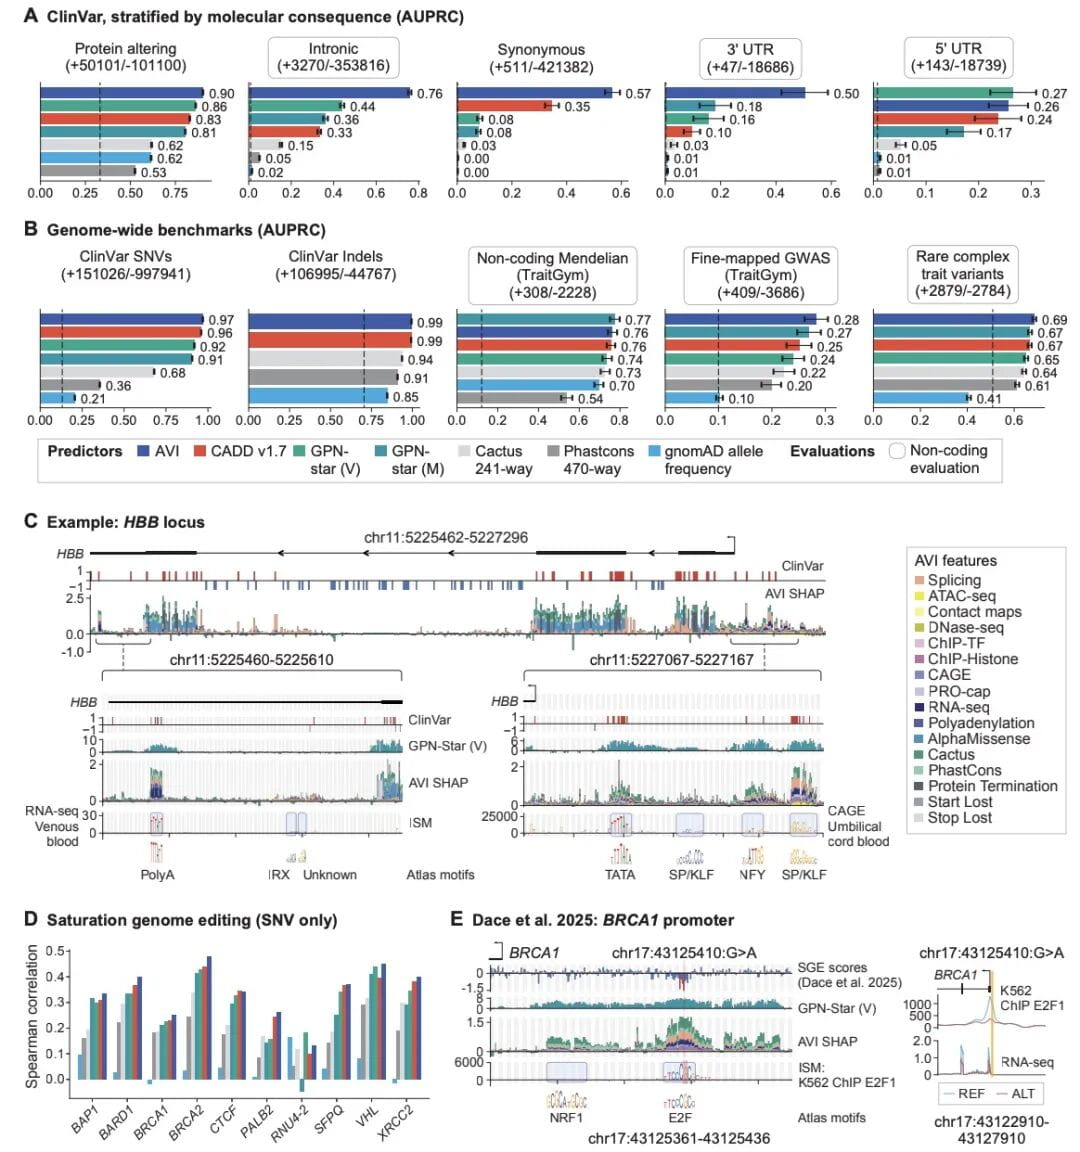
面对如此庞大的数据,普通研究人员很难直接使用。为此,Atlas 引入了 AlphaGenome 变异影响(AVI)评分。这是一个单一数值,综合了对编码区和非编码区的预测结果,让使用者无需逐项查看成千上万的分子轨迹,就能快速判断某个变异是否值得关注。
AVI 评分融合了两个模型的能力:AlphaGenome 负责非编码区的调控效应预测,而 AlphaMissense(DeepMind 此前开发的用于预测错义突变影响的工具)则处理编码区的蛋白质结构变化。这样一来,无论变异落在基因的哪个部分,都能得到统一评估。
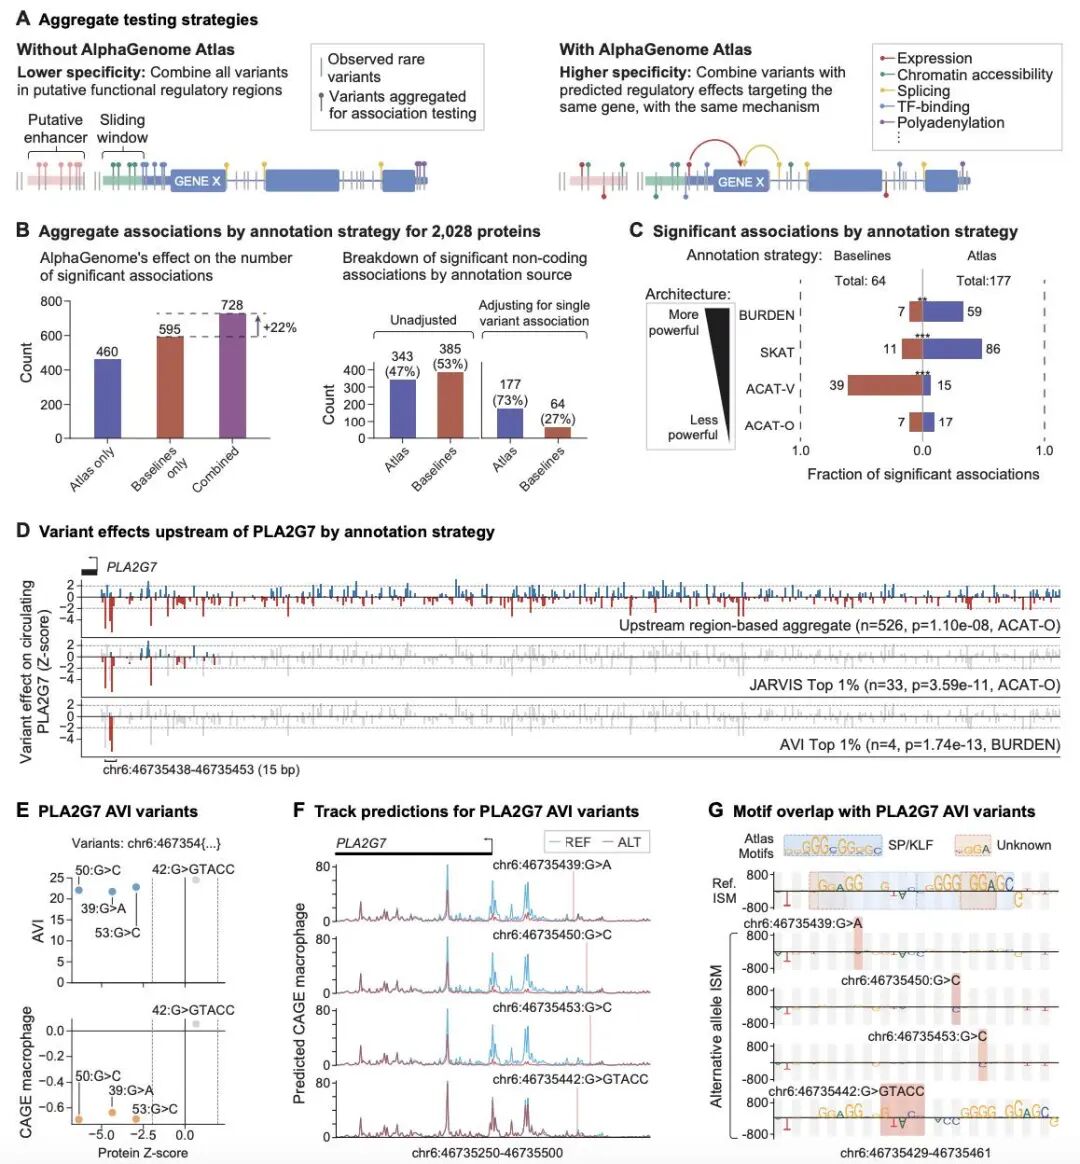
更重要的是,每个 AVI 评分都附带 特征归因——告诉你这个高分主要是由哪些生物学过程驱动的。比如,某个变异的高 AVI 值可能主要源于它对 RNA 剪接的干扰,而不是影响启动子活性。这种可解释性对后续实验设计至关重要。
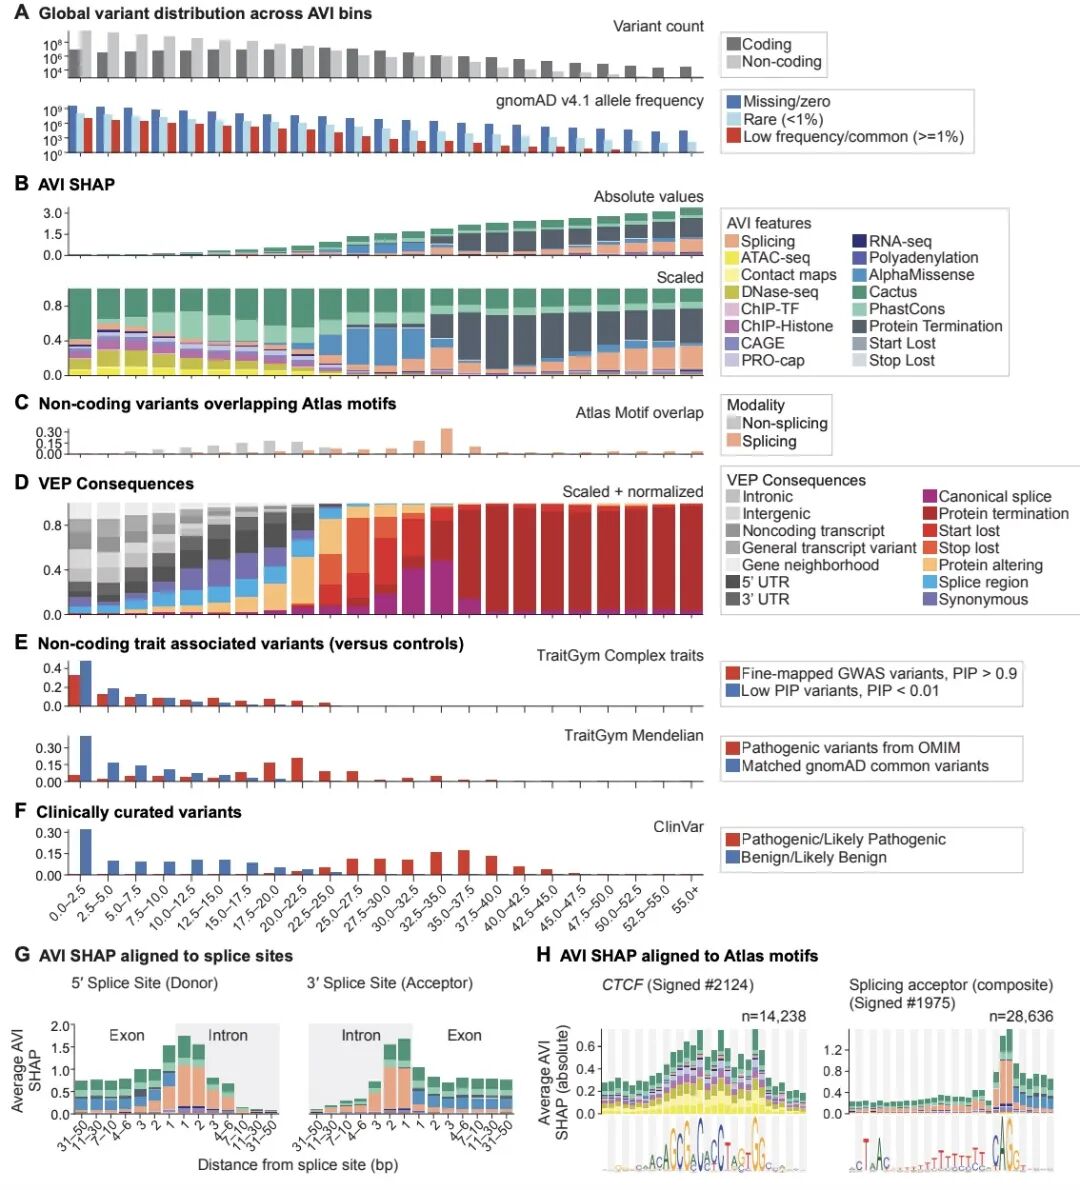
此外,Atlas 还整合了一个包含 超过 2500 个重复性 DNA 序列基序 的集合。这些短序列就像基因组中的“单词”,是转录因子识别并结合的关键位点。通过比对变异是否落在这些基序内,研究人员能更精准地推测其功能后果。
目前,AlphaGenome Atlas 已通过网页界面开放访问(https://deepmind.google.com/science/alphagenome/atlas),无需任何编程技能。临床医生、遗传学家甚至高中生都能上传一个变异坐标,立刻看到它的 AVI 评分和潜在机制。
在罕见病研究中找到“被忽略的针”
罕见病诊断的一大难题,是从患者基因组中成千上万个变异里找出真正致病的那个。很多病例经过常规分析后仍无解,被称为“未确诊疾病”。
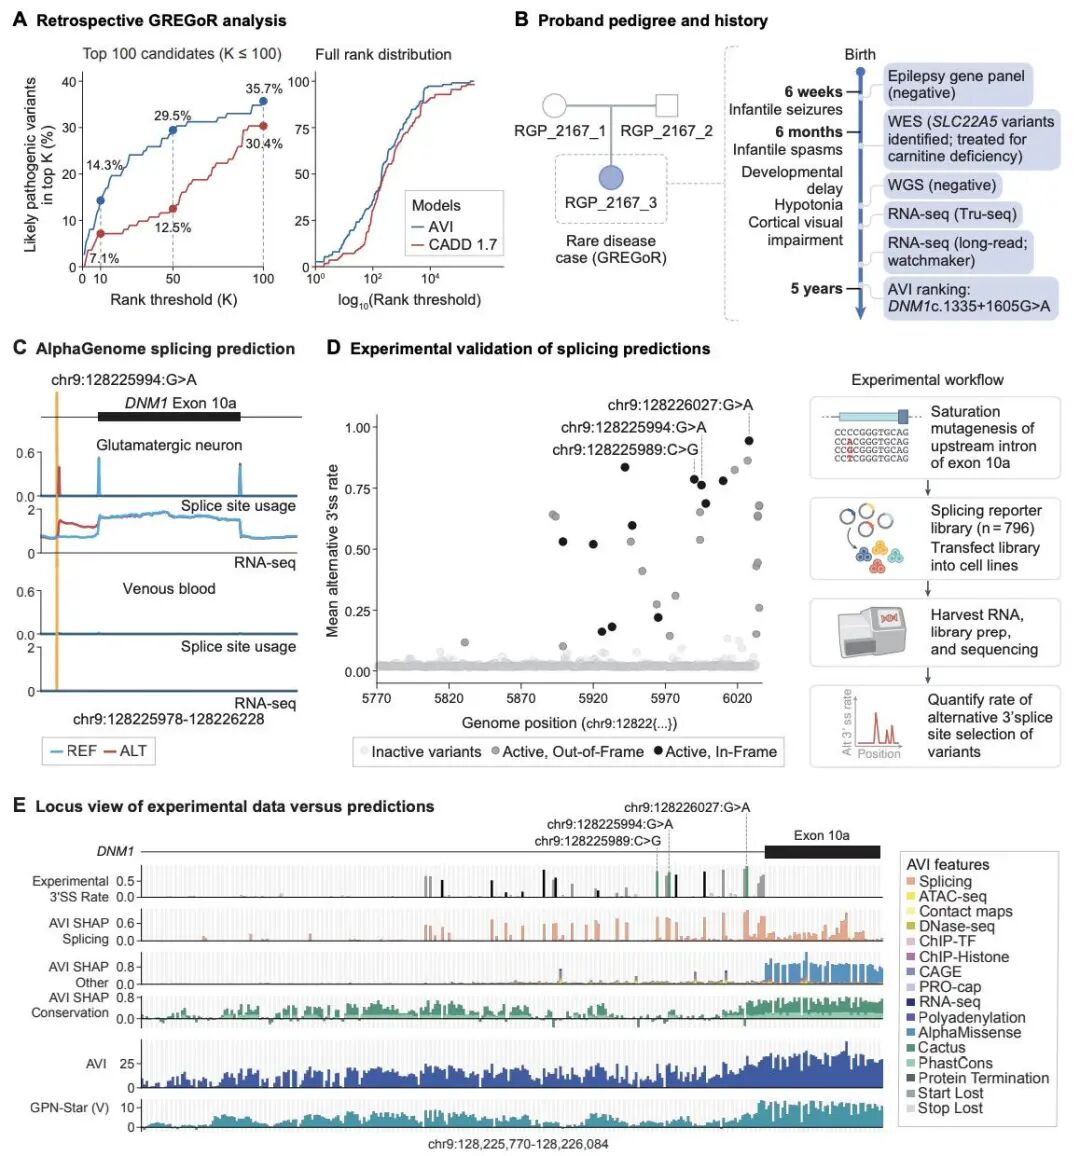
DeepMind 与 GREGoR 联盟(一个专注于罕见病基因发现的国际研究网络)合作,尝试用 AVI 评分重新审视这些悬案。博德研究所的研究人员将 AVI 应用于一组此前被排除的候选变异,结果发现了一个位于 DNM1 基因 内含子区域的变异。DNM1 与一种严重的癫痫性脑病有关,但这个变异不在编码区,传统方法难以判断其意义。
AlphaGenome 的预测显示,该变异创建了一个 异常的剪接供体位点,导致 mRNA 多出一段不该有的序列,最终产生延长且功能异常的蛋白质。随后的细胞实验验证了这一预测。更关键的是,团队还在附近发现了其他具有类似剪接破坏效应的变异,说明 Atlas 不仅能定位单个致病变异,还能揭示局部基因组的脆弱区域。
从统计噪音中挖出隐藏的遗传信号
除了罕见病,常见性状(如身高、胆固醇水平)也受大量微效变异影响,其中许多位于非编码区。但由于人群中有太多中性变异,真正的信号常被淹没在“背景噪音”中。
埃克塞特大学的 Gareth Hawkes 博士将 AlphaGenome Atlas 应用于 英国生物银行 的 54000 多名参与者的全基因组数据。他没有直接做全基因组关联分析(GWAS),而是先根据 AVI 预测的分子效应,将功能相似的罕见变异聚类分组,再检验这些组是否与特定蛋白质水平相关。
这种方法成功发现了 超过 22% 的新遗传关联,这些关联在传统 GWAS 中完全无法检测到。例如,他精确定位了调控 PLA2G7(一种与炎症和衰老相关的酶)和 EGLN1(细胞感知氧气的关键因子)循环浓度的非编码变异。这些发现不仅揭示了新的生物学机制,也为药物靶点筛选提供了线索。
解码基因组里的“调控词汇”
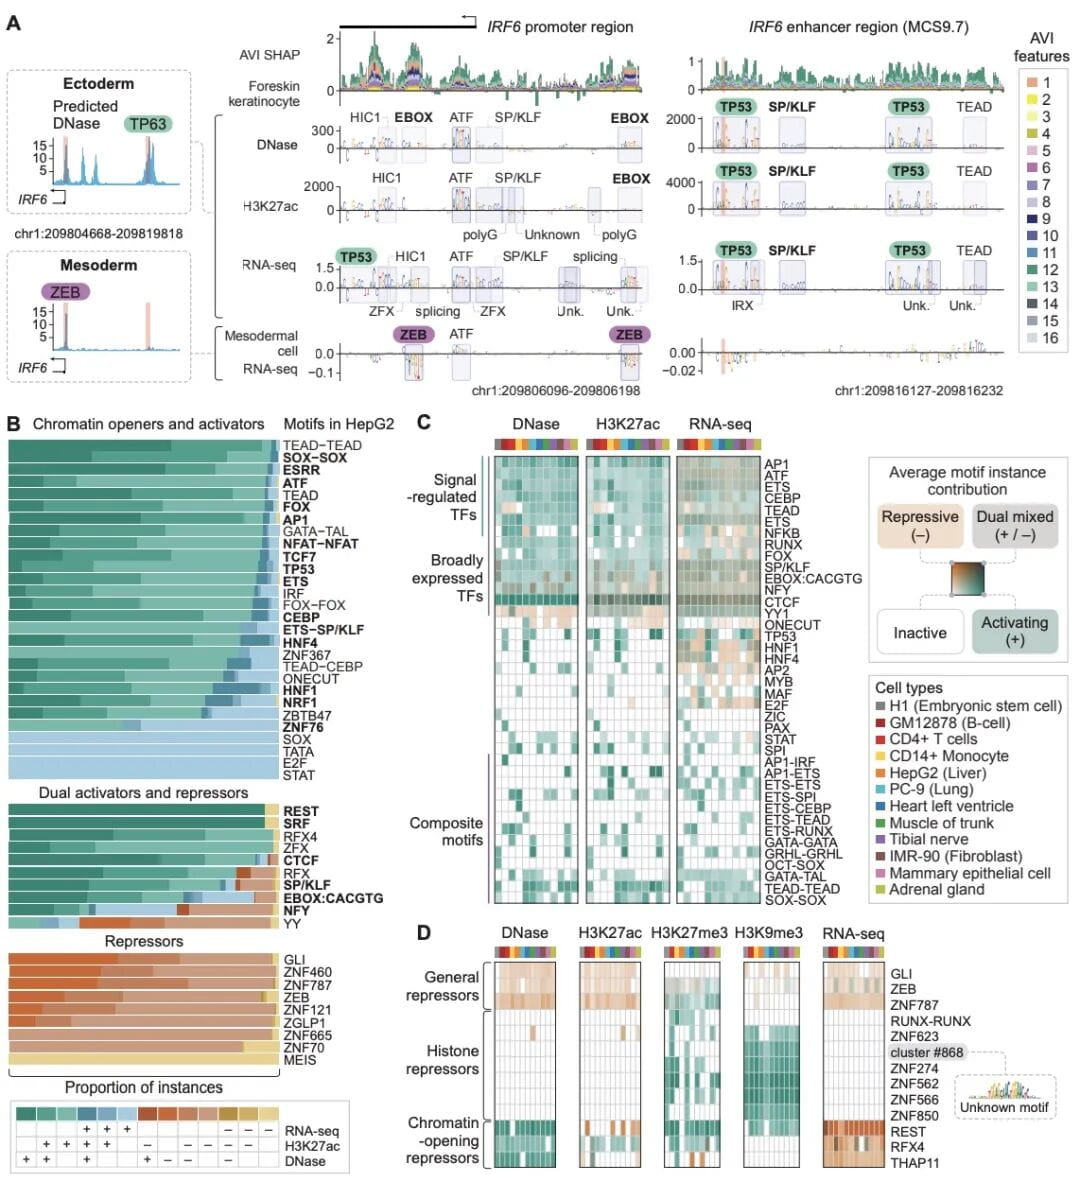
基因组调控不是随机的,而是依赖于特定的 DNA 序列模式——即基序。不同转录因子识别不同的基序,从而在特定细胞类型中激活或抑制基因。
斯托尔斯医学研究所的 Julia Zeitlinger 和 Melanie Weilert 利用 AlphaGenome Atlas 的高分辨率预测,系统性地分析了这些基序的功能差异。他们发现,有些转录因子结合后仅使染色质变得开放(即可及性增加),但并不直接启动转录;而另一些则能同时打开染色质并强力激活基因表达。
这种区分过去很难通过实验大规模实现,因为需要在多种细胞类型中逐一敲除转录因子并测量下游效应。而现在,只需查看 Atlas 中对应基序变异的预测轨迹,就能推断其功能层级。这为理解基因调控网络的逻辑提供了新视角。
不是终点,而是加速器
AlphaGenome Atlas 并不声称能完全替代湿实验。它的价值在于 大幅缩小搜索范围,把研究人员从“大海捞针”变成“在一小片海域重点打捞”。无论是临床遗传学家解读患者变异,还是基础科学家探索调控机制,都能从中获得可操作的假设。
DeepMind 表示,未来计划将 Atlas 扩展到更多物种,并纳入结构变异(如插入、缺失、倒位)的预测。同时,他们正与制药公司合作,利用该工具识别新的药物靶点——尤其是那些位于非编码区、传统方法难以触及的调控元件。
对于生命科学领域来说,这或许标志着一个转折点:我们不再只是被动读取基因组序列,而是开始主动预测每一个字母变化的后果。那片曾被视为“暗物质”的 98%,正在逐渐亮起。