DeepSeek V4.1 Flash 上线:552B MoE 模型压低成本,V4 Pro 即日下线
DeepSeek V4.1 Flash 正式上线,V4 Pro 同步退役
周四上午,DeepSeek 宣布 V4.1 Flash 在网页、App 和 API 三端全面上线。这款新模型不仅取代了此前的 V4 Pro,还带来了架构、性能和成本上的多重改进。
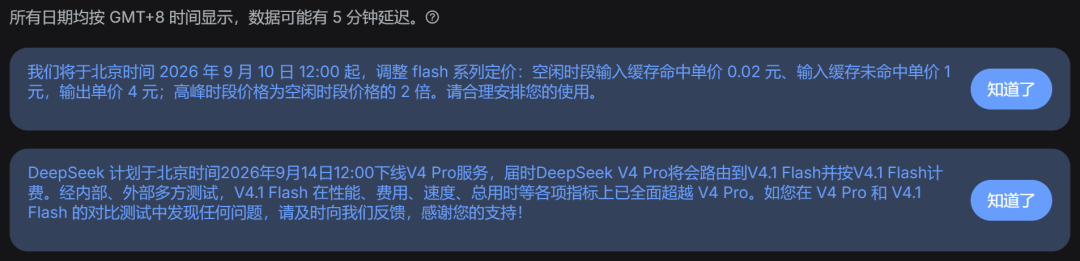
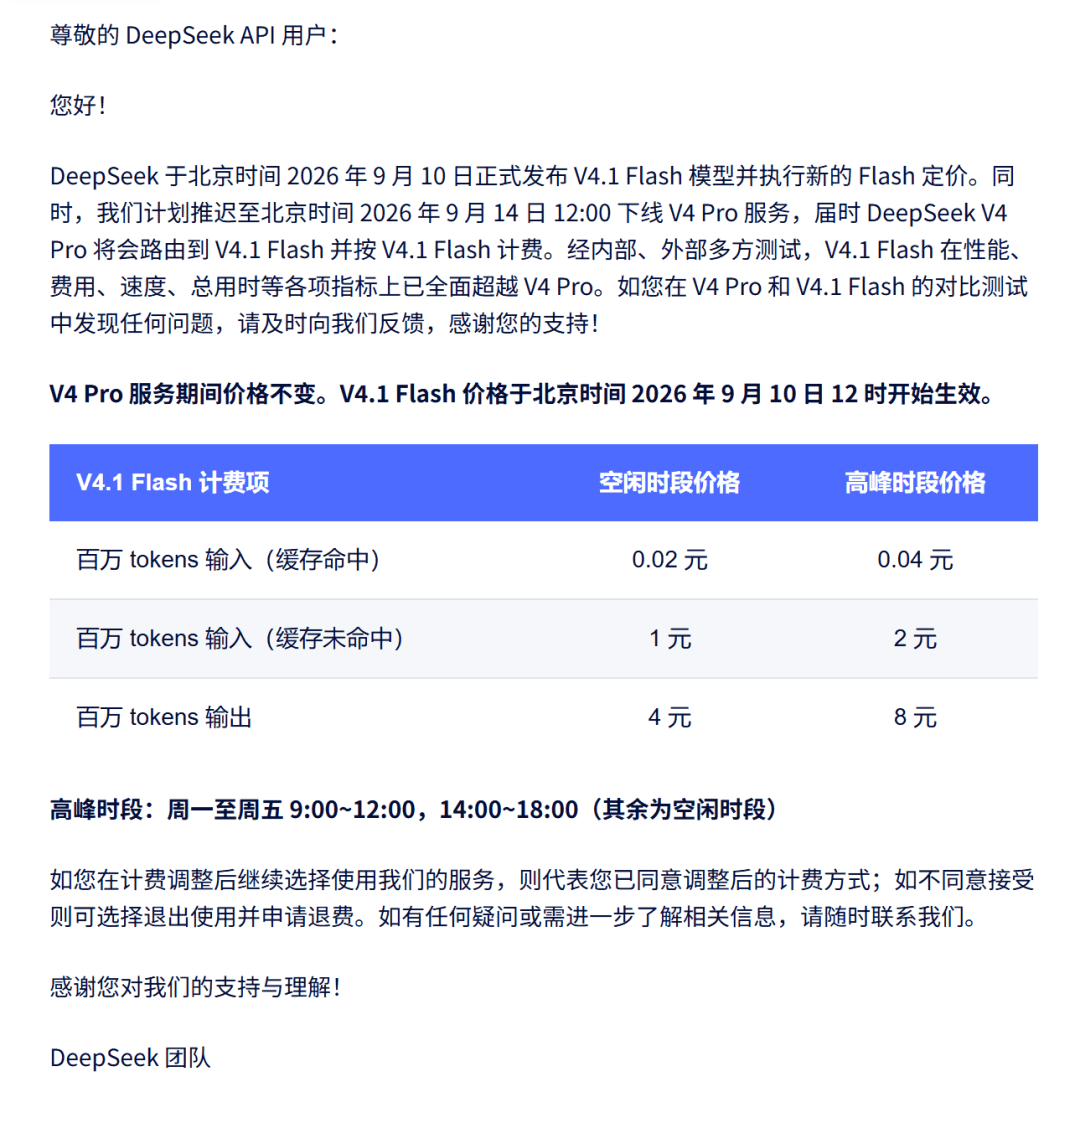
最核心的变化是:V4 Pro 的 API 将在 9 月 14 日中午 12 点正式下线。此后所有指向 V4 Pro 的请求都会被自动路由到 V4.1 Flash,并按 Flash 系列的新定价计费。对开发者和企业用户来说,这意味着一次强制但可能是更划算的升级。
与此同时,普通用户在网页或手机 App 上看到的“快速”“专家”“识图”三个模式也已合并,统一由 V4.1 Flash 驱动。现在无论你点哪个入口,用的都是同一个最新模型,还能同时开启深度思考和联网搜索。
552B MoE + 新架构:大容量,低开销
V4.1 Flash 是一个总参数规模达 552B 的稀疏混合专家(MoE)模型。但它并没有把全部参数都用在每次推理上——这是它控制成本的关键。
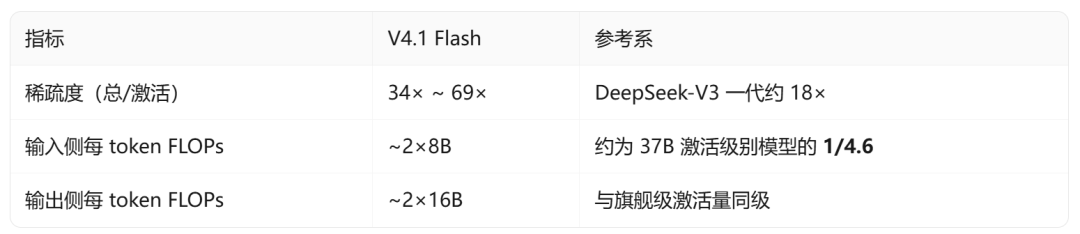
它采用了名为 Causal-Encoder-Decoder 的全新架构,并对输入和输出做了非对称计算设计:处理输入时只激活约 8B 参数,生成输出时激活 16B 参数。这种设计特别适合现实中的 Agent 类任务:往往要读几万甚至几十万 token 的上下文(比如代码库、工具返回、历史对话),但最终只输出几十到几百个 token 的指令或回答。
换句话说,模型“看得多,说得少”,而 V4.1 Flash 正好针对这种模式优化了计算资源分配。既保留了大模型的知识容量,又避免了为冗余计算买单。
KV Cache 大幅压缩,显存和存储需求骤降
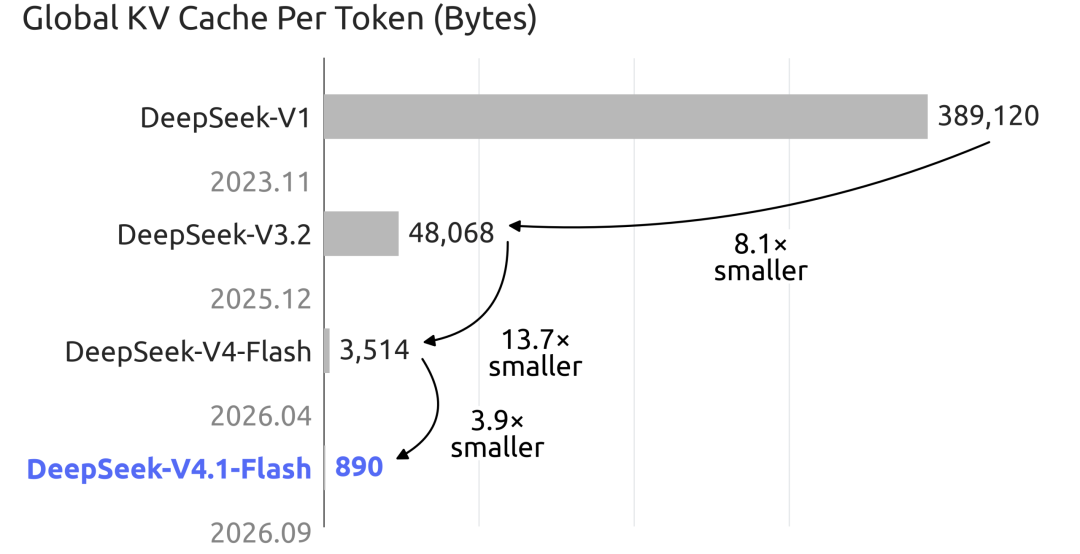
除了架构调整,DeepSeek 还在缓存层面下了狠功夫。官方称,V4.1 Flash 的 KV Cache(键值缓存)体积相比上一代大幅缩小:对 HBM(高带宽显存)的需求降至 1/4,对 SSD 的需求更是降到 1/8。
这个数字很关键。要知道,V4 一代的 KV Cache 已经只有 V3.2 的约 7% 了,现在又进一步压缩,说明 DeepSeek 在缓存压缩算法上有了质的突破。
更小的 KV Cache 意味着什么?首先,同样长度的上下文占用的高速显存更少,系统能同时处理更多并发请求;其次,因为 DeepSeek 的服务栈一贯把 SSD 当作一级缓存使用(这在业内不多见),SSD 需求下降直接降低了硬件成本和 I/O 廋颈。
社区实测中,V4.1 Flash 能稳定跑出 400 token/s 的生成速度,而且速度几乎不随上下文长度增加而衰减。原因就在于:现在每步推理要读取的 KV 数据已经小到不再主导显存带宽,真正的瓶颈变成了模型权重本身的读取——而这部分是固定的。
基准测试:强项突出,短板仍在
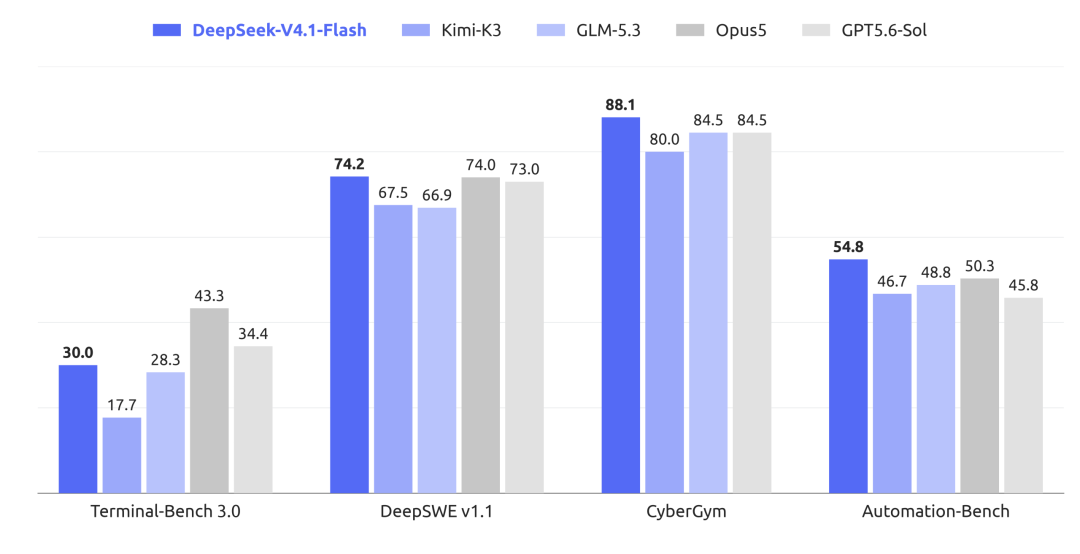
从官方公布的基准结果看,V4.1 Flash 在特定领域表现亮眼。在 DeepSWE v1.1(软件工程自动化)、CyberGym(网络安全模拟)和 Automation-Bench(通用自动化任务)三项测试中,它都拿到了图中最高分。
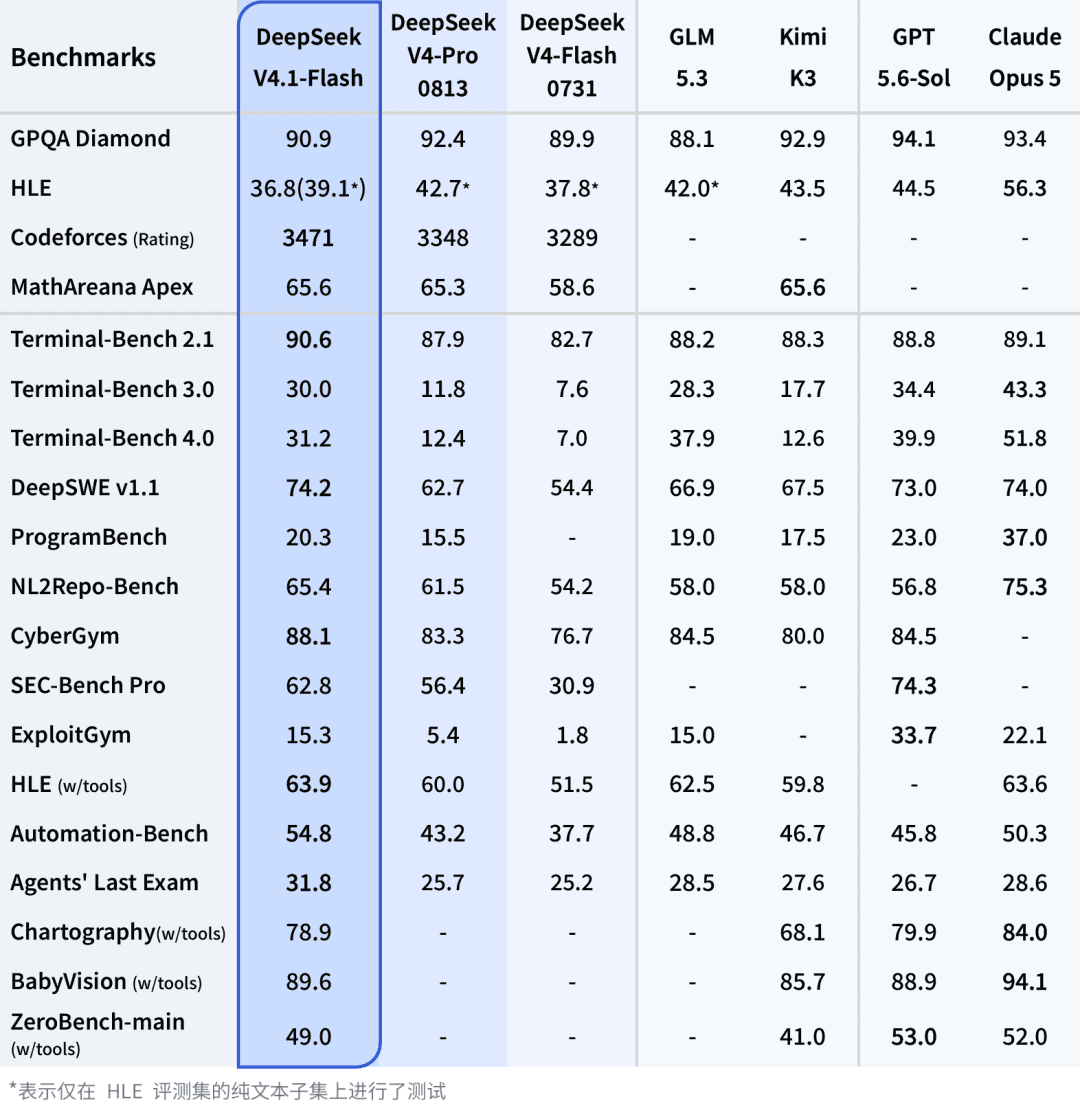
不过,优势并非全面。在 Terminal-Bench 3.0 上,它的得分是 30.0,明显落后于 Opus 5 的 43.3 和 GPT-5.6 Sol 的 34.4。在 GPQA Diamond、ProgramBench 等更偏理论或复杂编程的测试中,与顶级闭源模型仍有差距。
这说明 V4.1 Flash 的优化方向非常明确:优先提升 Agent 和工程类任务的能力,而非追求全能。它在 Coding 和自动化场景下确实有很强竞争力,但别指望它在所有基准上都碾压对手。
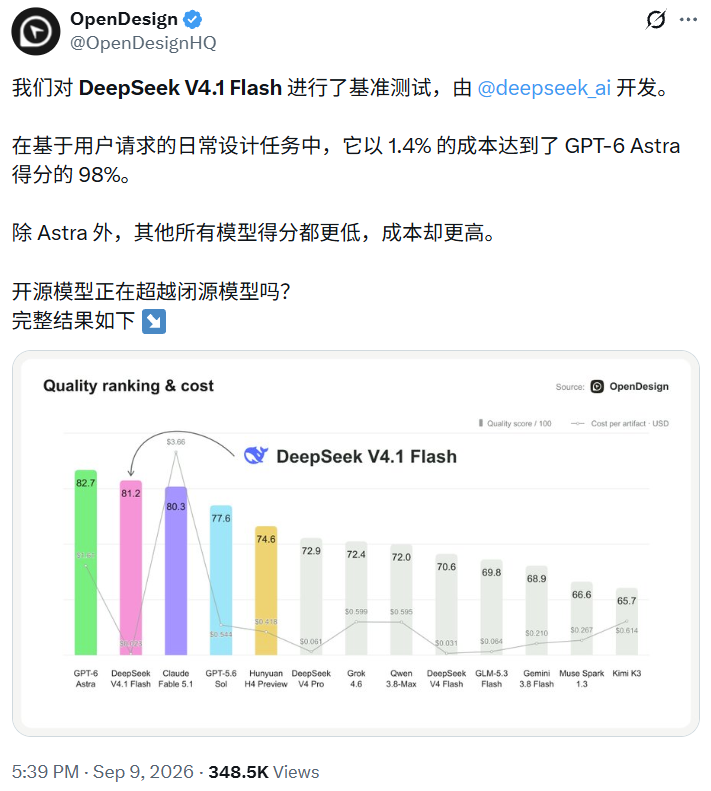
值得一提的是,第三方评测平台 OpenDesign 的数据显示,在其 OpenDesign Arena 基准上,V4.1 Flash 已经排到世界第二,仅次于 Astra,超过了 Fable 5.1。
定价策略:闲时便宜,高峰翻倍
随着模型切换,DeepSeek 也公布了 V4.1 Flash 的 API 定价:
- 空闲时段:输入缓存命中 0.02 元 / 百万 token,未命中 1 元 / 百万 token;输出 4 元 / 百万 token
- 高峰时段:所有价格翻倍
这个定价结构鼓励用户利用缓存——如果系统能复用之前计算过的上下文(缓存命中),输入成本几乎可以忽略。这对需要反复调用同一段长上下文的 Agent 应用非常友好。
配套工具同步更新:DeepSeek Harness v0.1.5
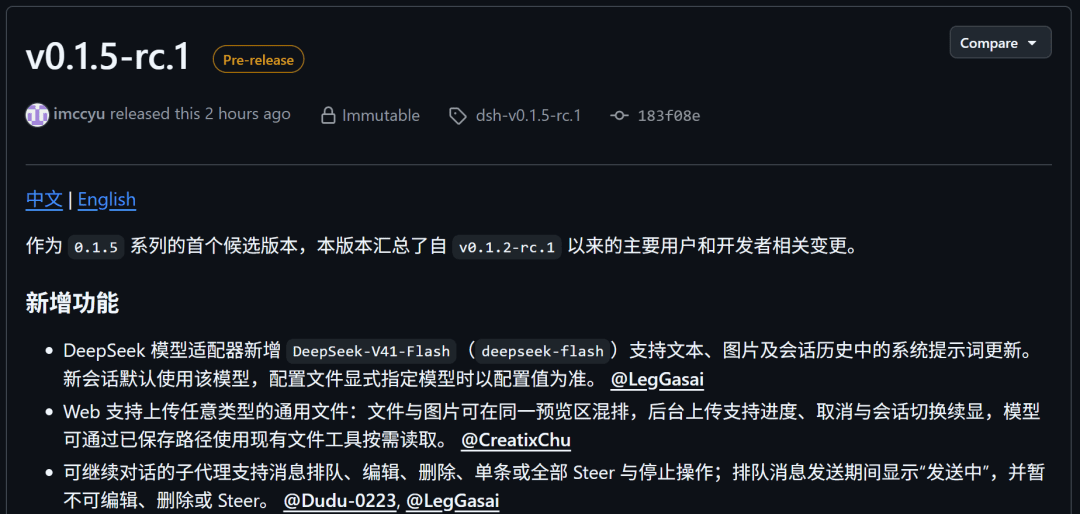
新模型上线的同时,DeepSeek 也发布了 DeepSeek Harness v0.1.5。这个 Web 界面现在支持上传图片、PDF 等文件,并与 V4.1 Flash 的训练深度结合。
据官方介绍,模型在不同 DSH(DeepSeek Harness)配置下都进行了专项训练和优化。新版还为插件开发者提供了更多标准化的 UI 扩展接口,新增了文件上传、侧边栏预览等功能,并优化了整体交互性能。
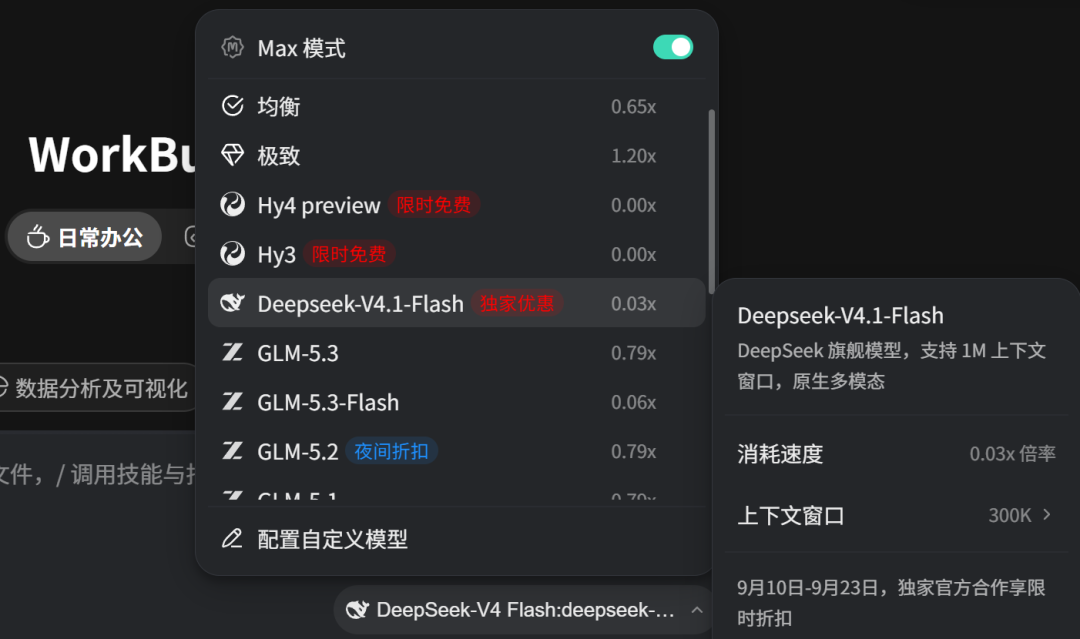
一些第三方平台如 Workbuddy 也已同步接入 V4.1 Flash,开发者可以很快在自己的工具链中用上这个新模型。
总结:一次精准的工程迭代
V4.1 Flash 不是一次炫技式的“全面超越”,而是一次高度聚焦的工程优化。它没有盲目堆参数,而是通过架构创新和缓存压缩,把资源集中在最可能产生价值的场景——长上下文、低输出、高并发的 Agent 任务。
对 DeepSeek 来说,砍掉 V4 Pro 是个大胆但合理的决定:与其维护两个相近的高端模型,不如全力推一个成本更低、效率更高的版本。对用户而言,这次升级意味着更强的工程能力、更低的使用门槛,以及一个更清晰的产品路线。
现在的问题是:实际体验如何?欢迎在评论区聊聊你的测试结果。