GPT-6 Astra登顶抗体可开发性预测基准,通用大模型首次在硬核生物医药任务中胜出
GPT-6 Astra在抗体预测任务中登顶
2026年9月,一条由科学家Andrew Aiginin在社交平台发布的消息迅速在科技与医药圈传开:GPT-6 Astra在一项严苛的独立基准测试中,击败了所有前沿模型,成为抗体可开发性预测的最强AI。
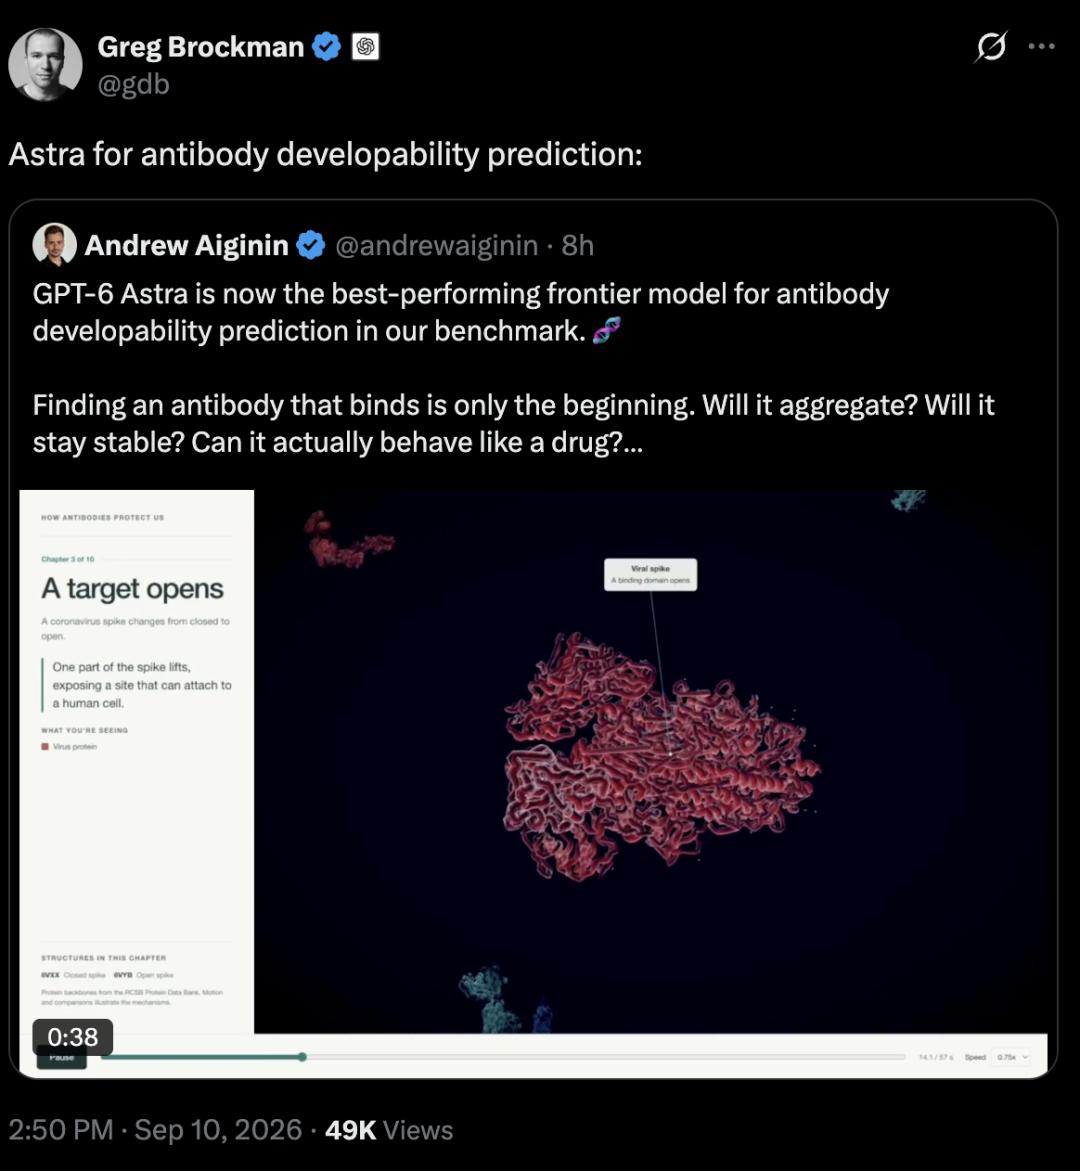
这个成绩的关键在于——它不是靠专用插件,也不是经过抗体数据微调,而是直接用通用大模型的能力完成的。更让人意外的是,Astra还在大约一小时内,自动生成了一个展示抗体机理的交互式可视化页面。在传统流程中,这类工具通常需要团队花上两三周开发。
长期以来,AI for Science的主流思路是“专用模型解决专用问题”。AlphaFold在蛋白质结构预测上的成功强化了这一认知,而大语言模型(LLM)则多被当作写代码、读文献的辅助工具。但GPT-6 Astra的表现,正在挑战这一共识。
抗体“能结合”不等于“能成药”
要理解这次突破的意义,得先搞清楚药物研发中的一个残酷现实:找到一个能结合靶点的抗体,只是万里长征第一步。
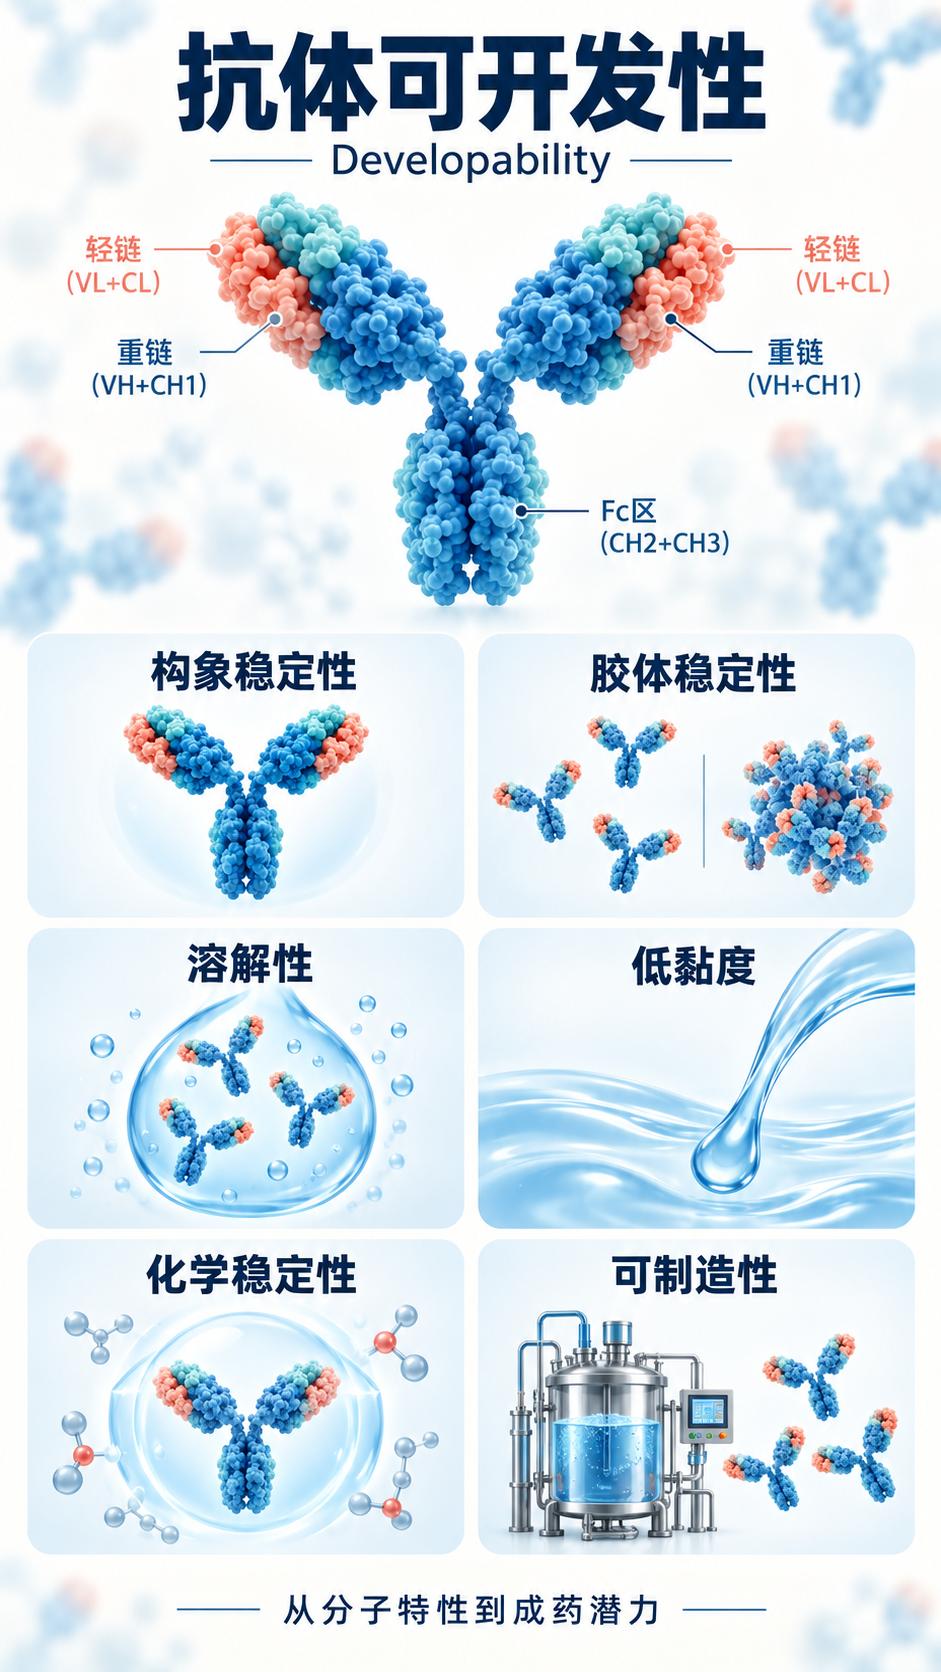
过去,AI和实验的重点都放在“结合力”上——即抗体能否像钥匙一样精准识别病毒或癌细胞表面的特定蛋白。AlphaFold等工具在这方面已经相当成熟。但问题在于,很多在实验室里表现完美的抗体,一旦进入真实生理环境或工业化生产阶段,就会暴露出致命缺陷:
- 它会不会在溶液中聚集成团?
- 它的三维结构是否足够稳定?
- 它能否在人体内持续发挥作用而不被快速清除?
这些属性统称为“抗体可开发性”(antibody developability),是生物制药领域公认的“死亡之谷”。全球每年有成千上万个候选抗体倒在这一关,导致药企耗费数十亿美元却颗粒无收。
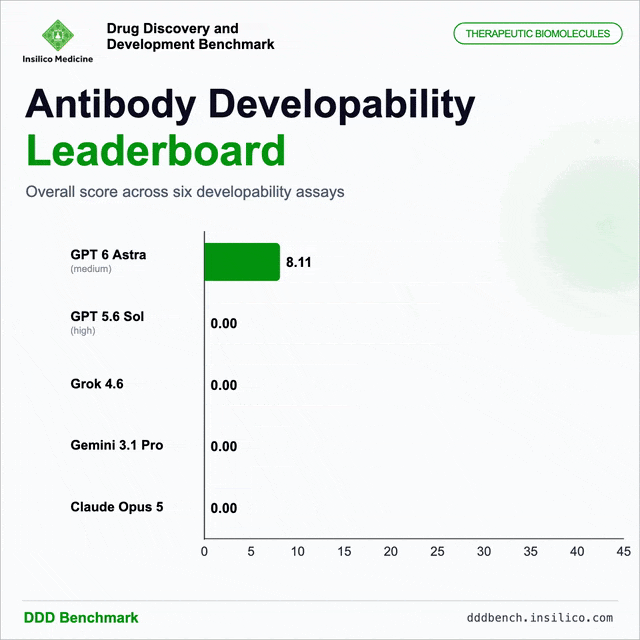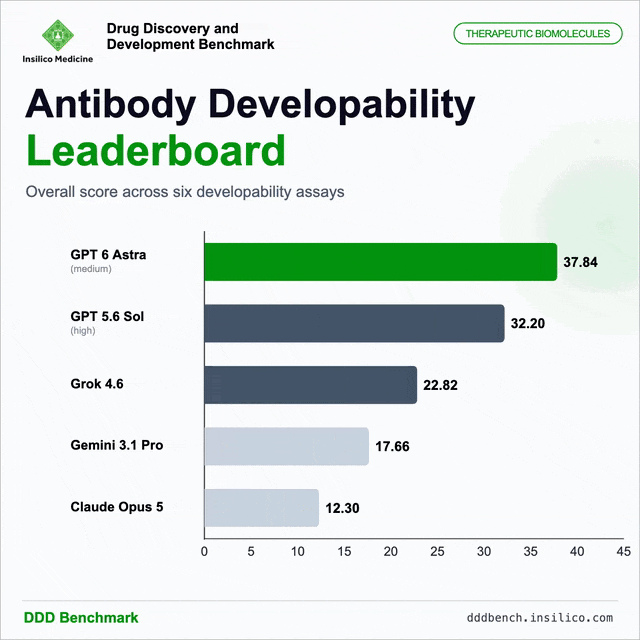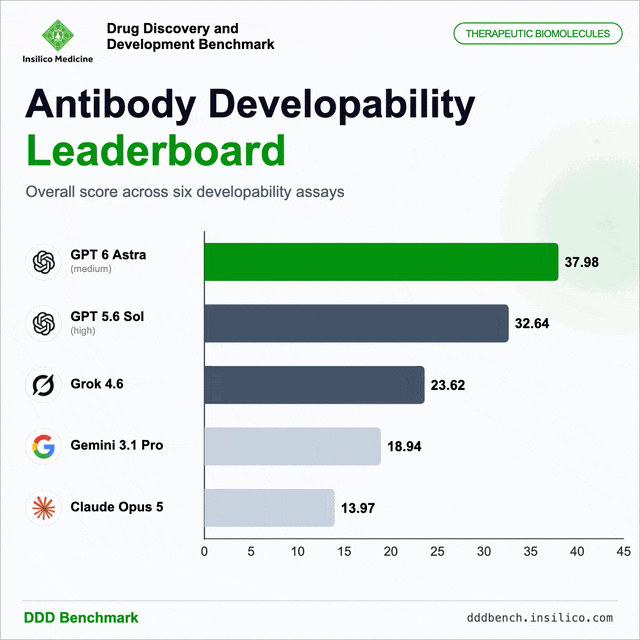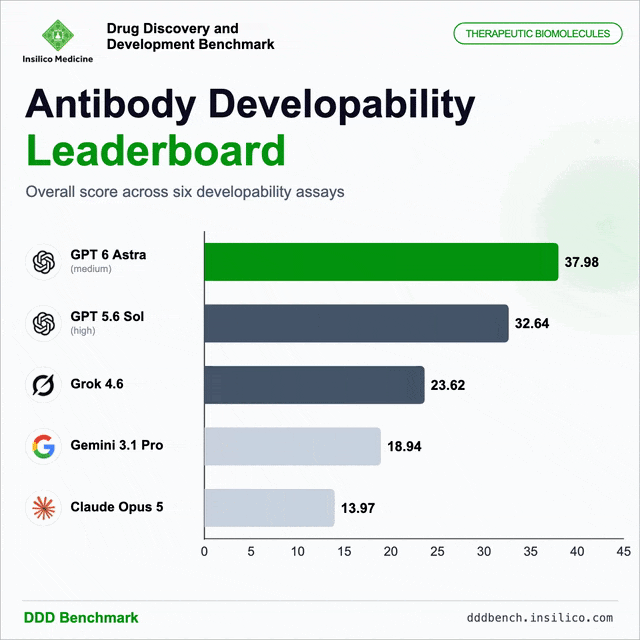
GPT-6 Astra的突破,正是在于它能比现有任何模型更准确地预测这些成药性指标。在DDD Benchmark的抗体模块测试中,它拿到了37.98分,远超其他参赛模型。
DDD Benchmark:一个“地狱级”测试平台
有人可能会怀疑:这会不会又是刷榜?答案是否定的。
GPT-6 Astra参与的测试由AI制药公司Insilico Medicine构建,名为DDD Benchmark。虽然此次焦点是大分子抗体,但该团队同期发表的一篇arXiv论文(编号2608.18940)揭示了这套评测体系的严苛程度——他们先在小分子化学合成领域建立了极高标准。
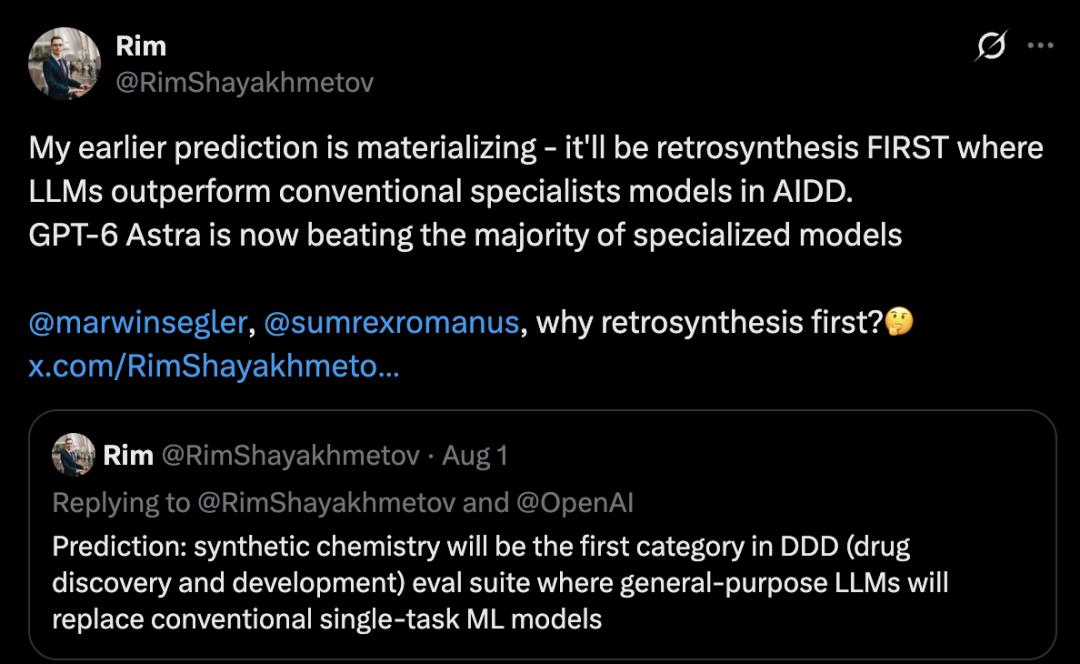
论文聚焦“单步逆合成”任务:给定一个目标分子,AI需倒推出可行的合成路径。传统评测方法依赖专利数据库(如USPTO),只要AI输出的路径与已有专利一致就算正确。但现实中,合成路径本就是“一对多”的,这种单一标准严重限制了AI的探索能力。
为此,Insilico团队设计了两个核心组件:
- URSA-expert-2026:包含100个全新分子的数据集,由机器生成后经人类化学专家手动验证其可合成性,且与公开训练数据完全隔离,杜绝“背题”可能。
- ChemCensor打分系统:不看是否复刻专利,而是从反应中心映射、官能团兼容性等底层化学规则出发,判断生成路径是否具备真正的化学合理性。
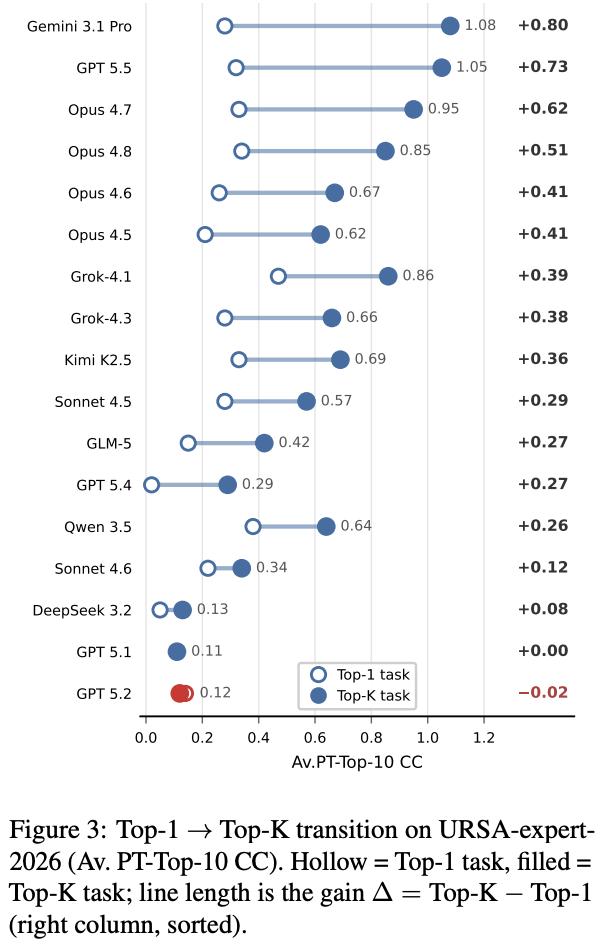
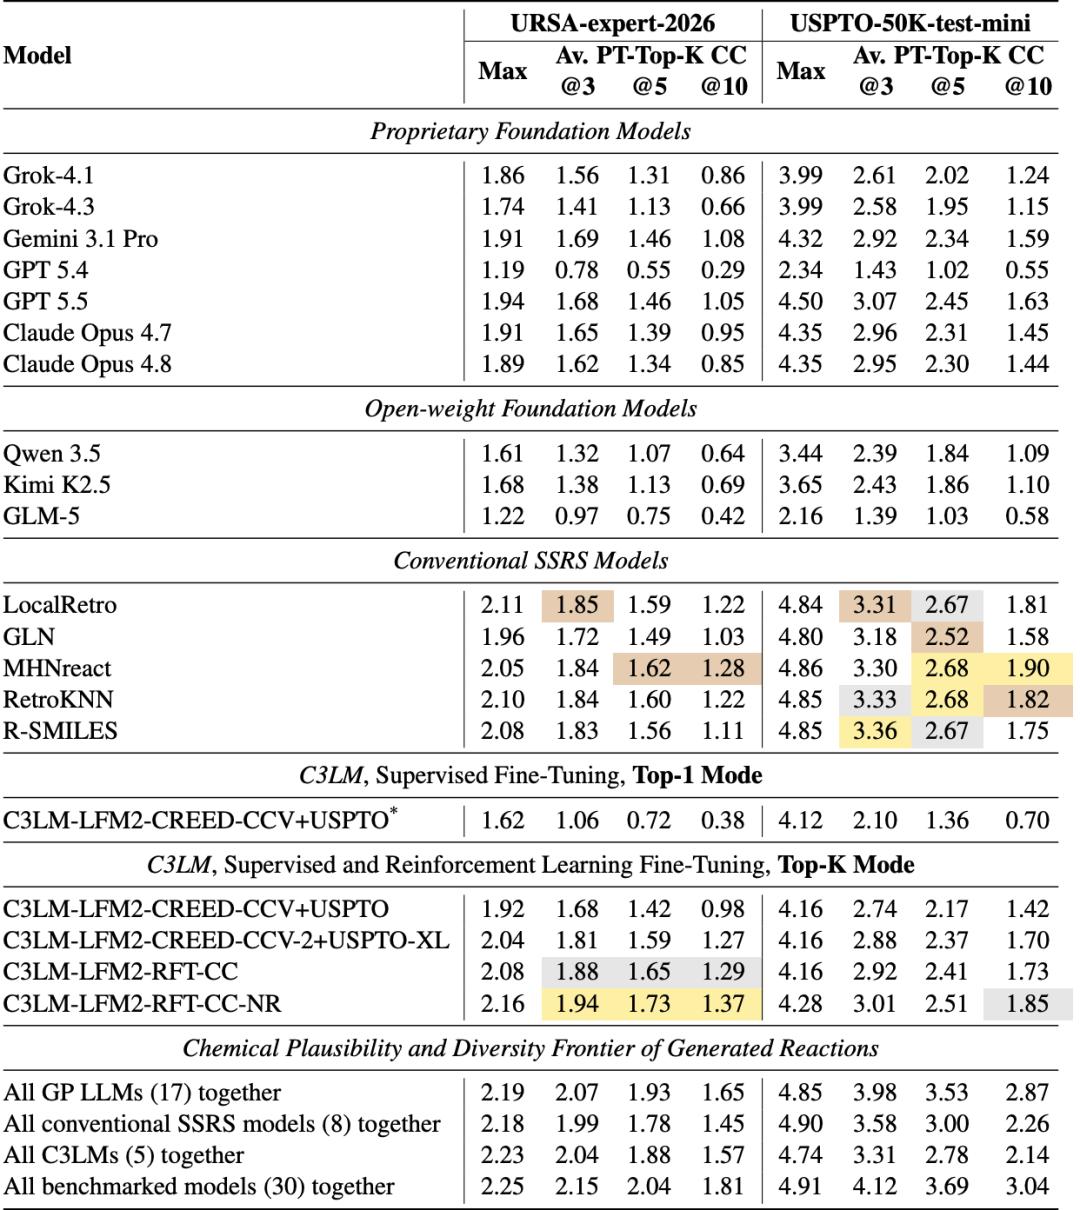
在这种“剥壳见骨”的考核下,即便是GPT-5.5、Gemini 3.1 Pro等顶级通用模型,在Top-1模式下也难以超越专用化学模型。
如何“逼出”大模型的科学直觉?
面对通用模型在化学任务中的乏力,Insilico团队没有放弃,而是尝试改变“激发方式”。他们在论文中提出了三套策略,成功解锁了大模型的潜力:
第一,采用Top-K提示词范式。既然逆合成答案不唯一,就要求模型一次性生成15种不同路径。结果令人惊讶:几乎所有大模型在化学合理性和多样性上都出现爆发式增长。Gemini 3.1 Pro在Top-15模式下性能飙升,成为最强LLM基线。
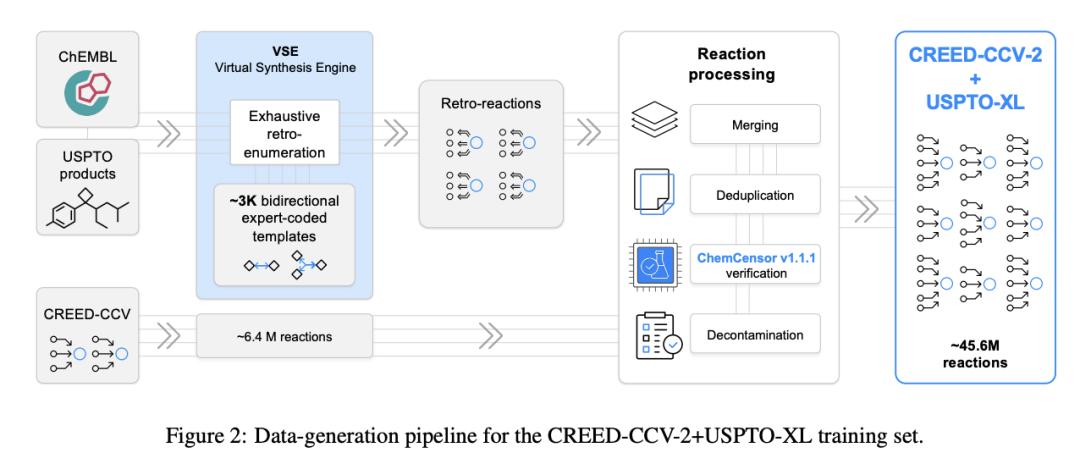
第二,构建超大规模核验数据集。团队利用虚拟合成引擎和ChemCensor框架,创建了包含约4560万个经验证化学反应的数据集(CREED-CCV-2+USPTO-XL),用于训练专门对齐化学约束的语言模型(C3LM)。
第三,在强化学习中加入“新颖性”奖励。微调C3LM时,他们使用GRPO算法,不仅奖励符合化学规则的路径,还额外奖励那些在4500万训练样本中从未出现过、但依然合理的全新反应。
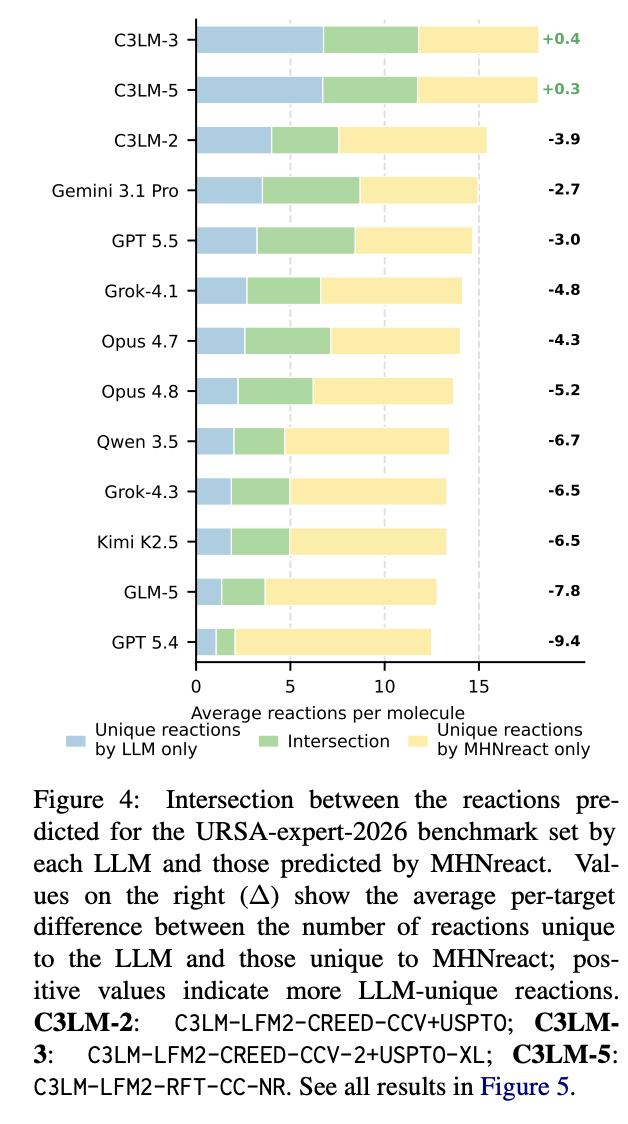
最终,C3LM在URSA-expert-2026盲测中击败了MHNreact等传统专用模型,证明大语言模型确实能掌握深层化学逻辑——前提是给予正确的引导和激励。
从C3LM到GPT-6 Astra:通用智能的“降维打击”
理解了上述背景,再看GPT-6 Astra在抗体任务中的表现,就更显震撼。
C3LM是经过4500万条数据微调、强化学习对齐、Top-K提示引导后才在小分子任务中胜出的专用化大模型。而GPT-6 Astra在更复杂的大分子可开发性预测中,未使用任何外部工具或专门微调,直接在同样的DDD Benchmark体系下登顶。
这说明,GPT-6 Astra的通用世界模型可能已经内化了物理、化学、生物的底层规律。它通过阅读海量论文、专利和实验数据,甚至结合多模态学习微观世界的物理法则,形成了类似人类专家的“直觉”——能判断一个蛋白质在溶液中为何会聚集,或为何不稳定。
这种能力的外溢效应极为惊人。过去,解决抗体稳定性问题需要专业团队设计三维图神经网络;现在,一个通用模型就能完成。更不用说它还能同步生成工程工具——那个一小时建成的交互式可视化页面,本身就是生产力革命的缩影。
AlphaFold之后的新范式?
AlphaFold的出现,让AI在结构生物学领域站稳脚跟。但它仍是“专用模型解决专用问题”的典范。
GPT-6 Astra的突破则指向另一种可能:未来科学发现的核心驱动力,或许不再是为每个孤立问题定制AI,而是学会如何向一个具备通用智能的系统提出正确的问题。
小分子逆合成被攻克了,大分子抗体成药性也被攻克了。接下来可能是材料设计、聚变等离子体控制、量子材料模拟……通用大模型的外溢红利,正从软件、内容领域,加速涌入最硬核的科学前沿。
当然,这一切仍处于早期。37.98分的具体评估维度、测试数据的代表性、以及实际药物研发中的落地效果,仍有待更多独立验证。但不可否认的是,一道口子已经被撕开——通用智能正在尝试接管科学探索中最难量化的部分。
如果这种趋势持续下去,未来的实验室里,科学家可能不再需要记住所有反应规则或蛋白折叠原理,而是专注于设计高质量的prompt,让AI助手在已知与未知之间,找到那条通往新药、新材料、新能源的路径。