世界模型到底是什么?李飞飞、朱军等如何定义它的能力边界
世界模型:一个被过度使用的词
2026年,“世界模型”成了AI圈里最模糊的术语之一。一段连续生成的视频,有人称它为世界模型;一个能随鼠标操作实时变化的虚拟场景,也被贴上同样标签;在潜空间里预测未来状态的系统,甚至直接输出机器人动作的策略,也都叫世界模型。
这些系统确实在处理“世界”的信息,但能力边界天差地别。视频可以逼真到以假乱真,却可能违反基本物理规律;机器人能完成一次抓取,也可能只在固定光照、特定物体和预设轨迹下有效。仅看演示,很难判断一个模型学到的是视觉相关性、物理结构,还是行动与结果之间的因果关系。
概念混乱让技术比较变得困难。画质、几何精度、预测准确率和任务成功率被混在一起讨论,不同团队看似在同一条赛道竞争,实际回答的可能是完全不同的问题。
于是,研究者开始回到一个更基础的问题:一个系统究竟需要具备哪些能力,才能从“生成内容”走向“理解并改变世界”?
李飞飞的三分法:渲染器、模拟器、规划器
李飞飞和她创立的World Labs提出了一种功能导向的分类方式。他们将世界模型拆解为三个组件:
- 渲染器:输入世界状态,输出像素(即图像或视频);
- 模拟器:输入当前状态和动作,预测下一状态;
- 规划器:输入目标和当前状态,输出达成目标的动作序列。
这种划分强调了世界模型的不同职责。渲染器负责“看见”,模拟器负责“推演”,规划器负责“决策”。三者可以独立存在,也可以组合成一个完整系统。
例如,一个视频生成模型本质上是一个强大的渲染器,但它未必包含有效的模拟器——它可能只是学习了画面之间的统计关联,而无法回答“如果我推这个杯子,它会往哪边倒?”这类反事实问题。
朱军的闭环框架:理解、想象、行动
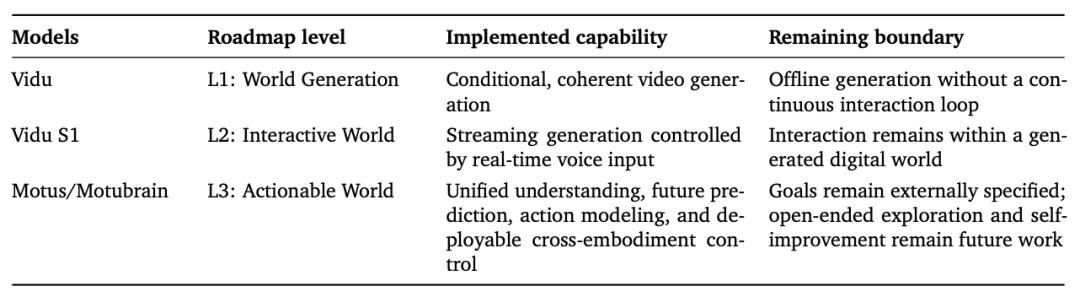
清华大学朱军团队则从认知科学和强化学习的角度出发,提出了另一个视角。他们在2025年底发布的Motus系统中首次阐述“通用世界模型”(General World Model, GWM)的构想,并在今年3月进一步将其定位为连接数字世界与物理世界的基础设施。
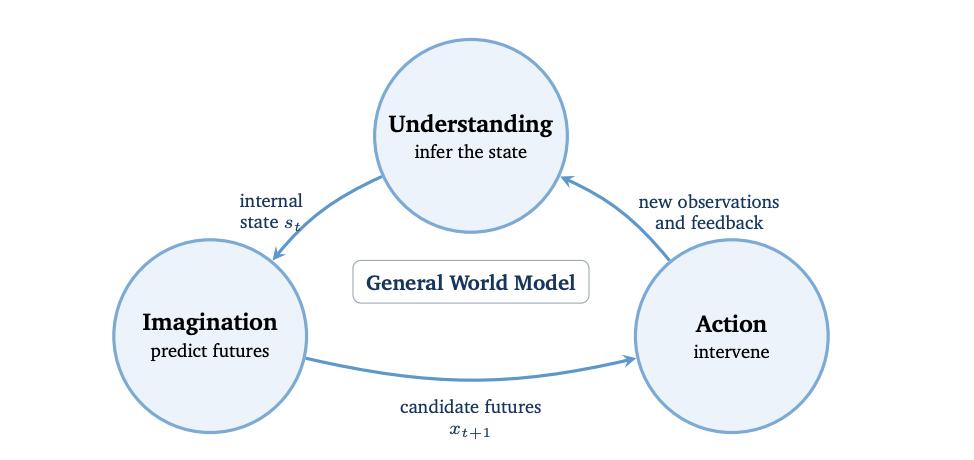
在论文《General World Models from First-Principles》中,团队从第一性原理出发,将通用世界模型的核心能力归纳为三项:
- 理解(Understanding):整合视觉、语言、声音、触觉或机器人传感器等多模态信息,形成对当前世界状态的内部判断;
- 想象(Imagination):从当前状态出发,推演多个可能的未来,尤其是“如果我执行动作A而非B,结果会怎样”这类干预性预测;
- 行动(Action):将预测转化为对数字或物理环境的实际干预,并用行动后的新观测来检验和修正模型。
这三项能力构成一个持续更新的闭环。理解是起点,想象是中间过程,行动是验证手段,而新观测又成为下一轮理解的输入。
这个框架解释了为什么单纯的视频生成不等于世界模型。视频模型能预测“接下来画面会怎样”,但要成为真正的世界模型,它必须能回答“如果我改变某个条件,世界会如何不同?”——这涉及因果推理、反事实推演和可执行决策。
五级进化路线图
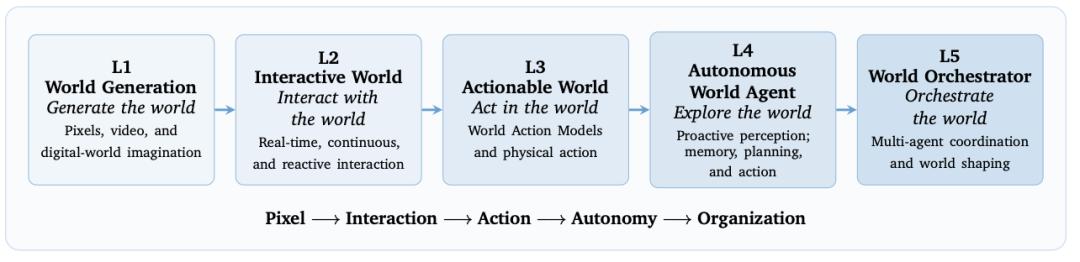
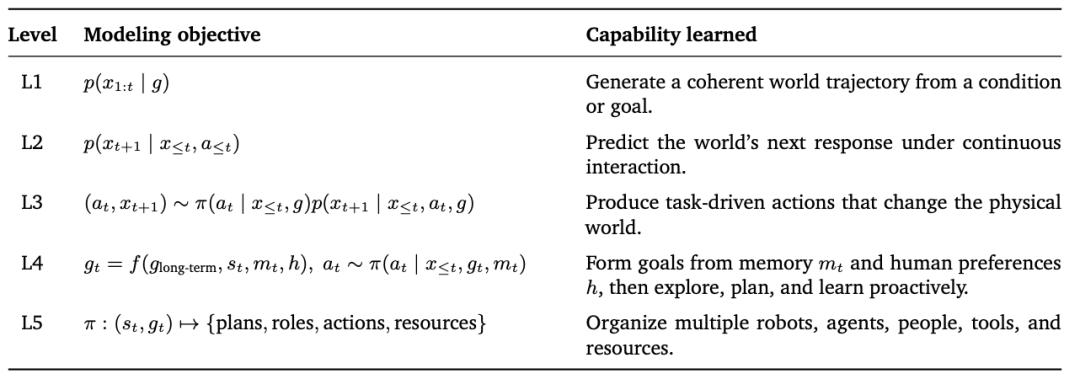
为了描述世界模型的能力演进,朱军团队进一步提出了一条五级路线:
- L1:生成世界 —— 能生成连贯的时空动态,如视频;
- L2:交互世界 —— 能响应外部输入(如用户操作),保持世界状态连续;
- L3:在世界中行动 —— 能输出可执行的动作,并接受真实反馈;
- L4:自主世界智能体 —— 能主动探索、设定子目标、从失败中学习;
- L5:世界组织者 —— 能协调多个智能体,在开放环境中组织复杂任务。
用一个具体例子说明:一只玻璃杯被推到桌边。
- L1模型能生成它滑落、撞击、碎裂的画面;
- L2模型允许用户改变推动方向或视角,继续演化场景;
- L3模型则需判断杯子是否会掉落,预测伸手是否来得及,并输出机器人可执行的抓取动作;
- L4模型会主动发现风险,比如注意到桌面湿滑,提前调整策略;
- L5模型则要协调多个机器人,决定谁去抓杯子、谁清理碎片、谁通知人类。
按照论文判断,现有系统已触及L1至L3,L4和L5仍是开放问题。主要缺口包括:因果与物理接地、持久记忆、在线学习、高效部署和安全控制。
数据金字塔:从视频到具身
世界模型的难点不仅在算法,也在数据。
互联网视频规模巨大,记录了丰富的物体、场景和运动模式,模型可从中学习空间结构、物体持续性和事件发展规律。但视频很少同步记录导致变化的动作、力和意图。
机器人轨迹则能连接观测、动作和结果,但采集成本高,且容易绑定特定硬件和任务。
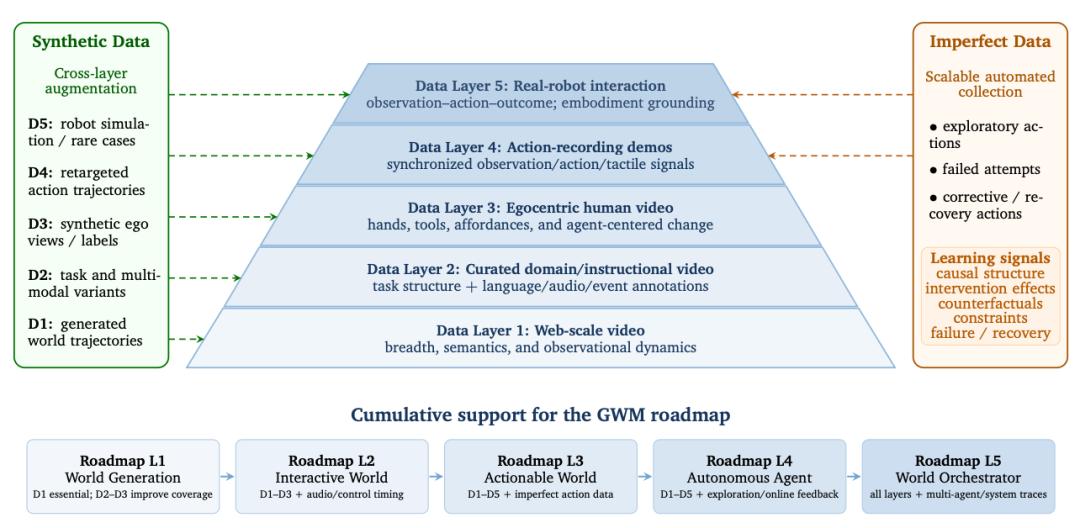
朱军团队提出的解决方案是一座“数据金字塔”:
- 底层:互联网规模视频,提供世界知识的广度;
- 向上依次:领域视频、第一视角人类视频、带动作记录的人类示范;
- 顶层:真实机器人交互数据,完成行动接地。
越往上,数据越稀缺,但动作与本体的对应关系越清晰。
这也解释了为何生数科技同时推进视频生成(Vidu系列)和具身智能(Motus系列)。Vidu S1已支持实时交互,用户输入可持续改变后续内容,测试模型能否在交互中保持状态连续;Motus则将环境理解、状态预测与机器人动作接入同一条链路,接受真实世界的检验。
MoT架构:多模态协同计算
要让数字和物理世界的验证共享底层能力,图像、视频、语言和机器人动作需围绕同一个世界状态协同计算。
传统模块化系统逐级传递信息,容易在接口处损失几何、时间和不确定性信息;而完全共享参数的端到端模型,又可能因海量视频数据压制稀缺的机器人信号。
朱军团队提出的MoT(Mixture-of-Transformers)架构试图平衡两者。不同模态保留各自的专家参数,再通过共享注意力机制交换上下文。视觉告诉模型“发生了什么”,语言提供“目标和约束”,动作带来“干预”,三者共同更新对世界的判断。
MoT提供了统一计算的基础,但物理规律建模、跨本体迁移、实时推理和安全控制仍需依赖数据、训练和系统工程。
Motus2:行动前先在心里试一遍
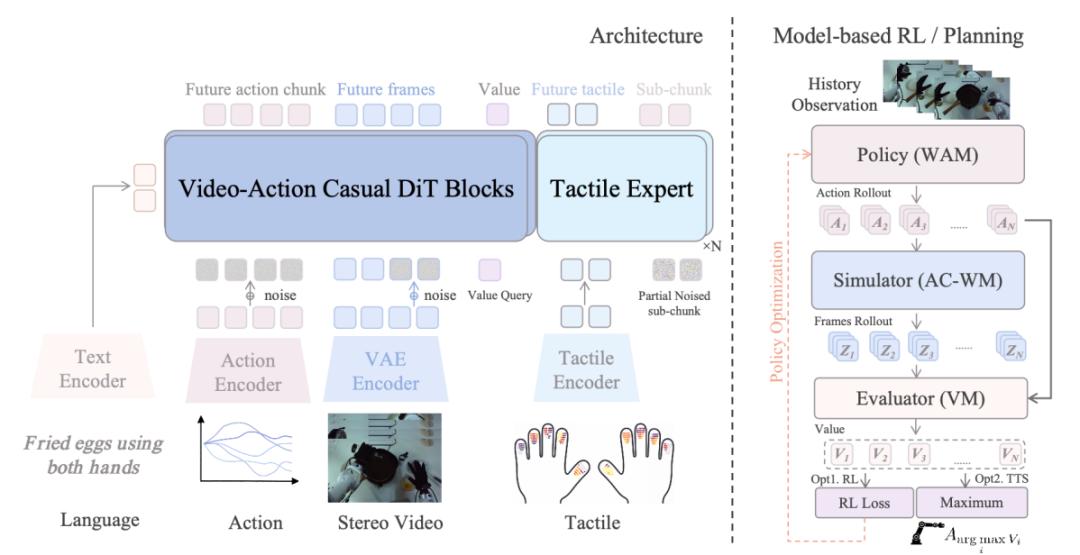
如果说Motus实现了L3能力,那么Motus2则尝试向L4迈进。它没有把动作生成、未来模拟和结果评估做成三个独立系统,而是构建了一套共享参数的视频-动作模型,暴露三种控制接口:
- 策略(Policy):提出候选动作;
- 模拟器(Simulator):预测这些动作在视觉世界中的后果;
- 评估器(Evaluator):判断哪种结果更接近任务目标,并用于选择和改进策略。
这相当于让机器人“先在自己的世界里试一遍”。它不再看到物体就直接输出动作,而是先提出几种方案,在模型中预演各自的结果,再选择最优解。执行后的成功或失败也不再是废料,而是下一轮学习的证据。
在数据方面,Motus2采用分层训练路径:从13万小时人类第一视角视频,扩展到同步双目数据,再通过100多小时机器人轨迹完成本体适配。先积累“人如何与世界互动”的经验,再学习“这具身体如何把理解变成动作”。
在执行层面,Motus2还引入独立的轻量触觉专家,对短动作进行细化,并预测接触后的力反馈。视觉擅长宏观变化,触觉则补上“最后一厘米”的细腻操作,实现即时校正。
目前,Motus2仍处于L3向L4过渡阶段,验证集中在特定任务。自主目标形成、持久记忆、开放泛化等L4能力仍有待探索,但它为闭环自进化提供了一条可检验的路径。
两条AGI入口:语言 vs. 世界
通用世界模型的框架,也延续了朱军及清华TSAIL实验室长期的研究脉络。朱军教授深耕贝叶斯方法、概率机器学习、生成模型与强化学习,分别处理不确定性、数据分布、未来生成和行动决策。
这条学术路径映照出AGI发展的两类入口:
- 一类从语言出发,逐步增强推理、工具调用和任务执行能力(如智谱);
- 另一类从视觉与动态世界出发,走向实时交互和具身行动(如生数)。
两条路线正在相互渗透。语言Agent需要视觉反馈和环境模型,世界模型也需要语言表达目标、规则与计划。最终,两者都指向对语言、世界状态和行动的共同建模。
真正的考验是反馈
世界模型的竞争,终将从Demo的震撼程度,转向系统经受反馈的能力。
画面能制造第一印象,几何和物理决定世界能否被反复使用,而行动则把模型的判断带进现实。一次预测是否成立,要等干预发生后才能确认;一次任务是否成功,也要在陌生场景、长期运行和持续变化中检验。
朱军团队的论文没有给出终极答案,但提供了一组可检验的问题:模型理解了什么?能想象多远?行动之后能否修正自己?
过去十年,AI的进步主要来自学习语言和数据中的统计规律。下一阶段,模型必须面对一个持续变化、可干预、有反馈的真实世界。只有当它能在这样的环境中不断形成判断、承担行动后果并持续学习,世界模型才会从一个拥挤的技术名词,真正成为通向通用智能的基础。