OpenAI被指窃取数学家二十年未发表成果,群论专家公开对峙
数学家晒出邮件:二十年心血被AI“自主发现”
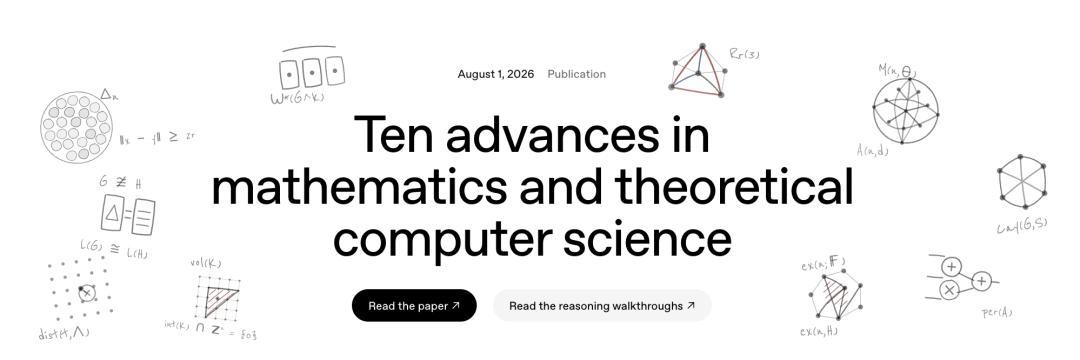
8月初,OpenAI高调宣布其新模型Astra成功攻克十大“菲尔兹奖级”数学难题,其中包括困扰群论领域27年的Gromov柔度猜想。该猜想的核心在于是否存在“非sofic群”——一种理论上可能存在但始终未被构造出的特殊群结构。
消息一出,AI圈一片沸腾,称AGI已打开纯数学发现的大门。但数学界内部却弥漫着不安。
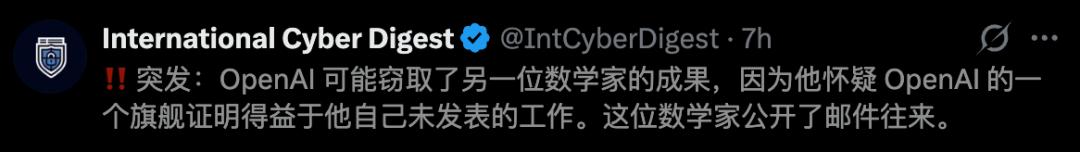
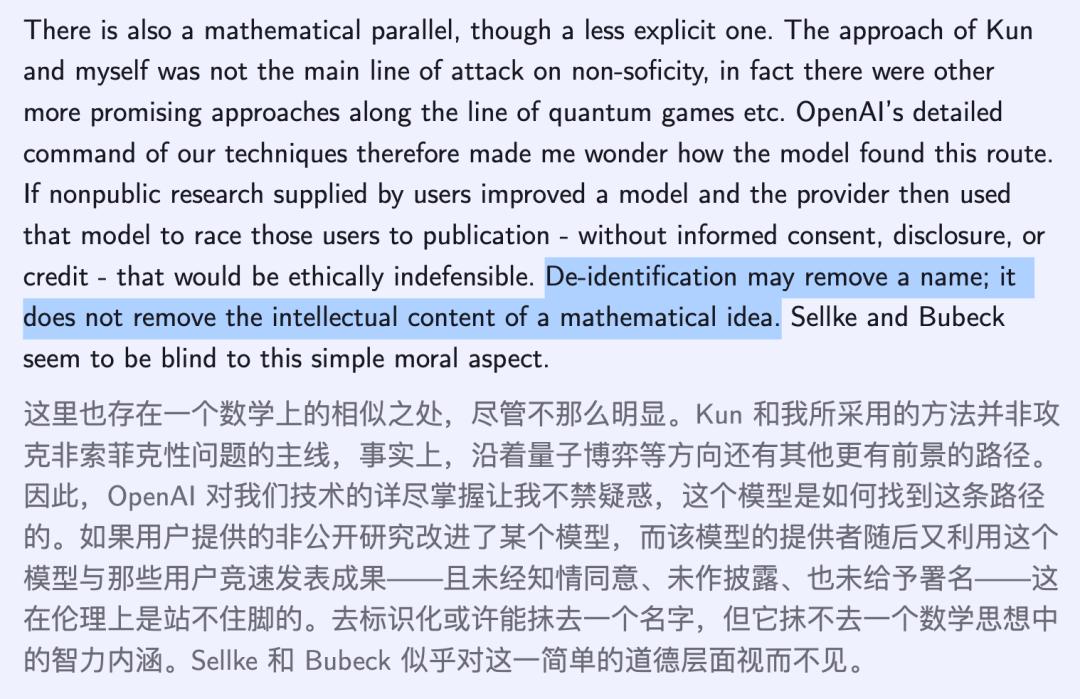
德累斯顿工业大学教授Andreas Thom是这一领域的顶尖专家。过去二十年,他与匈牙利数学家Gábor Kun一直在探索一条非主流路径,试图通过“扩展匹配问题”(expansion matching)来构造非sofic群。这条技术路线极为冷门,学界主流更关注量子博弈或遍历理论等方向。
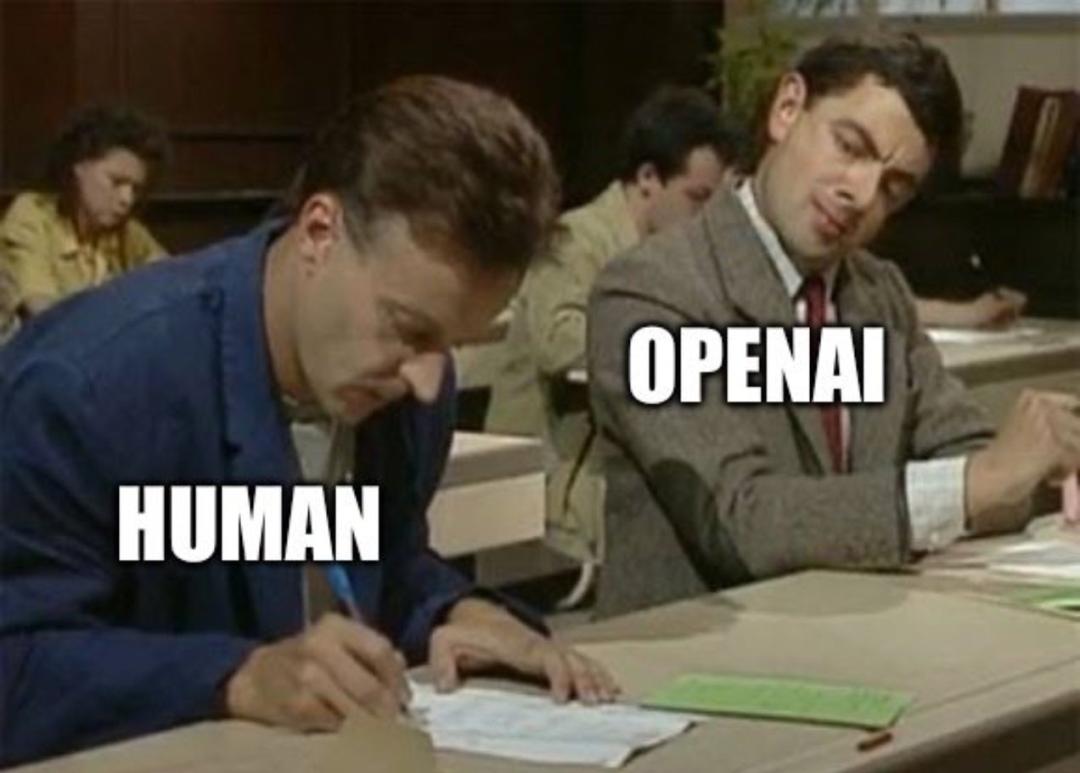
然而,Astra公布的证明中,最关键的几步推导竟与Thom和Kun正在推进的方法高度一致——不仅思路相同,连某些技术细节的处理方式都如出一辙。
“这太奇怪了,”Thom在社交平台写道,“我们的方法不是标准工具,也不是公开文献中的常见策略。AI是怎么精准复现这套逻辑的?”
答案很快浮出水面:过去几个月,Thom曾频繁使用ChatGPT讨论这一猜想。他在对话中输入了大量尚未发表的中间结论、失败尝试和关键引理的草稿。这些内容从未出现在任何预印本或会议报告中,仅存在于他与AI的私密对话里。
如今,这些思考成了Astra“自主突破”的核心。
OpenAI先否认,后改口
察觉异常后,Thom没有立刻公开指责。他于6月底给OpenAI两位研究员Mark Sellke和Sébastien Bubeck发了一封措辞严谨的邮件,提出两个具体问题:
- 用户与ChatGPT的对话是否被用于训练Astra?
- 模型在推理时能否访问这些历史对话?
Sellke的回复只有一句话:“关于你与ChatGPT的对话:那没有发生过。”
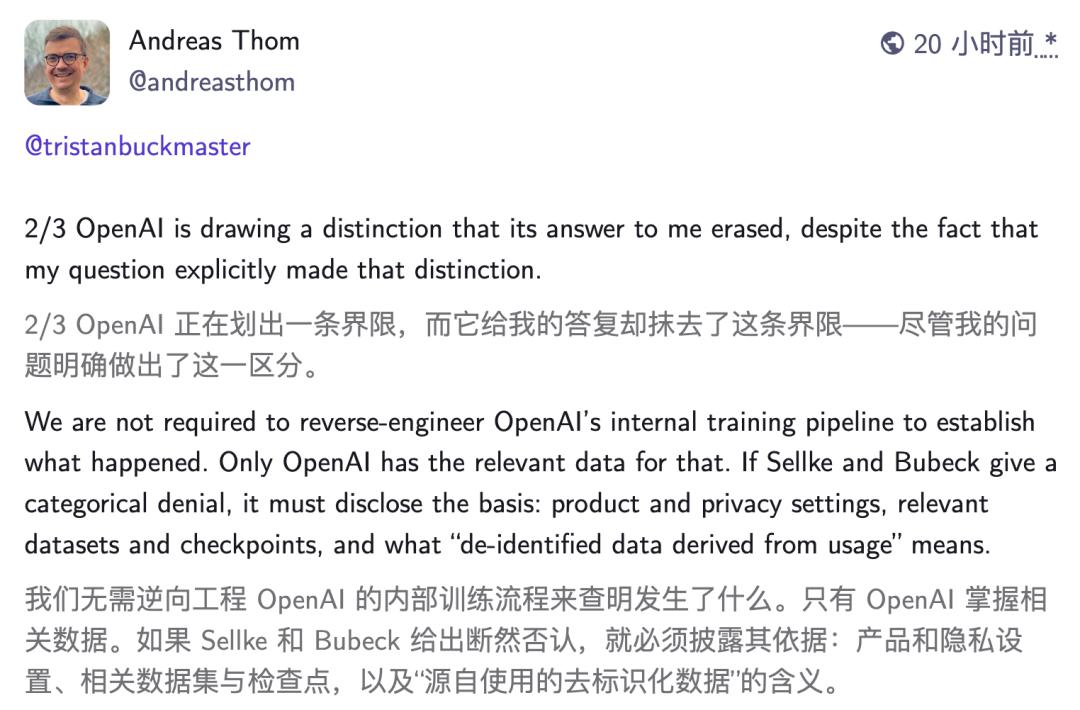
这封简短到近乎粗暴的回信让Thom感到被轻视。他特别指出,自己问的是“是否进入训练数据”和“是否可检索”,而对方用一句模糊的“没发生过”回避了所有实质问题。
值得注意的是,Thom在6月29日关闭了ChatGPT的“允许用于模型训练”选项。但他强调,这个开关只能阻止未来数据被使用,无法说明此前数月的对话是否已被采集、清洗并注入训练流程。
几周后,事态出现戏剧性转折。在另一起涉及纳维-斯托克斯方程的争议中,面对纽约大学数学家Tristan Buckmaster的质询,OpenAI官方突然改口:虽然坚称“未调取特定用户账户数据”,但承认“无法排除使用来自客户产品的去标识化数据来改进模型”。
这一承认等于间接推翻了此前对Thom的断然否认。所谓“去标识化”,是指删除用户身份信息(如姓名、邮箱),但保留对话内容本身。对数学家而言,这毫无意义——思想的价值不在于谁提出的,而在于内容本身。
“你可以抹掉我的名字,”Thom在后续长文中写道,“但你抹不掉一个证明的逻辑骨架。那是我二十年坐在办公室、咖啡馆、黑板前反复打磨的东西。”
从巧合到系统性风险
这已不是OpenAI第一次卷入数学成果归属争议。早在今年初,Buckmaster就发现Astra在NS方程问题上的“突破”与其未发表手稿高度相似。当时OpenAI同样以“模型泛化能力”解释,但未能提供技术细节。
接连两起事件让学界警觉。意大利行为科学家Valerio Capraro发文警告:如果这些指控属实,我们正目睹科学史上最隐蔽、最大规模的智力掠夺。
过去,学术剽窃通常发生在同行之间,可通过查重、时间戳、审稿记录追溯。但AI训练数据的黑箱特性,让这种新型掠夺几乎无法举证。用户输入的内容一旦被吸收,就成为模型“内生知识”的一部分,再也无法剥离。
更令人担忧的是,许多研究人员已习惯用AI辅助思考。写代码、推公式、梳理逻辑——这些原本属于“私人脑力劳动”的过程,如今大量发生在商业公司的服务器上。而服务条款往往含糊其辞,用户很难意识到自己正在无偿贡献前沿思想。
一位匿名代数几何学者坦言:“我现在连草稿都不敢在ChatGPT里打。宁可回到纸笔时代,至少黑板不会把我的想法卖给硅谷。”
技术细节为何难以自证清白
OpenAI目前面临一个根本困境:它无法向外界证明Astra的证明“独立生成”。
现代大模型的推理过程是端到端的神经网络激活,不像传统程序可逐行调试。即使工程师想检查Astra是否“记住”了Thom的对话,也缺乏有效工具追踪某个结论的具体来源。
此外,Astra的训练数据包含海量学术论文、教材、论坛帖子。OpenAI可以辩称,相关思路早已隐含在公开文献中,模型只是“重新发现”。但Thom指出,他们使用的组合技巧——比如将超图扩展性与群作用耦合——从未完整出现在任何出版物中,只存在于他与Kun的私人通信和ChatGPT对话里。
目前,Thom和Kun已暂停所有在线协作,转而使用加密本地工具。他们计划尽快将完整证明提交至arXiv,并申请时间戳公证。但这只能保护未来成果,无法挽回已被“吸收”的部分。
学界呼吁建立AI研究伦理边界
事件发酵后,多个数学组织开始讨论制定新规范。欧洲数学会内部邮件组提议:
- 禁止在未发表研究中使用商业AI工具
- 要求AI公司公开训练数据中学术内容的比例
- 建立“研究沙盒”,隔离敏感推导与联网模型
但这些措施治标不治本。根本问题在于,当前AI服务条款默认用户放弃对话内容的所有权利。OpenAI的隐私政策写道:“我们可能使用您的输入来改进服务。” 这句话覆盖了从闲聊到颠覆性猜想的一切内容。
有法律学者指出,这可能违反《伯尔尼公约》对未发表作品的保护。但跨国诉讼成本高昂,个体研究者难以对抗科技巨头。
眼下,Thom没有提起诉讼,而是选择公开所有证据。“我不是要赔偿,”他说,“我要整个学界看清:当你把思想喂给黑箱,你就可能永远失去它。”
下一个会是谁?
Gromov柔度猜想只是冰山一角。Astra宣称攻克的十大难题中,还有多个涉及前沿未发表工作。例如在代数拓扑领域,有研究者发现其对“稳定同伦群”的计算与某实验室内部报告惊人相似;在数论方向,其关于椭圆曲线秩的结论也与几位青年学者的预印本草稿重合。
随着更多人回溯比对,指控名单可能继续扩大。而OpenAI至今未公布Astra训练数据的具体构成,也拒绝第三方审计。
这场冲突的本质,是两种知识生产模式的碰撞:一种是缓慢、透明、可追溯的学术共同体实践;另一种是快速、封闭、以商业利益为导向的AI工业化流程。当后者开始吞噬前者的产出而不加标注,信任基础便彻底崩塌。
或许正如一位网友所言:“数学家最好彻底回到黑板、笔和纸的时代。” 至少在那里,思想属于自己,直到主动分享的那一刻。