墨芯在2026外滩大会展示稀疏推理芯片,聚焦算力效能提升
墨芯亮相2026外滩大会
9月9日,墨芯人工智能出现在2026 Inclusion·外滩大会现场。这场以“共创AI新经济”为主题的活动由蚂蚁集团主办,墨芯作为其生态合作伙伴,带来了自家的AI计算卡产品。
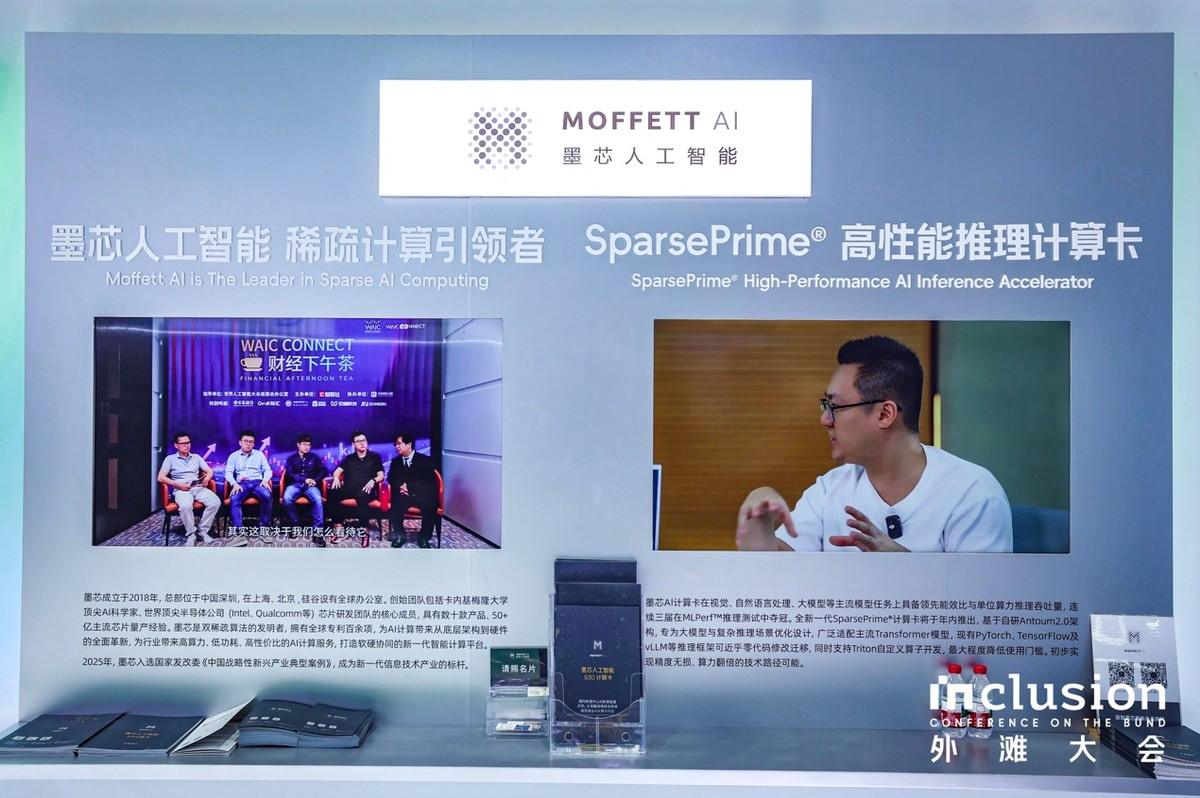
展台上没有太多花哨的演示,重点放在了一块看起来和其他加速卡差不多的硬件上——但它的核心是一颗专为稀疏推理设计的芯片。墨芯想说明的是:在AI推理需求暴涨的当下,光堆算力不够,得让每瓦电、每块芯片都干更有效的活。
推理需求涨了,算力不能只靠堆
过去几年,大模型训练是焦点,但如今风向变了。越来越多AI能力被封装成产品,用在客服、质检、医疗影像、城市管理这些实际场景里。这些都不是一次性的实验,而是要7×24小时跑的线上服务,对推理的稳定性、成本和效率要求极高。
墨芯观察到,很多现有系统在处理推理任务时,其实做了大量无用功。比如模型里有大量接近零的权重,在传统硬件上仍会被反复计算。而他们的方案,是从底层把这部分“水分”挤掉。
稀疏计算怎么省算力?
所谓稀疏计算,简单说就是跳过那些对结果影响微乎其微的计算步骤。但这不是简单删几行代码就行的事——需要算法、编译器、驱动和芯片架构全链路配合。
墨芯的做法是三位一体:先在模型压缩阶段保留结构化稀疏性;再通过自研软件栈识别并调度这些稀疏模式;最后由专用芯片硬件直接支持稀疏矩阵运算,避免通用GPU那种“不管有没有用都算一遍”的浪费。
据现场工程师介绍,这种设计能让同样规模的模型在他们的卡上跑出更高吞吐量,或者用更小的卡跑同等级任务,从而降低单位推理成本。
四大区域已有部署
这套方案不只是实验室产物。目前墨芯的推理集群已经在西北、西南、华东、华北四个片区的数据中心落地。不同地区侧重不同:有的对接制造业工厂做视觉质检,有的支撑生物医药公司的分子模拟,还有参与智慧城市项目处理视频流分析。
比如在某华东汽车零部件厂,原来用通用GPU做缺陷检测,延迟高且电费贵。换成墨芯的稀疏推理卡后,单台设备处理速度提升近40%,同时功耗下降,产线能实时拦截不良品。
这类案例积累多了,也让墨芯更清楚实际场景中推理负载的复杂性——请求大小不一、模型版本频繁更新、突发流量常见。这些都对芯片的调度灵活性提出挑战。
新一代SparsePrime®计算卡即将推出
针对上述问题,墨芯透露正在准备新一代SparsePrime®计算卡。相比前代,新卡在内存带宽、任务调度器和稀疏模式支持范围上都有升级。尤其加强了对动态批处理(dynamic batching)和混合精度稀疏计算的支持,以应对真实业务中千变万化的请求模式。
虽然没公布具体性能数字,但团队表示目标很明确:让客户在不增加机柜和电力的前提下,多跑30%以上的在线推理任务。
不只做芯片,也在搭生态
光有好芯片还不够。如果适配成本太高,企业宁愿忍受低效也不愿切换。墨芯意识到这点,开始从技术供应商转向生态共建者。
今年7月,他们成为工信部人工智能标准化技术委员会成员单位。这意味着能参与制定AI基础软硬件的互操作标准,比如模型格式、算子接口、性能评测方法等。统一标准后,芯片、框架、模型之间的磨合时间会大幅缩短。
紧接着8月,墨芯牵头成立了“稀疏计算产学研联盟”。首批成员包括几所高校实验室、算法公司和行业用户。联盟不搞空泛研讨,而是围绕三个具体方向:一是探索新型稀疏训练方法,二是攻关编译器自动稀疏化技术,三是推动典型场景的端到端验证。
一位参与联盟的教授提到:“以前学术界发论文讲稀疏,工业界觉得难落地。现在有了真实数据和反馈闭环,研究更能对准痛点。”
算力效能才是长期竞争力
回到外滩大会的主题——“共创AI新经济”。这个词听起来宏大,但拆解下来,其实就是让AI真正变成可规模化、可持续盈利的服务。而要做到这点,成本必须可控。
训练可以烧钱,但推理必须赚钱。当一个AI应用每天要处理百万级请求时,哪怕单次推理成本降一分钱,一年也能省下几十万。墨芯押注的方向,就是帮客户把这笔账算明白。
当然,稀疏计算不是万能药。它对模型结构有要求,并非所有算法都能无缝迁移。但随着MoE(混合专家)、动态网络等本身就具备稀疏特性的架构兴起,这条路的适用面正在扩大。
墨芯没喊“颠覆”或“革命”,只是默默在展台角落放了一台运行中的服务器,屏幕上实时滚动着推理吞吐和功耗数据。旁边一行小字写着:“省下的每一度电,都是AI落地的底气。”
这或许比任何口号都更能说明他们的立场:不追求最大算力,只追求最有效算力。