清华团队提出 EMERGE-Policy:用多智能体框架解决机器人长程操作难题
单一模型的瓶颈:为什么机器人做不好复杂任务?
过去几年,视觉语言动作模型(Vision-Language-Action, VLA)成了机器人操作研究的主流。这类模型试图用一个端到端网络,直接从图像和语言指令生成关节或末端执行器的动作轨迹。听起来很理想——输入“把红色杯子放到蓝色盘子上”,机器人就动起来。

但现实没那么简单。当任务变长、环境有干扰、或者需要中途调整策略时,单一模型很容易崩。原因在于它把太多职责压在一个架构里:既要实时处理像素,又要理解语义,还得输出精确动作,甚至隐式地做规划。这些任务对计算节奏、信息抽象层级的要求完全不同,硬塞进一个模型,结果往往是低层噪声干扰高层决策,或者误差在长序列中不断累积,最后动作完全跑偏。

更麻烦的是,一旦模型训练完成,它的“能力边界”就固定了。如果遇到训练时没见过的物体摆放、光照变化,或者有人突然打乱现场,它往往束手无策。
EMERGE-Policy:让不同模型各司其职
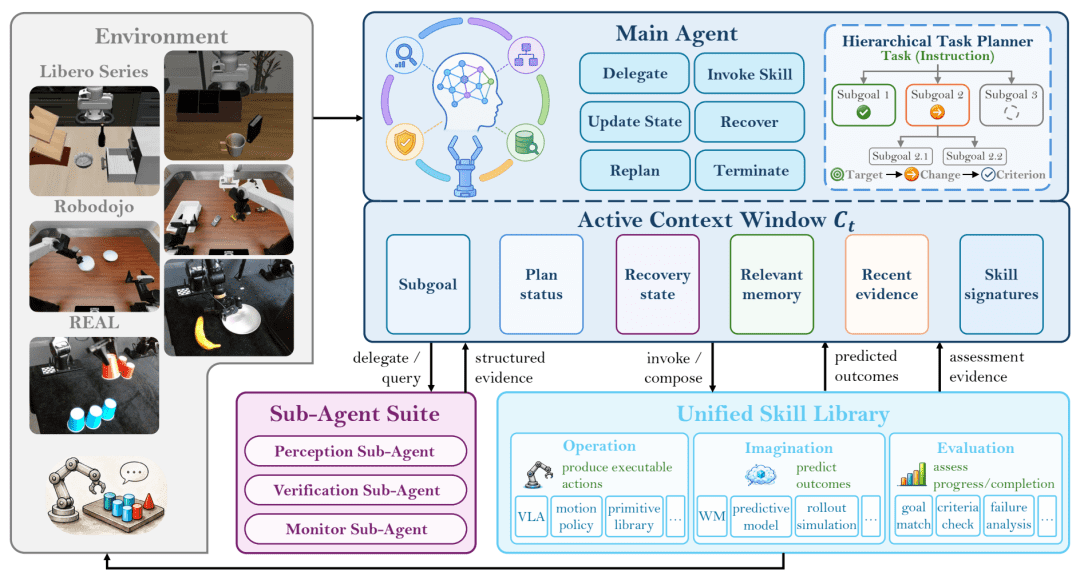
针对这个问题,清华大学深圳国际研究生院智能计算实验室的方智睿、于清池、陈子扬等人在李秀教授指导下,提出了 EMERGE-Policy。这个名字里的 “Emerge” 很关键——他们不追求单个模型聪明,而是让系统级智能从多个组件的协作中“涌现”出来。
核心思路很简单:别指望一个模型干所有事,不如把它拆成一套“工具箱”。
统一技能库:把模型变成可插拔的工具
EMERGE-Policy 的基础是一个 统一技能库(Unified Skill Library)。这里不再区分“哪个模型更好”,而是把不同架构的模型按功能分类,封装成标准化接口:
- 操作技能:负责实际动作生成。包括 VLA 模型(如 pi₀.₅),用于高频精细控制;也包括运动原语(motion primitives)或 WAM(World-as-Machine)这类更适合大范围、粗粒度动作的规划器。
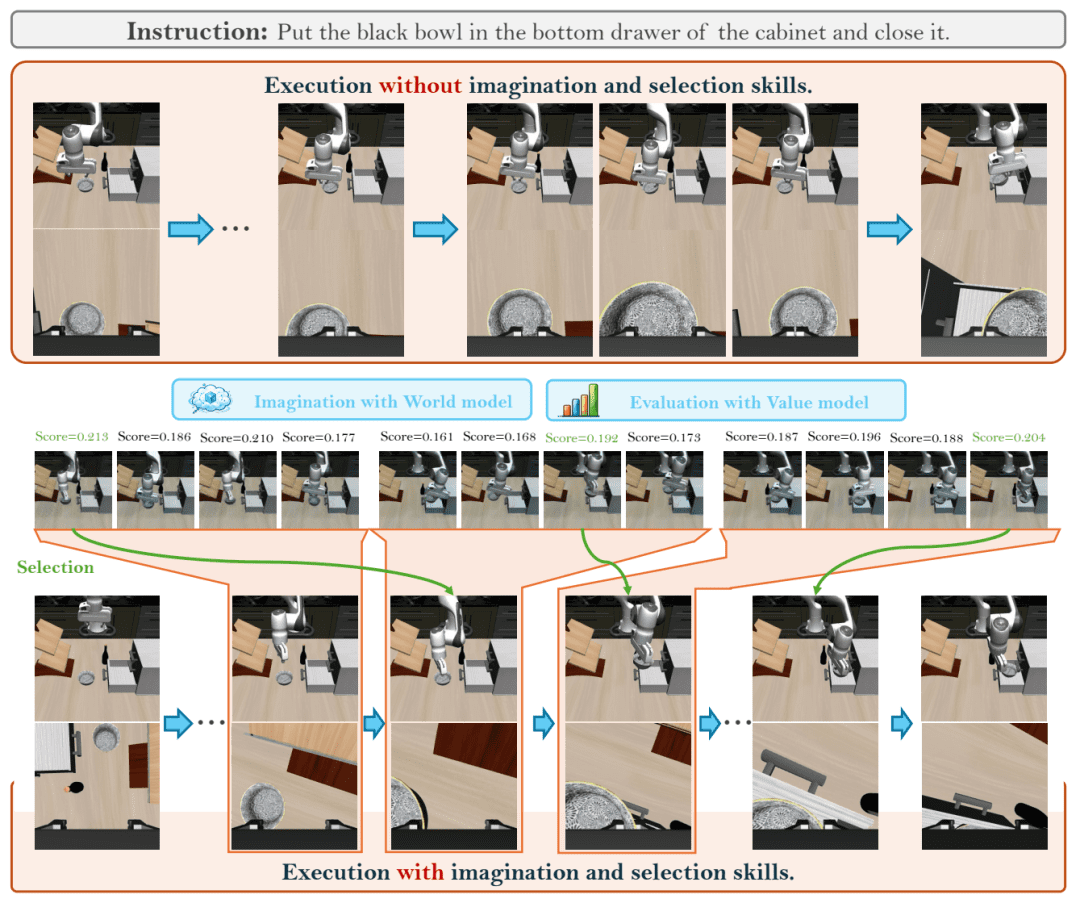
- 想象技能:主要是世界模型(World Model)。系统在真正执行前,可以调用它模拟未来几秒的视频,预演“如果我这么做,环境会变成什么样”。这相当于给机器人加了个“脑内仿真器”。
- 评估技能:由验证器模型(Verifier)承担。它能在动作执行前检查前提条件是否满足(比如“杯子是否已被抓起”),执行后判断目标是否达成,还能给世界模型生成的多个候选动作打分,选出最靠谱的那条。
这种设计的好处是灵活。今天你有个新的世界模型效果更好?换进去就行。明天发现某个验证器对遮挡更鲁棒?直接更新对应模块,不用重训整个系统。

图结构调度:主智能体 + 角色化子智能体
光有工具还不够,得有人指挥。EMERGE-Policy 引入了一个 主智能体(Main Agent) 作为调度中枢。它不直接看原始图像,而是通过结构化接口与子单元交互。面对“叠三层纸杯”这种长程任务,主智能体会先拆解成“抓第一个杯→倒扣→定位→放稳”等子目标,再按需调用技能库。
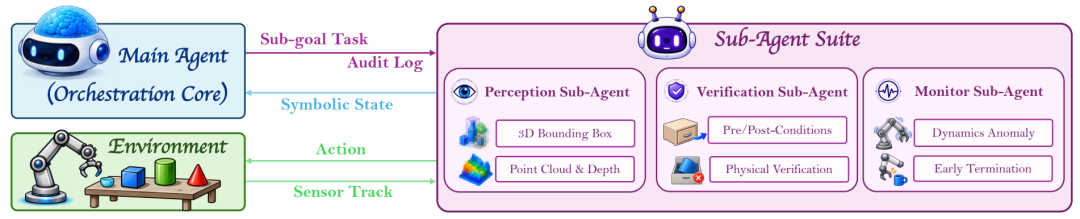
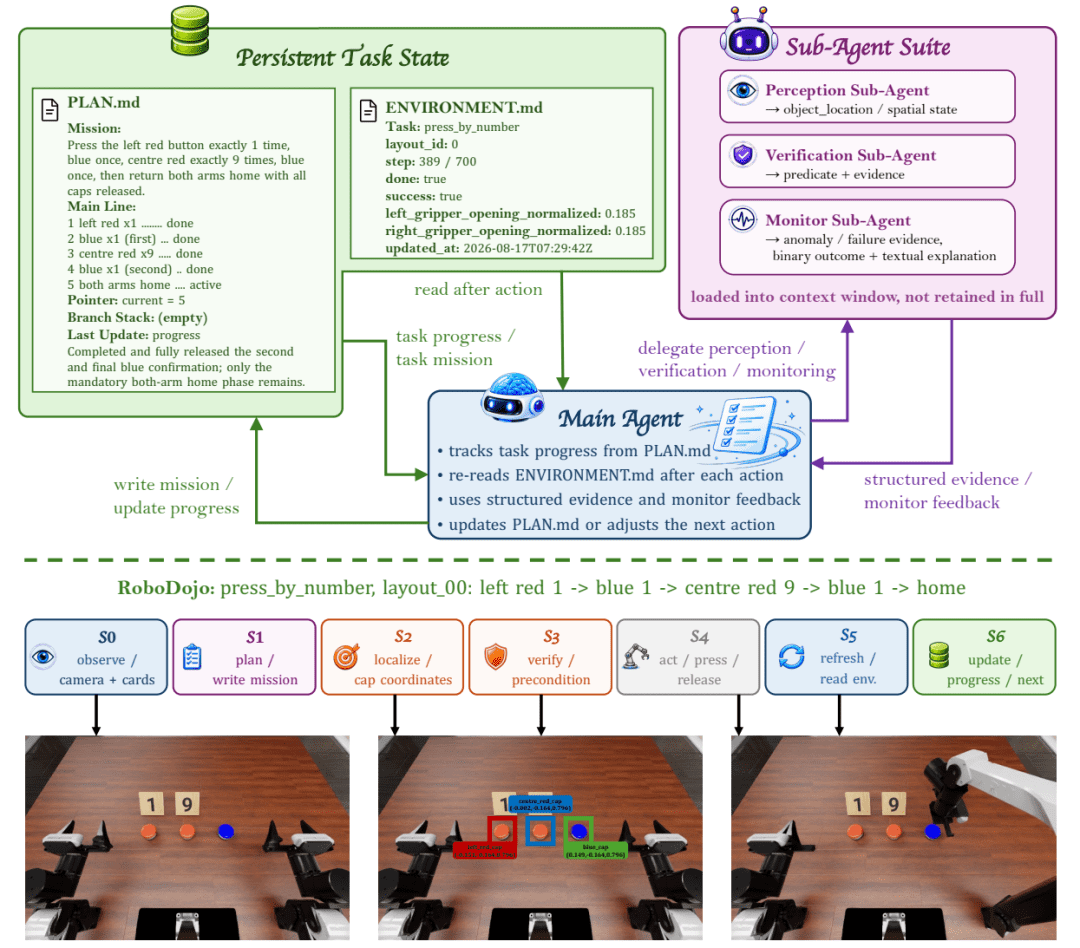
为了减轻主智能体负担,系统还部署了多个 角色化子智能体(Sub-Agent),各自专注一类数据:
- Perception Sub-Agent:处理 3D 场景理解,输出物体边界框和空间关系;
- Verification Sub-Agent:持续调用验证器,监控当前子目标是否完成;
- Monitor Sub-Agent:检测执行中的异常,比如机械臂碰撞或物体滑落。
这些子智能体运行在隔离上下文中,避免信息混杂。它们的输出以结构化形式(如 JSON)传给主智能体,后者据此决定下一步调用哪个技能。
三层记忆:不让机器人“失忆”
长程任务最大的挑战之一是上下文长度限制。大模型通常只能记住几千个 token,但叠 10 个杯子可能需要上百步操作,中间还有大量观测数据。
EMERGE-Policy 用 三层文件级记忆 解决这个问题:
- PLAN.md:记录当前任务图和进度,比如“已完成第 2 层,正在处理第 3 层第 1 个杯”;
- HISTORY.md:摘要存储历史动作和关键观测,例如“10:05 抓取杯 A 成功,10:06 放置偏移 2cm”;
- MEMORY.md:动态更新的环境事实,如“桌上有 5 个红杯、3 个蓝杯,其中 2 个已倒扣”。
当上下文快满时,系统自动触发 Memory Integration,把 HISTORY 和 MEMORY 压缩成更简洁的表述,确保主智能体始终能访问关键信息。
实验:从仿真到真机,全面验证
团队在四个主流基准上测试了 EMERGE-Policy:LIBERO(标准操作)、LIBERO-Plus(带扰动)、LIBERO-Pro(更复杂场景)和 RoboDojo(强调记忆与开放词汇)。
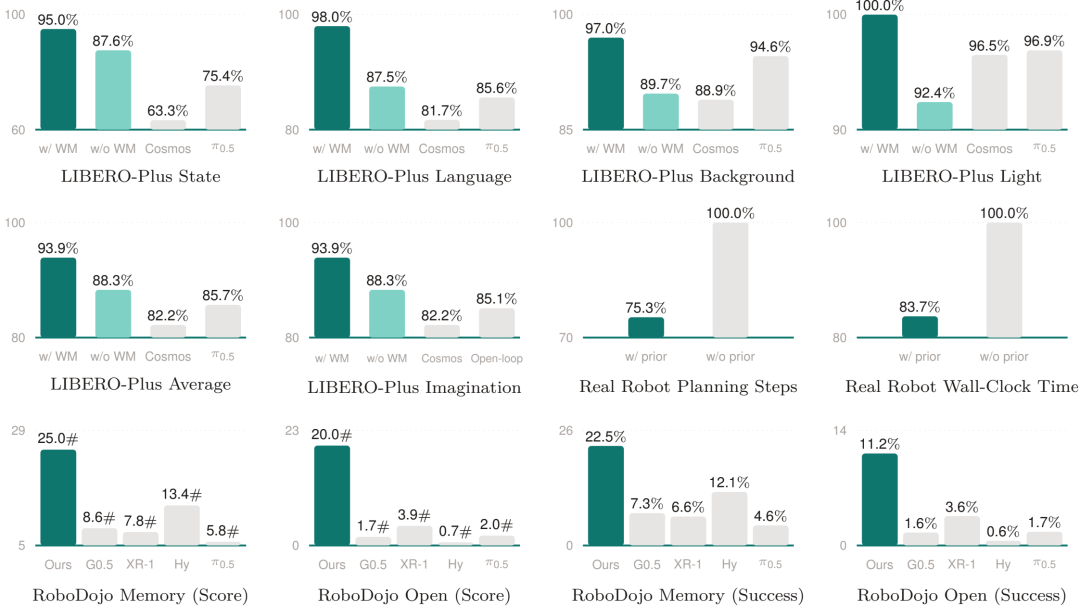
在标准 LIBERO 上,集成 Cosmos Policy 作为世界模型后,系统平均成功率达 99.2%,比单独使用 Cosmos 高 0.7%;若以 pi₀.₅ 为执行器,则达 98.8%,提升 2.0%。
LIBERO-Plus 引入了光照突变、相机抖动等干扰。此时 EMERGE-Policy(带世界模型)仍取得 93.9% 完成率,比基线高出 11.7%——说明其抗干扰能力显著增强。
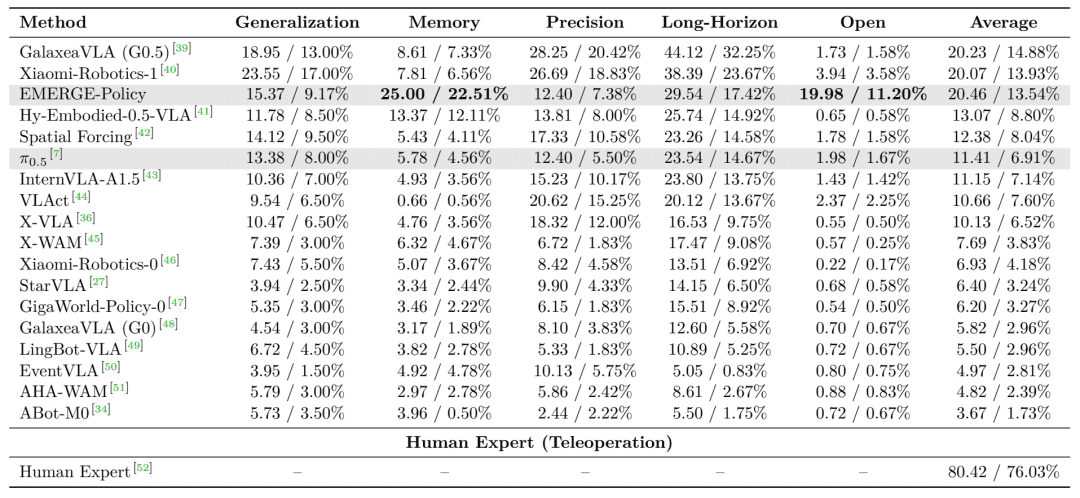
RoboDojo-Sim 重点考察长程推理。EMERGE-Policy 在 Memory 维度得分 25.00(成功率 22.51%),Open 维度 19.98(11.20%),远超同类方法。这证明它不仅能记住历史,还能基于记忆重组技能、理解新指令。
真机实验:叠纸杯金字塔
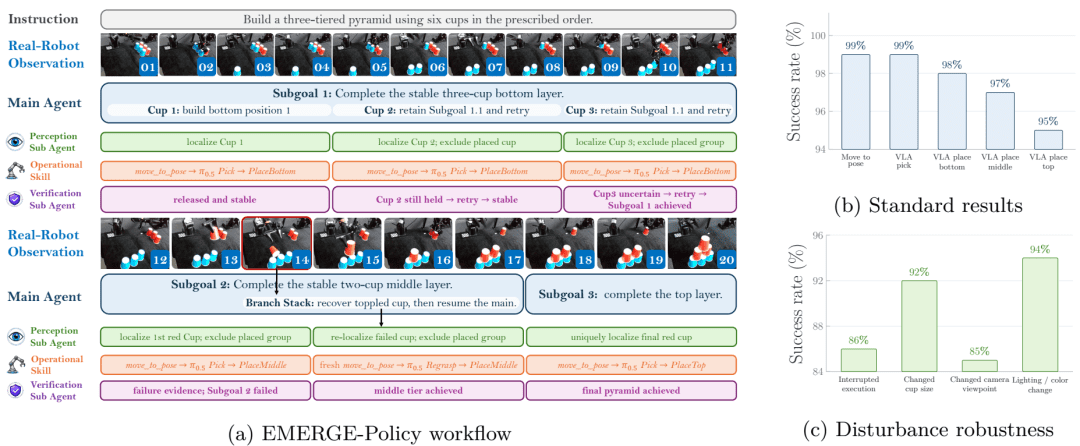
最直观的验证是在真实机械臂上做 多层纸杯叠放:把桌上散落的纸杯依次倒扣,堆成 3-2-1 的金字塔结构。这要求精准抓取、稳定放置、以及跨层的空间推理。
在 100 次重复实验中,系统完成率极高。更关键的是抗干扰测试:
- 当研究人员故意推倒已叠好的杯子,系统能回溯 PLAN.md,重新规划未完成部分,成功率仍达 85%–94%;
- 即使更换尺寸偏差 5%–15% 的纸杯,或改变颜色、移动相机视角,系统也能通过在线重规划适应。
这种鲁棒性来自其模块化设计:感知子智能体快速更新物体状态,验证器确认破坏发生,主智能体立即调用世界模型预演新路径,操作技能库则执行修正动作。
从“全能模型”到“协同系统”
EMERGE-Policy 的意义不止于性能提升。它代表了一种范式转变:具身智能不必押注于“一个模型解决所有问题”,而可以像人类一样——眼睛看、手操作、大脑想,各器官异构但协同。
这种架构天然支持增量改进。未来只要出现更好的世界模型、更准的验证器,甚至全新的技能类型(比如触觉反馈模块),都能无缝接入现有框架。对于工业场景尤其重要:产线上的机器人不需要每次都重训,只需更新对应工具即可应对新产品。
当然,挑战仍在。比如如何自动发现新技能、如何优化多智能体间的通信开销、以及如何在资源受限的嵌入式设备上部署这套系统。但至少,EMERGE-Policy 给出了一个清晰的方向:智能不在单一模型里,而在系统的组织方式中。