DeepSeek V4.1 Flash 如何靠压缩 KV 缓存实现小模型干翻大模型
小模型干翻大模型,关键不在参数而在缓存
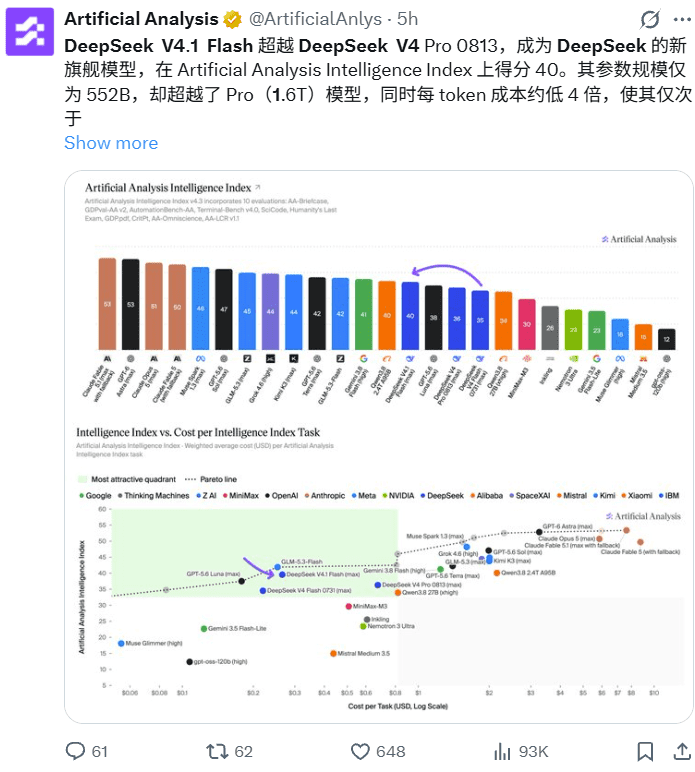
前两天 DeepSeek V4.1 Flash 上线,引发了一波测试热潮。著名评测机构 Artificial Analysis 给它打了 40 分的 Intelligence Index,甚至超过了 DeepSeek 自家参数量大得多的 V4 Pro(1.6T vs 552B)。更夸张的是,在 AutomationBench-AA 榜单上,它以 69% 的得分和 GPT-6 Astra 并列第一。
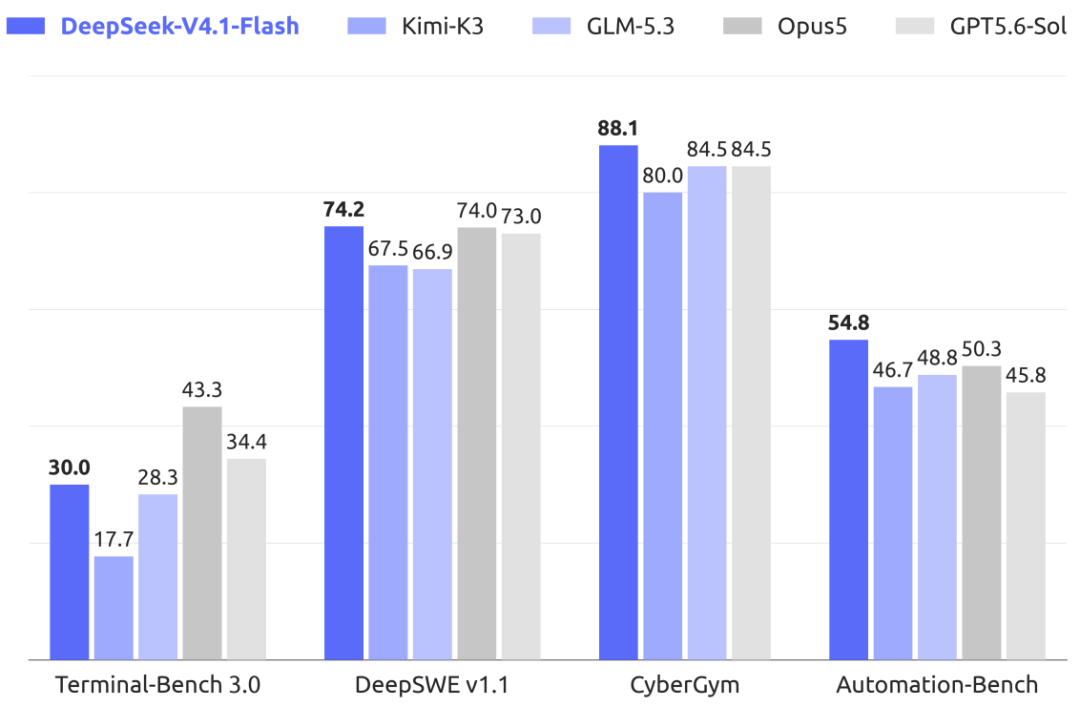
但最让人意外的不是分数,而是成本:每个 Intelligence Index 任务只花 0.27 美元。代价是输出特别长——平均每个任务生成 89k tokens,成了评测里“最冗长”的模型之一。
这背后其实藏着一个关键转变:DeepSeek 这次没在模型规模上死磕,而是把全部力气砸在了一个地方——KV 缓存压缩。官方技术报告标题就写得明明白白:《Pushing the Limits of KV Cache Compression》(推进 KV 缓存压缩之极限)。
翻完整份报告你会发现,从架构到部署,几乎所有设计都指向同一个目标:让 KV 缓存小一点,再小一点。
为什么 KV 缓存成了新瓶颈?
过去几年,稀疏注意力(比如 DeepSeek V3.2 的 DSA、V4 的 CSA)已经把长序列的计算成本压得很低。但实际跑智能体(agent)任务时,情况不太一样。
一个编码 agent 可能连续工作几小时,每次调用工具都会往上下文里追加新内容,但真正需要模型生成的 token 其实很少。这种“输入重、输出轻”的负载,让瓶颈从“算不动”变成了“存不下、搬不动”。
具体来说有三个问题:
- HBM 显存装不下太多并发请求的全局 KV;
- SSD 或主机内存容量限制了前缀缓存的留存时间和命中率;
- IO 带宽拖慢了缓存加载和迁移的速度。

这三个问题直接决定了服务吞吐和单位成本。V4.1 Flash 的思路很直接:既然算力不是问题,那就把存储和搬运的成本砍下去。
CED:prefill 阶段直接砍掉一半计算
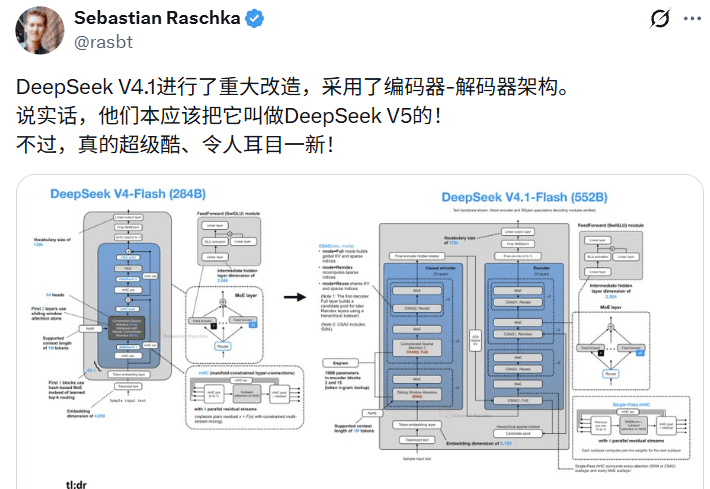
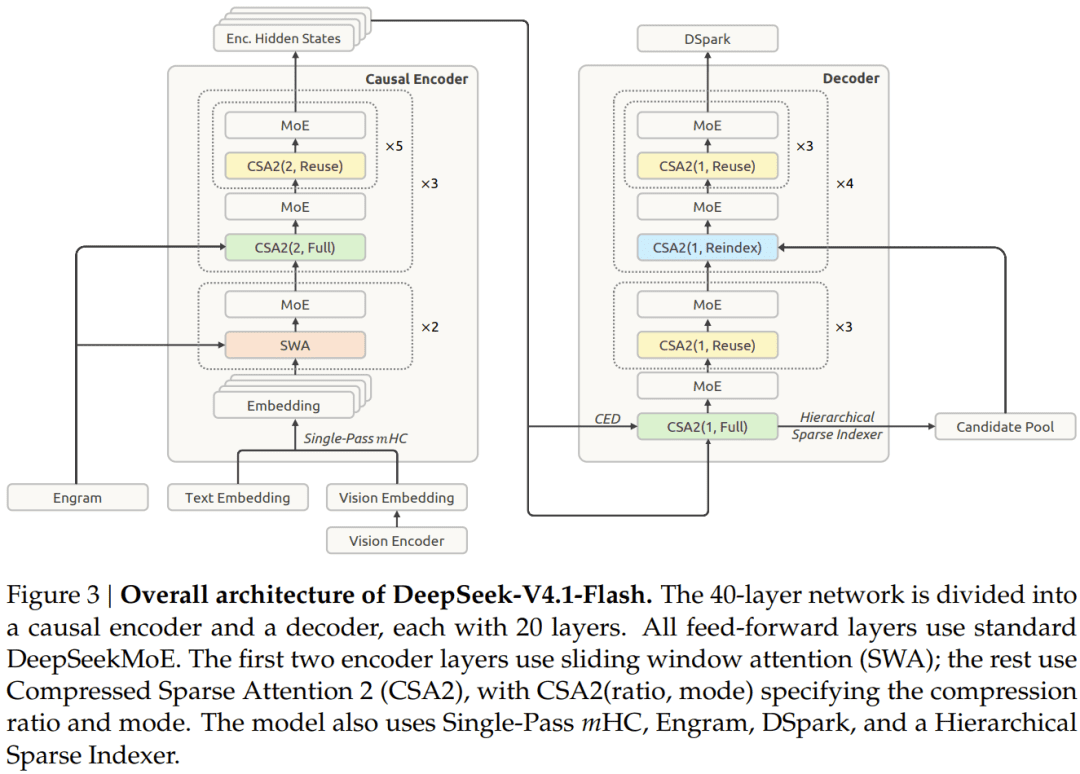
V4.1 Flash 的主干是个 40 层的 Transformer,但它被切成两半:前 20 层叫“因果编码器”(Causal Encoder),后 20 层是“解码器”。这个结构叫 CED(Causal Encoder-Decoder)。
常规 Transformer 处理一段提示词时,必须把 40 层全跑一遍,每层都要算自己的 K、V。但 CED 不这么干:解码器那 20 层的全局 KV,直接由编码器最后一层(第 20 层)的隐藏状态通过各自的投影矩阵映射出来。
这意味着 prefill 阶段只需要跑前 20 层,上半部分的 KV 缓存就拿到了。序列很长时,prefill 的计算复杂度几乎对半砍。
这个想法其实来自微软的 YoCo(You Only Cache Once),但 DeepSeek 做了改进:YoCo 是让上半部分直接共享同一份 KV,而 CED 给每一层配了独立的投影权重,在省计算的同时保留了表达能力。

当然也有代价。滑动窗口注意力(SWA)还是得逐层算,因为局部信息不能共享。但 DeepSeek 选择“近似处理”:只回放提示词最后 128 个 token 来重建 SWA 状态,而不是全部重算。这就是后面的 Decoder SWA Bounded Replay。
CSA2:三层压缩一次吃满
光靠 CED 省计算还不够,存储也得压。这里用上了 CSA2(Compressed Sparse Attention 2)。
DeepSeek 把 KV 缓存的压缩空间分成三个维度:
- 条目大小:比如用 GQA 减少 KV 头数,或 MLA 让各头共享一个小 latent;
- 序列维度:每 m 个 token 压成一条,V4 的 CSA 和 HCA 就属于这类;
- 层维度:让某些层复用其他层的缓存和选择结果。
之前的方案(比如 IndexCache、YOIO、HySparse)最多覆盖两个维度。CSA2 则想把三个全吃满。
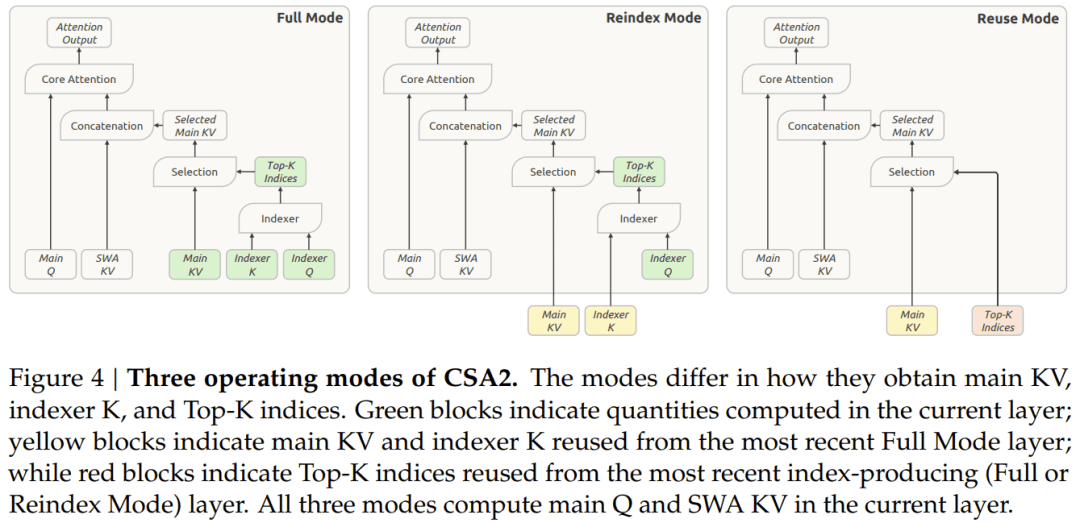
做法是给每个 CSA2 层静态分配三种模式之一:
- Full 模式:自己算 main KV 和索引器 Q,跑完整流程;
- Reindex 模式:复用前面某层的 main KV 和索引器 K,但用自己的 Q 重新打分选 Top-K;
- Reuse 模式:main KV 和 Top-K 全部沿用,连索引器 Q 都不算。
三种模式都保留了自己的全局 Q 和 SWA KV,所以层间表达能力没被抹平。实际部署时,大部分层都设成 Reuse 模式,prefill 只需 15 个 kernel,decode 只需 11 个。
FP4 量化 + Bounded Replay:精度和部署再砍两刀
除了架构,还有两处关键优化。
第一刀在精度。V4 已经对索引器的 Q、K 做了 FP4 量化,V4.1 Flash 把 FP4 推到了 main KV 缓存。格式选的是 E2M1,每 16 通道配一个 E4M3 缩放因子,接近 NVFP4 但省掉了二级全局缩放。
第二刀在部署,就是前面提到的 SWA Bounded Replay。精确重建 SWA KV 需要回放 L × n_win 个 token,成本太高。V4.1 Flash 干脆接受近似:只回放最近 128 个 token,并把 SWA 截断到这个窗口内。
更重要的是,它把 SWA KV 整个移出了持久化缓存。因为 SWA KV 只在活跃会话的几分钟内有用,会话一结束就是垃圾数据,根本不适合长期存在 SSD 上。
现在,SWA KV 被放进每台机器 10% 主机 DRAM 组成的分布式内存池,TTL 只有几分钟;全局 KV 则继续留在 SSD,保证至少 72 小时生命周期。偶尔 SWA KV 没命中,就用 bounded replay 重算 128 个 token 兜底——把一次灾难性未命中变成廉价的优雅降级。
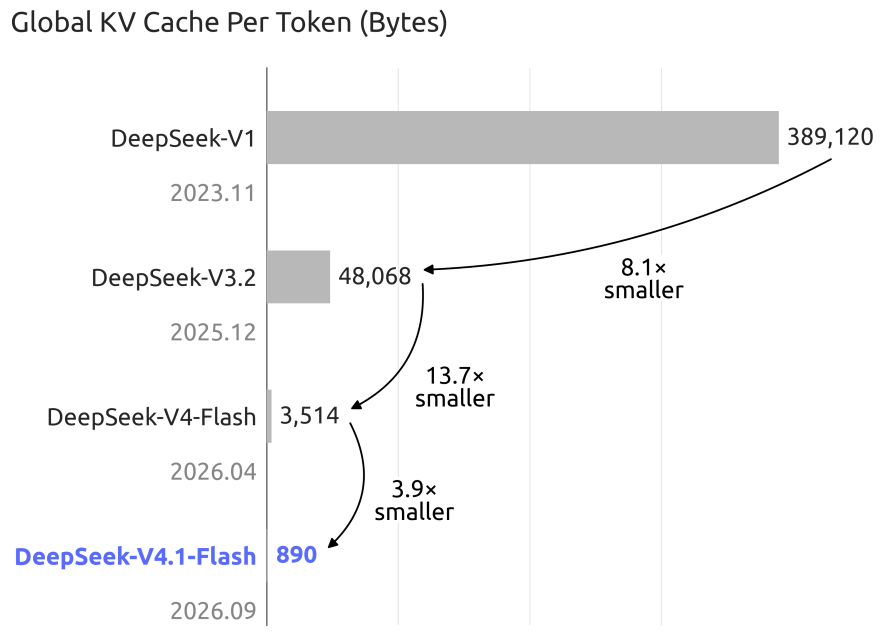
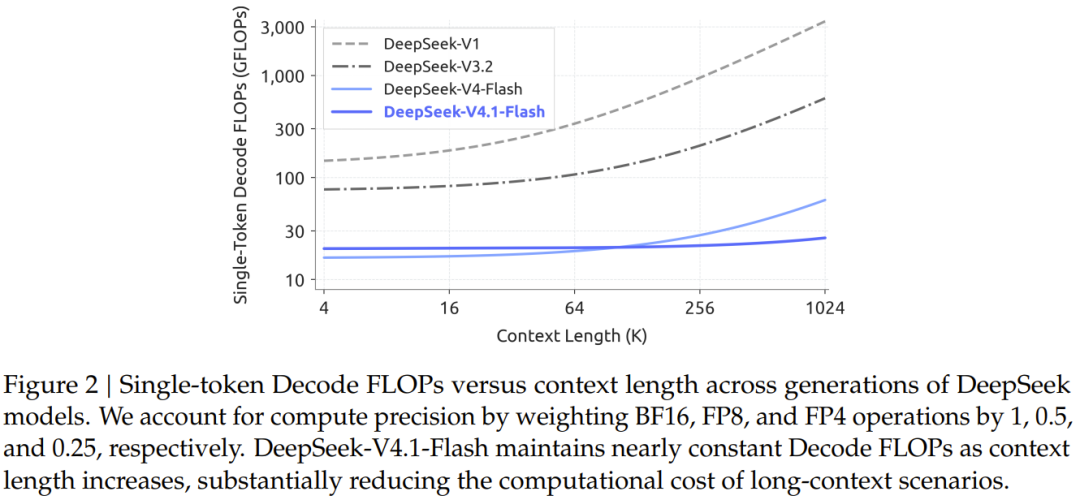
结果是:持久化 KV 缓存降到 V4-Flash 的约 1/8。全局 KV 缓存更是压到每 token 890 字节,只有 V4-Flash 的 1/4,比 DeepSeek-V1 时期小了 437 倍。
所有这些加起来的效果很直观:上下文从 4K 扩到 100 万 token(放大 256 倍),单 token decode 的 FLOPs 只增加了 25%。
老技术的新组合:mHC、Engram 和 DSpark
熟悉 DeepSeek 论文节奏的人,会在报告里看到不少老面孔,但这次都做了升级。
Single-Pass mHC 是今年元旦提出的流形约束超连接的改进版。原始实现里,混合系数必须等规约完成才能拿到,导致多个 kernel 只能串行。新版本把系数错开一个 block,让三步操作融进一个 Mega-mHC kernel,激活访存量直接减半。
Engram 是 1 月和北大合作提出的条件记忆模块,用 N-gram 哈希实现 O(1) 静态知识检索,把“记忆”从 GPU 显存卸载到主机 DRAM。V4.1 Flash 首次把它放进正式模型:196B 参数分给两个模块,放在第 1 层和第 14 层,用 {2,3,4} 阶 N-gram、8 个哈希头,每个头索引约 1600 万条目。嵌入表和投影都用 FP8,推理时靠 RDMA 从主机内存预取,和第一个 Transformer block 的计算重叠。
DSpark 是新的投机解码模块,由三个 Transformer block 组成,滑动窗口 128 token,一次前向并行给出五个草稿位置的 logits。它还带一个轻量 Markov 头建模草稿依赖,以及一个置信度头预测接受概率。和 V3 的 MTP 不同,DSpark 是预训练后单独训练的,不回传梯度,好处是可以持续对齐演化中的策略,同时加速线上服务和 RL rollout。
优化器层面也有调整:Q、K 权重用 head-wise Muon 处理注意力头异质性;Engram 嵌入表、token 嵌入和预测头则用动量更新配 Sinkhorn 平衡替代 Adam,省下大量优化器状态显存。
后训练:没新算法,但有新设计
DeepSeek 在后训练章节很坦率:这一版没引入新算法,就是标准的 SFT + RL + on-policy 蒸馏。所有改动都在数据管线,报告没细说。
但有个对用户直接可见的设计:reasoning effort。
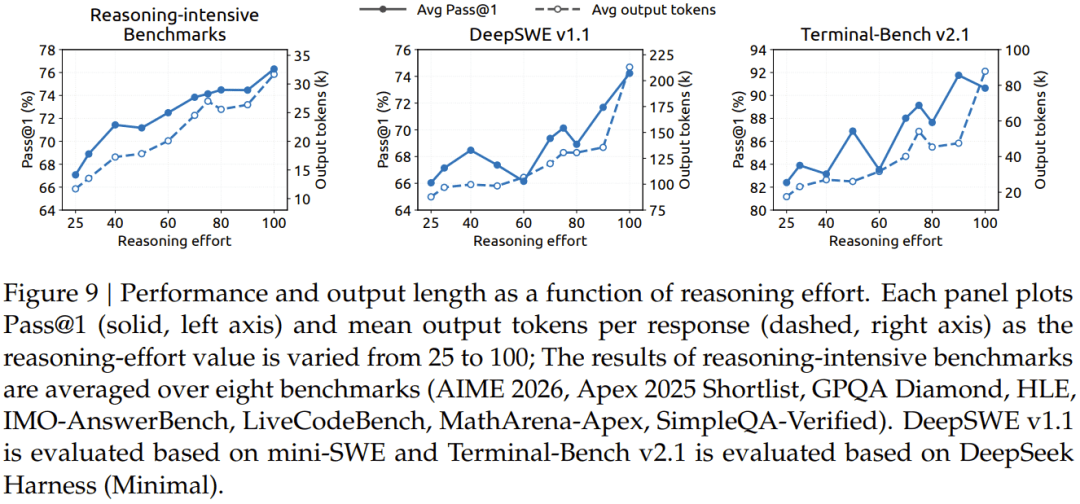
训练时把一个 1 到 100 的标量 effort 写进系统提示,同一 effort 下的多个采样构成子组,组内做奖励中心化。长度惩罚系数随 effort 指数衰减:effort 每增加一个特征尺度,惩罚系数乘以 1/e。
这样,同一套权重就能在成本-质量曲线上滑动。API 暴露的 max、high、low 三档,对应 effort=100、75、50。
这也解释了为什么 Artificial Analysis 测出它是“最冗长模型”——他们测的是 max 档。数据显示,effort 从 25 提到 100,八个推理密集型基准的平均 Pass@1 从 67.1% 升到 76.3%,但输出 token 也多了约 2.5 倍。
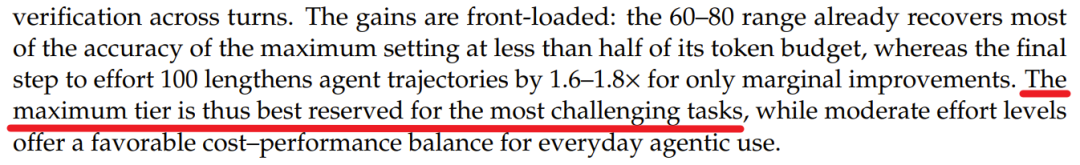
有意思的是,收益是前置的:effort 从 60 到 80,用不到一半的 token 预算就能拿到接近满档的准确率;但从 80 到 100,轨迹再长 1.6~1.8 倍,换来的只是边际提升。报告建议:把 max 留给最难的任务。
不止模型,还有工具链
DeepSeek 这次还开源了几套新工具,方便部署 V4.1 Flash 和后续模型:
- deepseek-recipe:一组 Rust 库和 Python bindings,能把不同格式的 API 请求统一转成 Conversation 格式,编码为 DeepSeek 提示,并把输出转回响应格式;
- DeepJIT:轻量级 C++20 JIT 运行时,支持 NVIDIA CUDA 和华为昇腾 NPU,方便在运行时编译、缓存、加载内核;
- DeepSelect:高性能 TopK 内核和采样器实现,比原生 torch.topk 快 2~20 倍。
这些工具加上 V4.1 Flash 的 KV 压缩设计,或许才是 DeepSeek 真正想推的“新范式”:不再盲目堆参数,而是通过软硬协同把每一字节缓存的价值榨干。