RunningHub开源方案让MiniMax H3视频生成提速12倍,本地多卡也能跑
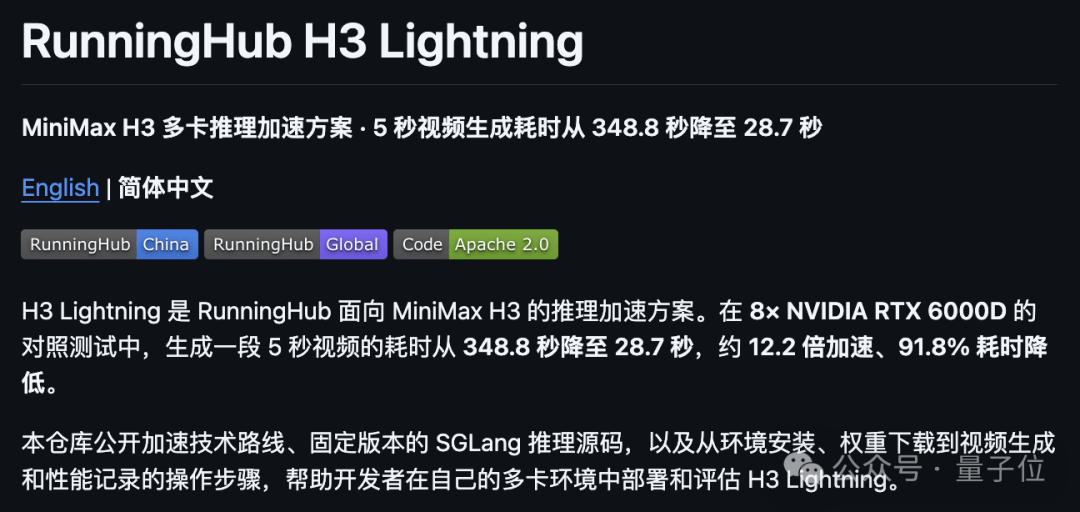
5秒视频从6分钟缩到30秒
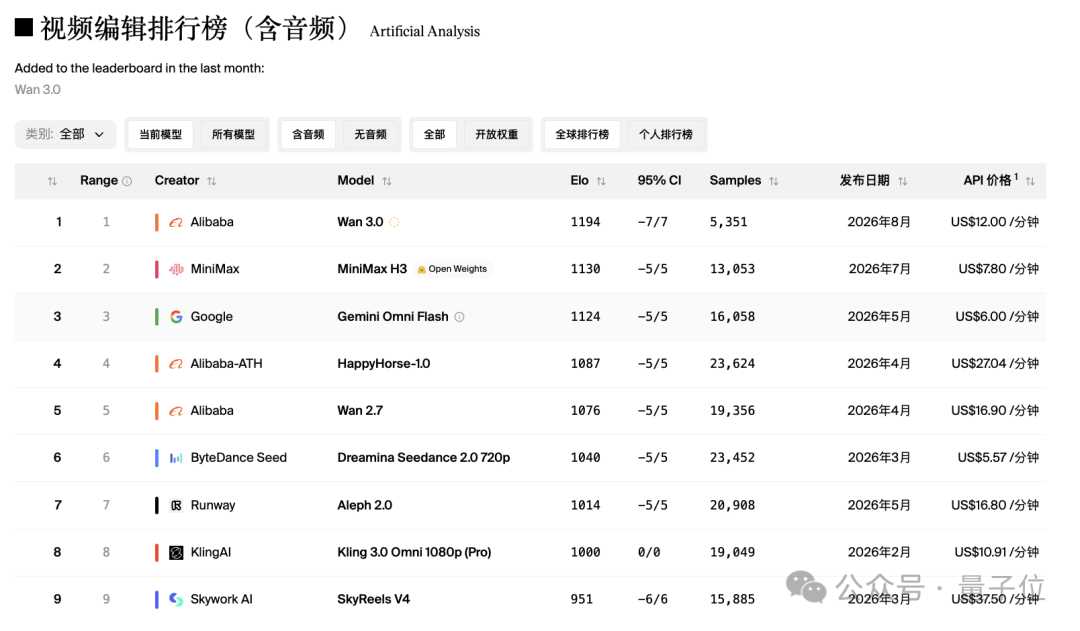
MiniMax开源的H3视频生成模型最近火出圈,不仅效果能打,还大方放出了权重。但用过的人都知道:好是真好,就是等得人着急。
默认配置下,生成一段5秒、1344×768分辨率的视频,在4张RTX 6000D上要花348.8秒——差不多6分钟。创意刚冒头,结果还在转圈加载,灵感早就飞走了。
RunningHub团队盯上了这个痛点,搞出一套叫“H3 Lightning”的加速方案。实测下来,同样硬件条件下,生成时间直接压到28.7秒,提速约12倍,耗时减少92%。关键是,全程没降精度,还是BF16满血运行。
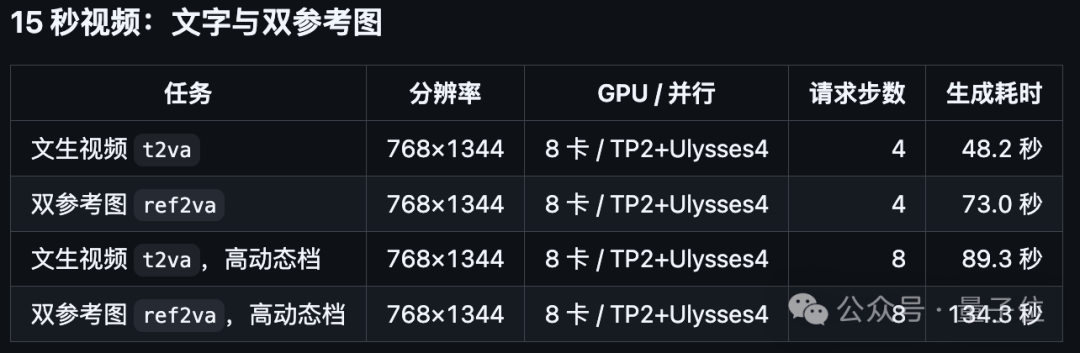
更狠的是15秒长视频。在8张RTX 6000D上,纯文字生成只要48秒,双参考图也才73秒。这意味着,一条15秒的图生视频,基本能打进“1分钟出片”的节奏。
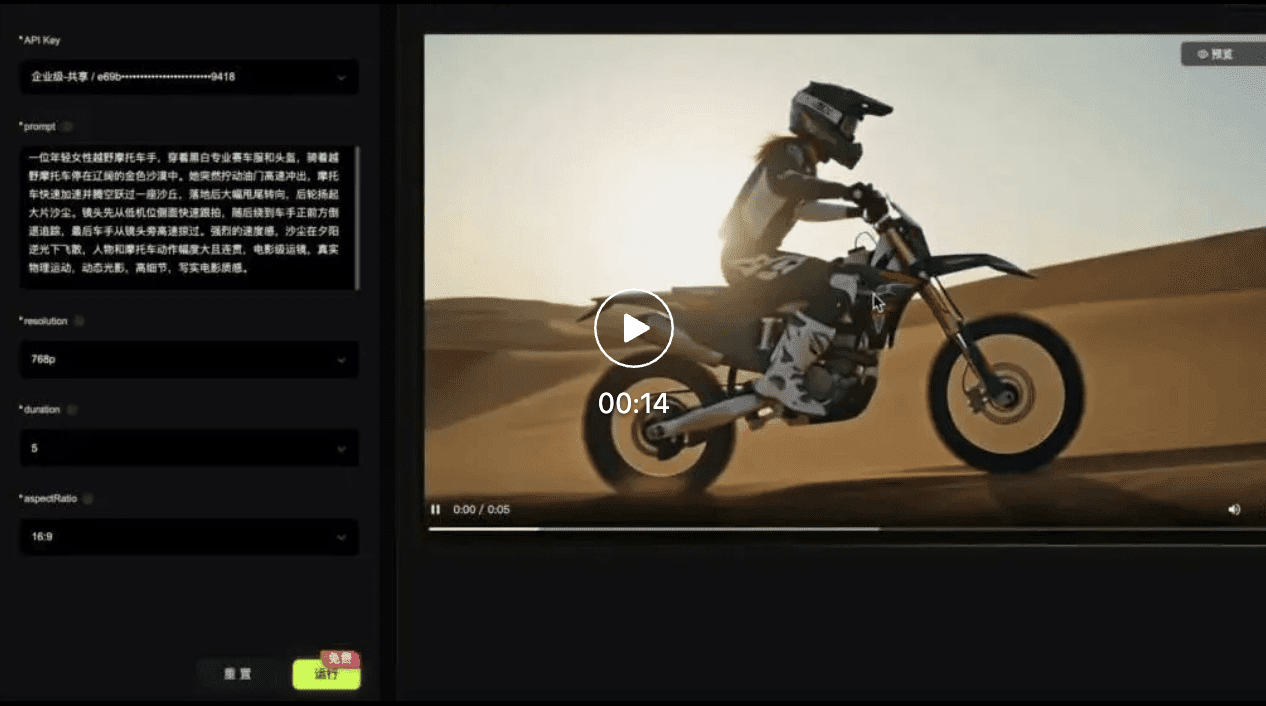
实际体验也挺稳。有人试了沙漠摩托场景:女骑手起步、冲坡、腾空、甩尾,镜头从侧跟拍切到正面倒退再掠过车身。30秒出片,人车动作连贯,落地有下沉回弹,沙尘飞扬自然,预设机位也都对得上。
再试15秒吉卜力风图生视频:少年和金毛从草地起身奔跑,镜头绕拍拉远,人物特征、背景山谷全程保持一致。虽然狗跳跃时四肢偶尔有点僵,但整体不出戏。更绝的是二次创作——把晴天改成下雨,加伞加彩虹,50秒就出新版本。
以前改个设定可能要犹豫值不值得再等十分钟,现在想到就能试,试错成本大大降低。
三刀砍出12倍提速
不靠顶级算力堆砌,也不牺牲精度,这省下的时间到底从哪来的?RunningHub的解法很工整,分三步抠细节。
第一刀:让模型少算点。
视频生成不是一步到位,而是通过多轮迭代从噪声中“想”出画面。H3默认要跑50步,每步都是一轮完整计算。RunningHub搞了个自研的RH后训练加速模型,教H3用更少步数完成任务。
实测用9步方案,5秒视频生成时间直接从348秒干到43秒,提速8倍。官方推荐日常用4步,复杂动作(比如大幅运动)切到8步,快和稳自己选。
第二刀:让剩下的计算跑更快。
就算步数少了,剩下的计算也不能浪费。RunningHub叠了三个技术:SageAttention2、Cache-DiT和torch.compile。
SageAttention2优化注意力计算——这是视频模型最吃算力的部分,要处理画面元素间复杂的时空关系。新算子让它执行更高效。
Cache-DiT盯重复劳动。视频生成多步之间常有可复用的中间结果,缓存起来避免重复计算,省下不少时间。
torch.compile则做编译级优化,把零散的调度开销捋顺,让GPU执行更流畅。
这三招一上,43秒又压到28.7秒。
第三刀:多卡别互相等。
H3这种大模型通常要多卡并行。但卡多不一定快——如果通信效率低,时间全耗在“你等我、我等你”上。
尤其在没有NVLink、只靠PCIe互联的环境里,卡间通信成本很高。RunningHub测试多种并行策略后,选了TP2+Ulysses4组合:TP从张量维度拆任务,Ulysses从序列维度做并行。
在8张RTX 6000D(无NVLink)环境下,这套组合比TP4+Ulysses2快12%,还省了14GiB显存。
最终,所有优化被整合进SGLang multimodal_gen推理引擎,统一调度模型、多卡和加速组件。
专为真实工作环境设计
现在很多性能宣传依赖顶级数据中心:B300集群、NVLink全互联、无限预算。但普通创作者和中小团队用不起这些。
RunningHub反其道而行,H3 Lightning专门针对无NVLink的PCIe多卡环境优化。RTX 6000D是公开能买到的专业卡,很多工作室已有类似配置。
整个部署流程完全开源:从环境安装、模型下载到服务启动,文档写得明明白白。开发者还能结合社区LoRA、注意力优化和多卡策略,在自己机器上调参适配。
不想折腾?也可以直接在RunningHub平台点开H3 Lightning使用,省去部署烦恼。
开源生态的反哺者
RunningHub这次没走API变现的老路,而是把工程能力回馈给开源社区。这其实延续了它对H3的一贯策略。
H3刚开源,RunningHub第一时间接入,让创作者免部署直接试用;接着又开源全套ComfyUI节点,激发更多玩法。
结果社区玩疯了:有人做电商视频,塞商品模特场景进去,H3自动安排露出和构图;有人搞音频驱动数字人,传图加音频,静止人物秒变开口唱歌;还有人做漫剧流水线,分镜脚本音频一把梭哈出成片。
目前平台已有上千创作者围绕H3开源了近万条工作流。
而H3 Lightning更进一步——不只让用户“能用”,还要“用得爽”。把单次试玩升级为可批量复用的生产力,补齐开源模型从权重到落地的最后一环。
背后其实是母公司海马云十多年GPU工程能力的延伸。从游戏云渲染、图形虚拟化到如今的AI推理,核心始终是如何高效调度高性能计算。H3 Lightning正是这套能力在AIGC时代的新落点。
现在开源模型不缺,缺的是谁能最快把它优化到生产可用,并持续反哺社区。RunningHub选了这条路,普通创作者也算跟着吃上细糠了。
相关代码已开源:https://github.com/RH-RunningHub/MiniMax-H3-MultiGPU-Lightning/