谷歌Gemini和Meta Muse被曝靠买数据刷榜,新评测一换题分数腰斩
榜单第二变倒数第三,只因换了套题
9月初,AI圈炸出一条猛料:谷歌的Gemini 3.8 Flash和Meta的Muse Spark 1.3,在同一个能力评测上,前后两版分数差出好几倍。
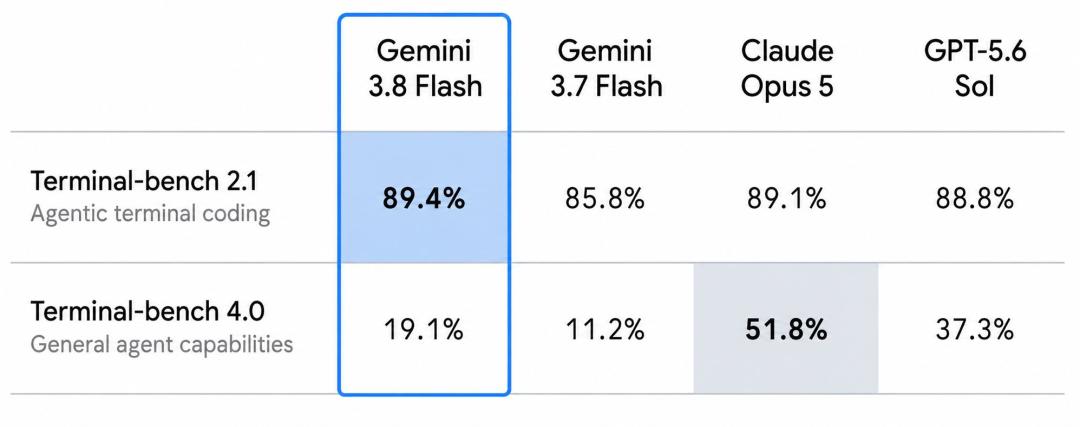
在Terminal-Bench 2.1榜单上,Gemini 3.8 Flash以89.4分高居第二,甚至压过了GPT-6 Astra(88.4分)。Muse Spark 1.3也以88.8分排第四,表现相当抢眼。
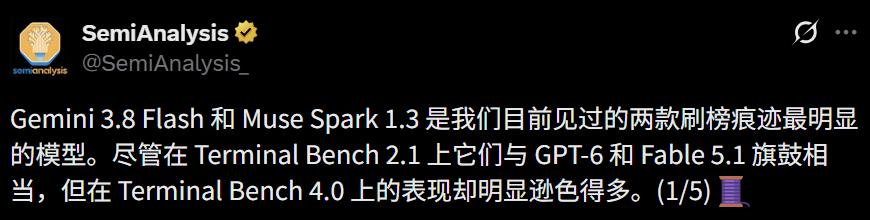
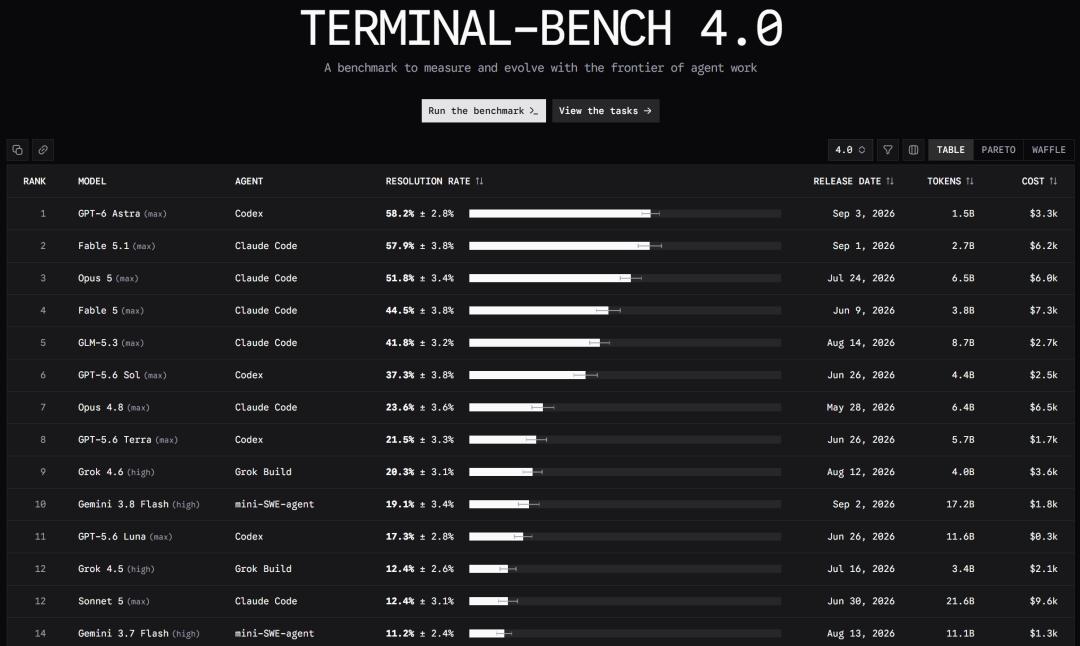
但到了8月29日刚上线的Terminal-Bench 4.0,情况急转直下。Gemini 3.8 Flash只拿到19.1分,在14个参评模型里排第12;Muse Spark 1.3的成绩是33.3分,勉强过线。而GPT-6 Astra虽然也从88.4掉到57.7,但跌幅远没那么夸张。
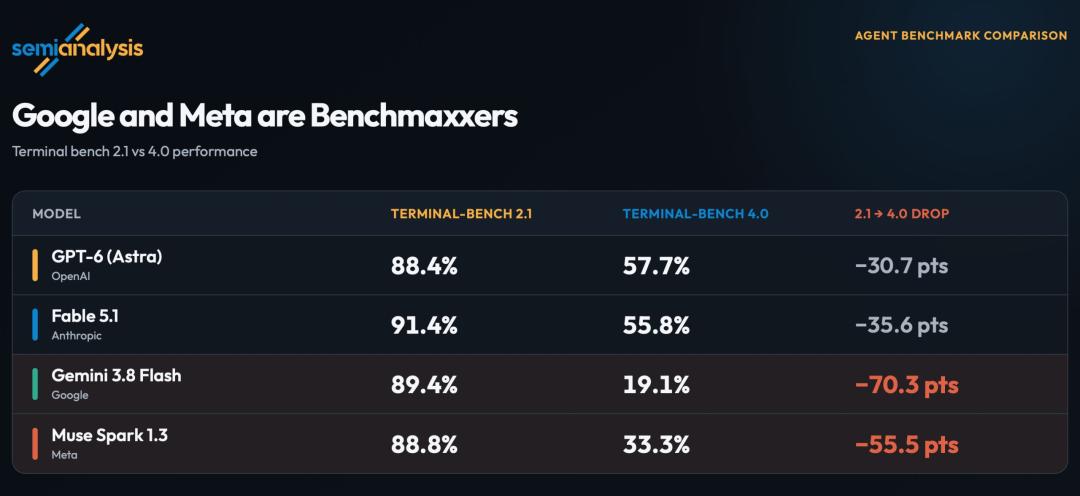
这就像一个学生在模拟考拿了年级第二,结果正式考试连及格线都没摸到。问题出在哪?
Terminal-Bench测的是什么?
Terminal-Bench不是那种只考问答或填空的简单测试。它模拟的是真实工作场景:给模型一个终端窗口和一个模糊目标,比如“部署一个带用户登录功能的网站”,剩下的全靠模型自己搞定。
它得自己规划步骤、调用工具、写代码、处理报错,甚至要反复调试。整个过程完全自动化,没人帮忙兜底。这种测试更贴近“AI Agent能不能真干活”的实际需求。
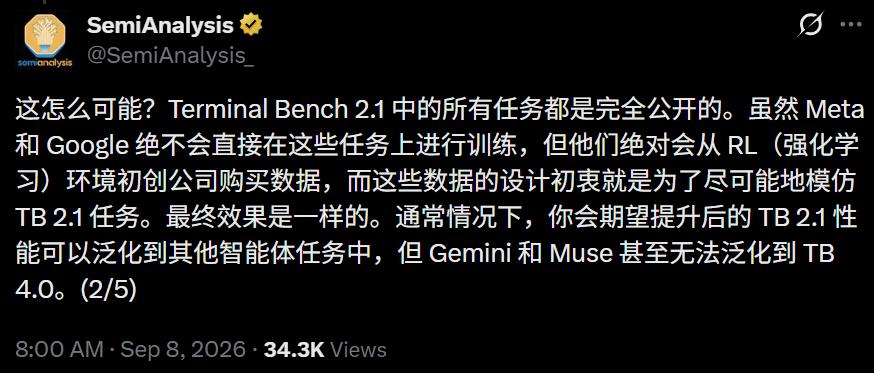
2.1版本发布后,很快成了行业热门基准。但正因为题目完全公开,不少团队开始针对性优化。有人直接把原题混进训练数据——这叫“污染”,查出来很容易。后来大家学聪明了,不再碰原题,而是去买“长得像考题”的模拟任务。
不抄原题,改买“密卷”
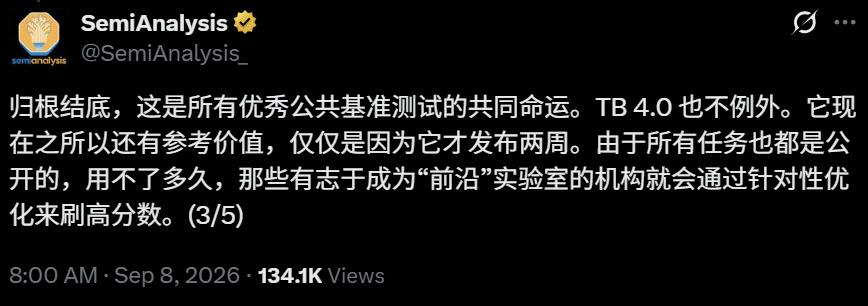
据分析机构SemiAnalysis透露,现在有一整条产业链专门做这事。公司会设计一套封闭的训练环境,里面包含大量与公开榜单题型高度相似的任务。模型在里面反复试错,系统给出奖励信号,相当于强化学习版的“押题班”。
这种服务明码标价:单个训练任务200到2000美元,复杂的软件工程任务能卖到2万美元。如果客户想复刻一个Slack级别的产品当训练场,报价30万美元起步。要是要求独家买断,价格还能翻4到5倍。
Epoch AI的调研显示,Anthropic内部曾讨论每年在这类数据上投入10亿美元。有研究员透露,单季合同均价在30万到50万美元之间。供给侧至少有35家公司提供类似服务,多数是20人以下的小团队。老牌数据商如Scale AI和Surge也早已转型,年收入分别超14亿和逼近10亿美元。
换句话说,想让模型在某个公开榜单上拿高分,根本不用作弊——直接掏钱买“密卷”就行。
主办方自己就是卖题的?
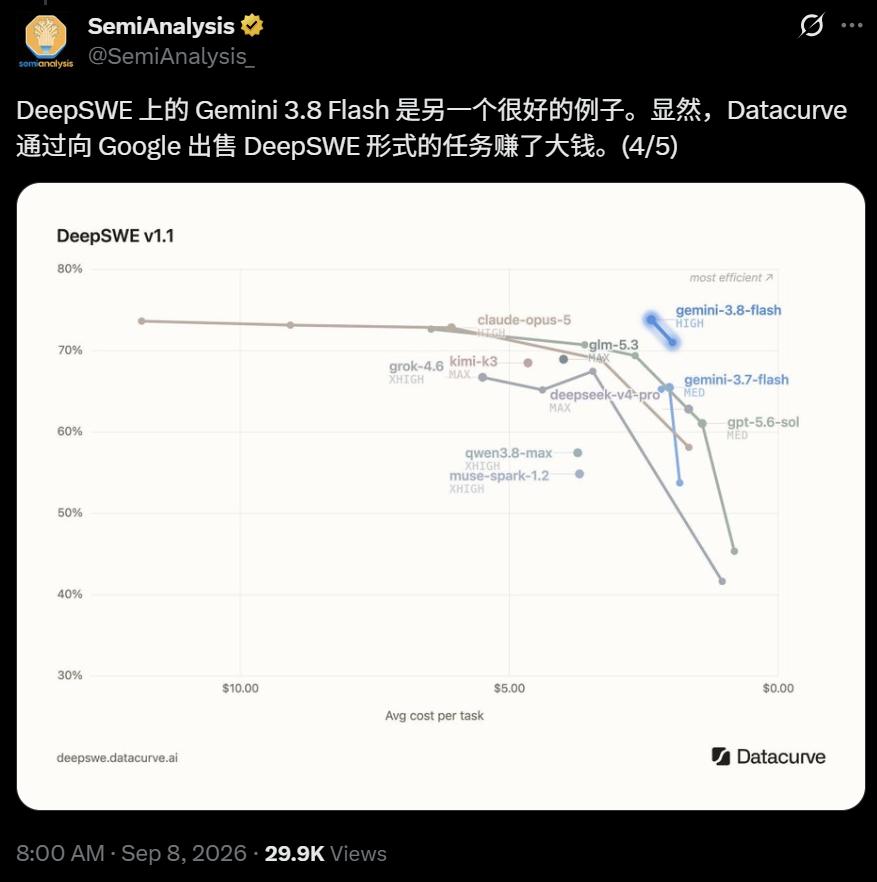
更耐人寻味的是另一份榜单DeepSWE 1.1。在这个专测长周期编程能力的排行榜上,Muse Spark 1.3(max)以75.4分第一,Gemini 3.8 Flash以73.8分排第四。
而这个榜单的主办方,是一家叫Datacurve的公司。巧的是,Datacurve的核心业务正是向大模型实验室出售“专家级编码数据和强化学习环境”。也就是说,它既是出题人、监考官,又是卖辅导资料的培训机构。
这种角色重叠很难不让人怀疑:榜单结果是否已被提前“优化”?
公开评测正在失效
SemiAnalysis的结论很直接:所有优质公开基准最终都会被“盘出包浆”。Terminal-Bench 4.0现在看起来还准,仅仅是因为它才发布两周。只要题目继续公开,用不了多久就会被各大实验室针对性训练到失效。
他们开出的药方是转向私有基准——由企业或研究机构内部维护、题目不公开的评测体系。这确实能避免“押题”,但代价也很明显:公开榜单将彻底沦为营销工具,真实能力对比只在少数人之间流传。
大厂或许乐见其成。闭卷考试谁都无法提前准备,反而更能体现真实水平。但对于普通开发者、中小企业和研究者来说,那把曾经可以公平丈量所有模型的公共尺子,可能再也找不回来了。
Meta和谷歌怎么说?
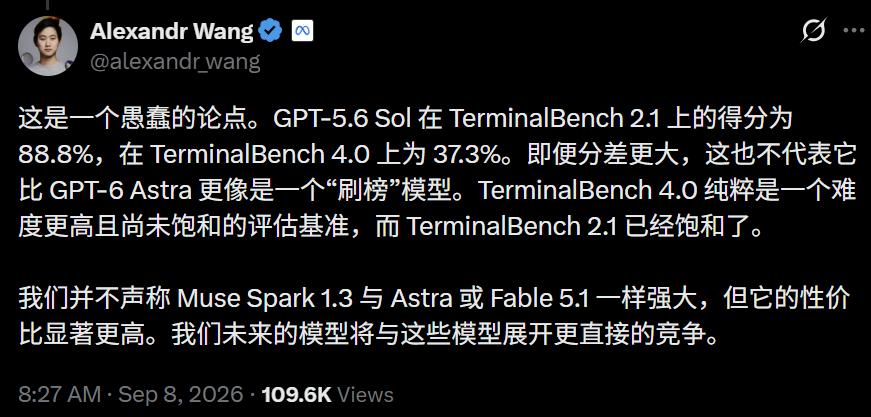
事件发酵后,Meta首席AI官Alexandr Wang迅速回应,称“这是个愚蠢的论点”。他指出GPT-5.6 Sol在2.1到4.0的分数跌幅更大(从88.8掉到37.3),却没人说它刷榜。他还强调,Meta从未宣称Muse Spark 1.3能比肩Astra或Fable 5.1,只是性价比更高。
谷歌方面则未直接回应。但业内普遍认为,即便没有主观恶意,这种依赖外部仿真数据的做法,客观上已经扭曲了公开评测的意义。
刷榜背后的逻辑
其实大厂这么做也不难理解。在AI军备竞赛中,榜单排名直接影响融资、客户信任和人才吸引力。一个模型如果能在知名基准上登顶,哪怕只是短期优势,也能带来巨大商业价值。
但问题在于,当“刷榜”变成行业潜规则,评测就失去了参考价值。开发者无法判断一个模型是真的强,还是只是“会考试”。更糟的是,资源有限的小团队根本玩不起这场游戏——他们既买不起高价训练数据,也没法自建私有评测体系。
下一步怎么办?
目前看,完全杜绝“押题”几乎不可能。可行的方向或许是建立更动态的评测机制:比如定期更换题目、引入对抗性测试、限制训练数据来源等。Terminal-Bench 4.0已经做了尝试——砍掉8道旧题、大修19道、加8小时超时限制,还专门设计“作弊试验”来筛掉钻空子的模型。
但这些措施治标不治本。只要公开题库存在,优化就会持续。或许未来的解决方案是“半公开”模式:核心题目保密,只公布评测维度和评分逻辑,允许第三方申请接入测试。
不过这样一来,透明度又会打折扣。如何在公平性、实用性与防作弊之间找平衡,成了整个AI社区必须面对的难题。
结语
这次事件暴露的不只是两家公司的策略问题,更是整个AI评测体系的脆弱性。当一把尺子本身可以被定制、被买卖,它量出来的“长度”还有多少意义?
对普通用户而言,或许该少看榜单排名,多关注实际体验。毕竟,模型能不能帮你高效完成任务,比它在某个测试里拿了多少分重要得多。