AI Agent 和直接调用大模型 API 到底有什么不同?
AI Agent 不是换个姿势调大模型
很多人第一次听说 AI Agent,容易把它理解成“更聪明地写 Prompt”或者“把多个 API 调用串起来”。这种理解不算错,但漏掉了最关键的东西:Agent 是一个能自己跑起来的系统,而不是一次性的问答。
想象一下你让朋友帮你订机票。如果你直接调大模型 API,相当于你问他:“明天去上海最便宜的航班是哪个?”他查完告诉你答案,然后就结束了。你得自己打开 App、输入信息、付款——他不干这些。
但如果你有个 AI Agent 助理,你说“帮我订明天去上海的机票”,它会自己查航班、比价格、选时间合适的、登录你的账号、填信息、付款,甚至发现信用卡过期了还会提醒你换卡。整个过程不需要你一步步指挥,它自己判断每一步该做什么。
这就是根本区别:一个是被动回答,一个是主动执行。
核心差异:三个关键能力
1. 循环执行:不是一次问答,而是一个闭环
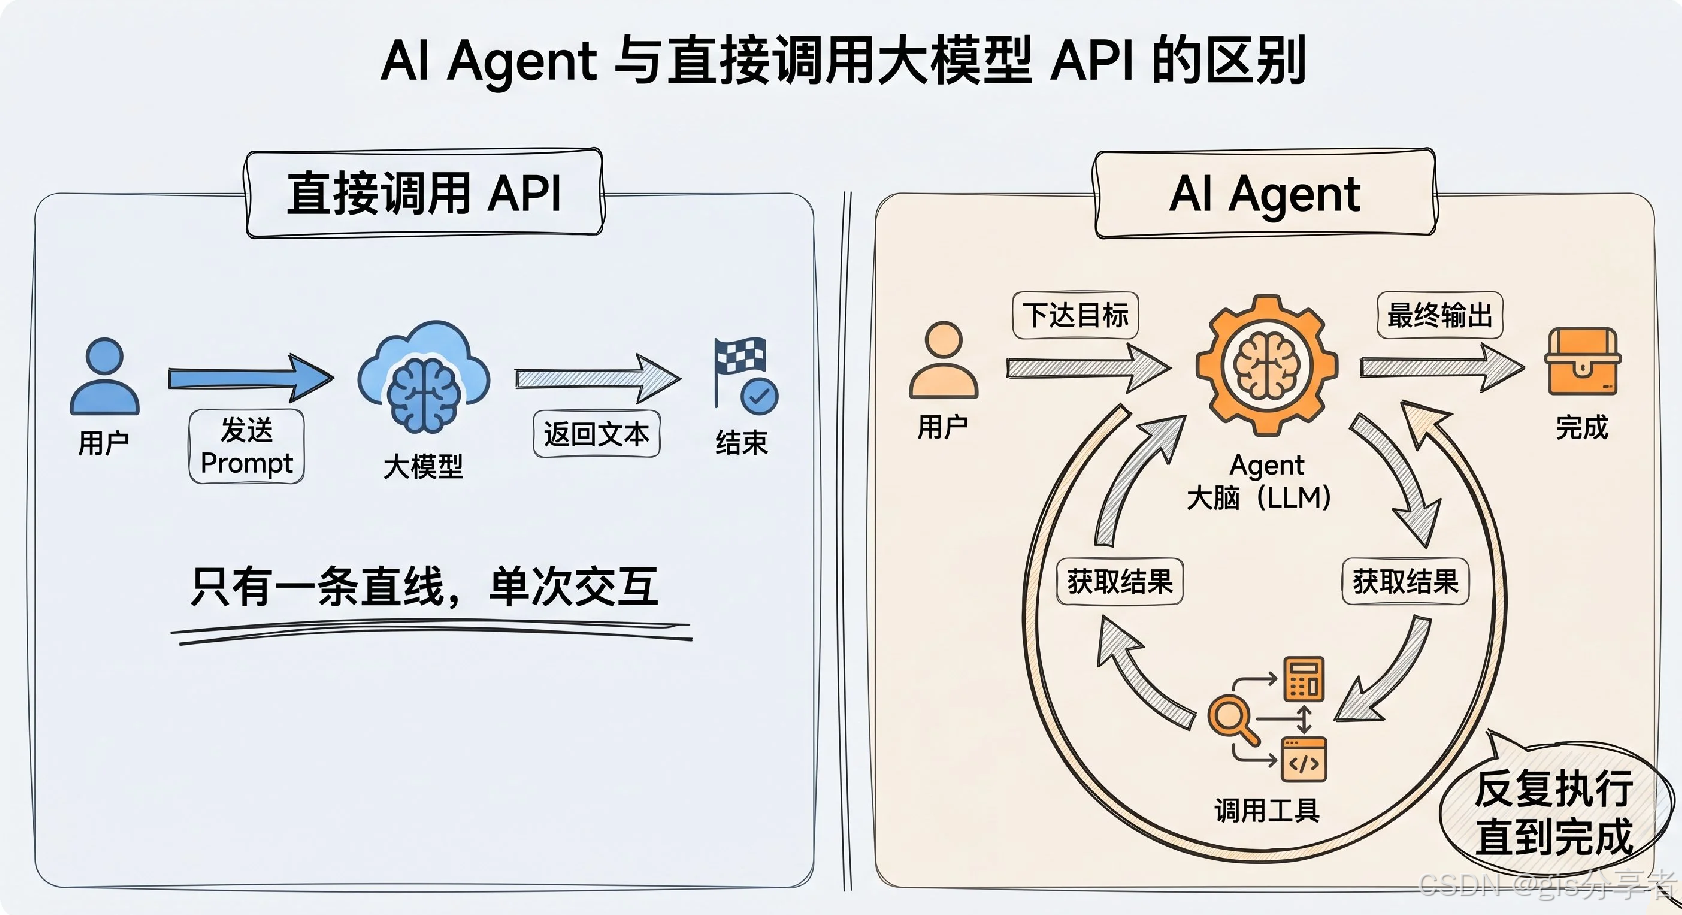
直接调用大模型 API 是单向的:你发 Prompt,模型返回文本,结束。哪怕你写再长的指令,模型也只能基于当前输入生成一次输出。
AI Agent 则内置了一个“思考 → 行动 → 观察”的循环。它拿到任务后,先分析需要几步;然后决定第一步做什么(比如调搜索工具);拿到结果后,再判断是否完成,没完成就继续下一步。这个过程可能重复多次,直到任务真正搞定。
举个例子:你想知道“特斯拉最近一季度在中国卖了多少车”。
- 直接调 API:你问模型,它可能凭记忆瞎猜一个数字,或者老实说“我不知道”。
- Agent:它会先意识到需要最新数据,于是调用财经数据库或新闻搜索工具;拿到几篇报道后,提取数字并交叉验证;如果数据冲突,可能再查官方财报;最后汇总出一个可靠答案。
这个过程中,Agent 自己决定“要不要查”“查什么”“信哪个”,而不是等你告诉它。
2. 工具调用:能动手,不只是动嘴
大模型 API 的输出永远是文本。哪怕它说“我已经帮你下单了”,实际上它什么都没做——只是生成了一段看起来像完成了的话。
真正的 Agent 必须能连接外部工具。常见的包括:
- 搜索引擎(查实时信息)
- 数据库(读写结构化数据)
- 代码解释器(运行 Python 做计算)
- 邮件/日历 API(安排会议)
- 电商或支付接口(实际下单)
这些工具让 Agent 从“纸上谈兵”变成“真能干活”。比如让它“分析上个月销售数据并邮件发给老板”,它会:
- 调数据库取原始数据
- 用代码计算环比、Top 产品等指标
- 生成图表和文字摘要
- 调邮件 API 发出去
每一步都是真实操作,不是模拟。
3. 记忆机制:记得自己做过什么
纯 API 调用每次都是“失忆”的。哪怕你连续发十条消息,模型也不会自动记住前九条(除非你手动把历史拼进 Prompt)。
Agent 则自带记忆。它可以记录:
- 已经尝试过哪些方法
- 中间结果是什么
- 用户之前提过什么偏好
这些记忆直接影响后续决策。比如你让 Agent “找一家适合带老人吃饭的餐厅”,它第一次推荐了家网红店,你回复“太吵了”。下次它就会避开热门商圈,优先选安静、有电梯、离地铁近的地方——因为它记住了“用户在意安静和便利性”。
从 Prompt 到 Agent:不是升级,是换赛道
早期大家用大模型,主要靠写超长 Prompt,把所有规则、格式、示例塞进去,希望一次输出完美结果。这叫“静态提示工程”。
但复杂任务根本没法一次搞定。比如“写一份市场分析报告”,涉及数据收集、竞品对比、趋势预测,每个环节都可能出错或需要调整。这时候,硬塞 Prompt 反而容易混乱。
Agent 的思路完全不同:把任务拆成小步,每步只做一件事,做完再看情况决定下一步。这更接近人类解决问题的方式——没人会闭着眼一口气写出完整报告,都是查一点、写一点、改一点。
所以 Agent 不是 Prompt 的“高级版”,而是把大模型当成“大脑”,外面包一层“手脚”(工具)和“记忆”(状态管理),组成一个能自主运行的系统。
Agent 和 Workflow 也不是一回事
有人会问:那我用 LangChain 或 LlamaIndex 把几个 API 串起来,算不算 Agent?
不一定。关键看有没有“自主决策”能力。
- 固定 Workflow:比如“先搜索,再总结,最后发邮件”。步骤是预设死的,不管中间结果如何,都按顺序走完。这更像是自动化脚本。
- 真正的 Agent:步骤是动态生成的。比如搜索后发现信息不足,它可能决定再查数据库;如果数据库也空,就改问用户要线索。路径不是固定的,而是根据观察实时调整。
打个比方:Workflow 是地铁线路图,到站就停;Agent 是出租车司机,你告诉目的地,他根据路况自己选路,堵车就绕行。
实际场景中的表现差异
场景一:处理模糊需求
用户说:“帮我看看这个月花得是不是太多了。”
- API 调用:模型可能泛泛而谈“建议记账”“控制消费”,因为没有具体数据。
- Agent:它会先调你的银行账单 API,拉出本月支出;分类统计餐饮、交通、娱乐等;对比上月和预算;最后指出“外卖花了 2800,比上月多 40%”,并问“要不要设置限额?”
场景二:应对意外中断
Agent 正在订酒店,突然支付失败。
- 固定流程:报错退出,任务失败。
- 智能 Agent:它会分析错误码,如果是信用卡问题,就问你“要不要换张卡?”;如果是房态满,就自动搜附近同级酒店;甚至能协商“加 50 块升级房型是否有空”。
场景三:长期任务跟踪
你让 Agent “每周一发销售周报”。
- API 调用:你每周一得手动触发一次。
- Agent:它内置定时器,每周一自动执行全套流程:取数据、生成报告、发邮件。你还能随时说“这周跳过”或“加个新指标”,它会记住并调整后续行为。
别被“智能”二字忽悠
现在有些产品打着“AI Agent”旗号,其实只是把几个 API 用 if-else 串起来。比如“如果用户问天气,就调天气 API;如果问新闻,就调搜索”。这种叫“规则引擎+大模型”,不算真正的 Agent。
真正的 Agent 必须满足:
- 目标驱动:始终围绕最终目标行动,不是机械响应指令
- 动态规划:路径可变,能根据中间结果调整策略
- 工具交互:能读写外部系统,不只是生成文本
- 状态保持:有短期或长期记忆,避免重复犯错
缺任何一个,都只能算“伪 Agent”。
总结:关键看能不能“自己跑起来”
判断一个系统是不是真正的 AI Agent,就问一个问题:如果中途断网一小时,恢复后它能不能接着刚才的状态继续干,而不用你重新交代一遍?
如果能,说明它有记忆、有目标、有自主决策能力——是 Agent。
如果不能,只是等着你喂下一步指令,那本质上还是高级版 API 调用。
未来,随着工具生态完善,Agent 会越来越多承担实际工作,比如自动运维、智能客服、个人助理。但前提是,别把“能说话”当成“能办事”。