统一多模态模型中理解与生成真的能互相促进吗?
理解和生成塞进一个模型,就一定能互相帮忙吗?
最近几年,统一多模态模型(Unified Multimodal Models, UMMs)越来越火。这类模型试图在一个架构里同时搞定视觉理解(比如看图回答问题)和图像生成(比如根据文字画图)。听起来很理想:文本和图像在同一个上下文中被处理,理解与生成无缝衔接。
但这里有个更根本的问题没人说清楚:把理解和生成硬塞进同一个模型后,它们真的会互相帮助,还是只是表面上“功能统一”,实际上互相拖后腿?
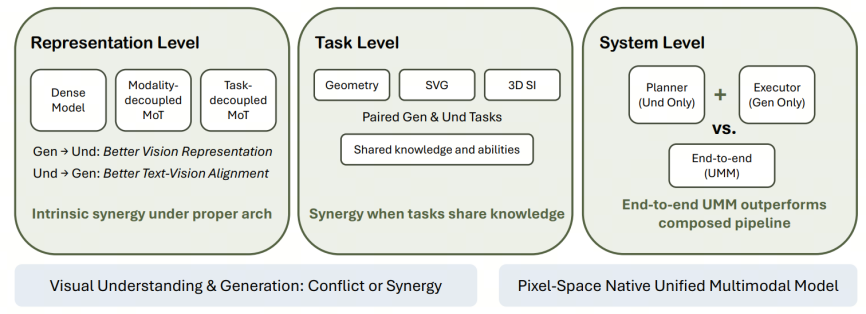
南洋理工大学MMLab的最新论文《Uncovering Understanding–Generation Synergy in Native Unified Multimodal Models: From Representation, Task to System》就专门来回答这个问题。他们没用现成的视觉编码器,而是从最干净的“像素进、像素出”原生多模态架构出发,把问题拆成三层来看:表征(Representation)、任务(Task)和系统(System)。
表征层面:共享不等于共赢
第一层,他们先看视觉表征——也就是模型内部学到的图像特征——在联合训练下会怎么变。
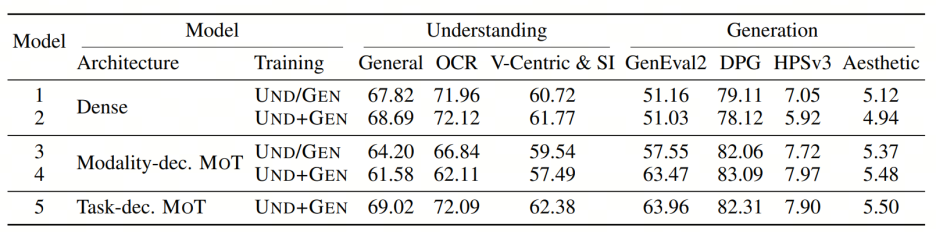
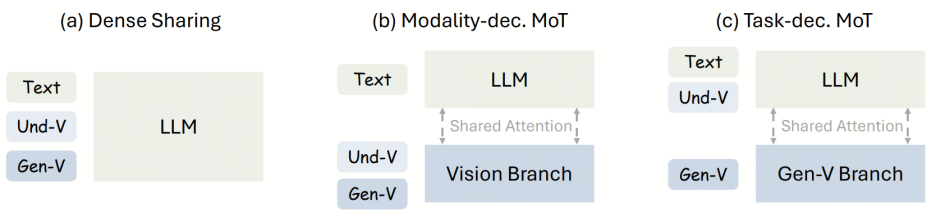
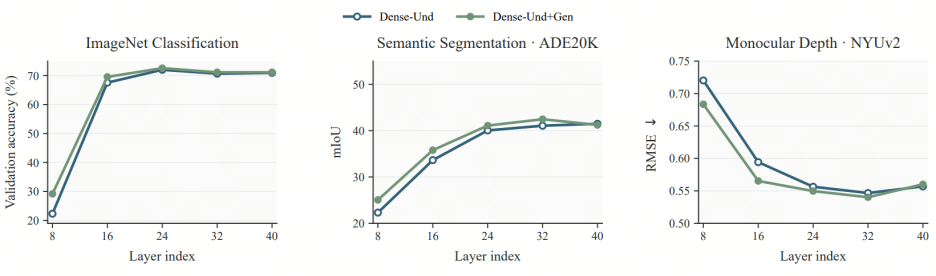
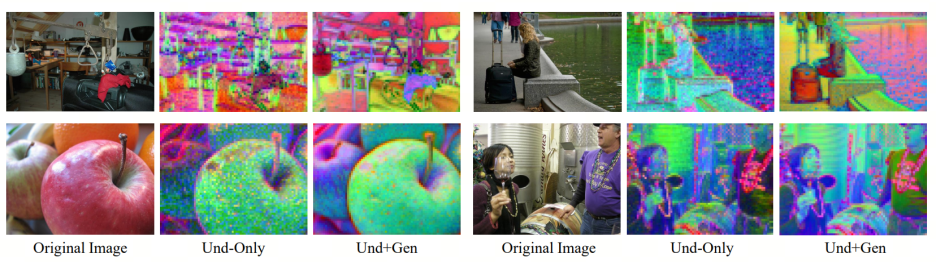
实验用了两种架构对比。一种叫 Dense Sharing:文本、用于理解的干净视觉token、用于生成的带噪视觉token,全走同一套大语言模型(LLM)参数。结果发现,加了生成任务后,模型在ImageNet分类、ADE20K分割、NYUv2深度估计这些理解任务上表现更好了。这说明生成任务确实能帮理解学到更丰富的视觉表征。
但代价是:图像生成质量反而下降了。
反过来,当他们用 modality-decoupled MoT(把视觉token放进独立的视觉分支),情况反转:生成变好了,理解却变差了。
更细的分析显示,加入理解训练后,文本特征和生成用的视觉特征之间的对齐度(用CKA衡量)明显提升。也就是说,理解任务能让生成的图像更好地贴合文字描述。
两边都能给对方提供有用信号,但问题出在“路径竞争”:如果强迫所有token挤同一条路,总有一方会占主导,另一方就被边缘化,变成辅助监督。
于是他们提出 Task-decoupled MoT:理解用的视觉token走语言锚定的主干,生成用的token走专门优化的生成分支。两条路通过共享注意力和文本语义保持联系,但计算路径分开。这样既避免了一边压垮另一边,又保留了信息互通。实验证明,这种“部分专用、部分共享”的设计,让理解和生成能力同步提升。
任务层面:知识共通才是关键
解决了表征冲突,下一个问题是:哪些理解任务和生成任务放一起练,才能真正互相促进?
答案取决于它们是否依赖相同的底层知识或能力。
论文选了三个案例来验证。
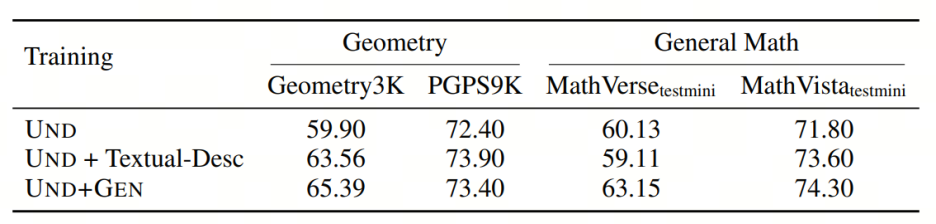
第一个是几何推理。理解几何题要识别图形中的点、线、角及其约束关系;而生成或编辑几何图,同样需要掌握这些结构规则。当模型同时训练几何图像生成和编辑任务后,不仅Geometry3K、PGPS9K这些几何理解benchmark得分上升,连MathVerse、MathVista这类通用数学推理任务也受益了。
有意思的是,作者把同样的生成数据转成图像描述(纯理解任务)作为对照组,结果收益远不如联合训练。这说明,学习如何生成一个符合几何规则的图形,本身就是一种比语言描述更强的监督信号。
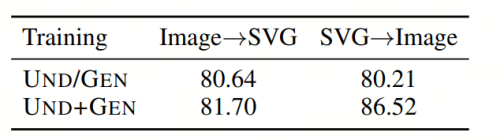
第二个案例是SVG(可缩放矢量图形)。模型要同时学会从图像生成SVG代码(Image→SVG),以及从SVG代码重建图像(SVG→Image)。这两种任务本质上依赖同一个矢量结构知识。
联合训练后,Image→SVG准确率从80.64%升到81.70%,SVG→Image更是从80.21%跃升至86.52%。分析发现,模型现在能直接从SVG代码“脑补”出对应图标的样子,想象力明显增强。
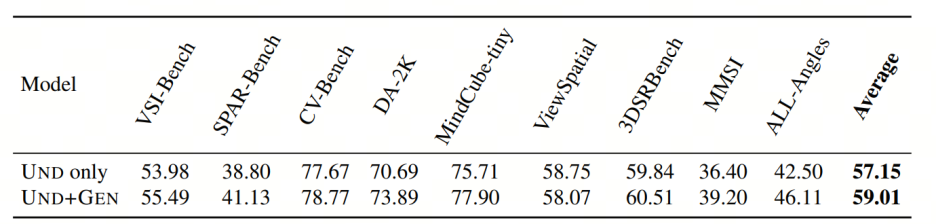
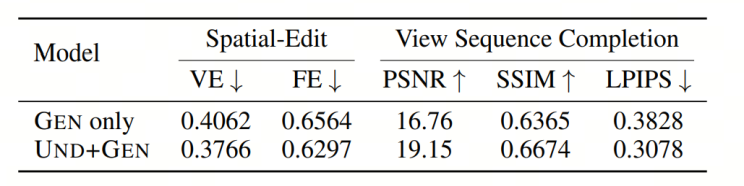
第三个是3D空间智能。涉及理解物体在三维空间中的位置、遮挡、相对关系,以及生成符合物理规律的3D场景。联合训练后,一系列相关理解和生成任务都得到提升。
这三个例子共同指向一个结论:只有当理解和生成共享latent knowledge时,双向迁移才会发生。随便拼两个任务,大概率只是互相干扰。
系统层面:为什么不用两个专用模型串起来?
到了系统层面,问题更现实:既然已经有很强的专用理解模型和专用生成模型,干嘛非得搞一个统一模型?直接用智能体(agent)把两个模型串起来不行吗?
比如,先用理解模型分析用户意图和图像内容,再把指令传给生成模型出图。模块化、灵活、还能各自迭代。
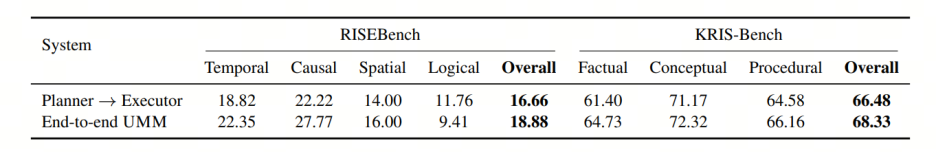
论文选了一个需要深度推理的图像编辑任务来公平比较:给一张原图和一个隐式编辑请求(比如“让这个房间看起来更温馨”),模型得先理解场景、推断具体修改点(换灯?加毯子?),再生成结果。
他们在相同基础模型、相同训练数据下,对比了两种方案:
- 模块化Pipeline:Planner(理解+推理) + Executor(生成)
- 端到端UMM:一个模型完成全部流程
结果在RISEBench和KRIS-Bench两个评测集上,端到端模型整体表现更好。
这说明,当任务需要理解、推理、生成紧密咬合时,端到端优化本身就能催生新能力。中间拆成两步,信息在传递中可能丢失,或者推理不够精细。而统一模型内部可以反复迭代、微调,形成更连贯的思维链。
UMM的真正价值在哪?
这项研究最后总结:UMM的价值不在于“一个模型干两件事”的便利性,而在于两类场景:
第一类在任务层面:当理解和生成天然共享底层知识时,联合训练能带来1+1>2的效果。比如具身智能中的world modeling(理解环境状态)和policy learning(生成动作),都依赖对物理规律、物体动态的共同建模。这时候UMM可以直接作为VLA(视觉语言动作)和WAM(世界模型)的结合体,成为更好的基座。
第二类在系统层面:当任务本身要求理解与生成高频交互时,比如通过生成图像来辅助多模态推理(“画个草图帮我理清思路”),或者需要多轮编辑反馈的agentic generation,端到端UMM能实现更高上限和效率。
换句话说,UMM不是万能胶水,不能随便把两个任务粘一起就指望协同。它的优势只在特定条件下显现——而这篇论文给出了判断这些条件的清晰框架:从表征是否冲突,到任务是否共知,再到系统是否需要紧耦合。
未来的设计方向也很明确:别再盲目追求“全共享”,而要在共享与专用之间找到平衡点。毕竟,真正的协同,从来不是靠强行合并,而是靠精准匹配。