用 WorkBuddy + Hy4 Preview 实现苏轼《定风波》三维诗词页:Three.js 与 Web Speech API 实践
技术选型与整体架构
最初的想法很简单:做一个网页,左边放苏轼的 3D 立像,右边展示《定风波》,还能让他“亲口”念出来。拆开来看,其实就三件事:模型从哪来、怎么在网页里展示、怎么发音。
模型来源上,手工建模太费时,素材站又难找符合宋代文人气质的形象,最后选了腾讯混元生 3D——输入一段详细提示词,几分钟就能出带 PBR 材质的全身像。渲染引擎在 Babylon.js 和 Three.js 之间犹豫了一下,还是选了生态更成熟的 Three.js,尤其是它的 GLTFLoader 和 OrbitControls 开箱即用,省心不少。至于语音,虽然云端 TTS 音质更好,但要管密钥、跨域、计费,对一个展示页来说太重了。浏览器自带的 Web Speech API 虽然音色依赖系统(Windows 上一般是 Huihui 或 Yaoyao),但零依赖、零成本,够用了。
最终决定做成单 HTML 文件,双击就能打开。整个页面按三层组织:数据层是统一的 POEM 数组,既用于生成 DOM 也用于语音朗读;呈现层是 Three.js 场景加竖排诗词;交互层靠 OrbitControls 控制视角,靠 speechSynthesis 控制朗读。这样改一处标点,两边都能同步更新,避免不一致。
三维人像:从 AI 建模到 GLB 校验
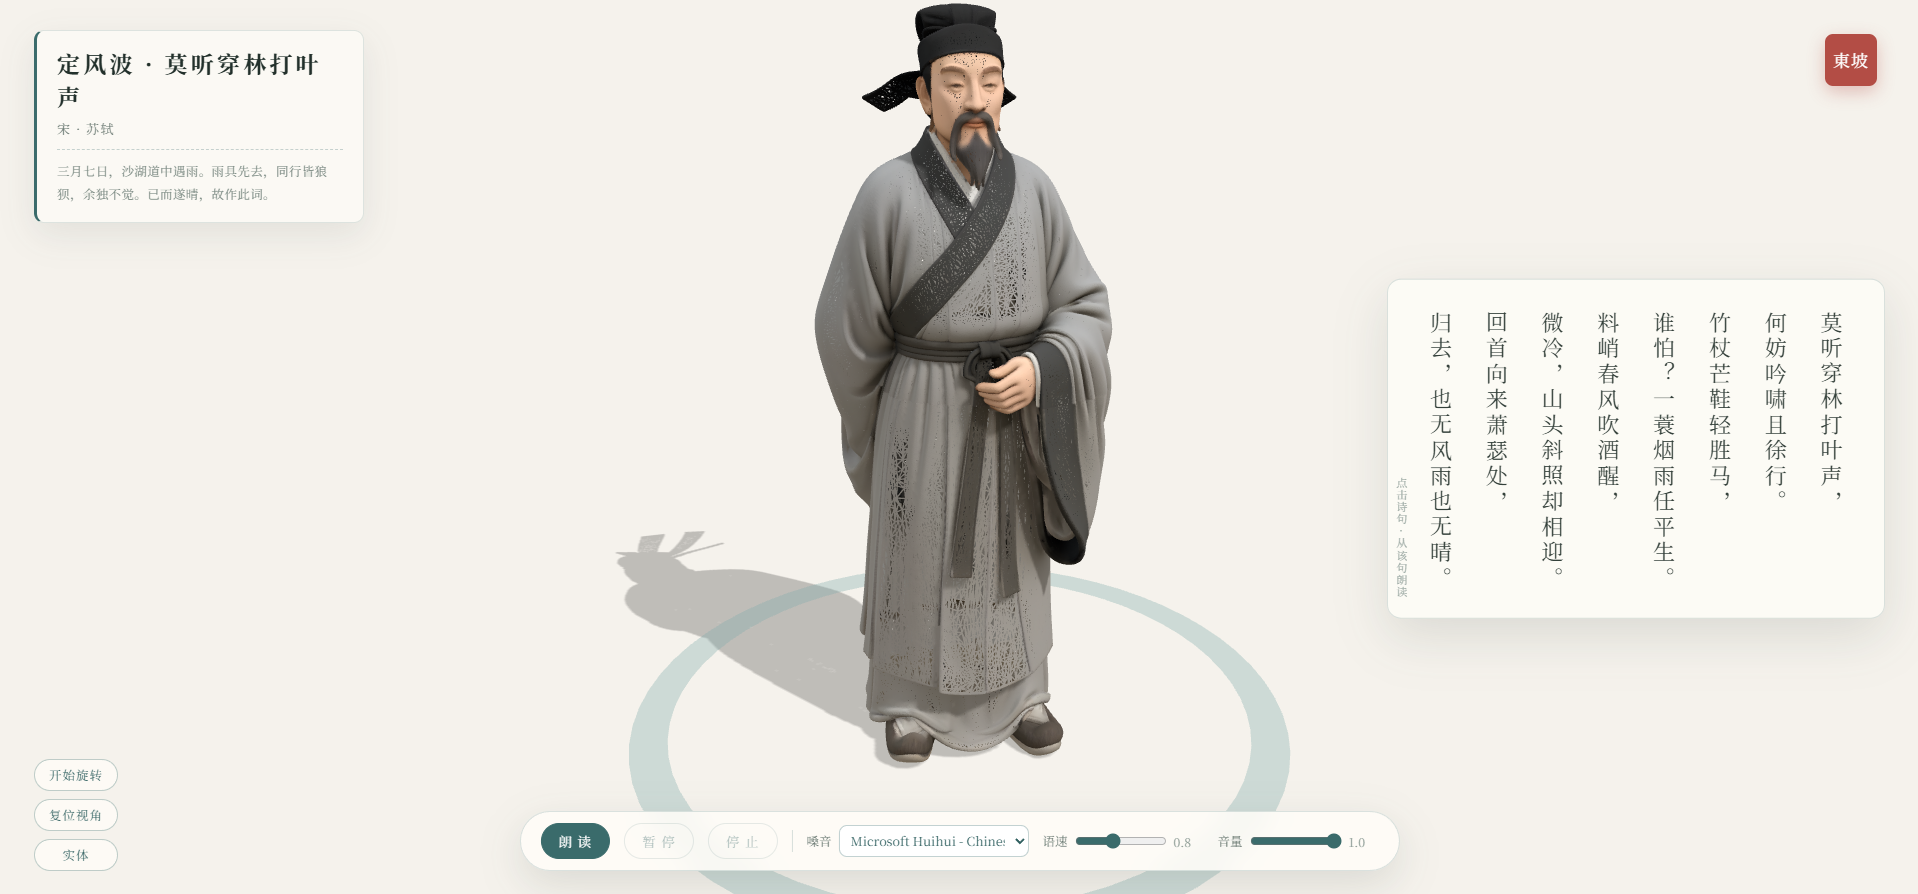
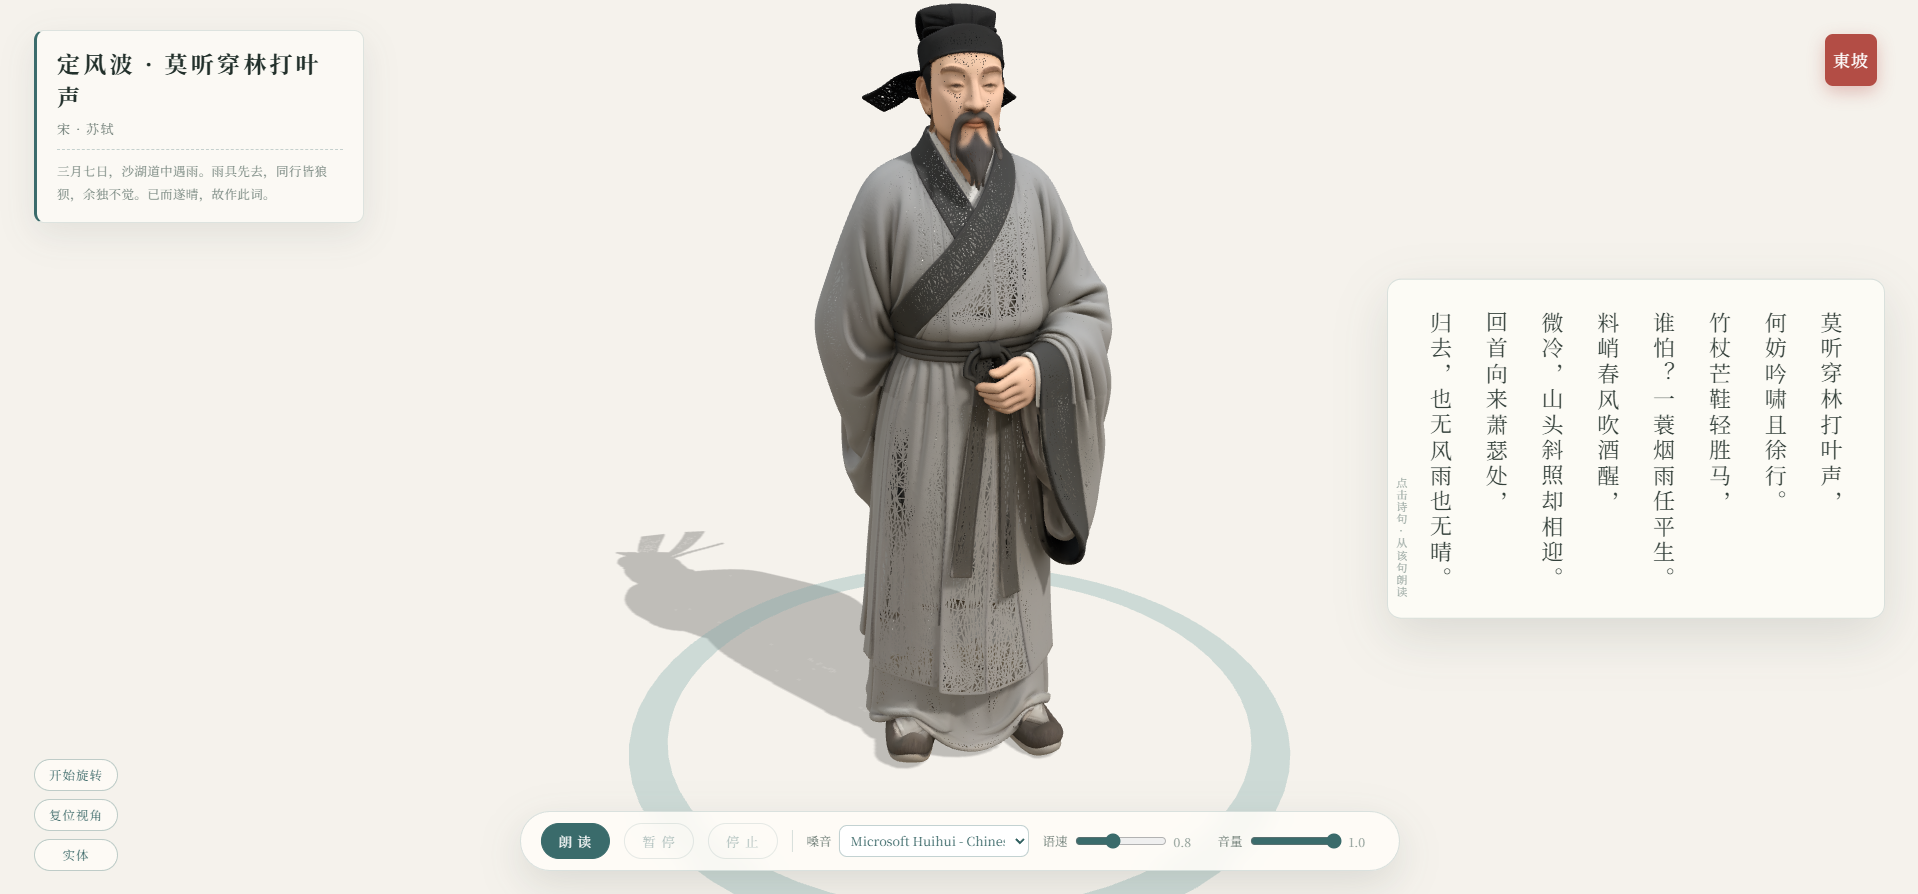
用混元生 3D 生成苏轼像时,提示词写得越具体,结果越稳。我强调了“北宋文豪”“东坡巾”“宽袖长袍”“站立姿态”“纯色背景”这些细节,还开了 PBR 材质和高精度模式。大约三分半钟后,拿到了一个 37.7MB 的 sushi.glb 文件。
在怀疑任何加载代码前,先确认文件本身没问题。GLB 是二进制格式,开头 12 字节必须是 glTF,后面跟着 JSON 和 BIN 两个 chunk。我写了个小脚本检查:文件头对不对、声明长度和实际长度是否一致、有没有用 Draco 压缩。幸运的是,这个模型没用 Draco,纹理也是内嵌的,属于最省心的情况。
Three.js 场景追求“展厅感”:宣纸色背景 (#f5f2ec),三点布光——环境光打底,主光投射柔和阴影,再加一盏冷色轮廓光把人物从背景里“抠”出来。几个容易忽略的细节:outputEncoding 必须设为 sRGBEncoding,否则 PBR 贴图会发灰;阴影的 bias 要给个微小负值,不然模型表面会出现条纹状的“痤疮”。
AI 生成的模型尺寸未知,不能硬编码相机距离。我写了段 frameModel 函数:先算出包围盒,统一缩放到 2.4 个单位高,再把几何中心移到原点,最后抬升让脚底落在 y=0 的地面上。顺序很重要,写反了模型会悬空或陷进地里。
踩坑实录:内联模型的解析失败
最有价值的部分其实是踩的坑。为了追求“真正的单文件”,我把 37.7MB 的 GLB 转成 base64 内联进 HTML,结果浏览器只报一句“模型解析失败”。
第一反应是文件坏了。我先用 Python 校验 base64 能否无损还原,发现解码后的字节和原文件完全一致,sha256 也匹配。接着在 Node 里用同版本的 GLTFLoader 解析,结果成功了。这说明问题不在文件,而在浏览器端处理 51MB 巨型内联脚本的方式——可能撞上了内存或字符串长度上限。
排查过程中还有个干扰项:用 grep -c 检查 HTML 是否有未替换的占位符,结果返回 1。后来发现是误报——three.min.js 压缩后是单行,里面本身就含有 __THREE__ 字符串,grep -c 数的是行数不是次数。正确的做法是校验带上下文的模式,比如 <script>__THREE__</script>。
最终放弃内联,改用 fetch 加载。配套做了三重兜底:多候选路径尝试(兼容不同托管方式)、文件选择器、拖拽加载。这样即使本地双击打开(受 file:// 限制),用户也能手动载入模型。顺便还解决了另一个坑:本地起 HTTP 服务时 curl 返回 502,原来是环境变量里的代理把 localhost 请求也拦了,加 --noproxy '*' 绕过就行。
词文呈现:竖排排版与响应式
古典诗词用竖排才有味道。CSS 的 writing-mode: vertical-rl 让这事变得简单,但有个反直觉的点:在竖排下,块级元素的排列方向是从右到左,所以“行间距”要用左右 margin 控制,而不是上下 margin。
视觉上走“宣纸+青瓷+朱印”路线:页面背景是 #f5f2ec,正文墨色 #33403a,朗读高亮用朱砂 #a8322a。背景还铺了两句超大号低透明度装饰文字(“一蓑烟雨任平生”“也无风雨也无晴”),增加层次感但不抢戏。
手机上看竖排会挤成一团,所以窄屏下用媒体查询切换回横排,并把诗词区移到底部。小屏还隐藏了三维按钮和印章装饰,让界面更清爽。
让东坡开口:语音朗读与高亮同步
最开始想把整首词塞进一个 utterance 一次读完,但 onboundary 事件在中文上支持太差,很多浏览器根本不触发,没法做逐句高亮。可靠的方案是拆句调度:每一句一个 utterance,靠 onend 驱动下一句,同时切换高亮。
这里有个经典坑:utterance 必须持有外部引用(比如 curUtter = u),否则 Chrome 可能在朗读中途把它垃圾回收,导致读到一半突然静音。另外,onerror 里也要继续推进,避免单句出错卡住整首词。每次开始朗读前先 synth.cancel(),防止连续点击造成语音叠加。
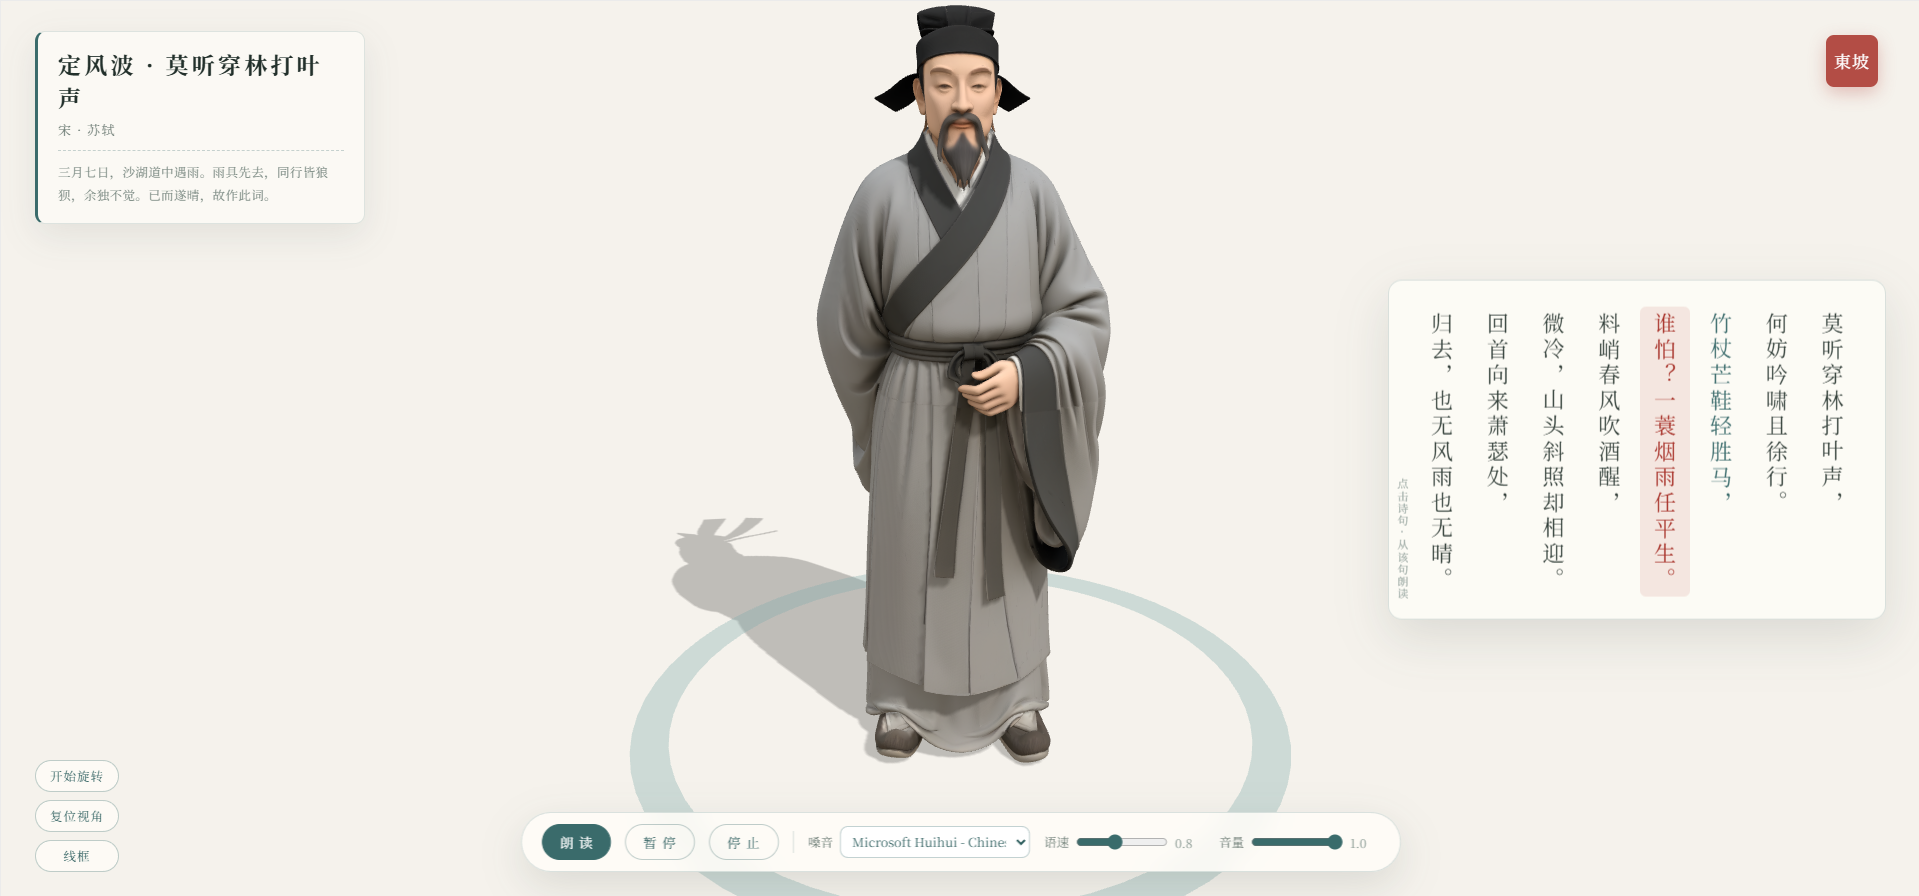
中文嗓音要筛选。speechSynthesis.getVoices() 是异步的,页面刚加载时常返回空数组,得监听 voiceschanged 事件。Windows 上常见的中文嗓音是 Microsoft Huihui/Yaoyao,优先选 zh-CN 的。用户切换音色时,重新调用 startAt(idx) 就能立刻用新嗓音重读当前句。
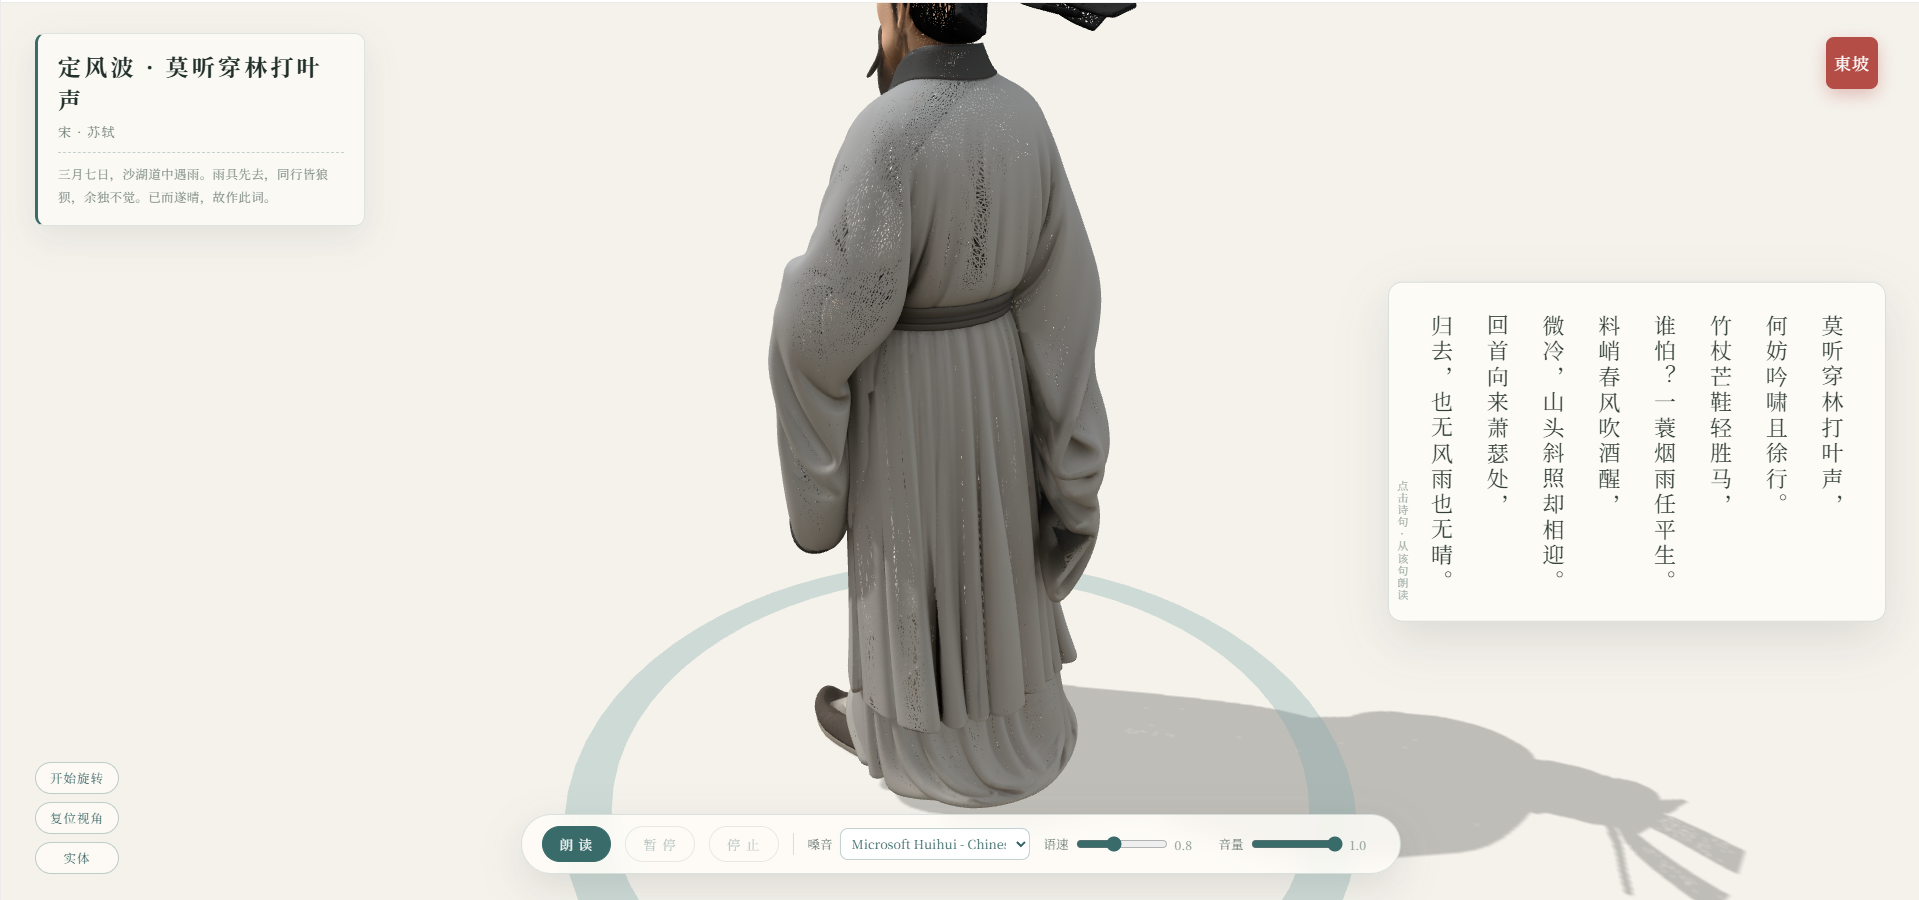
高亮逻辑很简单,但配合点击跳转和窄屏滚动体验更好:点哪句从哪句读,窄屏时自动把当前句滚进可视区。还加了键盘快捷键——空格键控制播放/暂停,Esc 键停止,不用鼠标也能操作。
完整源码与扩展
项目结构很清晰:dingfengbo.html 是最终成品(751KB,离线可用),models/sushi.glb 是 AI 生成的模型,vendor/ 下放 Three.js 相关库。为了维护方便,写了个 build_poem.py 构建脚本,把库文件内联合并进 HTML,改代码时只需改模板再跑一次脚本。
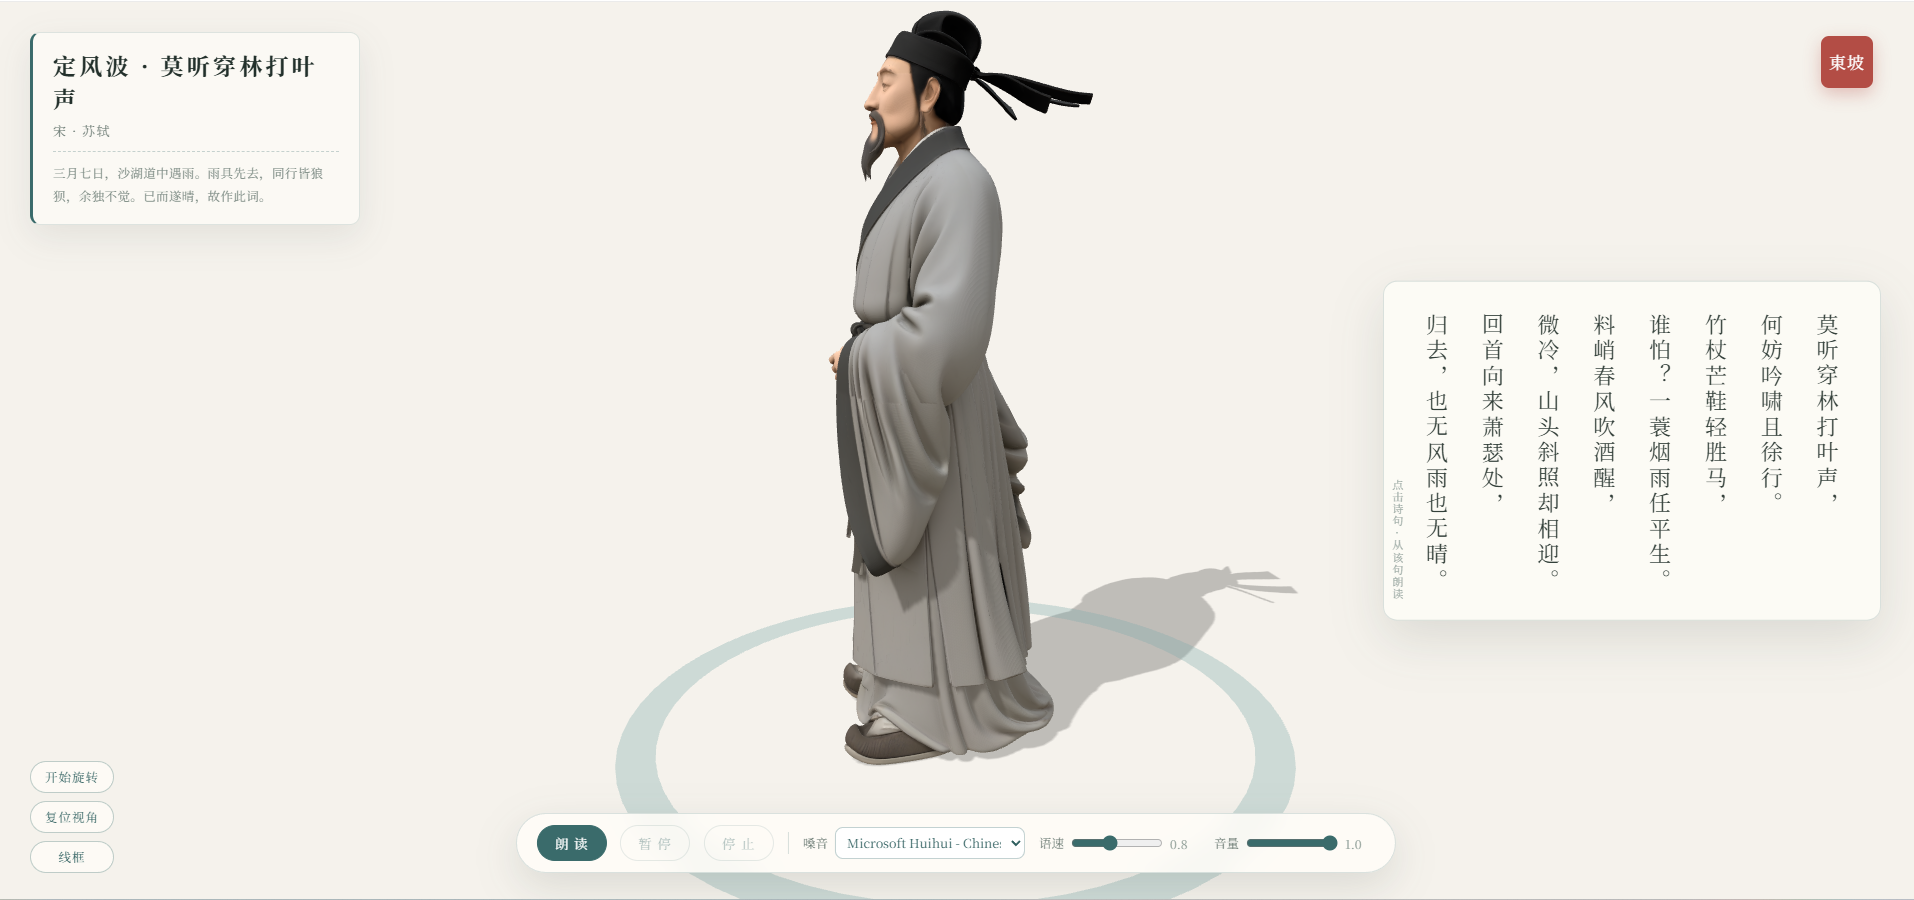
本地运行必须通过 HTTP 服务(比如 python -m http.server),因为要 fetch 模型文件。直接双击会被 file:// 安全策略拦截,不过页面会提示手动选择 glb 文件。
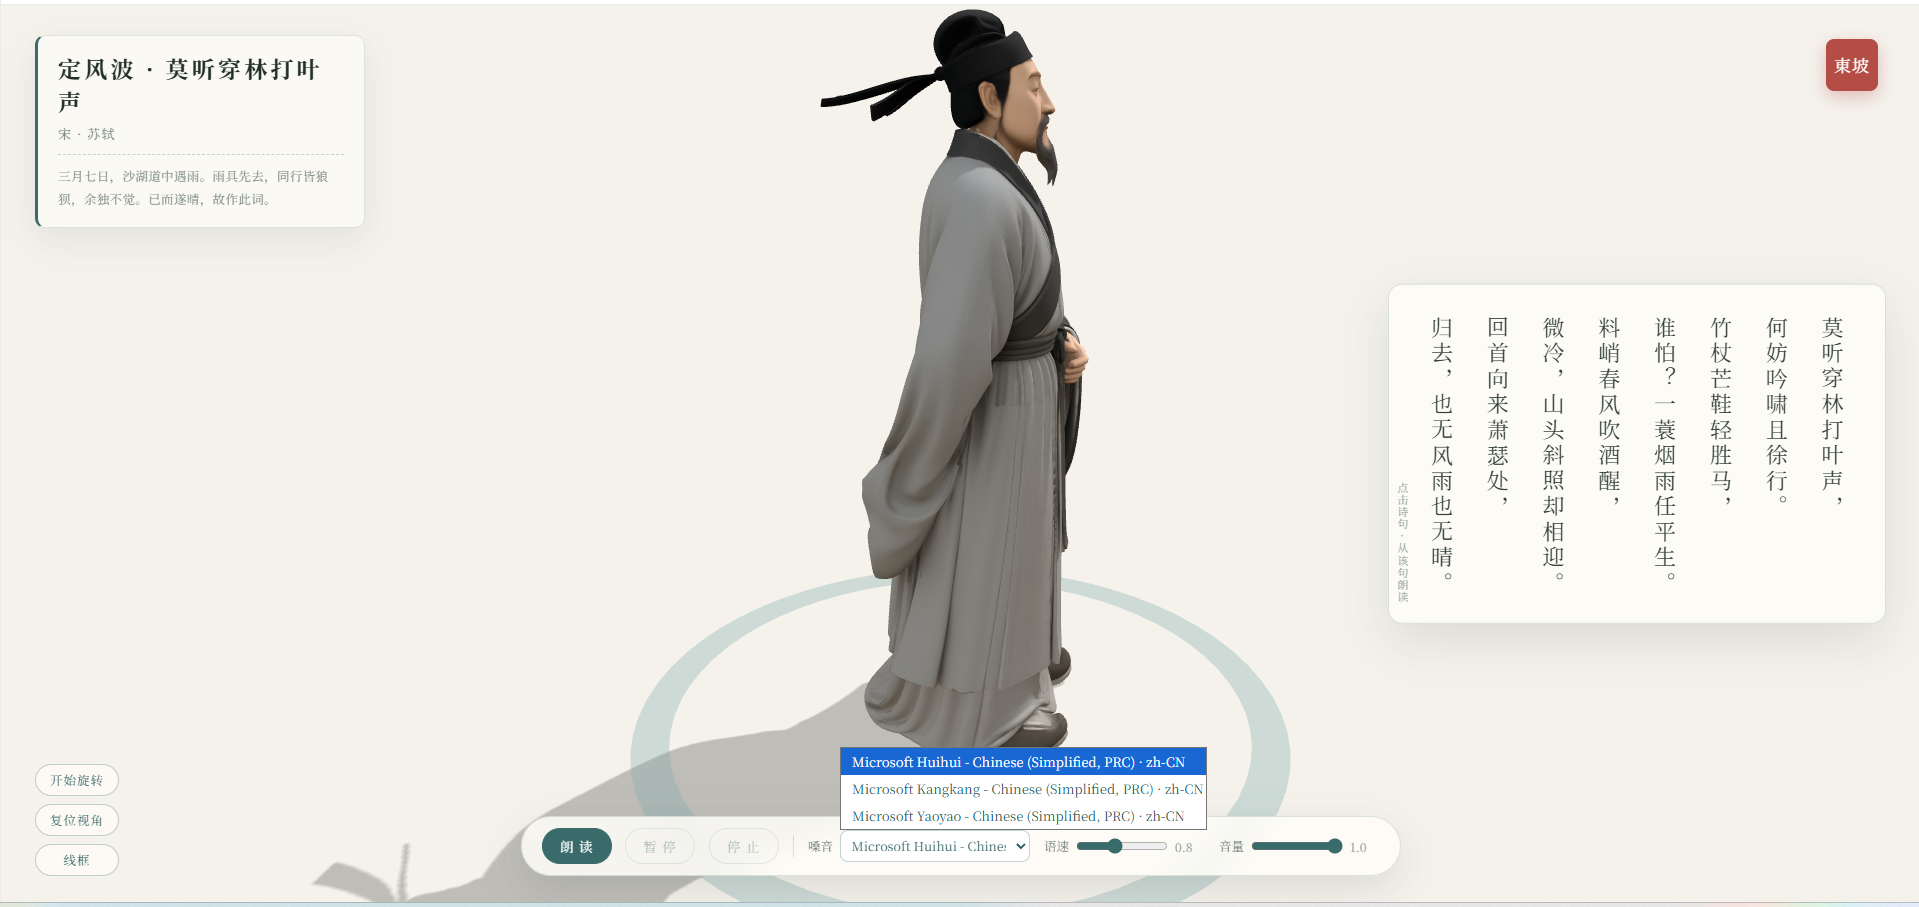
这个骨架很容易扩展:换一首词只需改 POEM 数组;换历史人物就重新生成 glb 放进 models 目录;想加译文注释,可以在 POEM 里加字段;如果真要用云端 TTS,把 speakLine 函数换成调用后端接口就行,其他调度逻辑完全复用。
回头看,真正花时间的不是写代码,而是那个“解析失败”的排查。它给了三条实用经验:大文件别内联进 HTML,校验文件完整性要用带上下文的模式,Web Speech 的 utterance 必须防 GC。技术本身都不复杂,难的是把“看起来应该能行”的方案,变成“真的能跑”的东西。