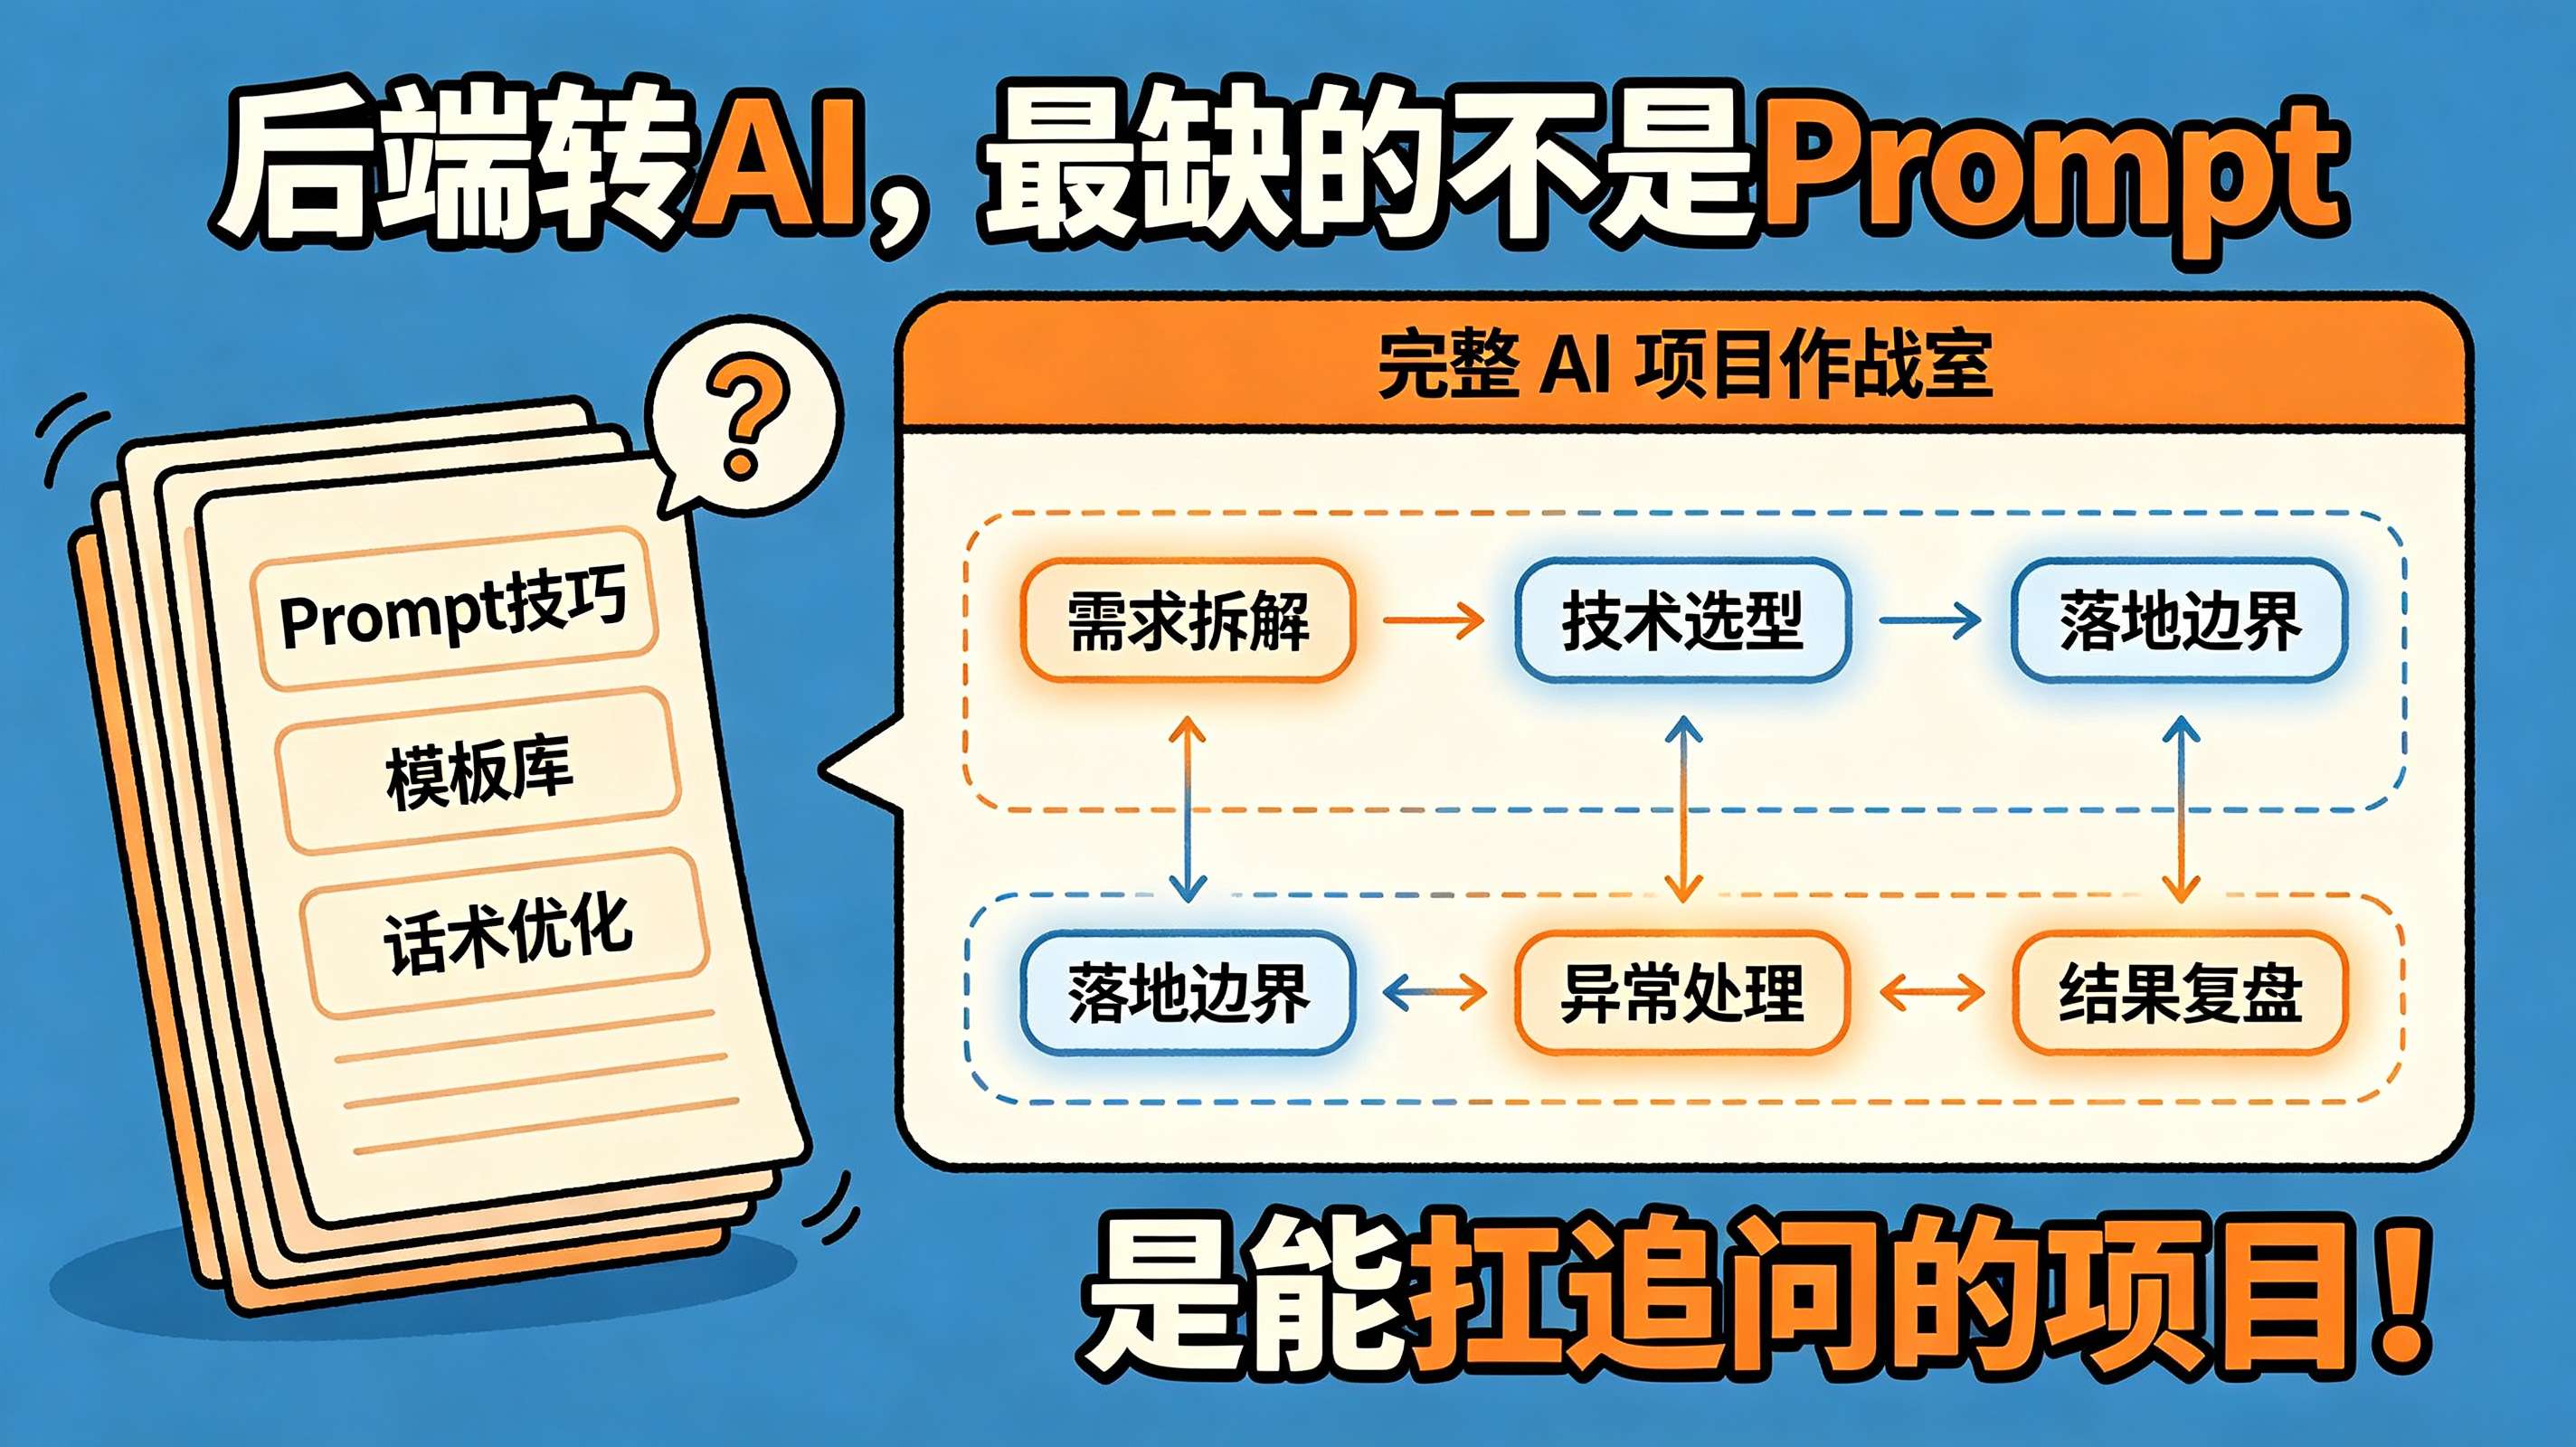
后端转AI,最缺的不是Prompt,是能扛住面试追问的真实项目
后端转AI,关键不在Prompt,而在能扛追问的项目
最近不少后端开发者发现,哪怕应聘的是传统后端岗,面试官也会问:“你们系统有没有接入AI?”“RAG怎么做的?”“Agent架构了解吗?”
这说明行业正在变化:单纯会写CRUD接口已经不够了。但很多人误以为转型AI就是从头学Python、调模型、背Prompt。结果学了一堆零散技巧,简历上写“基于大模型开发智能问答系统”,一到面试就被问懵。

真正的问题不是不会AI,而是没有一段能经得起深挖的项目经历。
真实项目 vs 聊天Demo:差距在哪?
市面上大多数AI教程教的是“调通一个聊天界面”——前端发请求,后端调个API,模型返回答案,完事。这种Demo在面试中几乎毫无价值,因为:
- 没有业务实体
- 没有数据持久化
- 没有多轮状态管理
- 没有权限和租户隔离
- 没有失败处理和可观测性
而真实企业级AI应用,比如一个律所智能客服平台,要解决的是完整业务流:
客户咨询 → 法律问答 → 意向打标 → 跟进记录 → 后续转化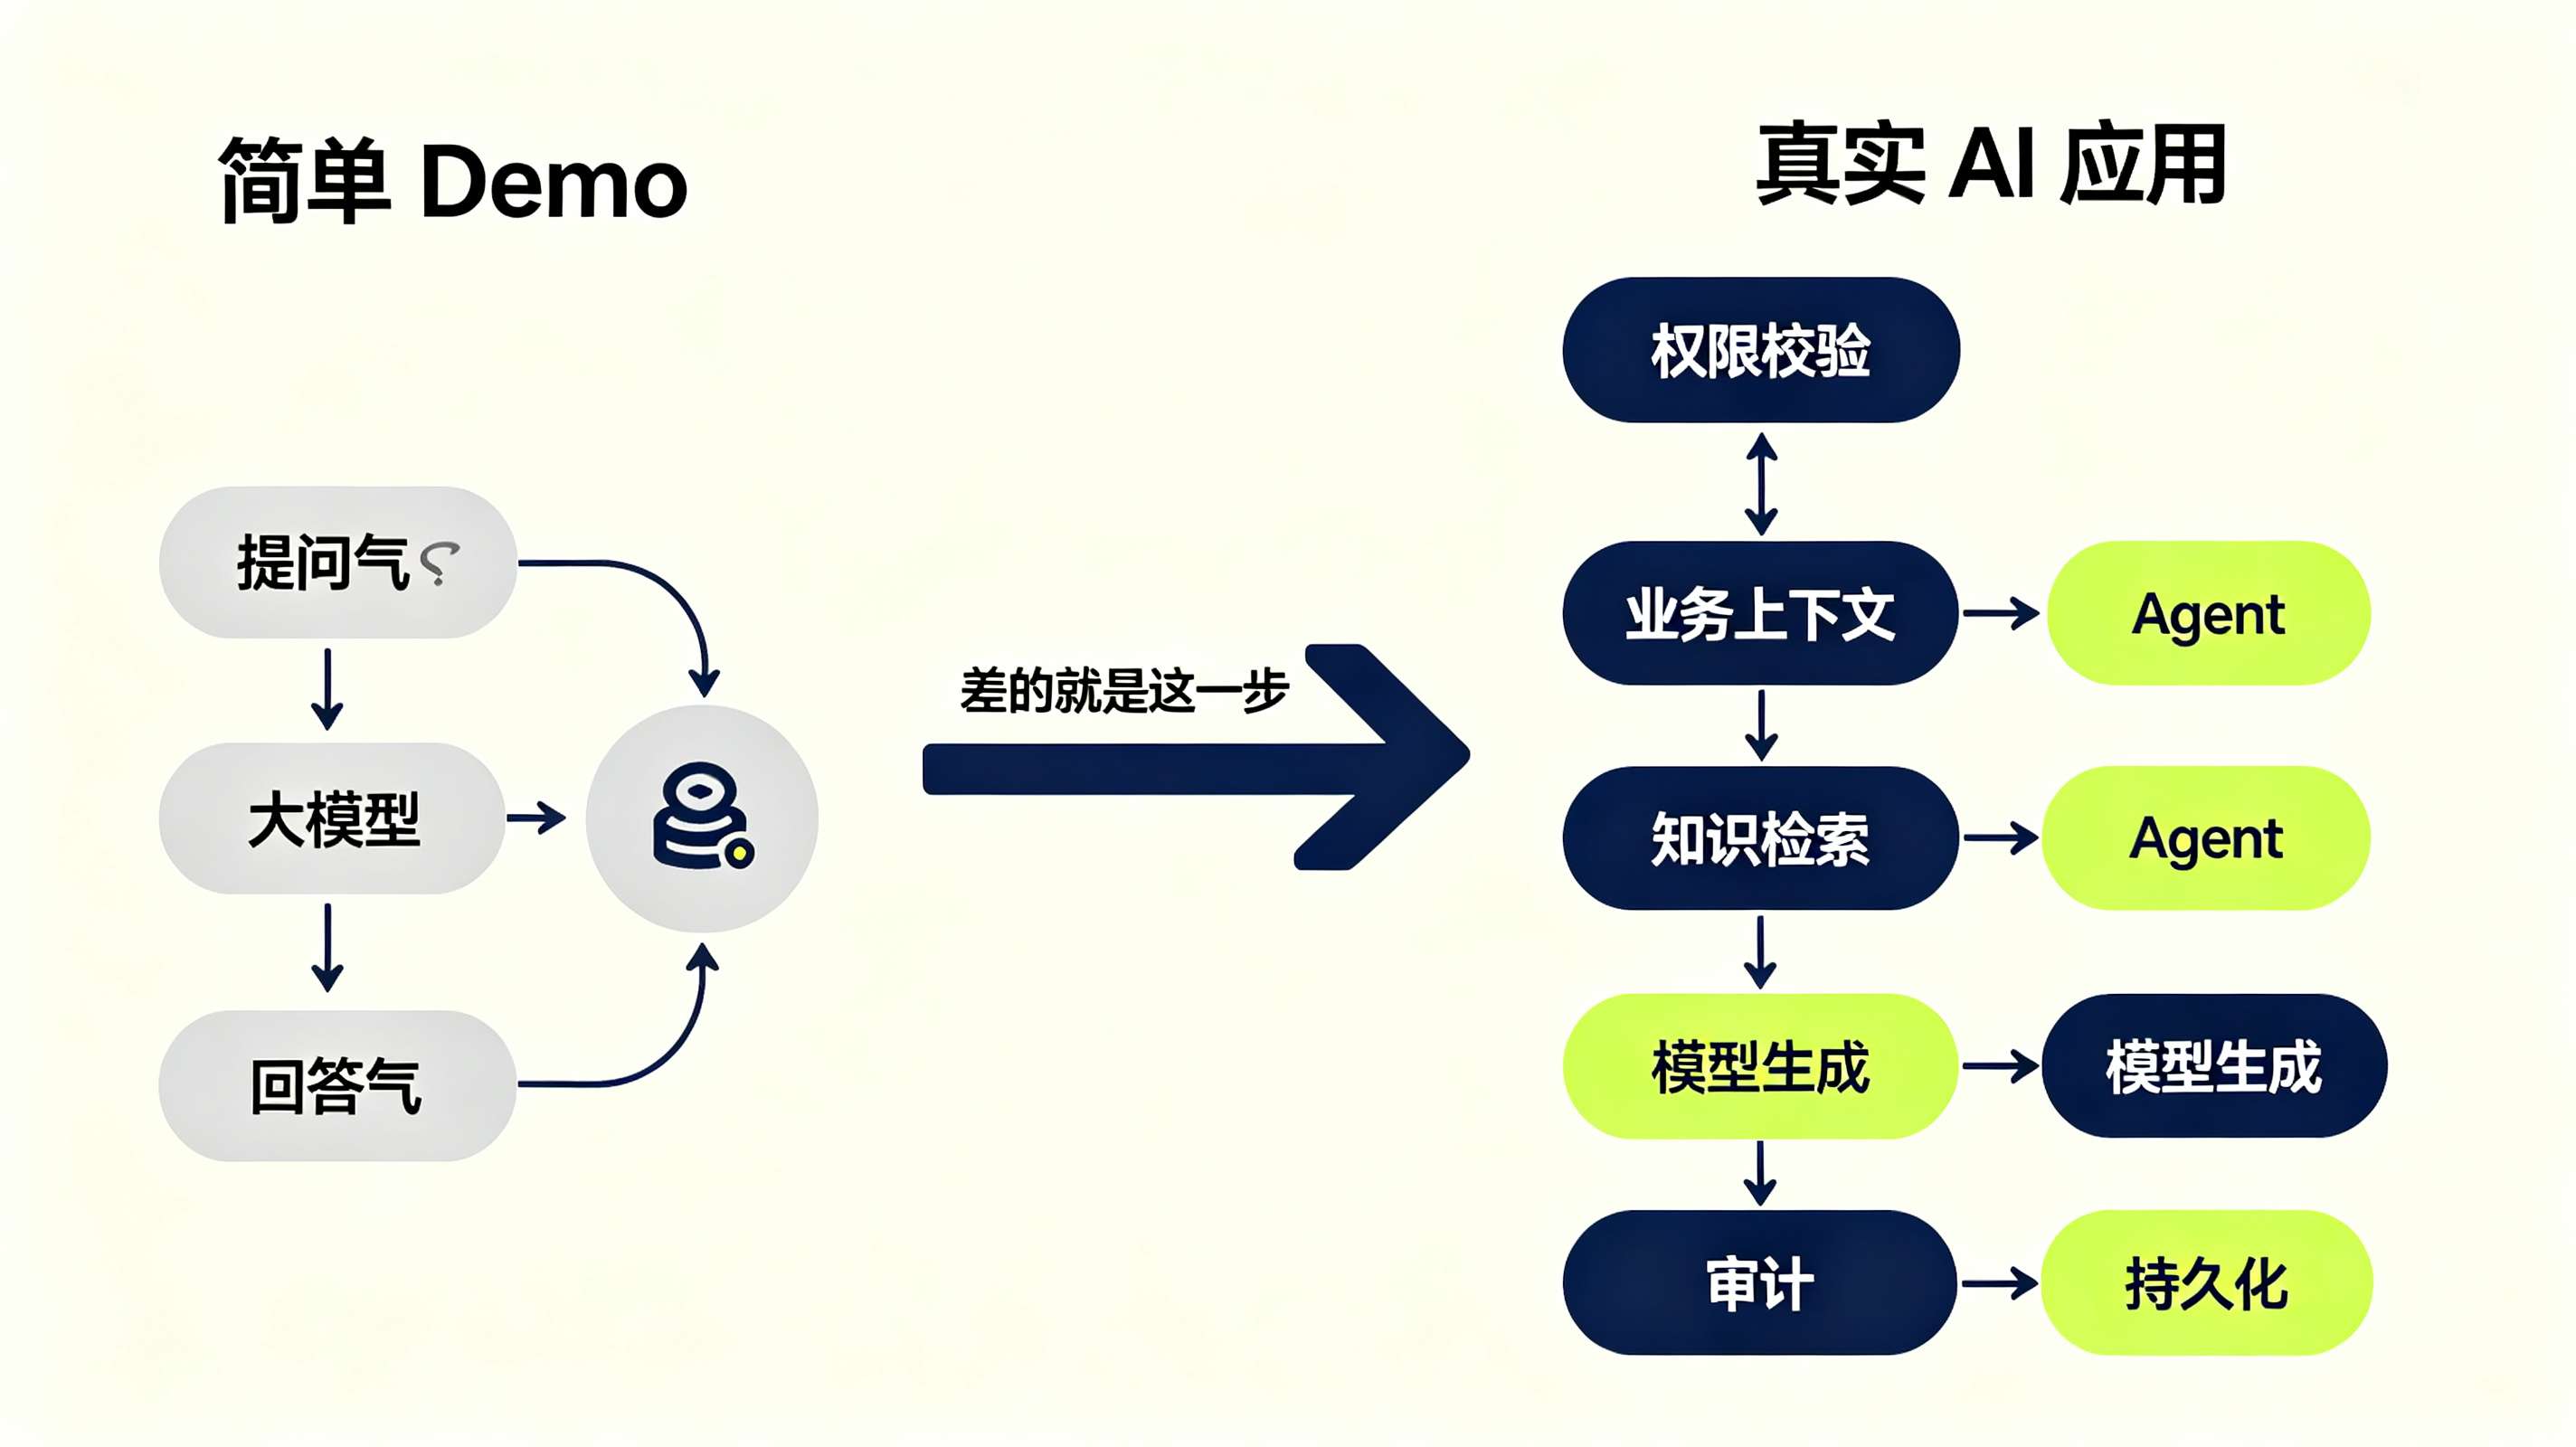
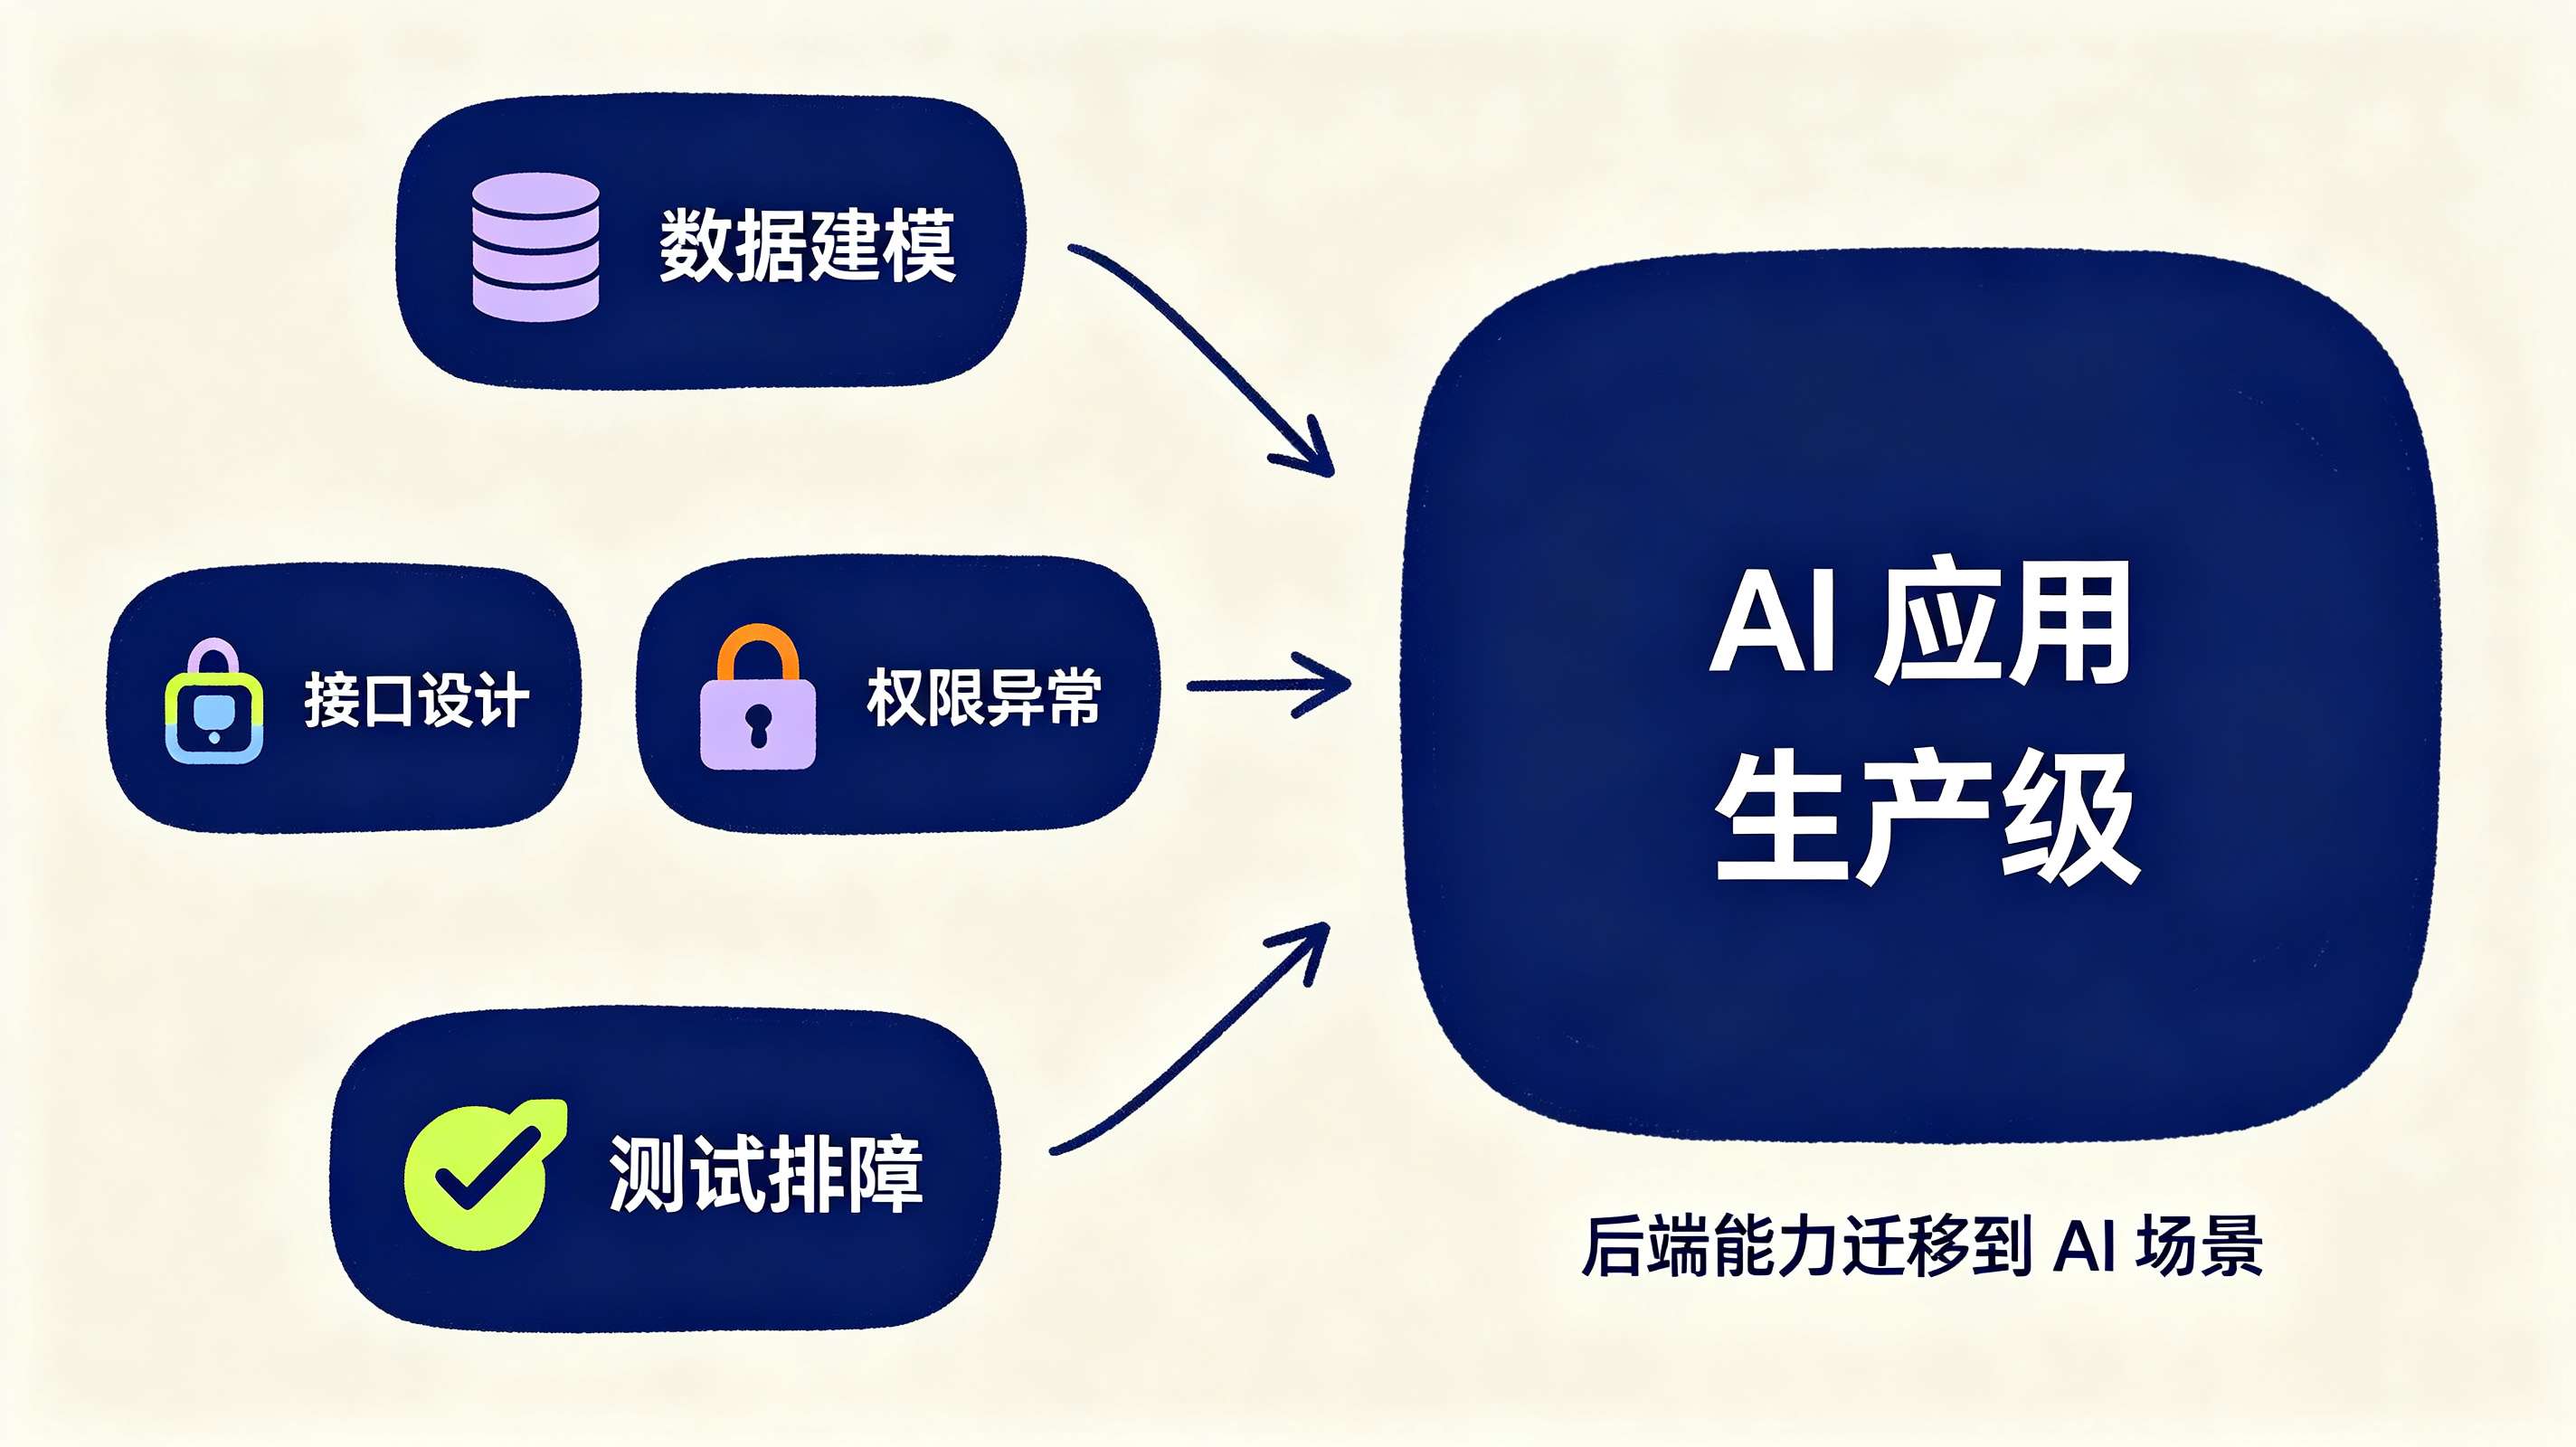
这个过程中,AI只是中间一环。前后都需要可靠的后端系统支撑:会话管理、数据存储、接口暴露、权限校验、错误回溯。
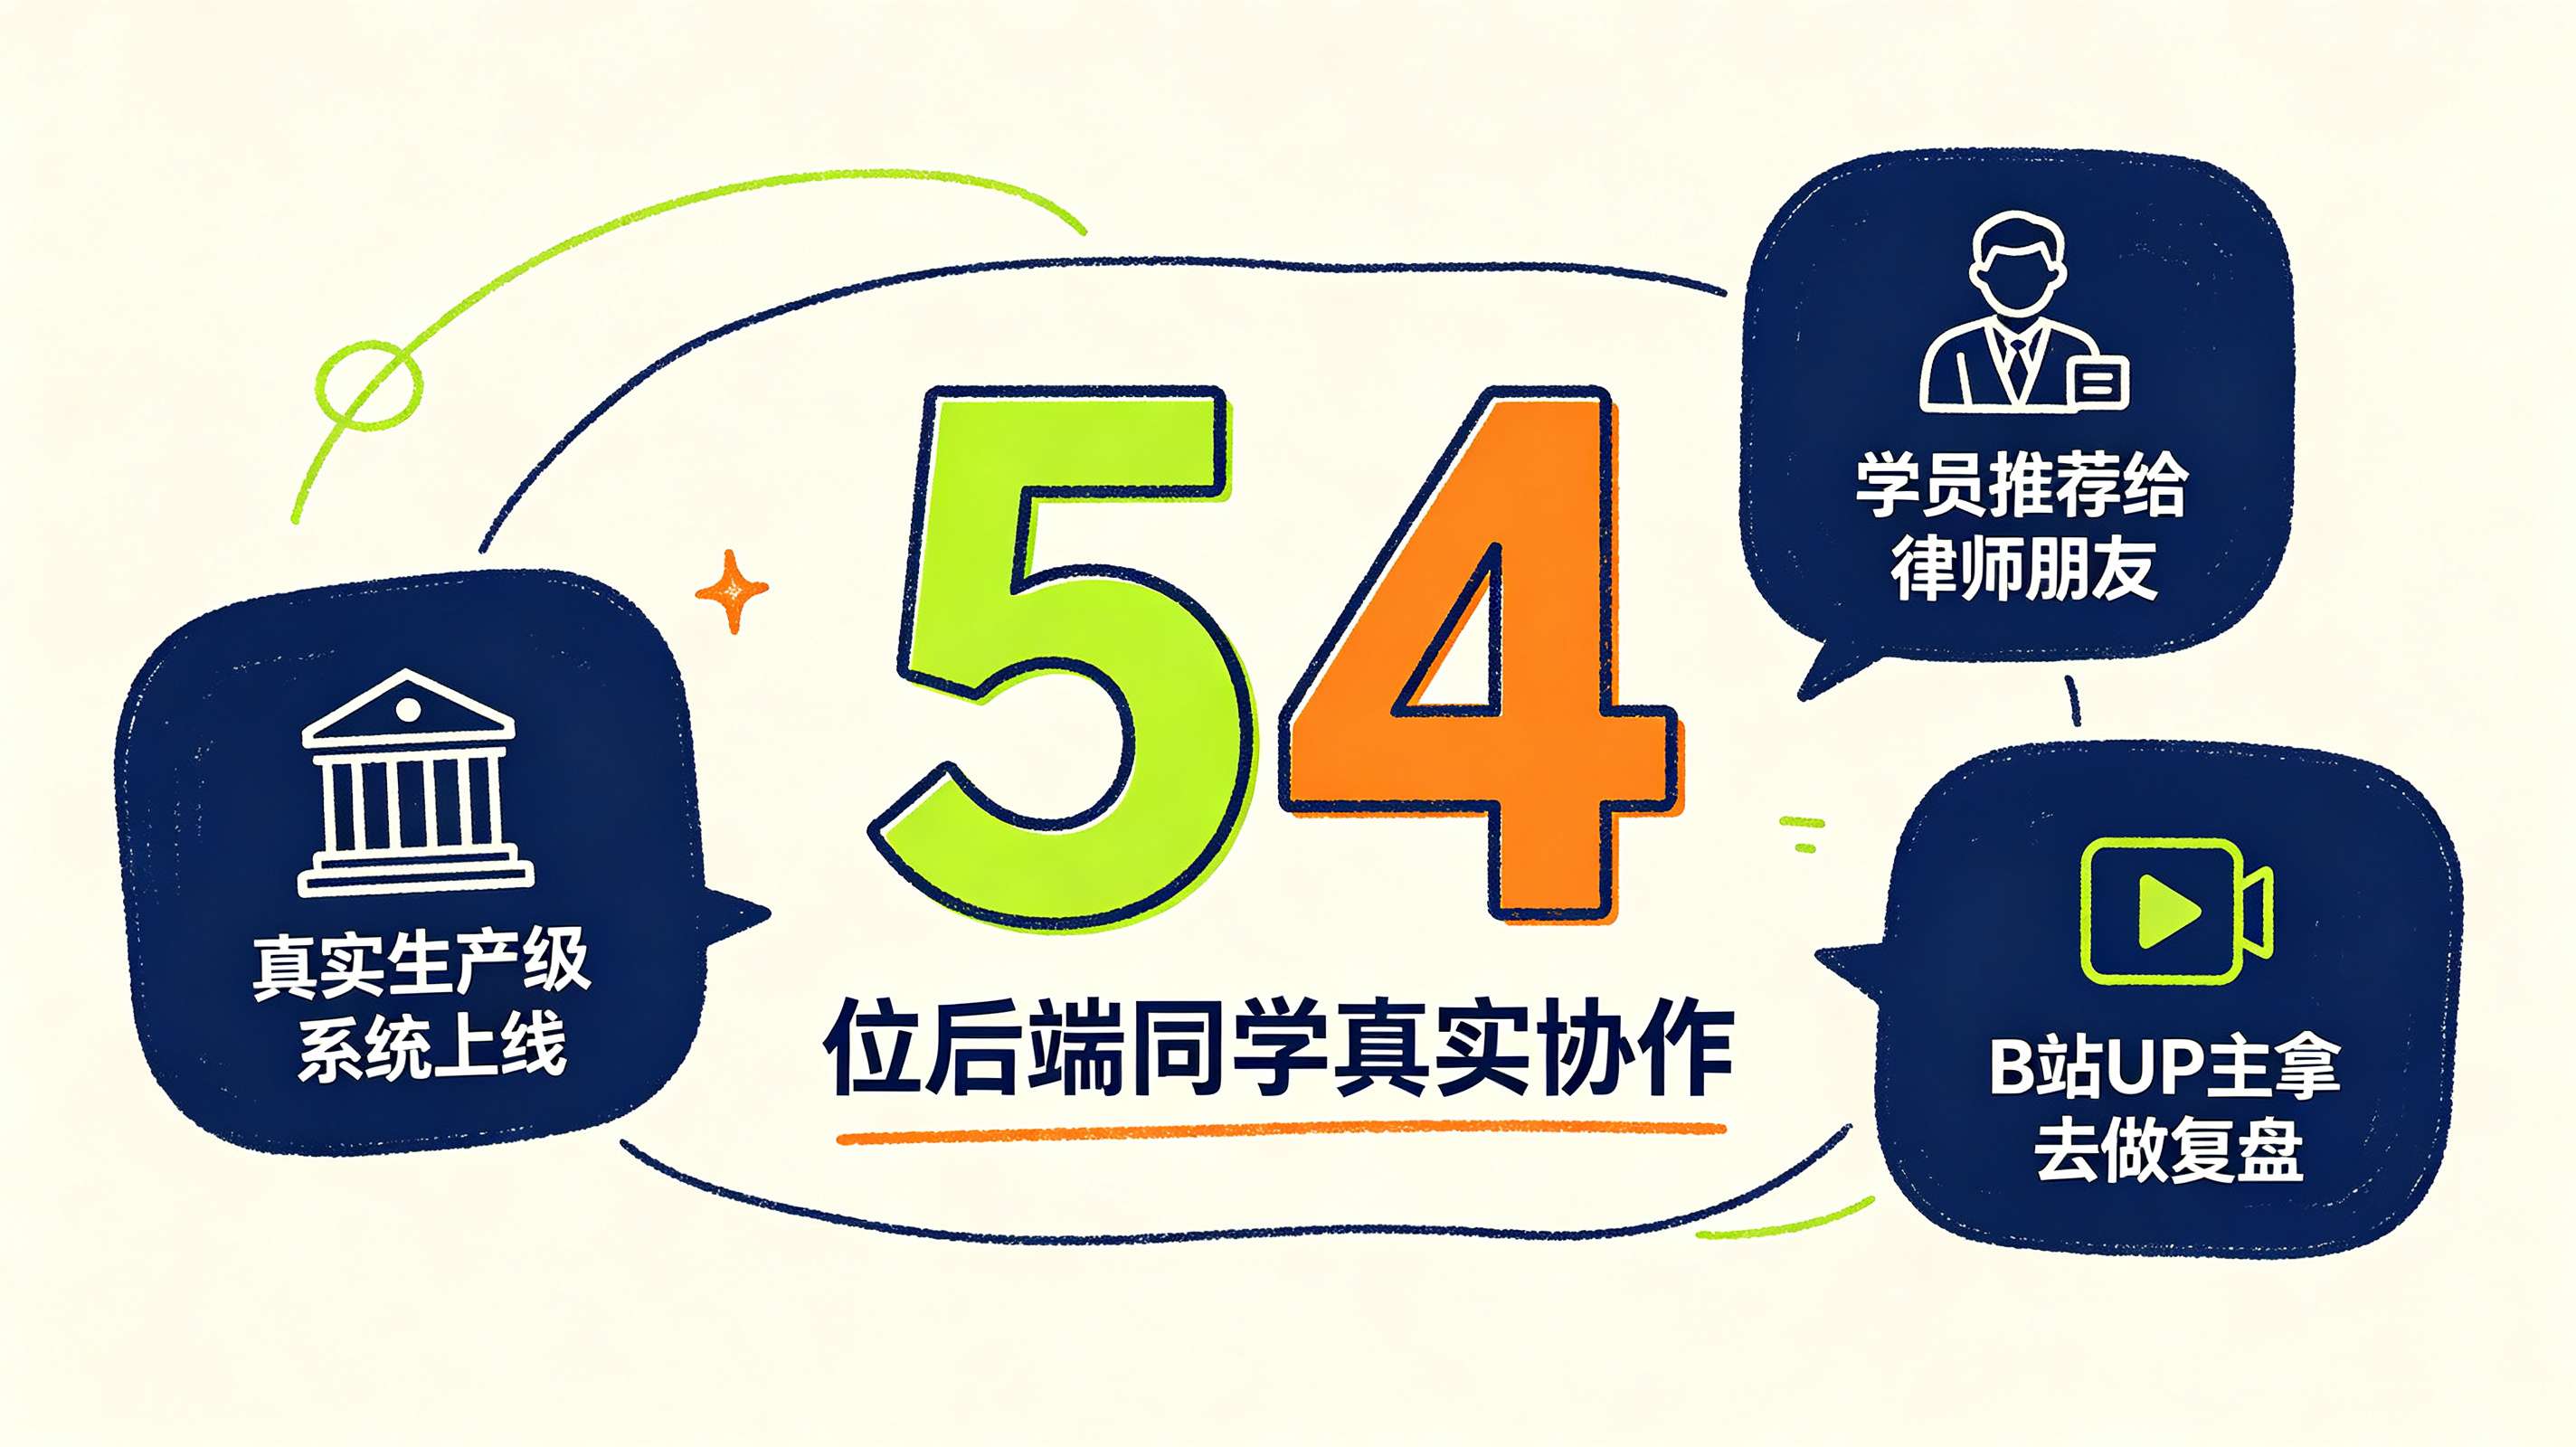
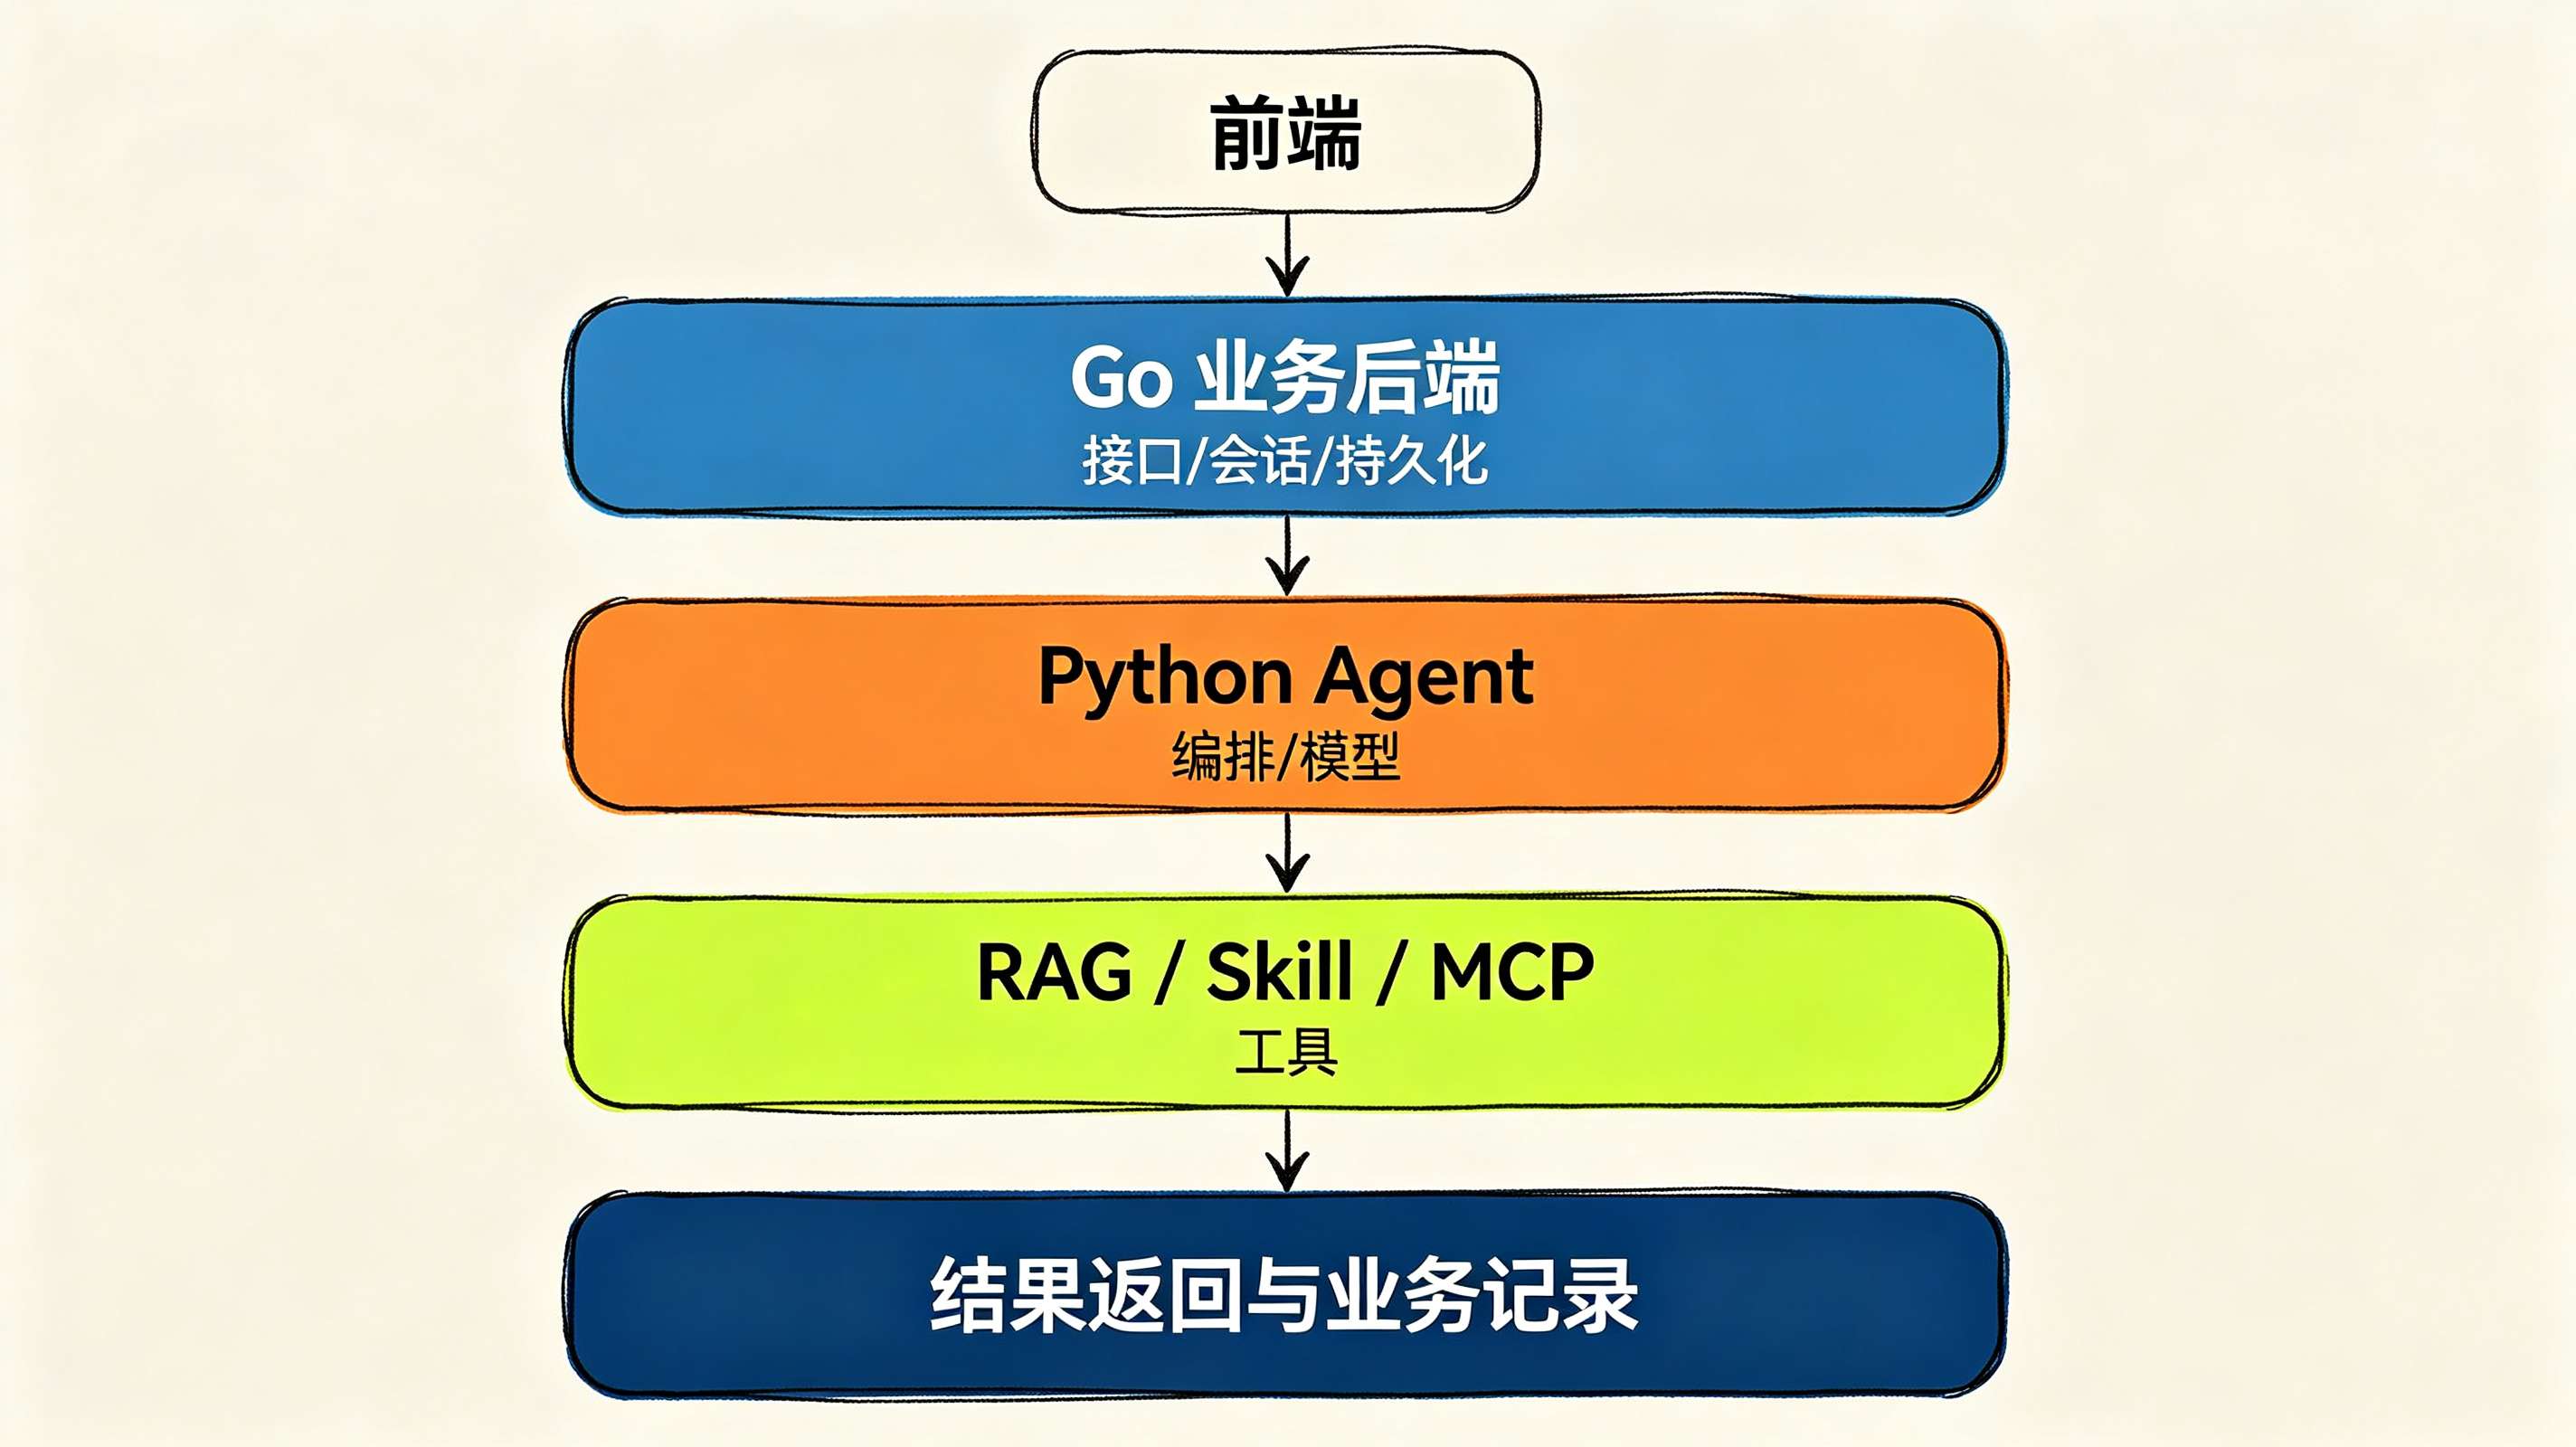
我们带54位后端同学一起做的 LexAgent 项目,正是这样一个生产级系统。它用 Go 处理业务逻辑和数据持久化,Python 负责 Agent 编排和模型调用,通过 MCP 协议实现跨语言工具调用。一次用户请求要经过多个模块协同,而不是单体Demo。
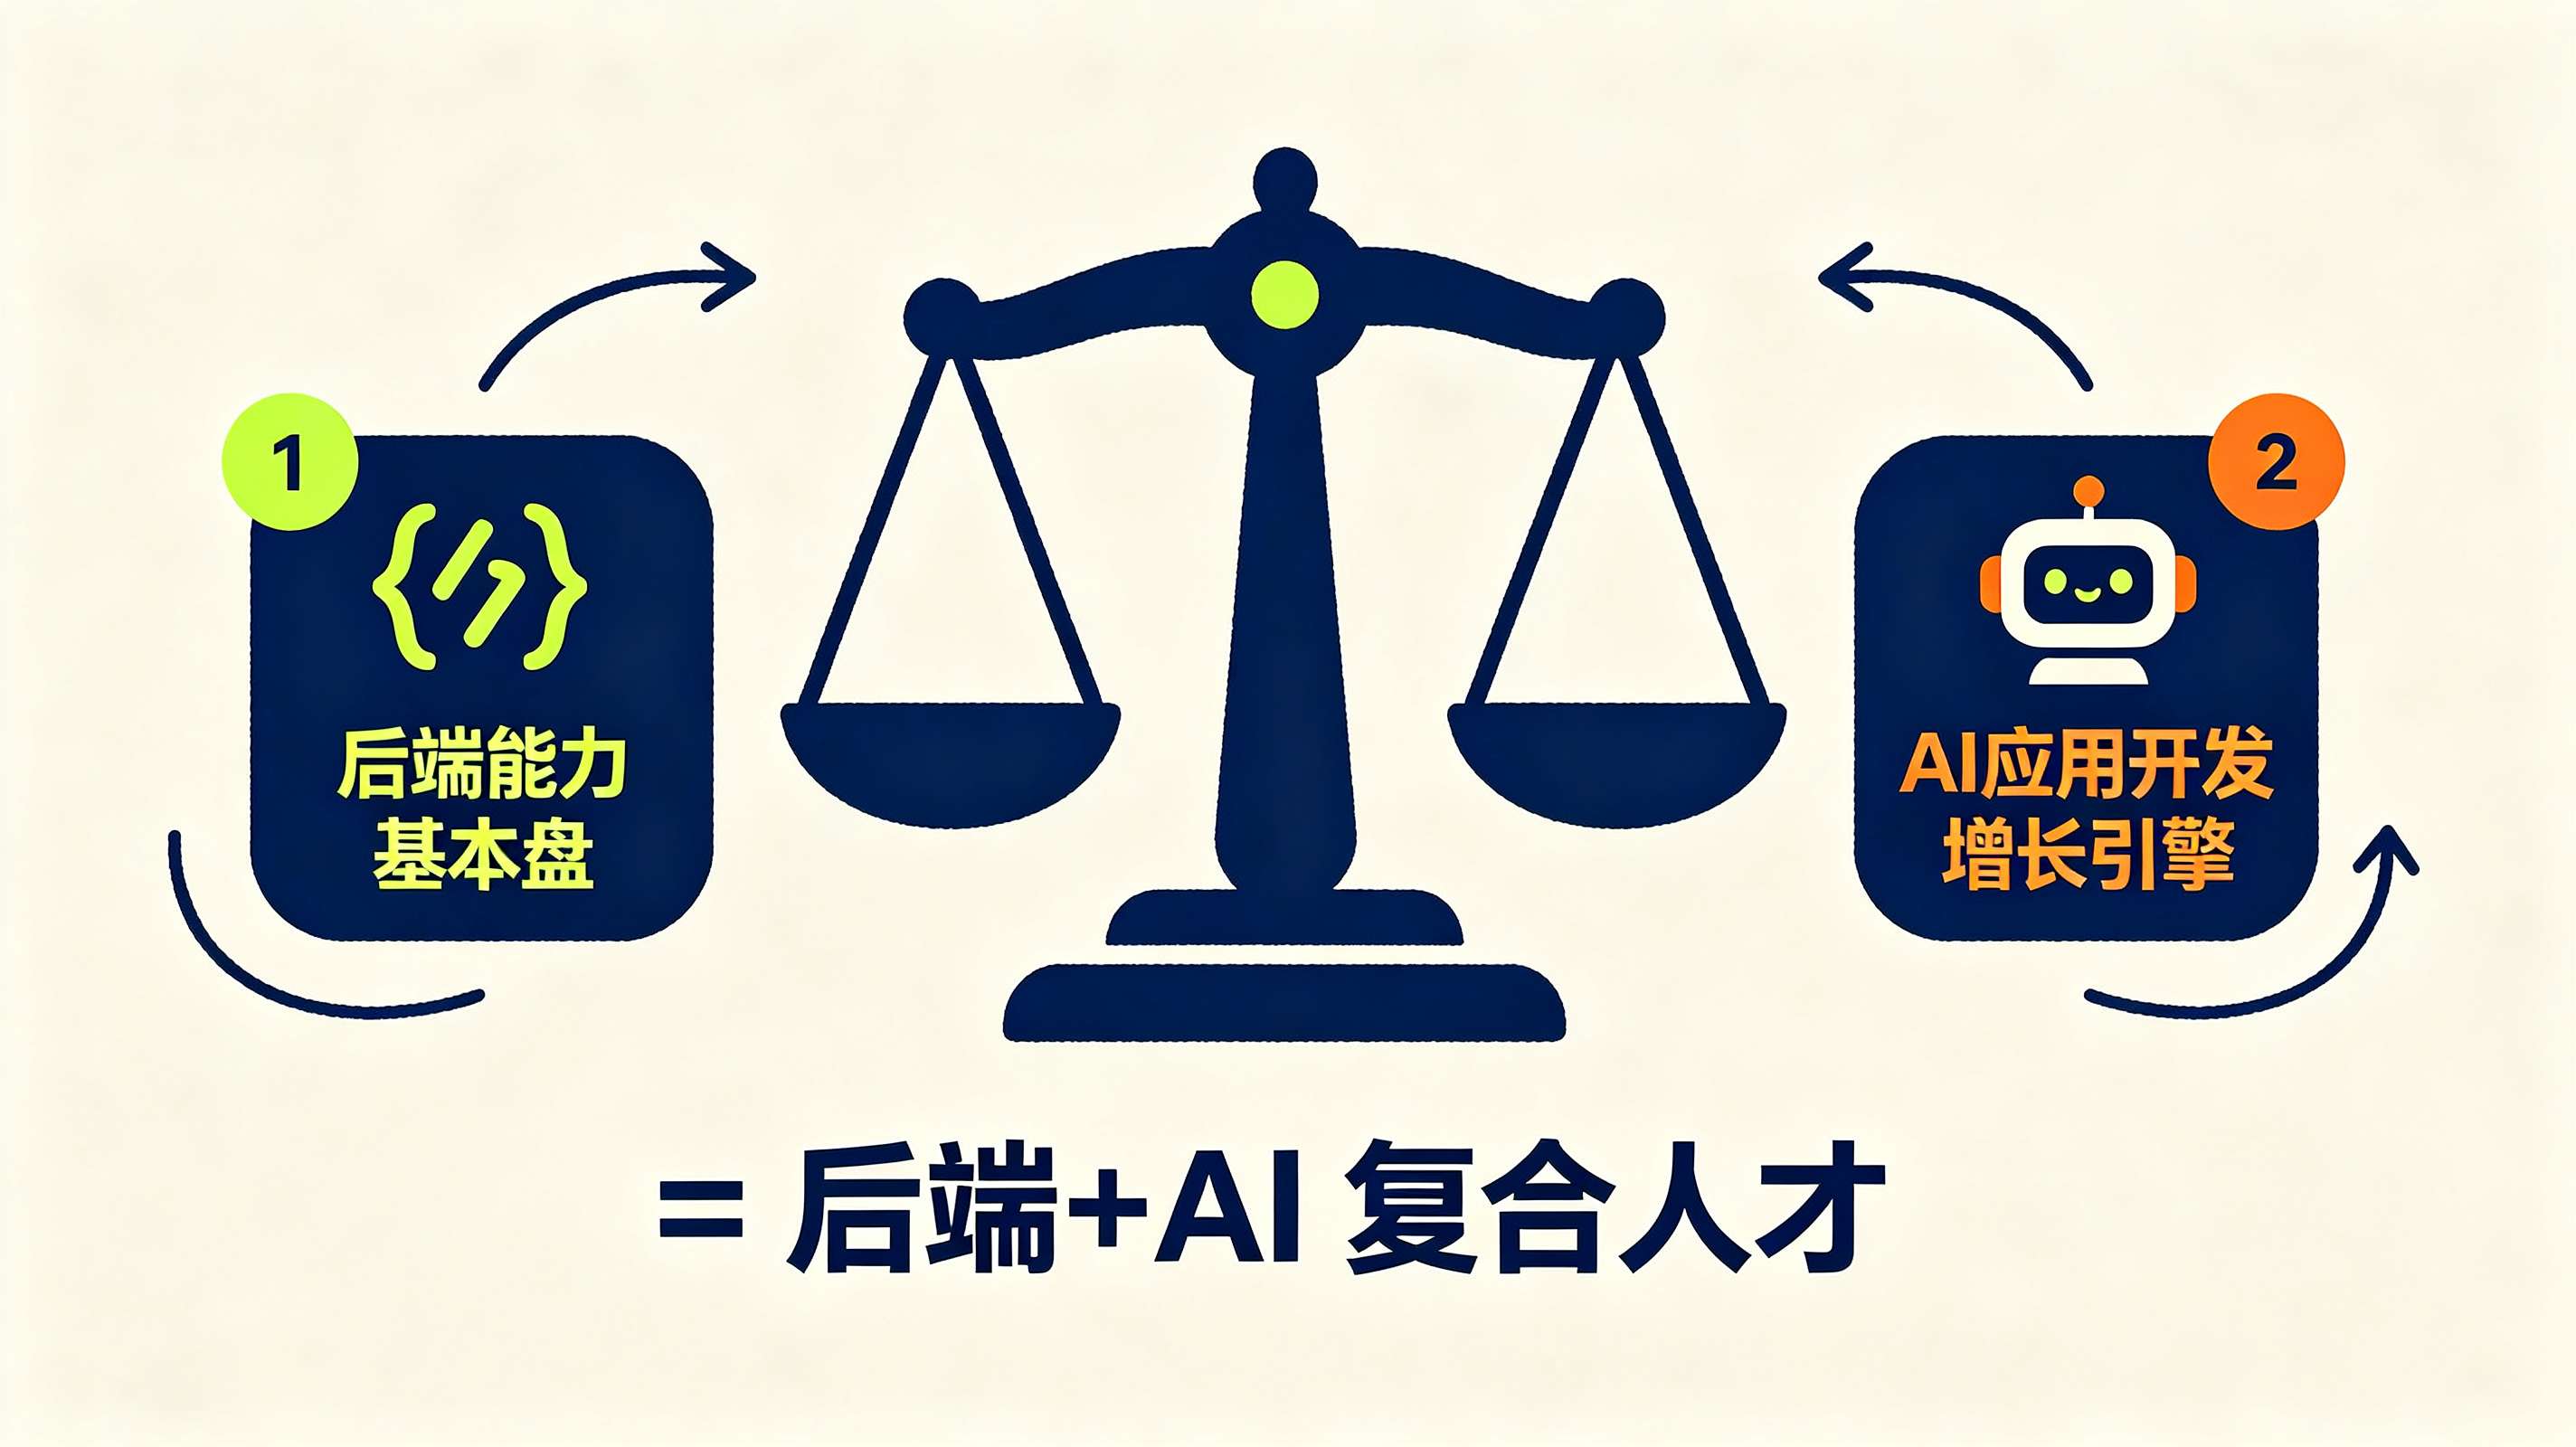
后端能力在AI项目里依然关键
有些后端担心:“我是不是得放弃Java/Go,从头学AI?”其实完全不必。
公司的存量系统不会因为AI出现就废弃。那些高并发、事务一致性、服务治理、日志追踪的能力,在AI项目里反而更需要——因为AI引入了更多不确定性。
举个例子:当Agent调用外部工具失败时,系统不能简单返回“服务异常”。它需要:
- 记录完整的请求上下文(Trace ID、Session ID)
- 保存失败原因和输入参数
- 触发降级策略或人工接管流程
- 避免重复请求导致数据污染
这些,不就是后端熟悉的熔断、幂等、审计日志、异常处理吗?AI只是让问题更复杂,但解法依然来自后端工程经验。
面试官会怎么追问?
如果你在简历写“做了个RAG问答系统”,面试官可能会连续问:
- 文档怎么切分的?为什么选这个chunk size?
- 检索效果怎么评估?用了哪些指标?
- 模型答错了怎么办?有没有纠错机制?
- 多轮对话的状态存在哪?Redis还是数据库?
- 用户权限怎么控制?不同律师能看到彼此的客户吗?
- Prompt改了之后,怎么验证没引入回归?
这些问题,光靠背八股文答不了。但如果你真的参与过一个有完整数据流的项目,就能说清楚:
“我在项目中负责Go后端的数据层,把Agent生成的意向判断和问答结果写入会话表和跟进记录。为了保证租户隔离,我们在Repository层加了tenant_id过滤;为了避免重复创建,对client_id + session_id做了唯一索引;还为命中、未命中、参数错误三种情况写了单元测试。”
这段话里每个点都能展开讲细节,自然能撑住20分钟追问。
后端同学在AI项目里具体做什么?
不是围观,也不是看录播。而是认领明确的工程任务。比如:
- 设计
consultation_session和follow_up_record数据库表 - 编写Go Repository,封装CRUD操作
- 开发HTTP接口,供前端查询客户历史咨询
- 处理Python Agent传来的JSON结构,做字段映射和校验
- 补充边界测试:数据不存在、参数非法、租户越权
- 参与联调,根据接口契约调整字段命名
这些工作看起来“不炫酷”,但它们构成了AI输出进入业务系统的关键桥梁。没有这一步,AI再聪明也落不到实处。
真实协作的四个阶段
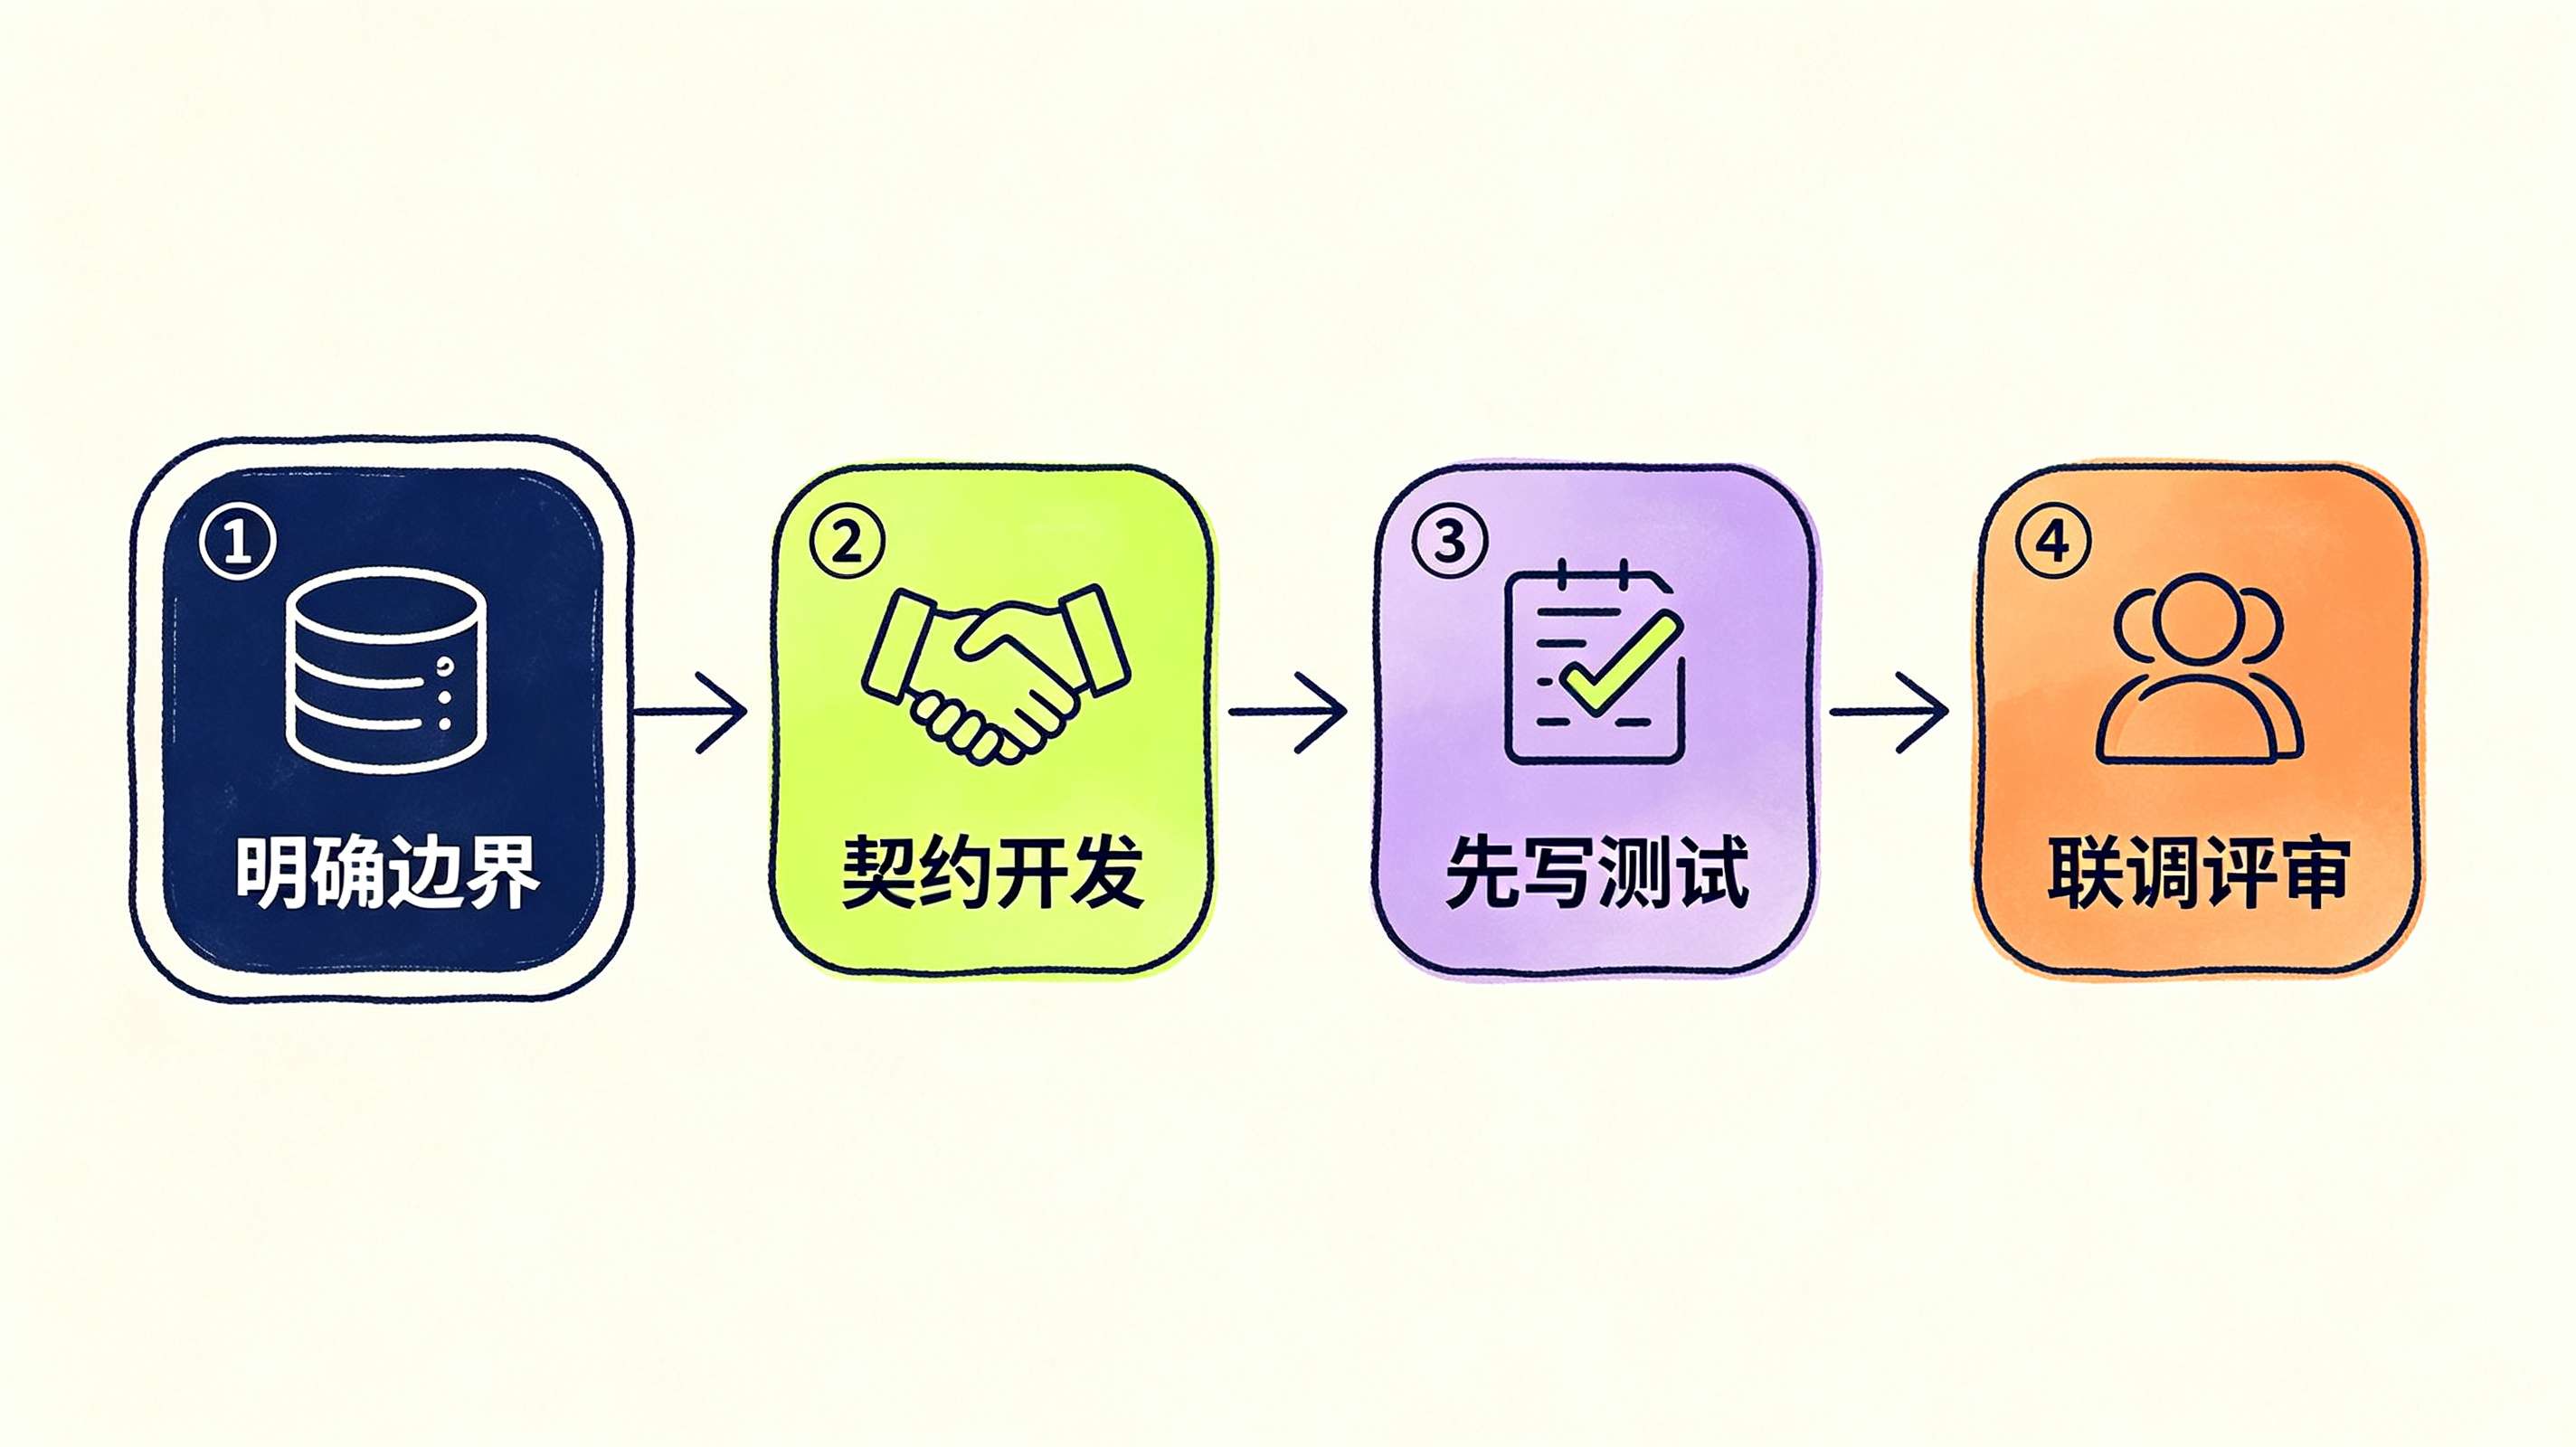
我们的项目强调契约先行、测试驱动、评审闭环:
- 明确边界:先约定Go和Python之间传递哪些字段,哪些必填,错误码怎么定义。避免两边各自建表、字段对不上。
- 按契约开发:接口文档先定稿,再并行开发。后端同学清楚自己只负责接收、存储、查询,不碰模型逻辑。
- 先写测试:不仅测正常路径,还要覆盖数据不存在、参数错误、租户越权、下游失败等场景。
- 参与评审:提交代码时说明改了什么、怎么测的、依赖谁。如果被指出问题,要理解为什么这个设计不合理,而不是被动改代码。
经过这个过程,你获得的不是“参与过AI项目”的标签,而是一段自己亲手做过、改过、解释得清的工程经历。
如何讲好这段项目经历?
面试时别只说“我做了律所AI平台的后端”。要聚焦具体任务和挑战:
“我负责把Agent生成的法律问答结果和客户意向标签持久化到数据库,并提供查询接口。难点在于:第一,Python返回的结构经常变动,我们通过中间DTO做适配;第二,要防止同一个咨询被多次记录,所以加了幂等键;第三,不同律所的数据必须隔离,我们在所有查询里自动注入tenant_id。我还为Repository写了三类测试用例,覆盖了正常、空结果和非法参数场景。”
这段描述里藏着多个可追问点:DTO怎么设计?幂等键用什么字段组合?tenant_id怎么自动注入?测试怎么组织?但因为你真做过,所以不怕问。
后端转AI,不是从零开始
你不需要先成为AI专家才敢碰项目。你已有的能力——服务设计、数据建模、异常处理、多人协作——在AI时代依然值钱,甚至更值钱。
真正要补的是:
- 如何把模型接入业务流
- 如何设计RAG检索链路
- 如何让Agent安全调用工具
- 如何评测和观测AI输出
- 如何把整个过程讲成连贯的项目故事
而这些,只有在真实项目里才能练出来。不是靠收藏几十个Prompt教程,而是靠动手写代码、联调、改bug、过评审。
LexAgent项目就是这样一个入口:它有真实业务场景(律所咨询)、完整技术栈(Go+Python+RAG+MCP)、明确分工(后端专注数据和接口),让你在不丢掉后端优势的前提下,逐步叠加AI能力。
你不必一开始掌握全部。可以从自己熟悉的Repository、API、测试开始,慢慢理解AI模块如何与之交互。重要的是,留下可追溯、可解释、可验证的个人贡献。
这才是后端转AI最该走的路。