中国团队发布 RSI 五级框架:拆解「人类造的最后一个 AI」路线图
RSI 不再是哲学猜想,而是一张可分级的工程路线图
最近,一篇来自中国研究团队的报告在海外 AI 圈引发热议。标题直指一个老问题:「人类造的最后一个 AI」还有多远?但这次,答案不再是模糊的预言,而是一套从 L1 到 L5 的递归式自我改进(Recursive Self-Improvement, RSI)框架。
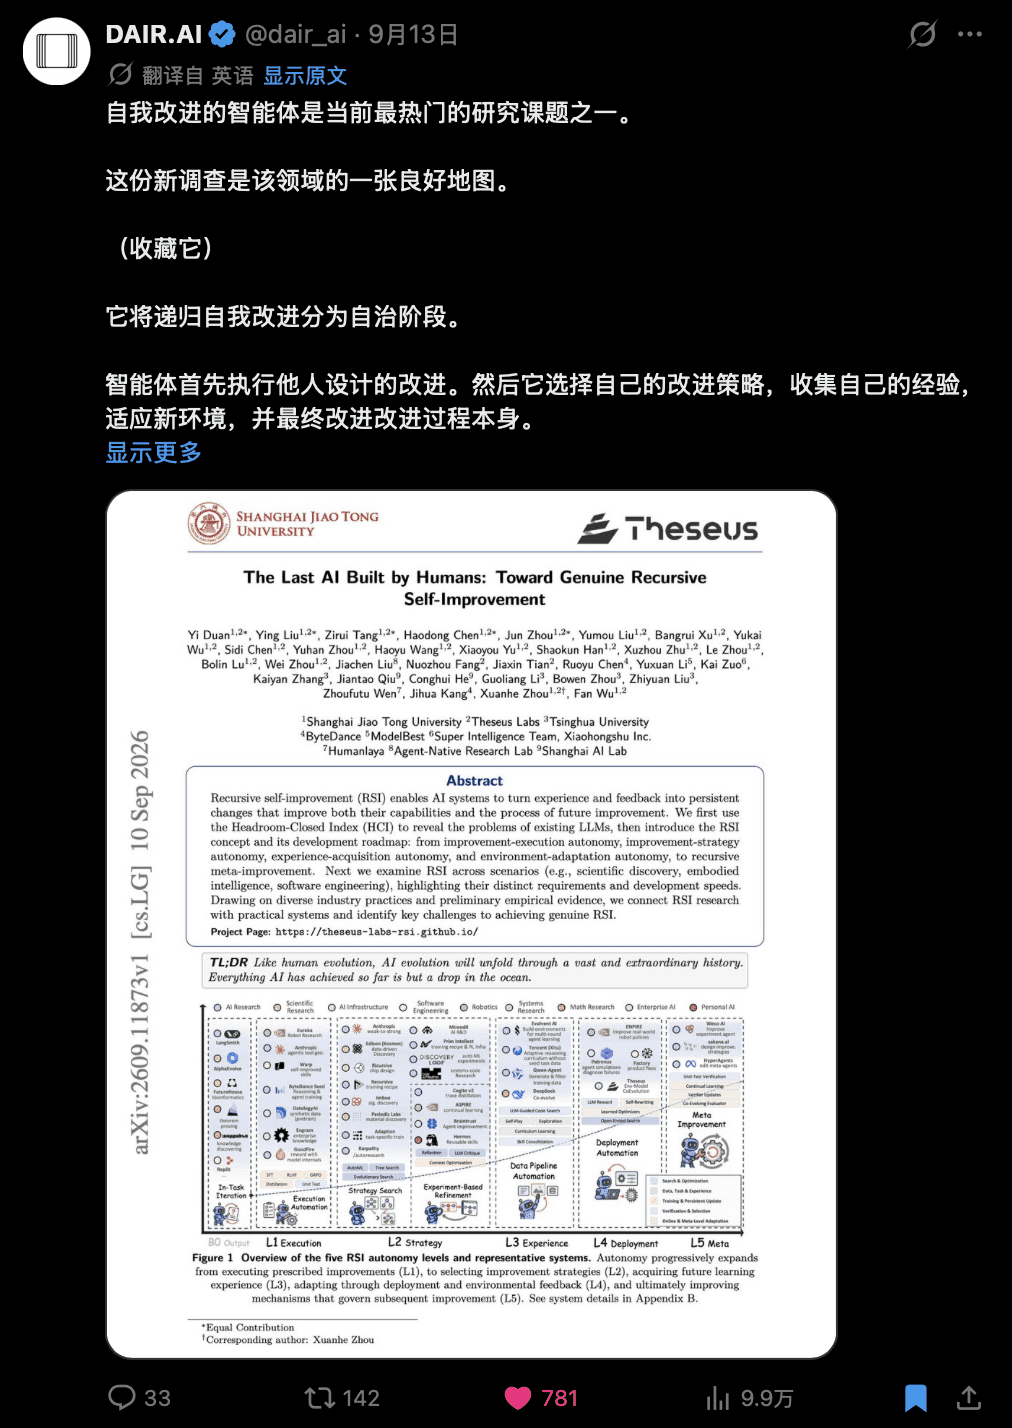
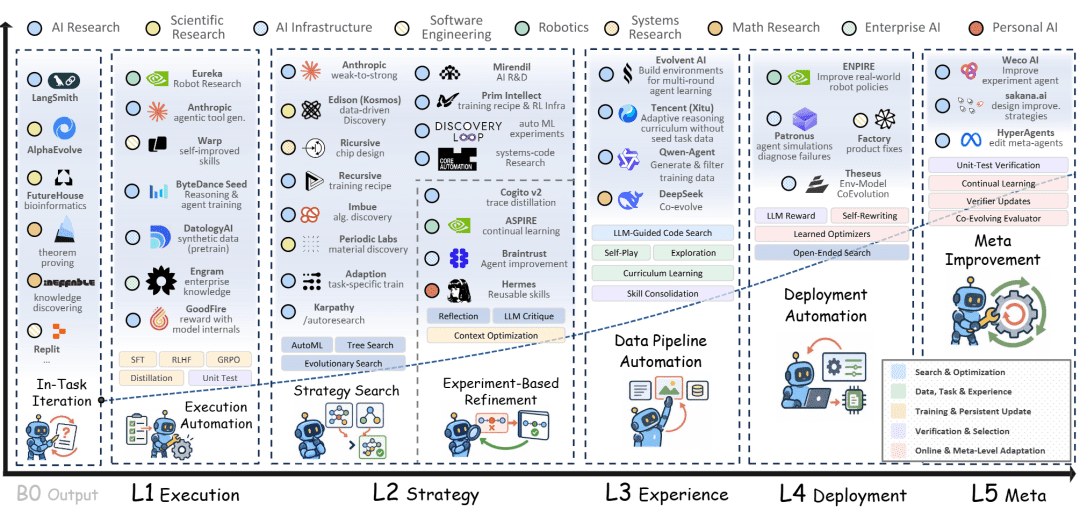
这份由 Theseus Labs 牵头、联合清华大学、字节跳动、面壁智能、小红书超级智能团队等多家机构发布的报告《The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement》,没有堆砌宏大叙事,而是扎进 OpenAI、Anthropic、Google DeepMind、Meta、腾讯混元、字节 Seed 等 72 家团队的公开材料里,一条条比对、一家家拆解,最终提炼出可度量、可工程化的路径。
报告的核心观点很直接:RSI 的关键不在于模型能不能在某个任务上刷高分,而在于它能否在有限资源下,让每一次改进都成为下一次更高效改进的基础。
用 HCI 量出 AI 的「能力余量」
要讨论 RSI 的潜力,先得知道模型现在到底缺什么。Theseus Labs 提出了一个新指标:能力余量闭合指数(Headroom-Closed Index, HCI)。
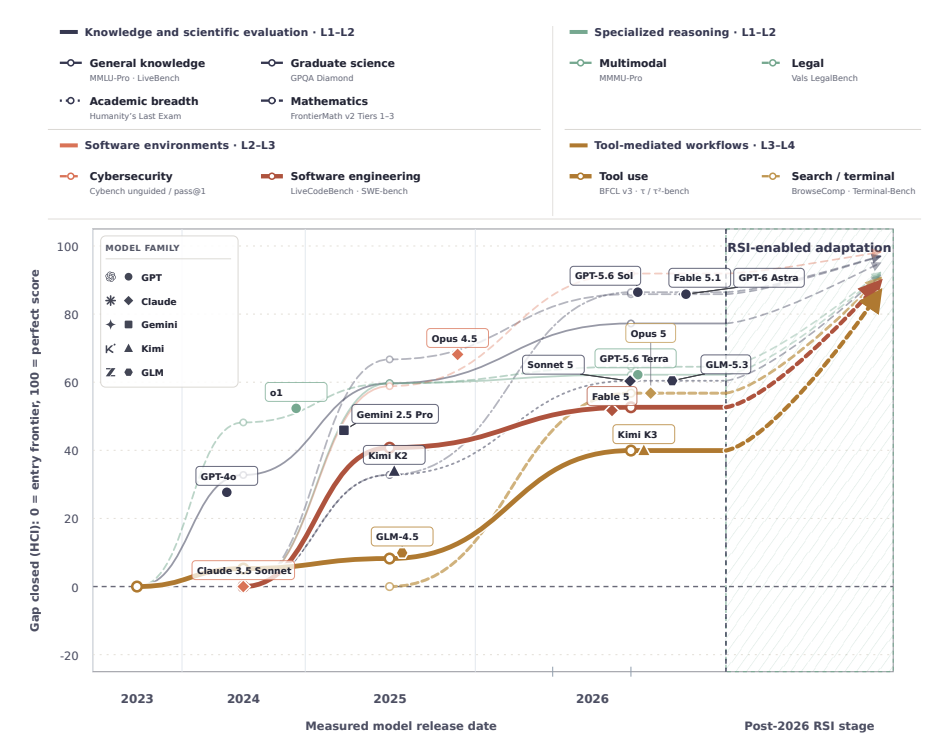
HCI 的计算逻辑很简单:以某项评测首次纳入数据集那一年模型得分的第 90 百分位为基准(比如 60 分),满分设为 100 分,那么当前得分 80 分对应的 HCI 就是 50——意味着原有提升空间已被填补一半。
他们汇总了 2023 至 2026 年间 10 大能力领域的 393 组观测数据,结果呈现出强烈反差:
- 前沿数学 HCI 达 86.4
- 研究生级科学为 85.8
- 广博知识 77.2
但另一边:
- 法律推理仅 64.5
- 多模态推理 62.2
- 前沿学术广度 60.4
更值得注意的是交互类任务:软件工程 HCI 仅为 52.6,搜索与终端 Agent 为 56.8,而工具调用 Agent 更是低至 39.9。相比之下,网络安全 Agent 已达 91.9。
这说明,模型在标准化、边界清晰的测试中已接近天花板,但在需要长程交互、状态维护和真实环境反馈的任务中,才刚刚起步。而这些恰恰是 RSI 最能发挥杠杆作用的领域。

五级自主权:从执行到递归继承
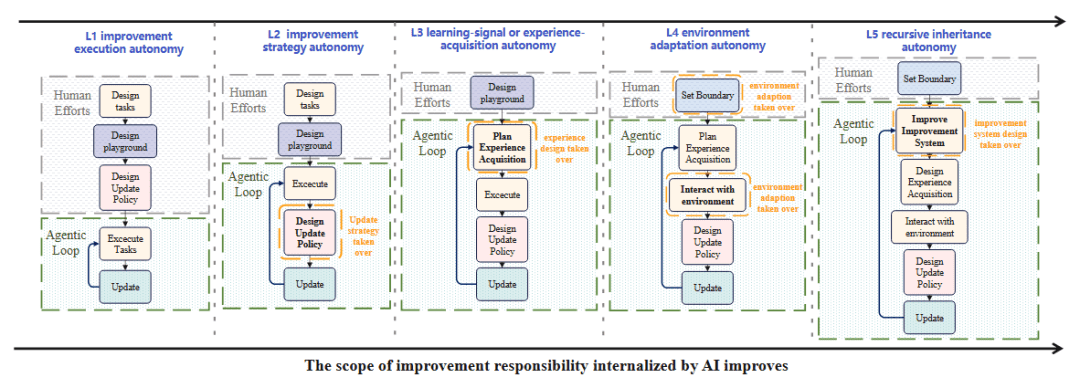
基于 HCI 揭示的能力缺口,Theseus Labs 提出了 RSI 五级框架,按 AI 在「改进循环」中承担的责任划分:
- L1 执行自主:人类设计任务、环境和更新策略;智能体只负责执行和更新。
- L2 策略自主:人类设计任务和环境;智能体自己设计更新策略并持久化。
- L3 经验获取自主:人类只设计环境;智能体自主规划经验获取、执行、设计策略并更新。
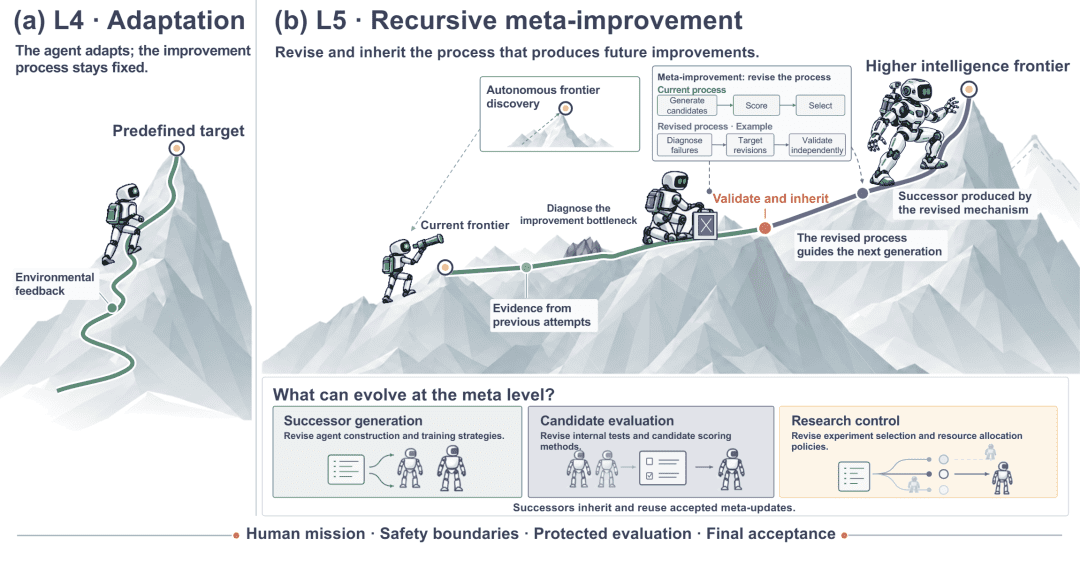
- L4 环境适应自主:人类设定边界;智能体与环境交互,将失败转化为更新信号。
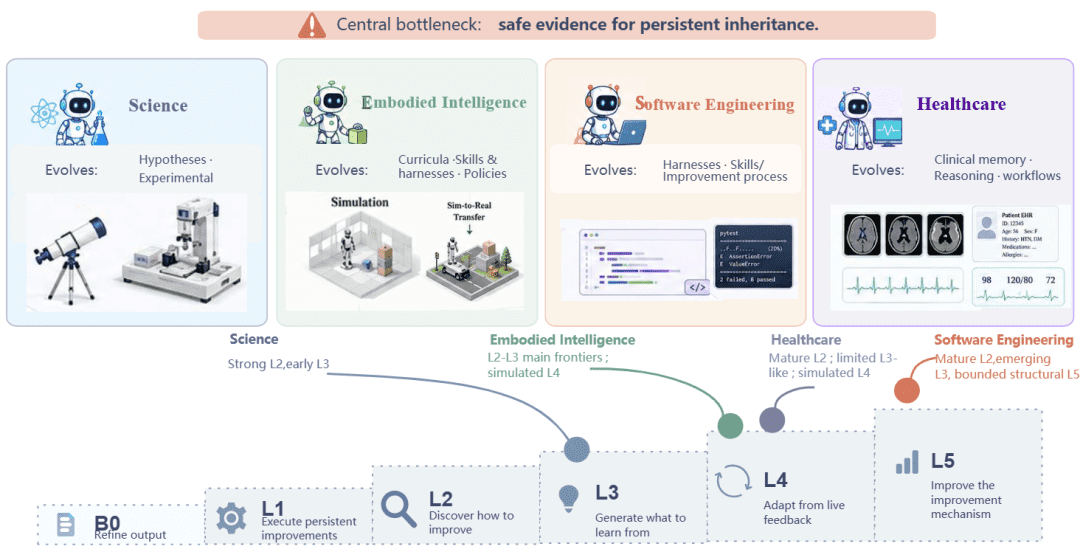
- L5 递归继承自主:人类仅设定边界;智能体不仅能改进自身能力,还能改进「改进系统」本身,并将有效方法传给下一代。
目前,主流大厂集中在 L1–L2。例如 OpenAI Symphony 和 Anthropic Agent Skills 主要优化任务衔接与技能复用;GPT-Red 的自博弈、Claude 的工具优化则开始将策略改进自动化。
向 L3 迈进的代表是腾讯 R-Zero,它能自主出题并求解,减少对人工准备学习任务的依赖。L4 的探索包括 Factory Signals 和 OpenAI 的自改进税务智能体,它们试图缩短「发现问题—修复—验证」的闭环。
至于 L5,Meta HyperAgents、Sakana Darwin Gödel Machine 等尚属候选,Anthropic 的《When AI Builds Itself》更多是愿景。关键问题在于:改进机制本身是否能在同等预算和独立评估下产生更强后代?
RSI 的真正红利在「干活」最弱的环节
报告指出一个反直觉的事实:模型当前最不擅长的领域,恰恰是 RSI 能带来最大增量的地方。
Theseus Labs 给出了一个示意性公式:R = 100 - 0.22 × (100 - 2026 年 HCI)。假设 RSI 能以当前效率(系数 0.22)填补能力缺口,那么:
- 软件工程可从 52.6 跃升至 89.6
- 工具 Agent 从 39.9 拉高到 86.8
- 搜索与终端从 56.8 提升至 90.5
为什么?因为「干活」需要长程交互、反复试错、回归测试——这正是 RSI 在积累经验、验证更新上的强项。简单测评只能锻炼 L1–L2 能力,而只有真实工作流才能暴露 L3–L4 所需的验证、记忆与适应能力。
因此,务实的切入点不是追求通用智能,而是聚焦部署薄弱环节:让 Agent 在软件工程、工具调用等场景中反复生成经验、做回归测试、沉淀有效策略。
工业界已有初步信号
报告梳理了多个团队的实践案例,证明 RSI 正从理论走向落地:
- Humanlaya:经过四轮反馈驱动更新,关键缺陷率从 9.0% 降至 3.7%,平均人工处理时间从 48 分钟降至 27 分钟。
- 面壁智能(ModelBest):Agent 自主完成工程设计、实现和优化,ForgeStencil 实现 1.15–1.9× 加速。
- 腾讯混元:将代码、日志和评估反馈沉淀为经验,驱动下一轮实验;nanochat 验证 BPB 从 0.9109 降至 0.9015。
- 小红书生成式推荐:利用推荐后的真实反馈校正用户记忆,并将高价值难例转为后训练样本;Feed 精排分 score_mean@16 从 2.211 提升至 2.366(+7.0%)。
这些数字背后是共同逻辑:形成「经验沉淀—模型迭代—效果验证」的闭环。不同领域的进展速度也取决于三个因素:反馈成本、可验证性、部署约束。软件工程因反馈快、验证易,走在最前;科学发现、医疗、具身智能则因验证难或风险高,进展较慢。
L5 的四大拷问:不止于一次成功
报告强调,真正的递归改进不能只看单次性能提升,还需回答四个问题:
- 可衡量:改进是否真实?能否在独立评估下复现?
- 可保持:改进能否持久保留,而不退化?
- 可迁移:改进能否跨任务、跨领域复用?
- 可回滚:改进失效时,能否安全撤回?
这四问决定了 RSI 是「一次性刷榜」还是可持续的进化能力。目前多数系统尚未通过全部检验,尤其是「改进机制本身的改进」仍缺乏充分验证。
Theseus Labs 的解法:从环境重构开始
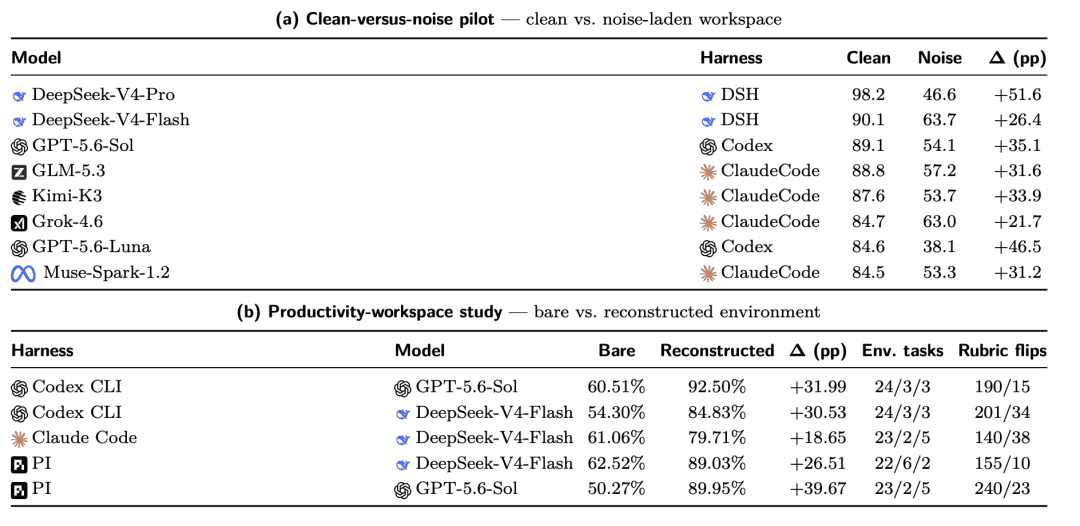
作为报告发布方,Theseus Labs 也给出了自己的实践路径。他们先在 30 个工作区任务、1,280 项评分细则上对比干净环境与噪声环境,发现八组模型与工具框架的通过率相差 21.7–51.6 个百分点。
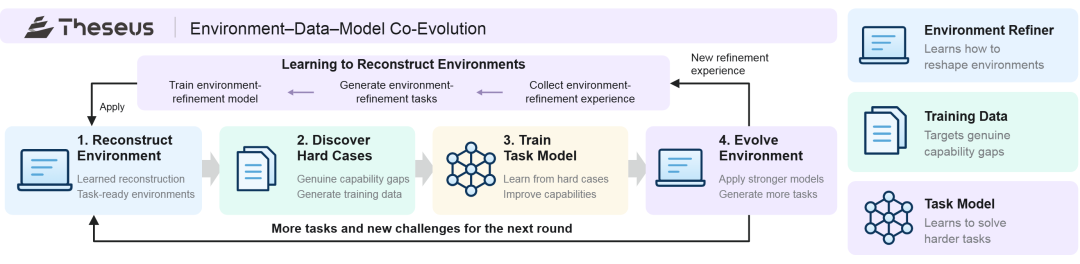
接着,他们将 RSI 路径拆为四步:
- 学习如何重构环境
- 借助新环境发现真实能力缺口,生成训练数据
- 再训练任务模型
- 用更强模型推动下一轮环境迭代
在 30 个生产力任务、547 项评分细则上,五组最新基模和 harness 配置均取得性能跃迁。
报告标题中的「Last AI Built by Humans」并非指某个瞬间诞生的超级智能,而是一粒学会自己添柴、自己校准、自己记住来路的火种。人类一生都在把「经历」变成「成长」,AI 的自进化或许也是如此——每一次被验证的改进,都是下一轮探索的起点。
让智能增长形成杠杆,让有限资源撬动持续跃迁。这既是目标,也是脚踏实地的工程挑战。