Claude Code 推出 Mods 插件机制,有人已在里面玩起俄罗斯方块
有人在 Claude Code 里玩起了俄罗斯方块
这事听起来有点魔幻:不是另开一个游戏窗口,而是直接在 Anthropic 的 AI 编程工具 Claude Code 的界面里,跑起了完整的俄罗斯方块。
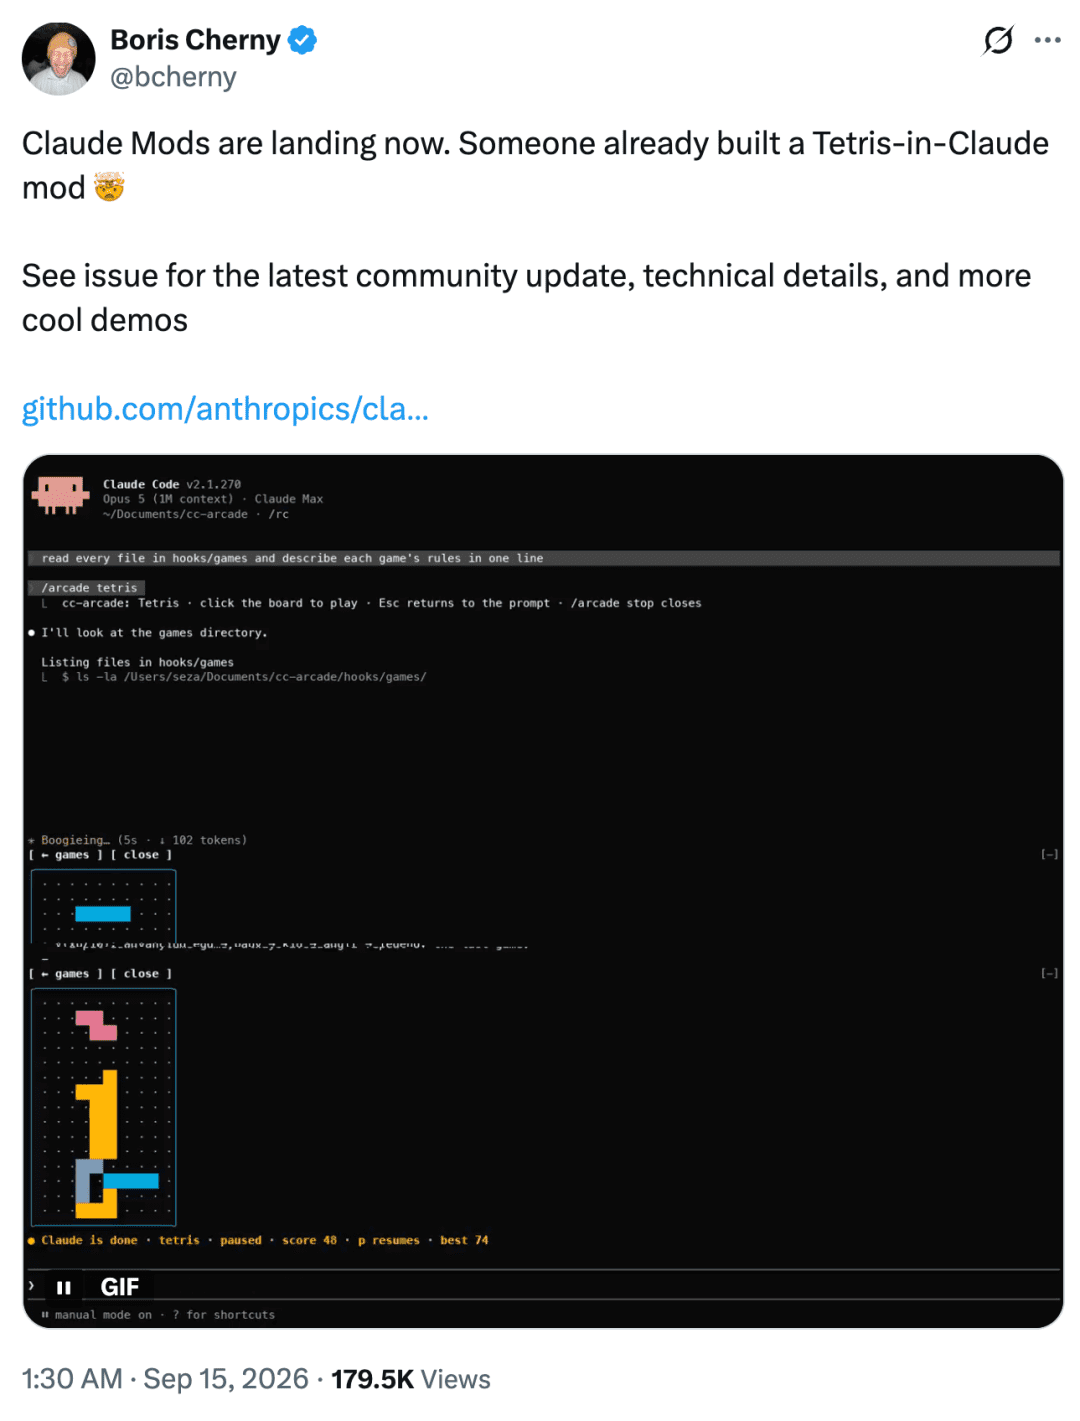
9 月 10 日左右,Claude Code 负责人 Boris Cherny 在 X 上宣布,Claude Mods 开始落地。很快,社区就有人基于这套新机制做出了 Tetris Mod。乍看是个趣味 Demo,但背后的技术动向远比游戏本身重要得多。
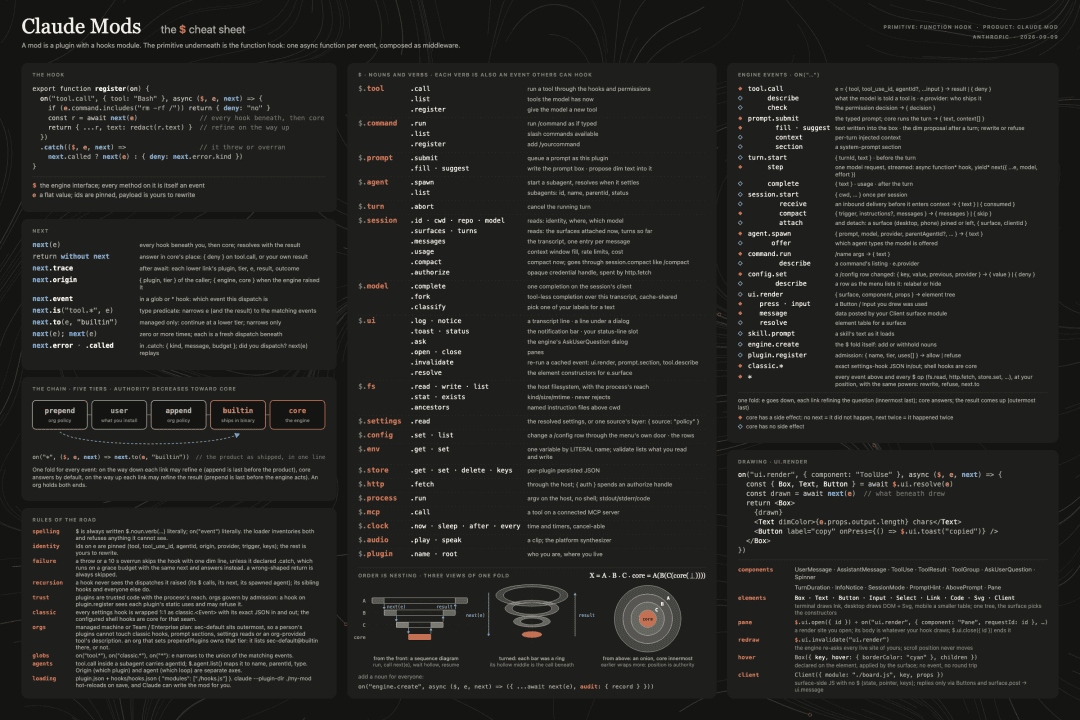
Claude Mods 的核心,是让开发者能更深入地干预 Claude Code 的运行逻辑——比如在 AI 准备执行一条命令前拦下来检查,或者给界面加个新按钮。更进一步,用户甚至可以对 Claude 说:“我想让编辑器支持某种交互”,然后让它自动生成对应的插件代码。
这并不等于 Claude 能改自己的模型权重,也不是随意重写核心程序。它是在 Anthropic 设定的扩展边界内,把越来越多的功能变成可被外部代码操控的接口。换句话说,Claude Code 正从一个封闭的 AI 工具,转向一个可被开发者“长”在上面的平台。
从 Function Hooks 到 Claude Mods
这场变化的起点,可以追溯到 9 月 3 日。那天,Anthropic 工程师在 Claude Code 的 GitHub 仓库提交了一项名为 “Function Hooks” 的提案。
在此之前,Claude Code 已支持基础的 Hooks 机制。比如在会话开始、工具调用前后插入脚本。这些脚本通常是小型 Shell 脚本,只能在几个预设节点运行,功能有限,且在 Windows 上经常出问题。
Function Hooks 把这层能力往内部推进了一大步。现在,Hook 可以写成带完整类型定义的 TypeScript 函数。多个 Hook 按注册顺序层层嵌套,行为很像 Express 或 Koa 这类 Web 框架中的 middleware(中间件)。
举个例子:当 Claude 准备调用一个文件写入工具时,第一个 Hook 可以检查路径是否包含敏感目录;如果违规,直接拒绝执行;如果合规,则把请求传给下一个 Hook。整个过程发生在 Claude Code 的关键执行路径上,不再是边缘回调。
这套机制还延伸到了 UI 层。插件可以挂载到 Claude Code 的 React 组件上,修改 props,甚至包装最终渲染的节点。一次按钮点击事件,也能被 Hook 捕获并处理。终端和桌面端的相同操作,可以走同一套逻辑。管理员还能站在调用链上游,限制后续插件能访问哪些能力。
9 月 9 日,Anthropic 正式将这一功能命名为 “Claude Mods”,并明确表示:一个 Mod 本质上就是一个使用 Function Hooks 的插件。Function Hooks 作为底层工程机制保留,Claude Mods 则成为用户可见的产品形态。
官方当时称功能将在“数周内”发布,并开放了首批内置 Mods 的源码,允许开发者通过实验开关提前试用。结果没过几天,主仓库就开始密集出现 Mods 相关的提交。
目前代码中已能看到 diff、sec-default 和 telemetry 等内置 Mod。其中 diff 尤为关键——Claude Code 原本自带的代码差异对比面板,正在被重构成一个 Mod。Anthropic 的意图写得很清楚:未来会把更多现有功能迁移到 Mod 形态。
网友热评:影响可能超过新模型发布
GitHub 和社交平台上,不少开发者认为:“Claude Mods 的影响,可能会比发布一个新模型还大。”
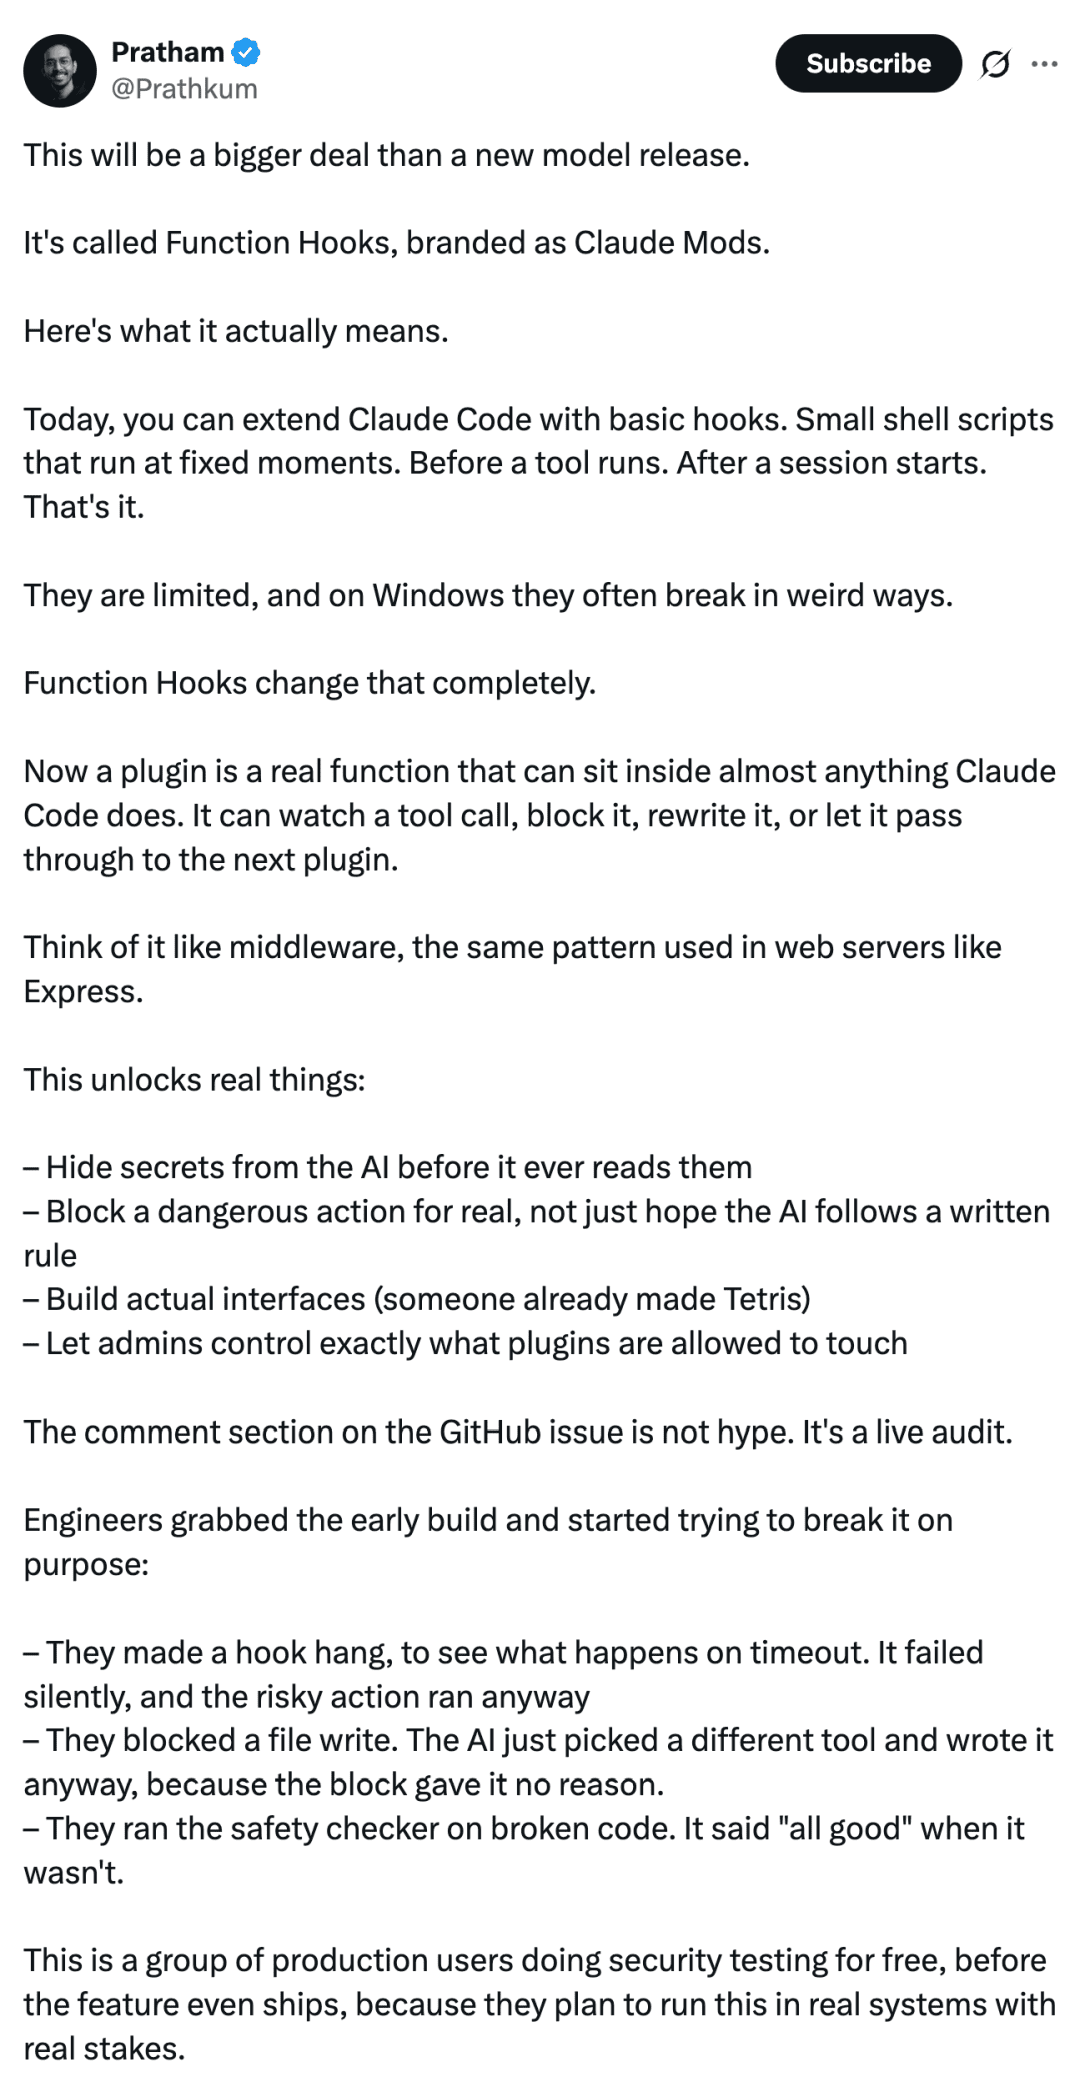
原因在于,过去 Claude Code 的扩展能力非常受限。基础 Hooks 只能在固定节点运行,无法介入核心流程,也无法构建复杂交互。而 Mods 改变了这一点——插件现在能作为真正的函数,嵌入几乎任何执行环节。
这意味着一系列实际能力成为可能:
- 在 AI 读取项目文件前,自动过滤掉密钥、密码等敏感内容;
- 真正阻止危险操作,比如删除生产数据库,而不是依赖 AI “自觉遵守规则”;
- 构建富交互界面,比如那个在 Claude 里运行的俄罗斯方块;
- 让企业管理员精确控制每个插件能访问哪些 API、修改哪些数据。
但评论区并非一片叫好。相反,GitHub issue 下的讨论更像一场公开的安全审计。一些工程师拿到早期版本后,立刻开始“搞破坏”,测试系统在异常情况下的表现:
- 有人故意让一个 Hook 无限卡住,结果发现超时后 Hook 静默失败,原本有风险的操作继续执行了;
- 有人拦截了一次文件写入,但 AI 换了个工具绕过拦截,因为插件没告诉它“为什么不能写”;
- 有人用明显有问题的代码跑安全检查,结果系统仍返回“一切正常”。
这些用户不是在挑刺,而是真打算把 Mods 接入生产环境。他们知道,一旦接入,AI 的每一个操作都可能带来真实后果——删错文件、泄露数据、误部署。所以他们在正式发布前,免费帮 Anthropic 做压力测试。
Coding Agent 的竞争,正在移向模型之外
从行业角度看,Claude Mods 的出现时机很有意思。
大模型的基础能力仍在进步,但 Coding Agent(编码智能体)的竞争焦点,已经开始从“谁的模型更强”转向“谁的外围架构更可靠”。上下文组织、工具链设计、权限控制、记忆管理、子 Agent 协作、失败恢复机制、企业规则注入……这些共同构成了 Agent 的 “Harness”(运行框架)。
Claude Mods 相当于把 Harness 的一部分控制权交给了开发者。未来,开发者选择 Coding Agent 时,考虑的可能不只是“哪个模型写代码更准”,还包括:
- 平台是否有成熟的插件生态?
- 能否对 AI 行为做细粒度控制?
- 是否支持企业级策略(如审计日志、权限隔离)?
- 自己的工作流能否真正“长”在这个平台上?
Anthropic 正在做一件典型的平台化动作:先开放扩展接口,再用自己的产品功能验证这套接口(比如把 diff 面板重构成 Mod),然后鼓励社区填充生态。目前,仓库里已有第一批内置 Mods,社区也出现了实验性项目。
如果这套机制最终稳定下来,Claude Code 的升级逻辑也会改变。过去,想要某项功能,得等 Anthropic 官方开发。以后,很多时候可能只需对 Claude 说一句:“我想让编辑器这样工作。”剩下的,Claude 自己就能写出来——生成 Mod 代码、测试、加载,一气呵成。
当然,这一切的前提是安全可控。而那群在 GitHub 上“搞破坏”的工程师,正是这套新范式能否落地的关键守门人。他们的反馈,将决定 Mods 是成为生产力利器,还是变成新的攻击面。
眼下,俄罗斯方块只是个开始。真正值得期待的,是开发者们接下来会用 Mods 做出什么。