GPT-6 Astra 的循环深度争议:技术真相与思维链可解释性
GPT-6 Astra 引发的“循环深度”争议
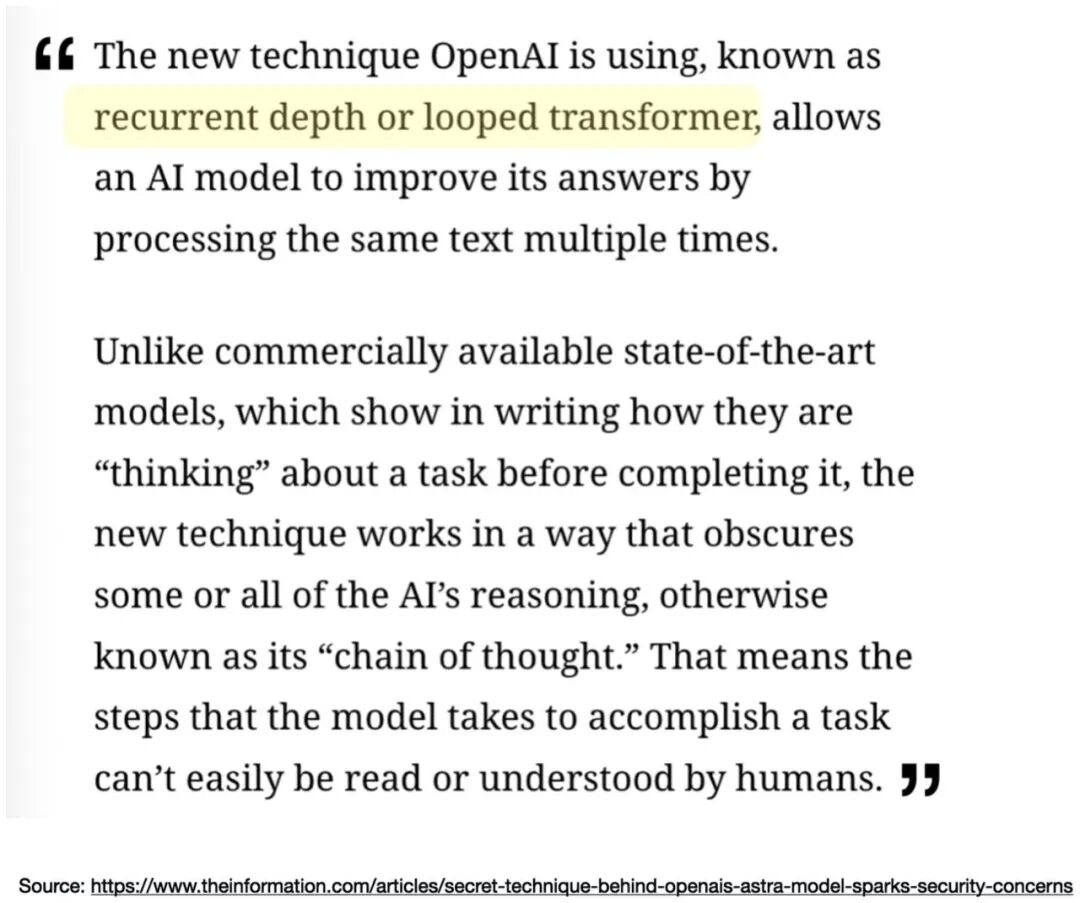
过去两周,“循环深度”(recurrent depth)这个词突然成了 AI 安全圈的热门话题。导火索是知名科技媒体 The Information 在 OpenAI 发布 GPT-6 Astra 前两天放出的一则内部消息:Astra 采用了一种叫 循环 Transformer(looped transformer)的设计,这种设计“会让模型的部分乃至全部推理过程变得不可见”。
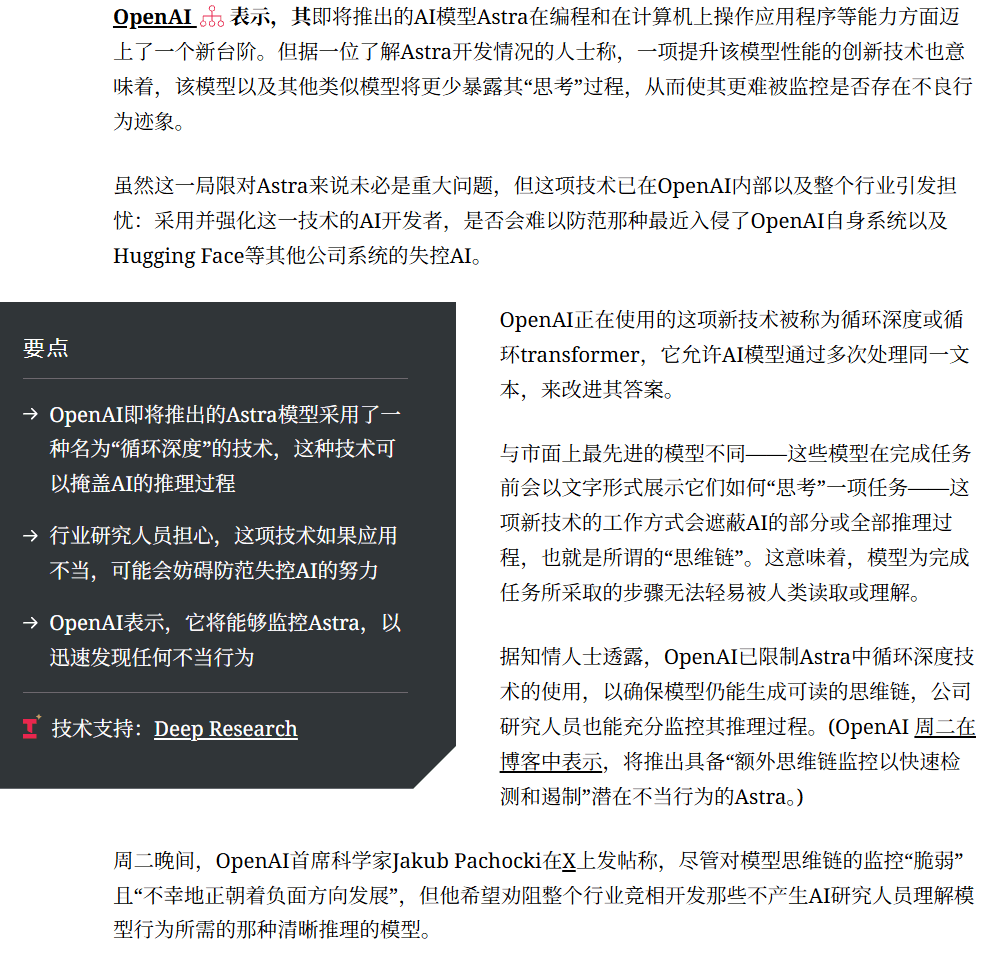
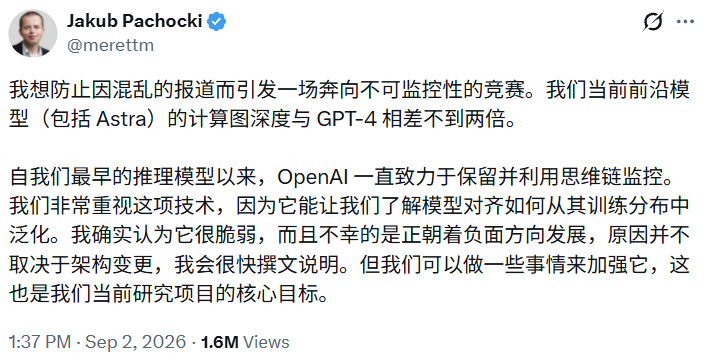
消息一出,社区炸锅。人们担心这是否意味着新一代大模型正在走向“黑箱化”,连开发者都无法监控其内部逻辑。几天后,OpenAI 首席科学家 Jakub Pachocki 出面澄清,称当前前沿模型(包括 Astra)的计算图深度与 GPT-4 相比仍在两倍以内,并强调他想避免“一场由混乱报道引发的、奔向不可监控性的竞赛”。
在这片模糊转述和猜测中,著名技术博主、《Build a Large Language Model (From Scratch)》作者 Sebastian Raschka 写了一篇长文,试图拨开迷雾。他不仅分享了自己使用 Astra 的一手体验,还系统梳理了循环 Transformer 的技术脉络,并对“隐藏思维链”的说法给出了明确否定。
Astra 的实际表现:强在哪?
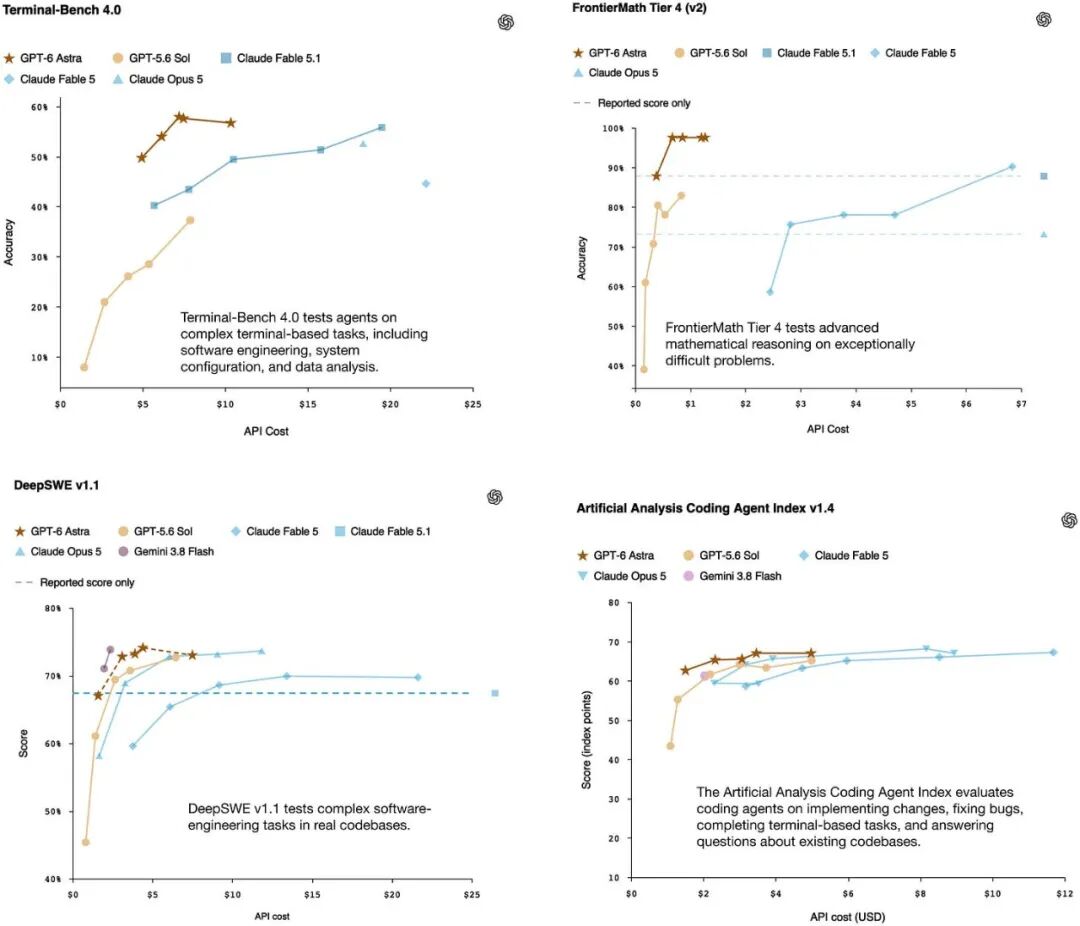
Raschka 开篇就直言:GPT-6 Astra 是他用过的最好的模型。但它的优势并非均匀分布——在 3D 渲染、动画和图形任务上的领先尤其突出,远超其在写作、数学或编程等常规领域的提升。
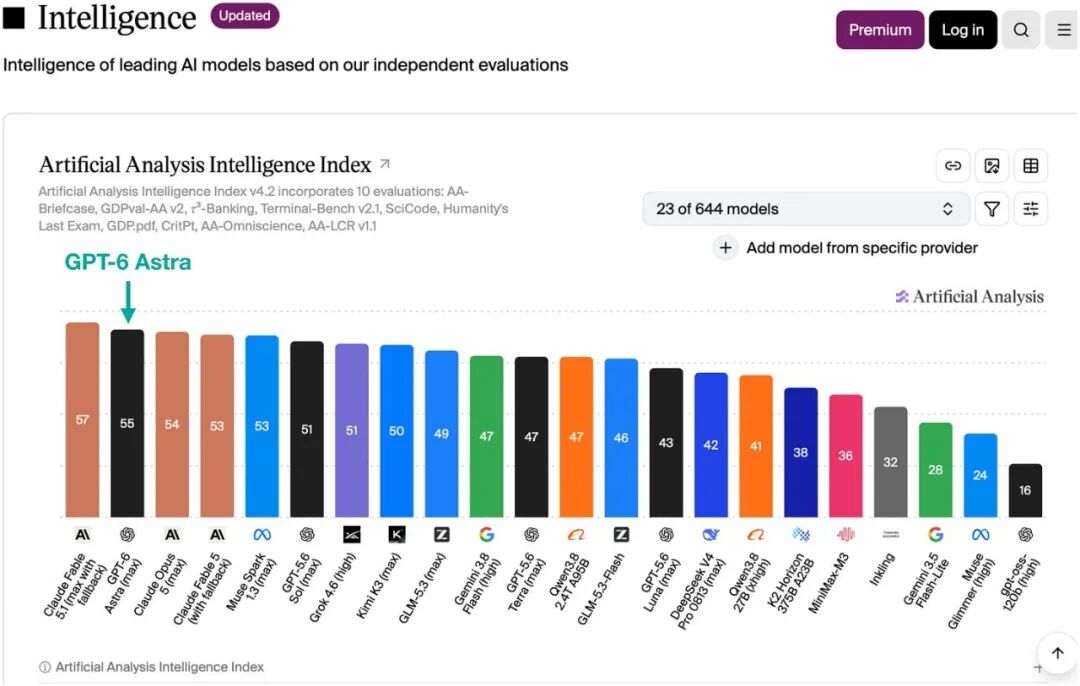
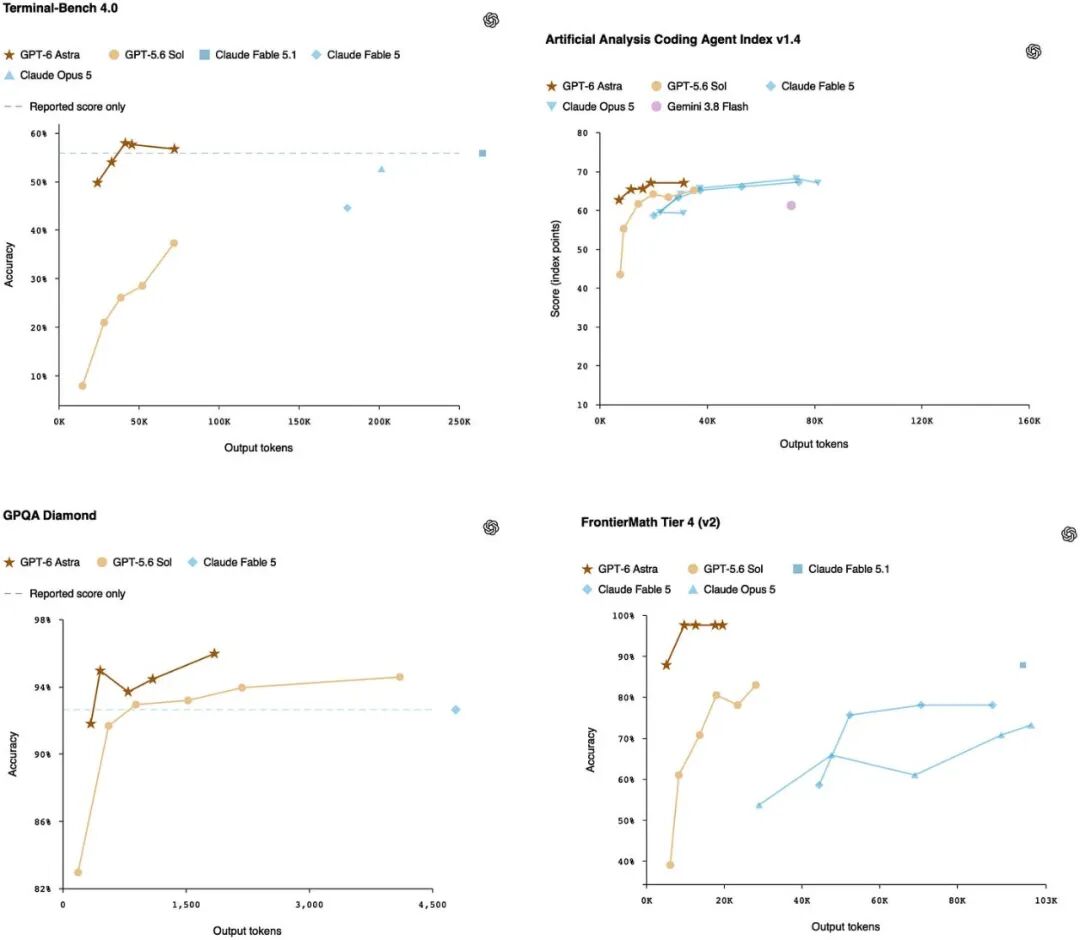
这一点在基准测试中也有体现。例如,在衡量逻辑谜题求解与泛化能力的 ARC-AGI-3 域名上,Astra 拿到了惊人的 99.9%,而前代 GPT-5.6 Sol 仅为 7.8%。在更贴近真实场景的编程和计算机操作类基准中,Astra 同样处于前沿,尽管优势没有那么夸张。
计算机操作能力的飞跃
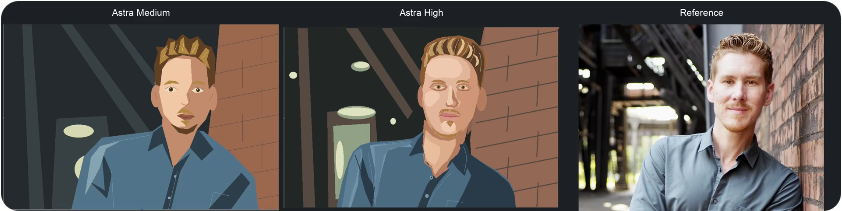
Astra 最引人注目的新能力,是通过 Codex/ChatGPT 应用直接操作用户本地电脑上的软件。Raschka 展示了一个例子:让 Astra 在浏览器版 MS Paint 中,用鼠标重绘他的照片。这不仅考验绘画能力,更关键的是模型能否理解并操控图形界面。
这类演示在社交平台上迅速走红,从 Blender 建模纽约市到虚拟看房导览,效果直观且震撼。Raschka 认为,这背后反映了一个趋势:与其等待所有软件都提供命令行接口(CLI),不如直接提升模型使用图形用户界面(GUI)的能力。这类似于人形机器人的发展逻辑——牺牲部分效率,换取通用性。
Mac 环境与强化学习训练
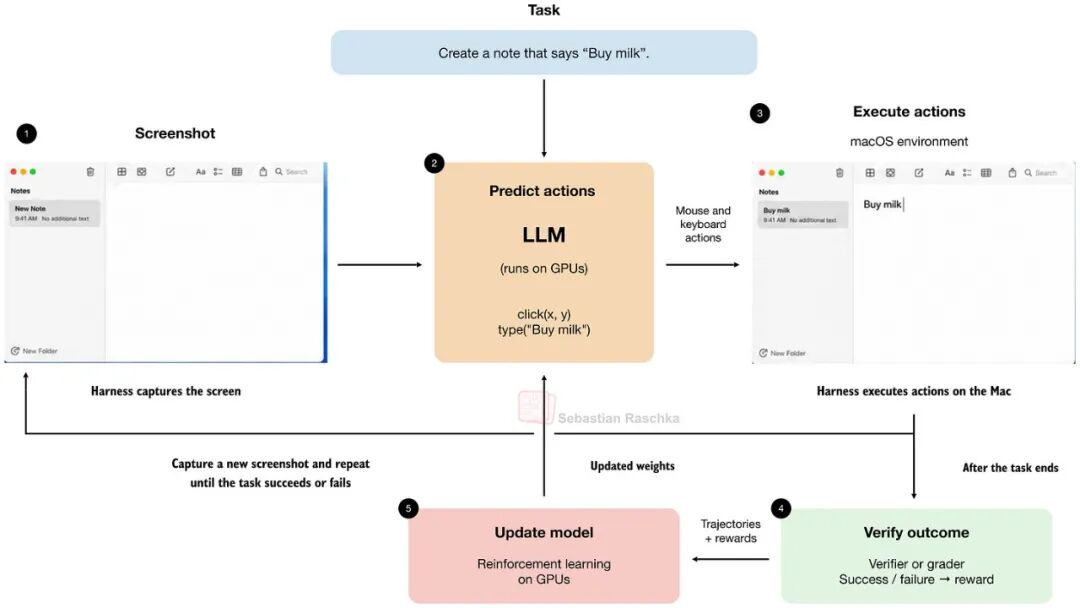
这一能力的实现,与近期一则报道高度吻合:OpenAI 采购了数万台 Mac Mini 和 Mac Studio。这些设备并非用于模型训练(那仍由 GPU 集群完成),而是作为强化学习的交互环境。
训练流程大致如下:
- 给模型一个任务提示,如“打开某应用并完成某操作”。
- 框架将 macOS 界面的截图传给模型。
- 模型预测下一步的鼠标或键盘动作。
- 框架在真实的 Mac 上执行该动作。
- 获取新界面截图,反馈给模型,重复上述过程。
- 根据任务成功与否,通过可验证奖励强化学习(RLVR)进行训练。
简言之,这些 Mac 构成了一个庞大的“数字沙盒”,让模型在真实操作系统中学习如何与软件交互。
循环 Transformer:技术原理详解
要判断“循环深度”是否真的会隐藏思维链,首先得搞清楚它到底是什么。
核心思想:复用权重
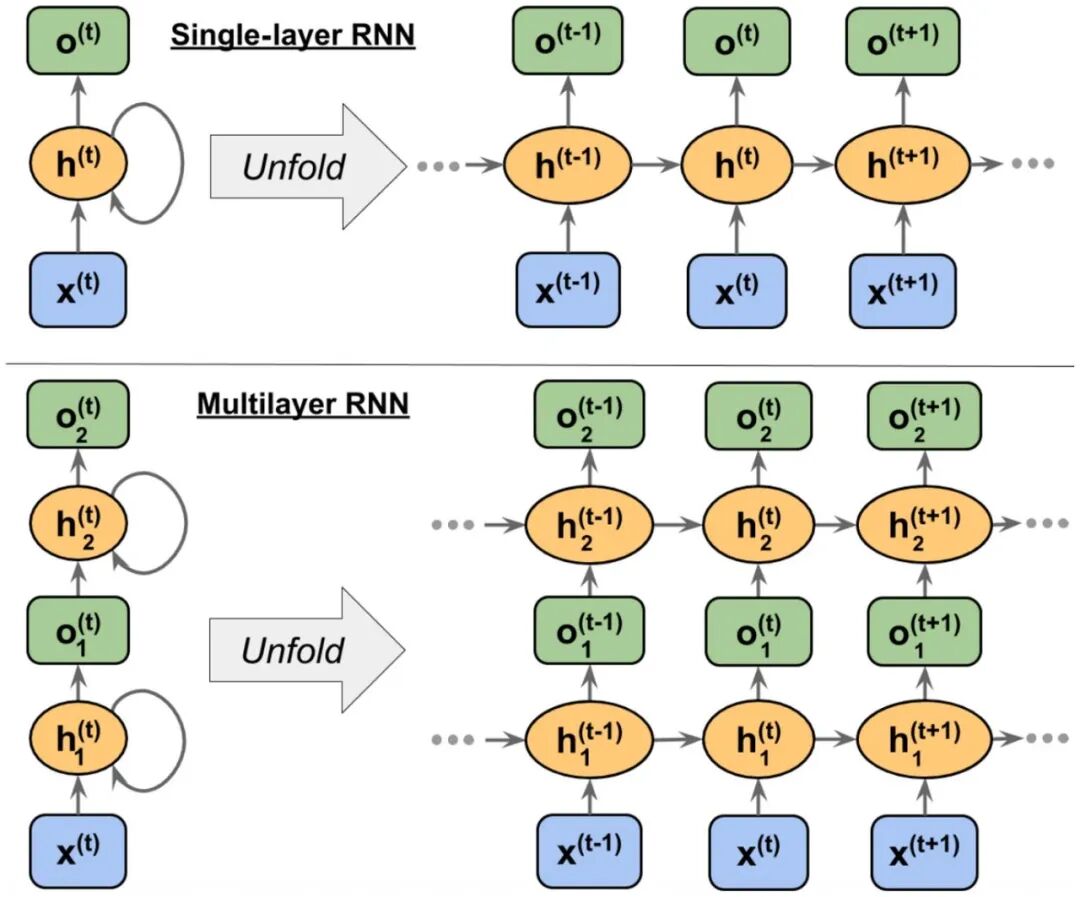
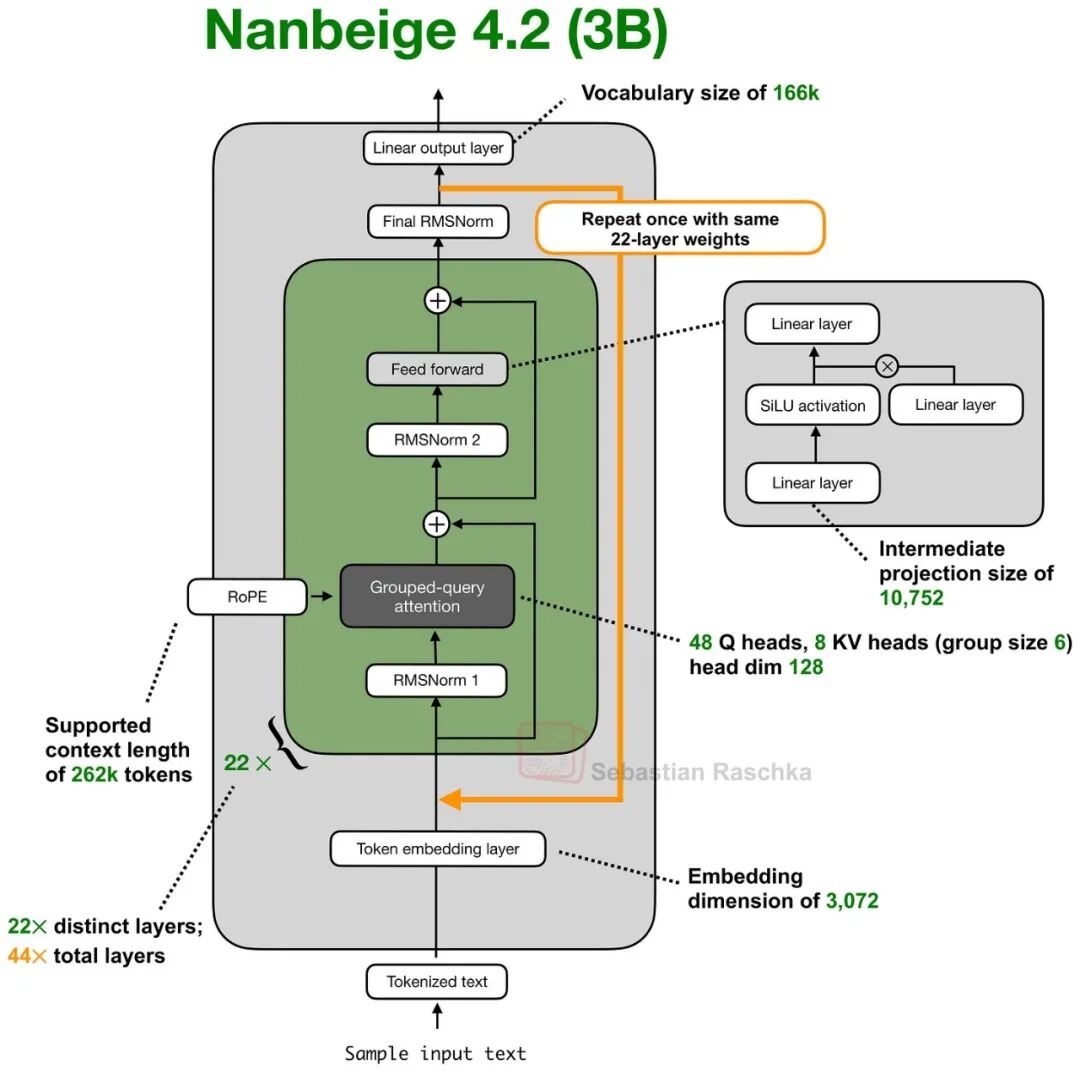
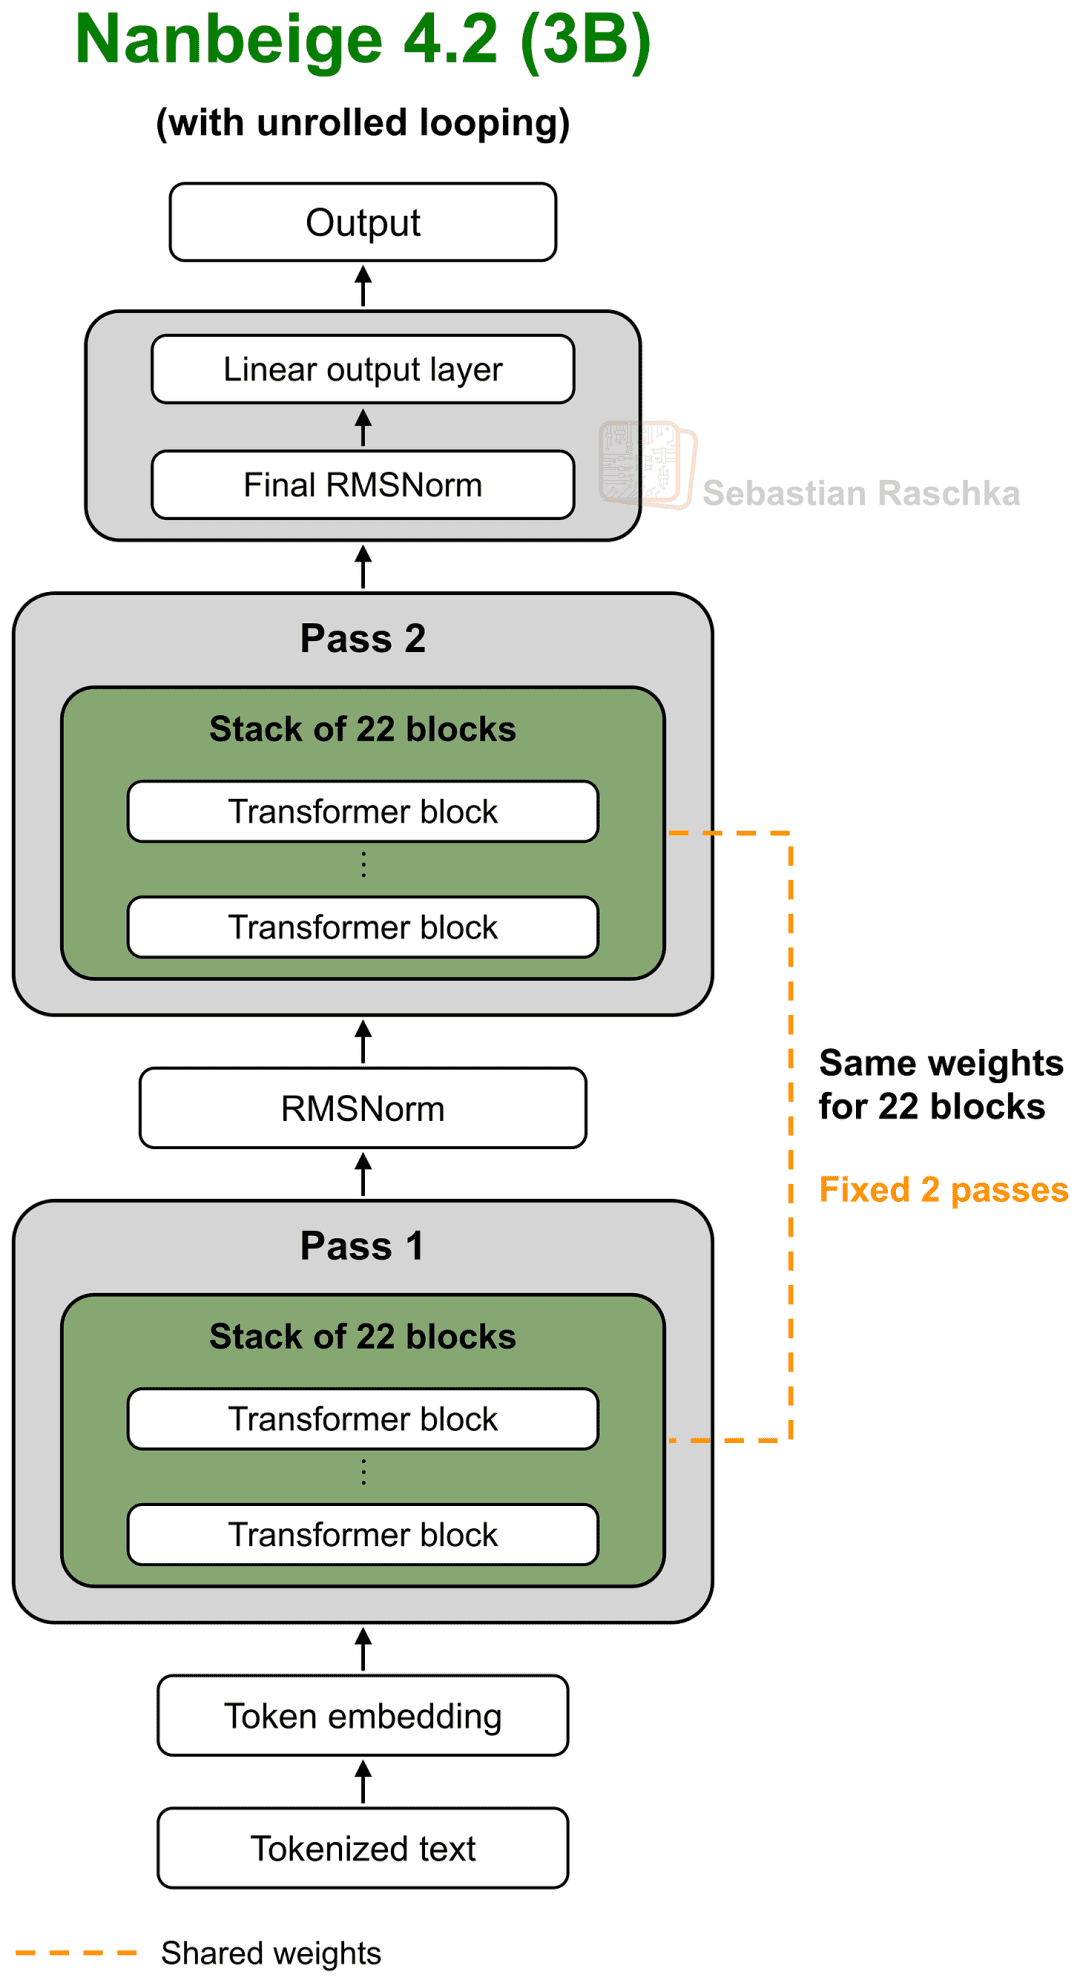
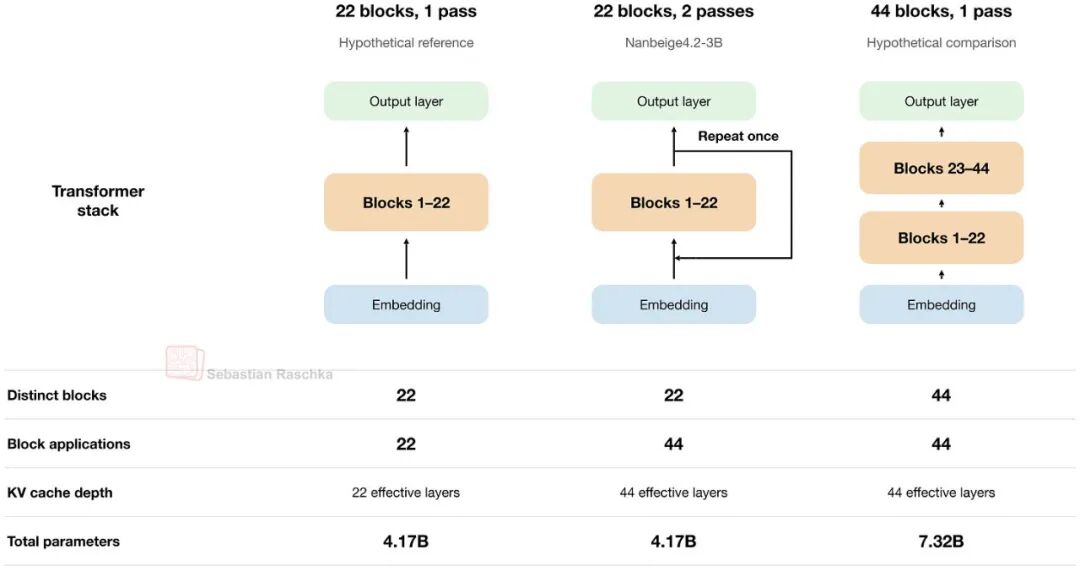
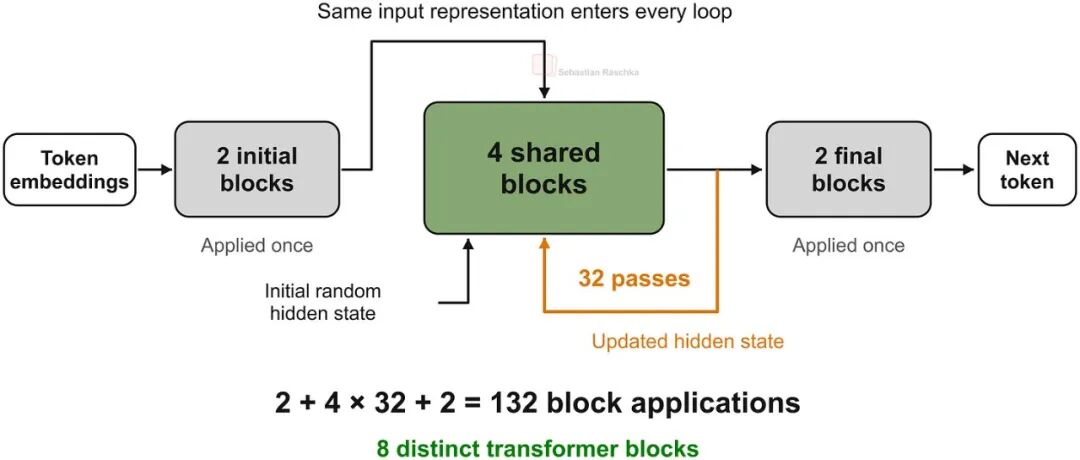
循环 Transformer 的核心思路很简单:让输入数据多次通过同一组 Transformer 块,而不是堆叠更多独立的块。权重在每次遍历中保持不变,从而在不显著增加参数量的前提下,有效增加模型的“深度”。
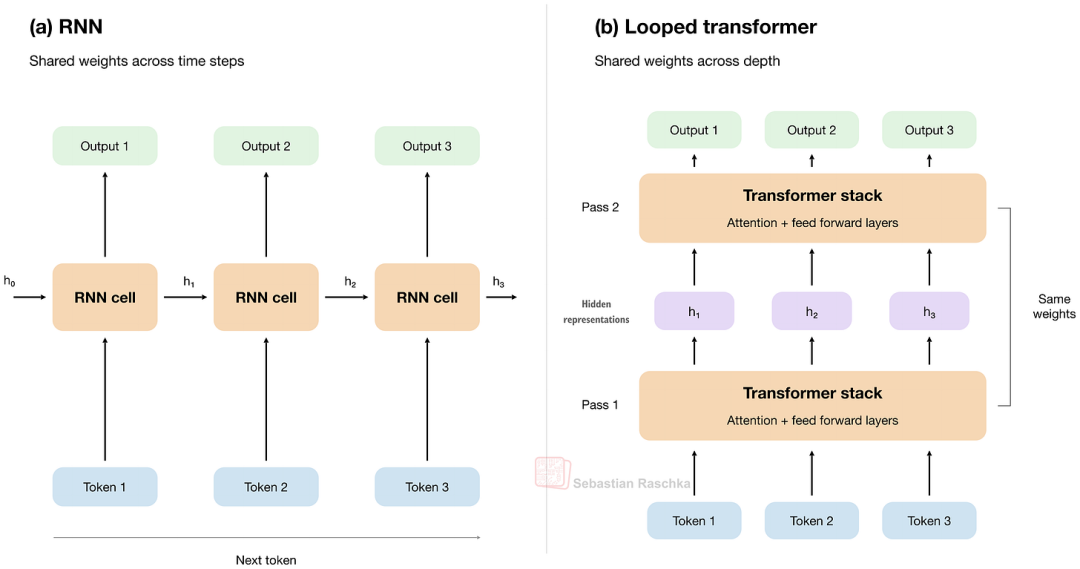
一个典型例子是开放权重模型 Nanbeige4.2-3B。它拥有 22 个 Transformer 块,但会让输入数据先后通过这 22 个块两次。展开来看,相当于进行了 44 次块应用,但参数量只相当于一个 22 层模型。研究者发现,两轮循环是性能与成本的最佳平衡点,更多轮次带来的收益递减。
更灵活的设计:自适应循环次数
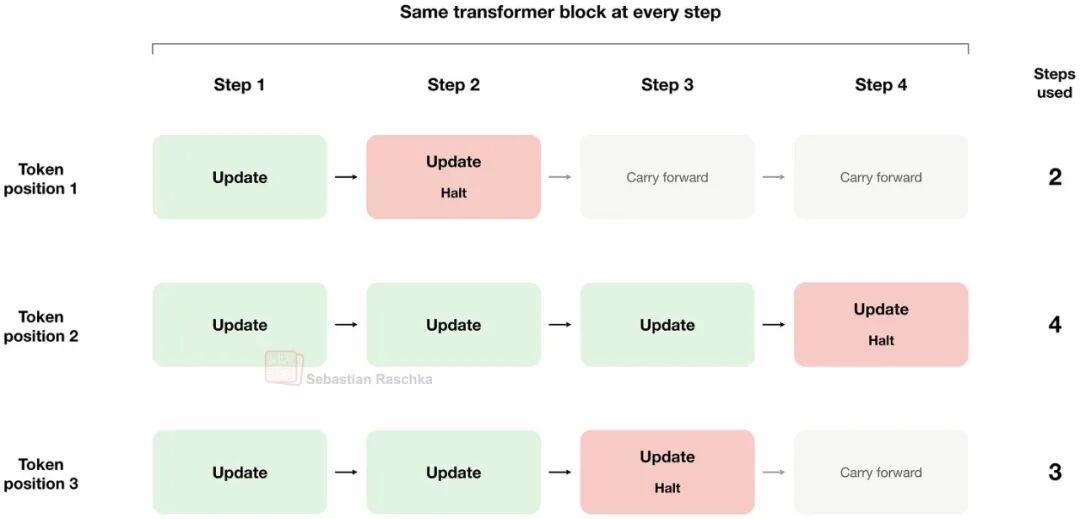
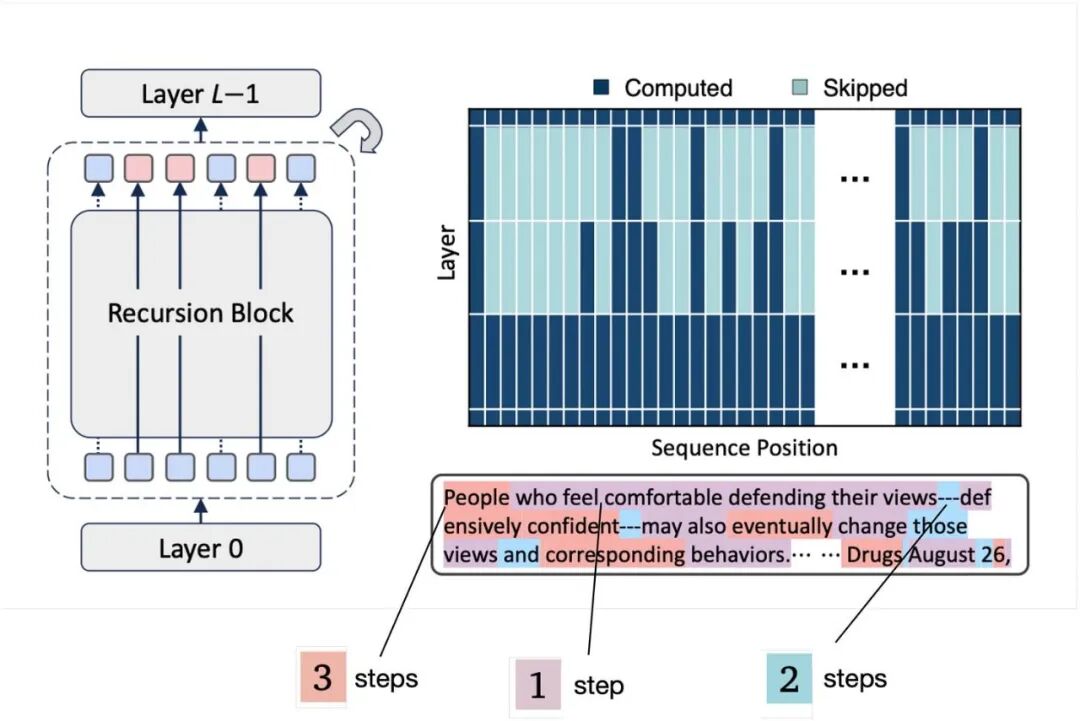
2018 年的 Universal Transformer 提出了更灵活的方案:每个 token 可以根据需要决定循环多少次。模型内部有一个小型函数,为每个位置输出一个“停止概率”,一旦累积概率超过阈值,循环就停止。这使得计算资源能被动态分配给更复杂的 token。
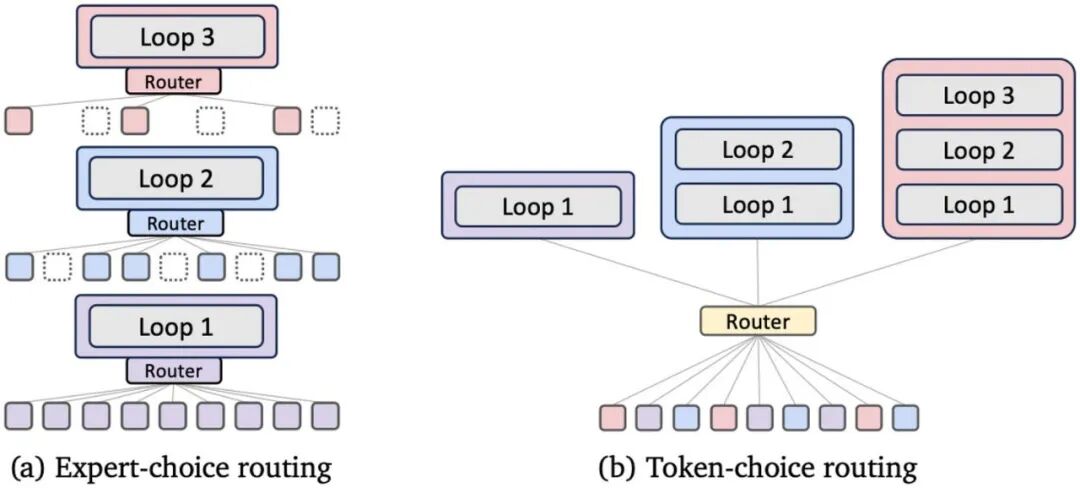
字节跳动的 Ouro 模型则更激进,将 48 个块循环四次,并引入“退出门”机制来选择最终输出来自哪一轮。而 2025 年的 Mixture-of-Recursions(MoR)论文,则借鉴了混合专家(MoE)的路由思想,用一个可学习的路由器为每个 token 动态分配循环次数(1次、2次或3次),实现了更精细的计算控制。
效果如何?
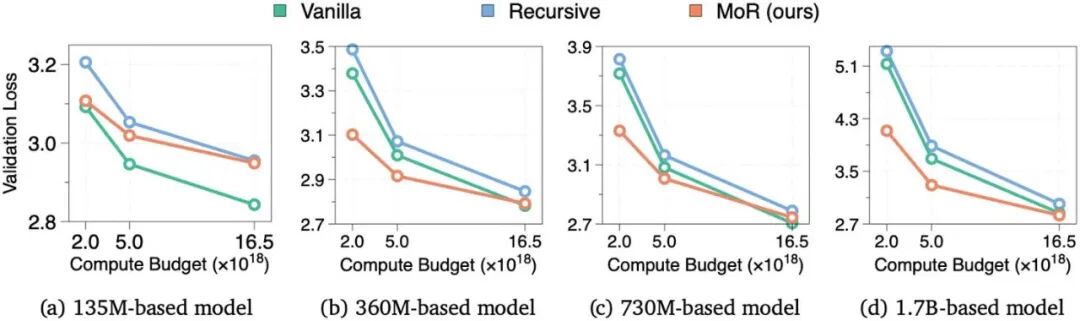
MoR 论文的实验表明,在较大的模型规模和有限的训练算力下,循环 Transformer 的表现优于传统架构。因为它能在相同算力预算内处理更多 token,或者用更少的算力达到相同的性能。不过,在小模型上,传统 Transformer 依然占优。这说明,循环架构的优势依赖于足够大的模型规模。
循环 Transformer 会隐藏思维链吗?
这是争议的核心。Raschka 给出了明确的否定答案。
思维链的本质
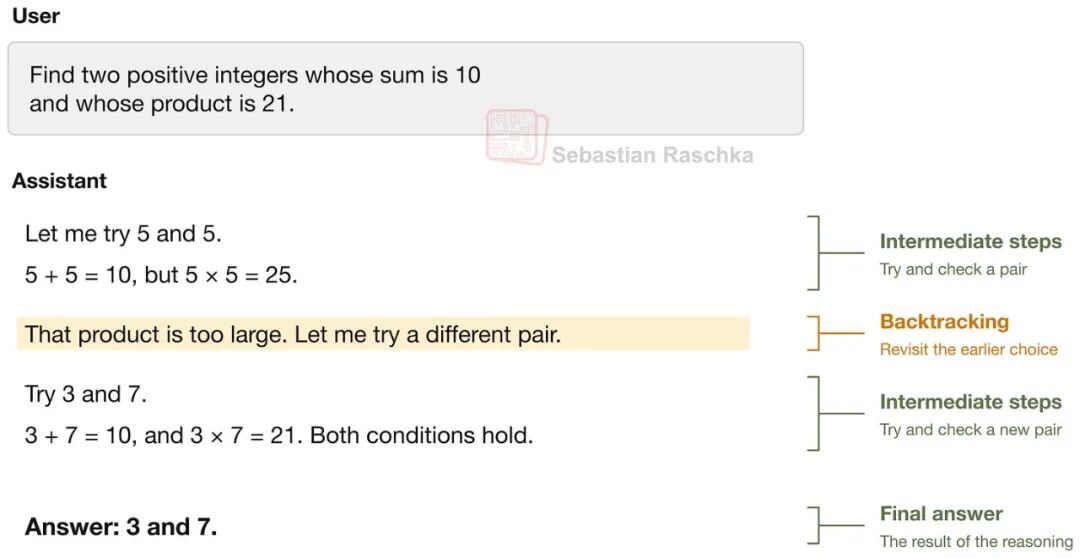
首先,推理模型(如 OpenAI o1 系列)的工作方式是在给出最终答案前,生成一系列中间步骤,即“思维链”或“推理轨迹”。这些步骤就像草稿纸,帮助模型进行多步推理和错误回溯。OpenAI 一直倾向于对终端用户隐藏大部分轨迹,所以对普通用户而言,Astra 并未带来新变化。
更短的轨迹 ≠ 更差的可解释性
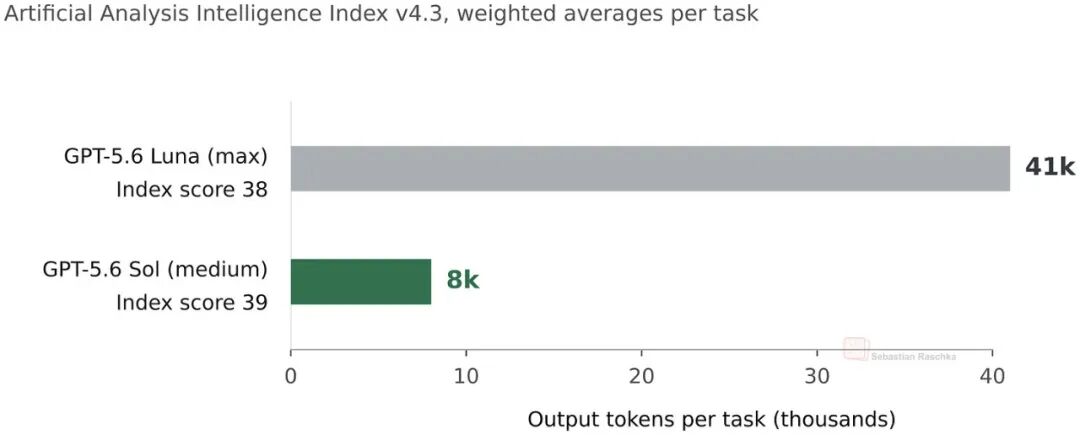
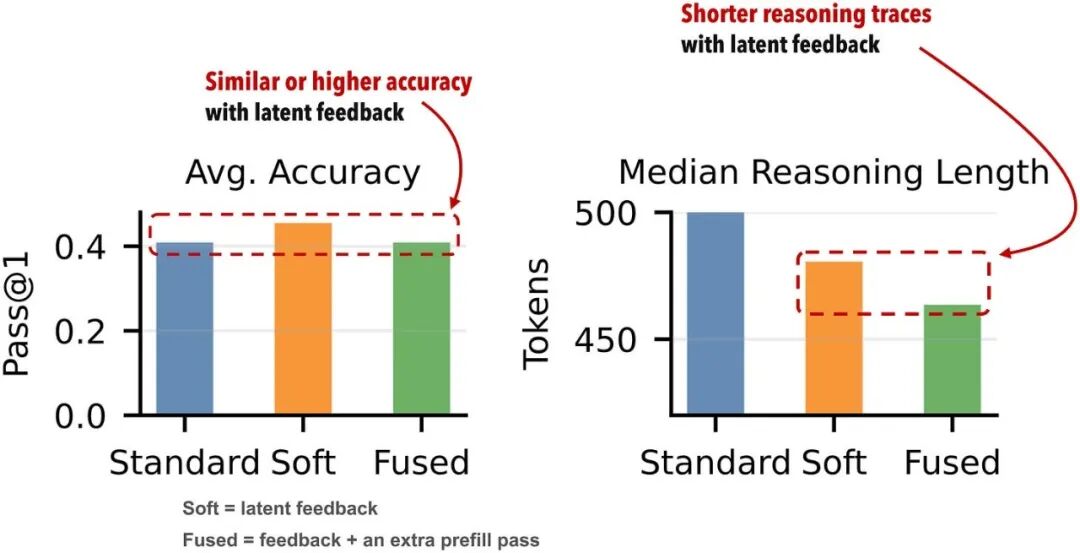
Astra 的推理轨迹确实更短。但这很可能只是因为模型能力更强,犯错更少,不需要那么多“草稿”。Raschka 举了一个有力的例子:在同一模型家族中,更大的 GPT-5.6 Sol 在达到与较小的 Luna 相近性能时,token 用量少了 80%。没人会因此说 Sol 的可解释性更差。
Astra 的系统卡也承认其推理轨迹的可监控性有所退步,但这更可能是整体长度变短的结果,而非循环架构的直接后果。目前没有任何证据表明循环 Transformer 会刻意生成“虚假”的推理轨迹来误导监控者。
Pachocki 的澄清也佐证了这一点。他明确表示,思维链可监控性的下降“与架构变化无关”,并承诺将专门撰文说明真正的原因。
相关研究的新洞见
除了上述模型,近期还有几项研究值得关注:
- 潜在推理(Latent Reasoning):在推理时动态增加循环次数,让模型能根据任务难度调整计算量。实验显示,某些任务(如 GSM8K)能从更多循环中持续获益。
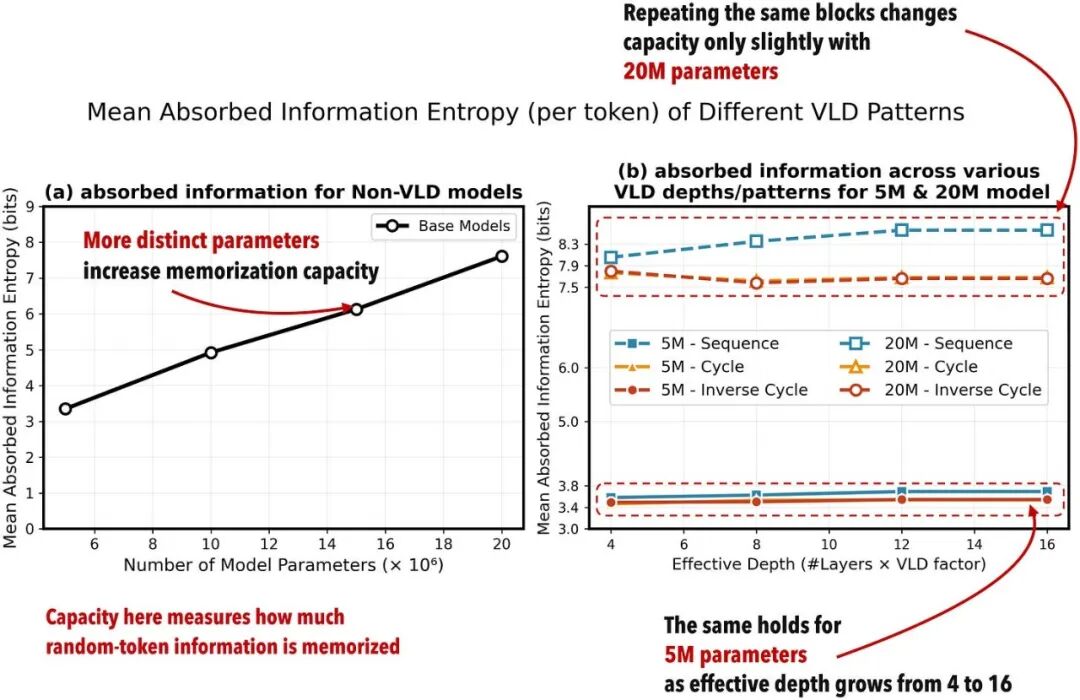
- 知识检索 vs 推理:一项研究区分了模型的“存储”和“推理”能力。结果发现,循环架构几乎不增加模型的知识存储容量,但能显著提升多步推理表现,证明其价值在于计算而非记忆。
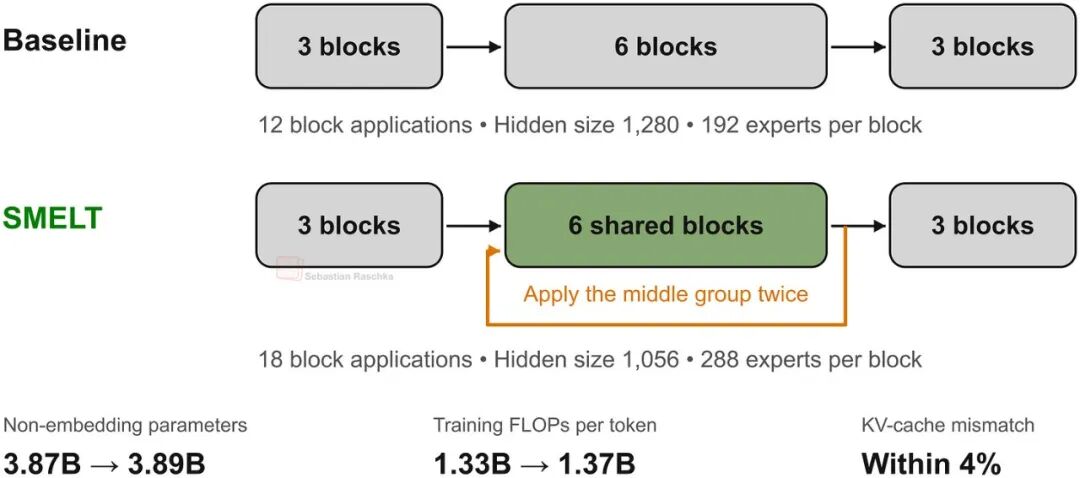
- 算力对齐下的比较:SMELT 论文在严格对齐算力、参数量和 KV 缓存的条件下比较了循环与传统架构,发现前者能达到相同性能所需的训练算力少 6.8% 到 18%,证明了其计算效率优势。
- 全带宽 Transformer:这项研究探索了跨 token 的循环,发现它能缩短基座模型的推理轨迹,但该效应在指令微调后消失,说明训练方式对轨迹长度有重要影响。
结语
GPT-6 Astra 的强大毋庸置疑,尤其在计算机操作领域迈出了关键一步。它很可能采用了某种循环 Transformer 的变体,这是一种在固定算力下提升性能的有效手段。
至于“隐藏思维链”的担忧,更像是对技术细节的误读。更短的推理轨迹,是模型变得更聪明、更高效的自然结果,而非有意为之的遮蔽。正如一个准备充分的学生在考场上很少需要草稿纸一样,一个强大的模型也能在内部完成更多计算,减少对外部“草稿”的依赖。
未来几个月,计算机操作能力将成为开源和闭源框架竞争的新焦点。而在这个将系统控制权部分交给 AI 的时代,开源框架的透明性和可审计性,将显得尤为重要。