REAL:让机器人在模糊指令和未知环境中主动探索与沟通
真实任务从不完整信息开始
你对家里的机器人说:“帮我从餐桌上拿点零食。”听起来简单,但问题来了——餐桌上可能有面包、一包薯片、两个不同口味的甜甜圈。你没说清楚要哪个,机器人也不知道该选什么。

更麻烦的是,机器人一开始甚至不知道餐桌在哪,或者零食是否真的在那儿。它得自己走过去看,边看边找,发现多个选项后再回头问你:“我看到一个面包和两个甜甜圈,您要哪一个?”

这正是真实家庭场景的常态:环境未知,指令模糊。而大多数现有的具身智能研究却建立在两个理想化假设上:一是机器人能直接知道所有物体的位置(通过“上帝视角”的特权接口),二是用户总能给出精确无歧义的指令。这两个假设在真实世界里根本站不住脚。
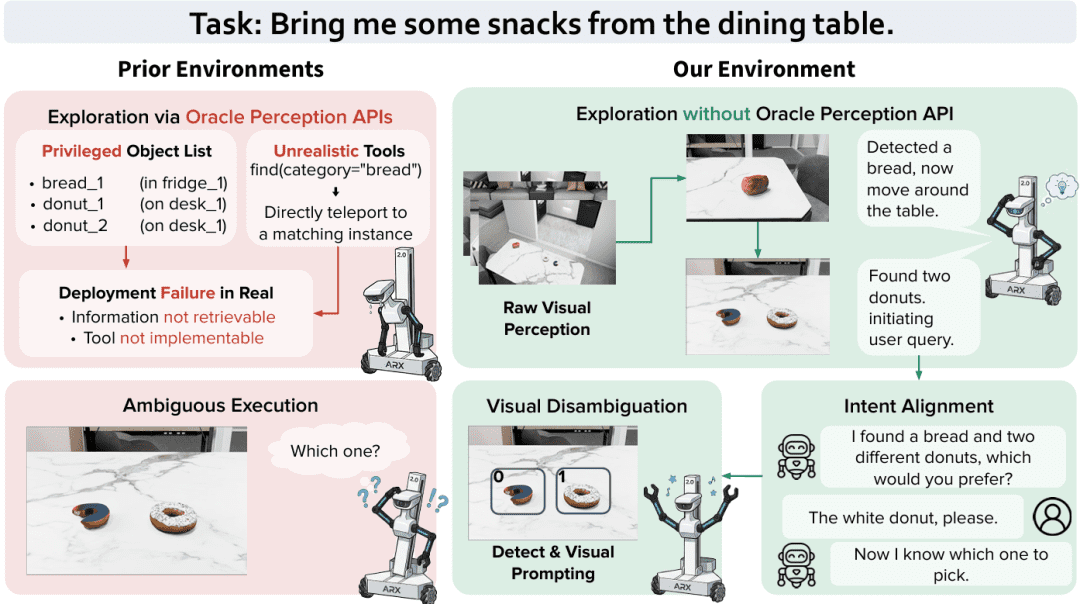
为了解决这个问题,上海交通大学、上海人工智能实验室等机构的研究者提出了 REAL(Reasoning, Exploration, and Active interaction for embodied Language agents)框架。这项工作已被 ECCV 2026 接收,核心目标是让机器人在没有完美感知、没有清晰指令的情况下,依然能完成任务。
打破理想化假设:去掉特权感知,接受模糊意图
REAL 首先对现有仿真环境动了刀子:移除了特权感知接口。这意味着机器人不能再直接调用“告诉我所有苹果的位置”这样的函数。它必须像人一样,走到桌子旁,环顾四周,用摄像头一点点扫描,靠视觉检测出可能的目标。
同时,REAL 引入了模拟用户来处理意图模糊的问题。当机器人在探索中发现多个符合“零食”描述的物体时,它会主动调用 Ask 工具,生成一句自然语言提问,比如:“我找到了原味和巧克力味的甜甜圈,您想要哪个?”模拟用户会根据预设的任务目标给出回答,机器人再据此执行下一步操作。
这样一来,探索、理解、执行不再是三个独立阶段,而是一个持续交互的闭环。机器人不是被动等待完美指令,而是主动获取信息、暴露不确定性、请求澄清,再行动。
系统架构:大脑、工具与记忆
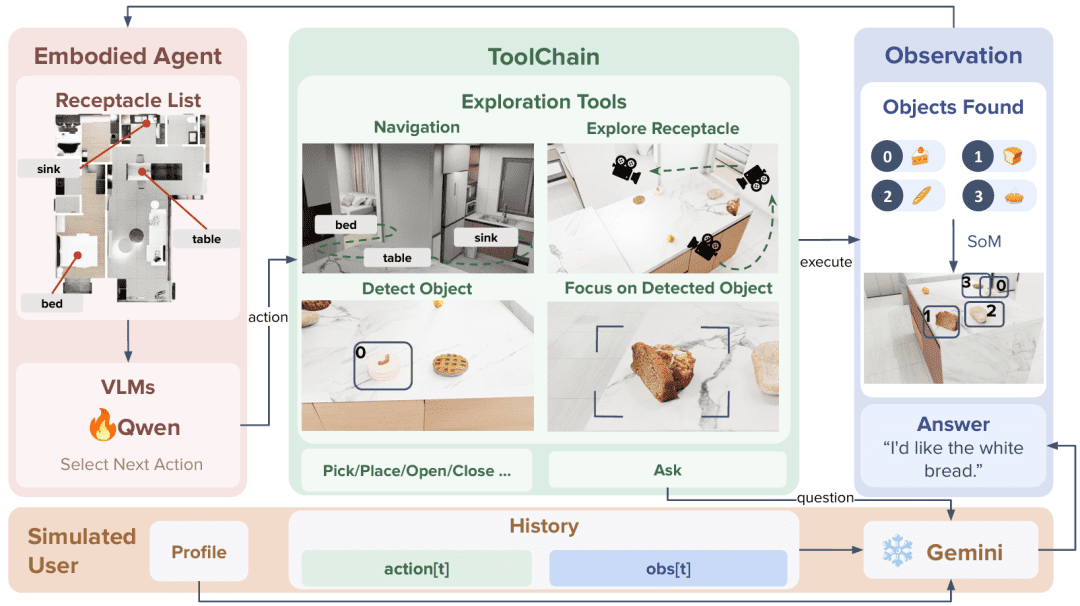
REAL 的整体架构由三部分组成:
大脑基于 Qwen3-VL-8B-Instruct 视觉语言模型。它接收第一视角 RGB 图像、物体分割掩码、用户回复等多模态输入,并维护一个结构化的自摘要历史状态。这个状态只保留与当前决策相关的关键信息,比如“已打开微波炉”“在柜子A发现面包”,避免上下文无限膨胀。
工具与接口通过模型上下文协议(MCP)标准化。高层大脑只需输出离散的工具调用,比如 Nav_to(table) 或 Ask("有两个杯子,要哪个?"),MCP 服务器负责将其转换为底层可执行的操作。这套工具链包括四类:
- 探索类:
Nav_to(导航到区域)、Walk_around(绕行扫描)、Show_object_by_category(按类别显示物体)、Gaze_at(注视特定物体) - 操作类:
Pick、Place、Open、Close - 交互类:
Ask(主动提问) - 感知反馈:返回视觉分割结果、3D 位置、物体ID等
状态与记忆则将所有工具返回的信息组织成结构化格式。例如,当 Show_object_by_category("snack") 被调用后,系统会返回检测到的物体列表,每个物体附带视觉掩码、类别标签和临时ID。这些ID用于后续的 Pick 操作,确保机器人抓取的是用户确认的那个具体物体,而不是随便一个“甜甜圈”。
技术实现:如何让机器人学会“边看边问”
主动探索与视觉消歧
REAL 的探索流程分四步:
- 导航到承载区域(如餐桌、柜子)
- 绕行扫描,从多个角度拍摄图像
- 运行目标检测模型,识别区域内所有物体
- 对齐注视,将检测结果反投影到3D空间,构建临时地图
系统使用 SoM(Set-of-Mark)技术为每个检测到的物体分配唯一视觉ID。即使两个甜甜圈外观相似,只要它们在图像中的位置不同,就会被赋予不同ID。这样,当用户说“要左边那个”,机器人就能准确对应到具体的视觉ID并执行抓取。
高低层解耦:MCP 让仿真策略直通真机
MCP 协议是 REAL 能实现 sim-to-real 迁移的关键。在仿真中,Pick(object_id=5) 可能直接触发一个理想化的抓取动作;在真机上,同样的调用会被路由到微调后的底层技能模型 $\pi_{0.5}$,后者负责处理真实的抓取姿态、力控等细节。
高层 VLM 完全不需要知道底层是仿真还是真实硬件——它只关心“调用 Pick 是否成功”。这种抽象使得训练好的策略可以零样本迁移到真实机器人,无需任何微调。
双阶段训练:先学会用工具,再学会自主决策
训练分为两个阶段:
第一阶段是监督微调(SFT)。研究者用规则规划器在仿真中生成专家轨迹,再用 Gemini 3 Pro 自动将清晰指令改写为模糊版本,并在轨迹中插入 Ask 调用和模拟用户回复。例如,原始任务是“拿红色杯子”,被改写为“拿杯子”,并在发现红蓝两个杯子时插入提问。经过这一阶段,模型学会了基本的工具调用范式。
第二阶段是在线强化学习(RL),采用新提出的 GSPO(Group Sequence Policy Optimization)算法。与传统的 token 级裁剪不同,GSPO 在整个动作序列级别计算重要性比率,更适合长程任务的奖励稀疏问题。奖励设计综合考虑:任务完成(+1)、操作失败(-0.5)、不必要的提问(-0.1)。这鼓励模型在真正需要时才提问,避免过度依赖用户。
实验发现,仅靠 SFT 的模型在干扰少的任务上表现不错,但在复杂场景容易过拟合;加入 RL 后,模型学会了动态调整策略,比如在找不到目标时扩大搜索范围,而不是死板地重复失败动作。
REAL-Bench:四个任务族检验真实能力
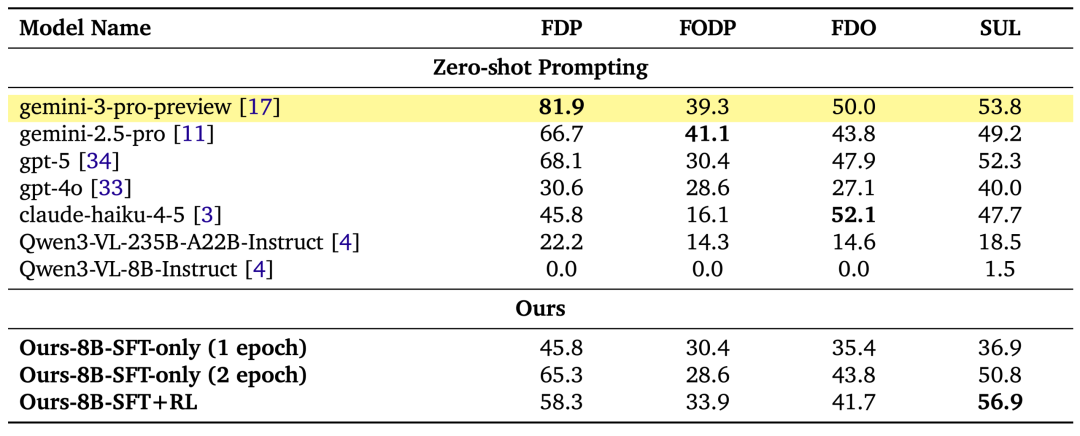
为了全面评估,团队构建了 REAL-Bench,包含 241 个任务实例,分为四类:
- FDP(家具干扰取放):在多个相似柜子中找到正确容器并取物。考验基础探索与操作闭环。
- FODP(家具+物体双重干扰):不仅柜子相似,柜内还有多个同类物体(如三个不同颜色的碗)。要求细粒度视觉定位。
- FDO(开合操作):任务涉及打开柜门、微波炉等,需处理动态遮挡和状态变化。
- SUL(模拟用户闭环):故意给出模糊指令(如“拿水果”),检验主动提问与意图对齐能力。
结果表明,REAL-8B 在 SUL 上达到 56.9% 成功率,超过 GPT-5(52.3%)和 Gemini-3-Pro(53.8%)等零样本基线。这说明主动交互能力无法靠大模型的通用知识解决,必须通过闭环训练获得。
真机部署:78.3% 成功率的背后
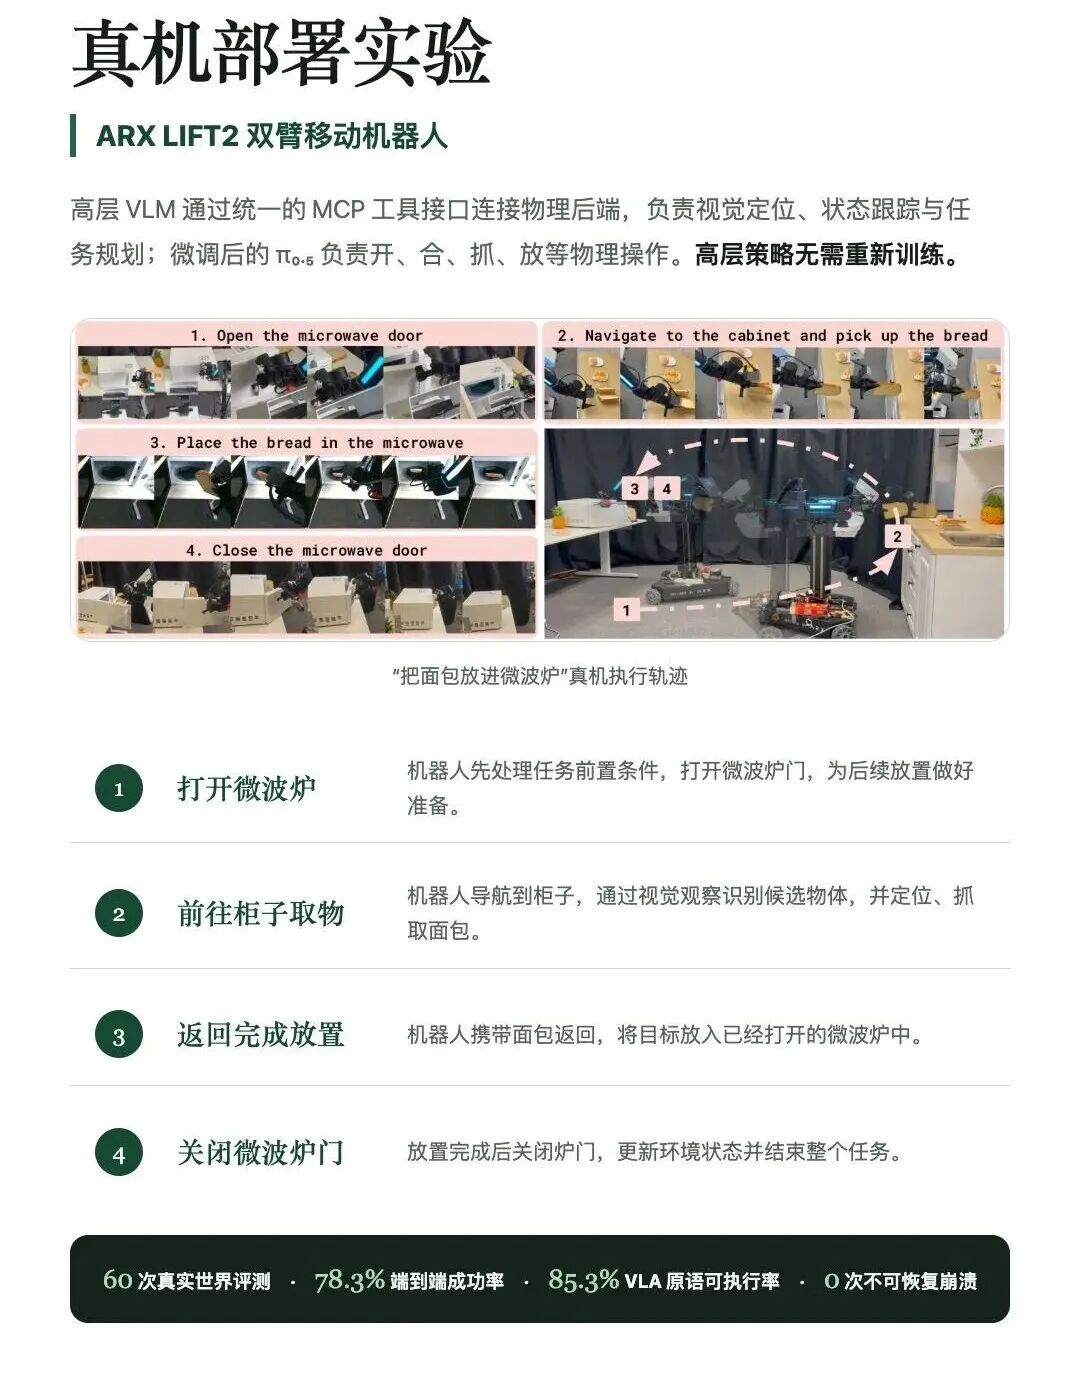
REAL 的最终验证是在 ARX LIFT2 双臂移动机器人上进行的。60 个真实任务 episode 中,系统实现了 78.3% 的端到端成功率。这意味着从接收到模糊指令,到完成最终操作(如“把面包放进微波炉并关门”),整个流程无需人工干预。
一个典型任务展示了 REAL 的规划能力:当指令是“把面包放进微波炉”时,机器人并没有先去拿面包。它首先导航到微波炉,打开门,再去柜子取面包,最后返回微波炉放入并关门。这个顺序体现了对操作依赖关系的理解——如果先拿面包,双手被占用就无法开门。
底层 600 次原语操作(如抓取、放置)的可执行率为 85.3%,说明 MCP 接口有效屏蔽了仿真与现实的差异。更重要的是,整个测试过程中没有发生不可恢复的系统崩溃,证明了框架的鲁棒性。
为什么 REAL 走向了真实世界
REAL 的核心贡献不是某个新模型,而是重新定义了具身智能的训练与部署边界。它承认真实世界的信息是残缺的,用户的表达是模糊的,机器人的感知是有限的。因此,智能体必须具备三种能力:
- 主动探索:不等指令完美,先去看、去扫、去发现
- 意图澄清:在歧义出现时,用自然语言提问而非瞎猜
- 可靠执行:通过解耦设计,确保高层策略能在真实硬件上稳定运行
通过将这三者统一到一个闭环中,并构建从仿真训练到真机部署的完整链路,REAL 为具身智能走出实验室、进入家庭提供了一条可行路径。毕竟,真正的智能,不是在完美条件下表现优异,而是在混乱、模糊、不确定的现实中,依然能找到办法完成任务。