生数科技Motus2世界模型实现机器人自进化闭环
自进化闭环:行动、预测、评估三位一体
机器人拧灯泡时如果歪了,谁来告诉它错在哪?传统方法依赖人类反复示范,但现实场景千变万化,不可能穷尽所有情况。生数科技最新发布的Motus2世界模型尝试解决这个问题——让机器人自己评价动作结果,并用反馈持续改进策略。
Motus2的核心突破在于将三种能力集成到单一模型中:
- 行动:由世界动作模型(WAM)生成下一步动作;
- 预测:通过条件动作世界模型(AC-WM)模拟执行后的状态;
- 评估:价值模型(VM)判断结果是否符合预期。
这三者形成一个闭环流程:生成动作 → 预测后果 → 评估结果 → 更新策略。模型利用自身预测和评估产生的信号优化行为,无需外部干预。这种机制被称为递归自我改进(Recursive Self-Improvement, RSI),是迈向通用智能体的关键一步。
需要强调的是,这里的“自进化”并非指机器人能在开放环境中无限自主学习,而是限定在特定任务内,通过内部反馈迭代优化策略。例如在手机放置和多指操作两项真机测试中,基础策略成功率为65%;加入规划和基于模型的强化学习后,成功率提升至75%,高出10个百分点。
动作优先:防止模型“偷看未来”
要实现可靠的自进化,必须确保模型不会在决策时提前“看到”动作执行后的结果。过去一些视频生成+动作控制的方案失败,正是因为模型学会了用未来的视觉帧反推动作,而非真正理解因果关系。
Motus2采用“动作优先”(Action-first)的信息流设计:先根据当前观测生成动作,再预测该动作带来的后果,最后评估结果好坏。这种严格的时序约束迫使模型学习真实的决策逻辑。
在推理阶段,Motus2使用Best-of-N规划策略:模型生成多个候选动作,分别预测执行后的画面,再由价值模型打分,选择最优方案执行。执行一小段后,机器人重新观察真实环境,开启下一轮循环。这种方式相当于给机器人一次“脑内模拟”的机会,优化当次动作选择。
训练阶段则更进一步:候选动作的评分被转化为策略更新信号。高分方案获得更强的正向引导,低分方案逐渐被模型放弃。团队称此为“基于模型的强化学习”(MBRL)。值得注意的是,该阶段仅更新动作相关参数,预测和评估部分保持冻结,避免反馈信号干扰已学好的模块。
这种机制也改变了对失败数据的看法。以往行业高度依赖“完美轨迹”,失败记录常被当作噪声丢弃;而在Motus2的闭环中,失败轨迹用于学习动作后果与结果评价,帮助模型识别无效操作。例如Physical Intelligence的RECAP系统也让机器人从错误中学习,但Motus2的优势在于能先在模型内预测多种方案的后果,无需全部在现实中试错。
触觉与记忆:补全感知拼图
视觉虽能提供物体位置和姿态信息,却难以判断接触状态。比如撕厨房纸时,双手看似到位,但是否夹稳、有无打滑,这些细节直接影响后续动作。Motus2为此引入轻量级触觉专家模块,在短动作片段执行前读取最新触觉反馈,细化动作指令。
该模块复用主模型已计算的中间结果,避免每次重新运行完整视频骨干网络,兼顾反馈频率与计算开销。在抽取纸杯、撕纸两项任务中,加入触觉后平均成功率从60%提升至72.5%,增幅达12.5个百分点。
记忆机制则解决另一类问题:当目标物体被隐藏或环境动态变化时,仅靠当前帧无法做出正确决策。例如三个杯子中藏一方块,重新排列后需依赖历史信息定位。Motus2默认缓存近期真实观测,在寻找隐藏方块、根据历史提示操作按钮两项测试中,保留完整历史的方案平均成功率达57.5%,明显优于压缩历史的方案。
这说明对于依赖长期上下文的任务,历史信息本身就是决策要素。但完整保存所有观测会增加存储和计算负担,而过度压缩又可能丢失关键线索。目前Motus2的做法更像是阶段性妥协——在找到更优解前,优先保证信息完整性。业内其他团队也在探索类似平衡,如只保留最近片段或对历史“划重点”,但物理世界的记忆问题尚无优雅解法。
从人类经验到机器人操作
Motus2已部署于单手22自由度的Sharpa Wave和20自由度的WUJI Hand 2等高自由度灵巧手上,完成拧灯泡、翻书等复杂任务。自由度越高,操作可能性越多,但也带来学习复杂性:同一物体可用不同手指组合抓取,微小差异可能导致后续动作完全不同。
真正的难点在于数据。Motus2选择将人类第一视角(Ego)操作经验作为主要数据源,再逐步迁移到机器人平台。整套Ego数据体系包含约13万小时人类操作视频,配合百小时级的机器人及人机对齐数据。
训练分三步走:首先用单目Ego视频预训练,学习基础物体与场景变化规律;其次引入双目视频和人类动作数据,掌握手部与物体交互细节;最后通过机器人轨迹和人机对齐数据,将经验适配到机器人控制空间。
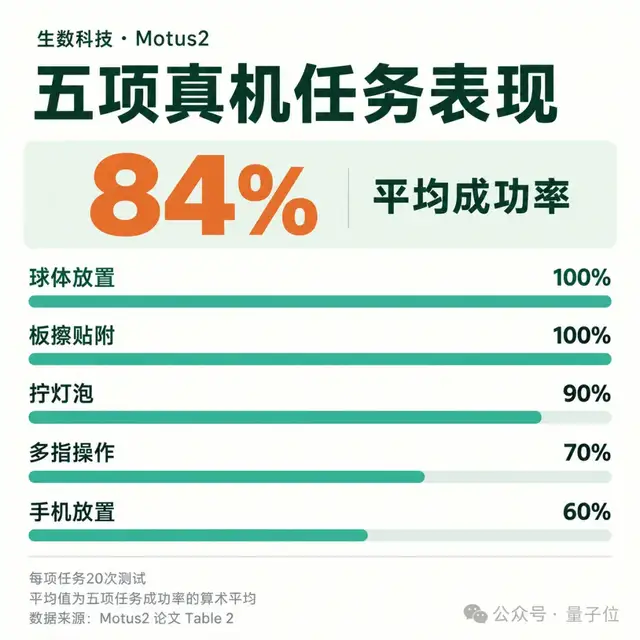
对照实验显示,在相同微调流程下,仅经人类Ego数据预训练的模型在五项真机任务中平均成功率为51%;加入机器人中间训练后,成功率跃升至84%,提升33个百分点。这表明人类数据提供规模化世界知识,机器人数据完成控制适配。
尽管人手与灵巧手在尺寸、关节活动范围上存在差异,但人类经验仍构成有效学习基础。团队还测试了双目数据规模的影响:从2000小时增至20000小时,模型在人类动作预测任务上的验证误差持续下降,未见明显天花板。这意味着依靠人类数据提升性能的路径仍有潜力可挖。
从L3到L4:还有多远?
生数科技将通用世界模型演进分为五级:L1生成世界、L2与世界交互、L3在世界中行动、L4自主世界智能体、L5世界组织者。Motus2已具备L3核心能力——理解状态、预测后果、输出真实动作。
向L4迈进的关键,在于模型能否利用自身能力参与改进自身。Motus2通过预测不同动作后果并评估其价值,产生策略更新信号,初步触及L4的“自主决策、自主反馈、持续自我改进”内核。
但距离开放世界中的长期自主学习仍有差距。触觉数据在不同机器人本体间的迁移困难,长任务中的预测可靠性、记忆效率,以及持续学习机制都需进一步探索。不过Motus2至少验证了一点:评价与反馈已真正进入世界模型的闭环,机器人开始从“能行动”走向“会反思”。