Vidu S2:AI视频能边播边改,还能实时换人换背景
AI视频不再是一次性成品,而是可实时操控的“活画面”
过去,AI生成的视频大多是一段预先计算好的内容,用户只能看,不能改。但现在,情况变了。打开摄像头,上传一张角色图,画面里的人就能立刻“变身”——动作照做,节奏不变,连背景都能同步切换。你甚至可以对虚拟人说“跳个舞”,它马上开始扭动,动作流畅得像排练过。

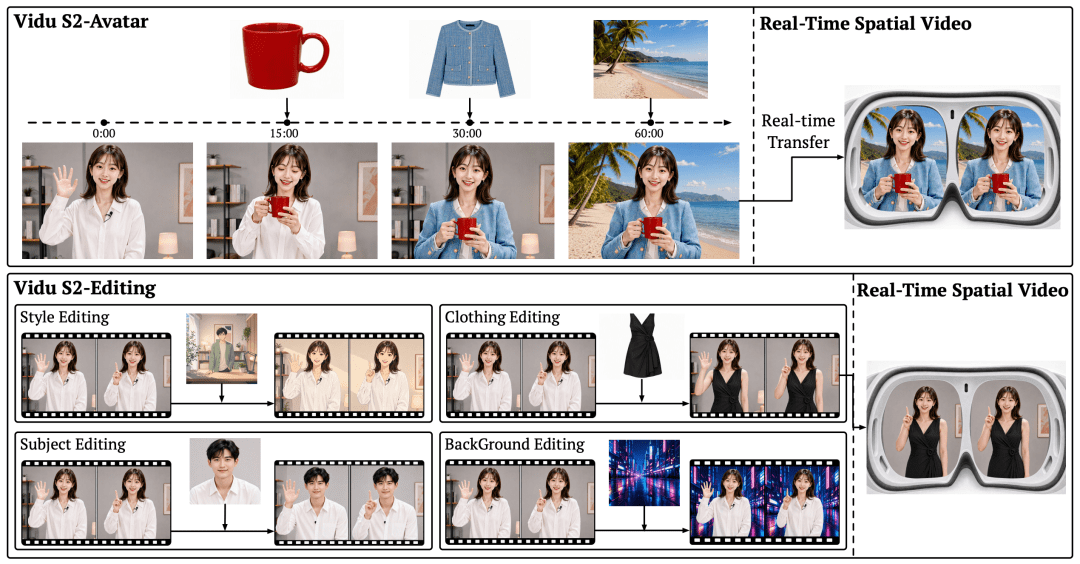
这种体验来自生数科技最新发布的 Vidu S2。它不是简单的视频生成工具,而是一套专为实时交互与实时编辑设计的系统,包含三大核心能力:实时数字人(S2-Avatar)、离线数字人(S2-Avatar Offline)和实时视频编辑(S2-Editing)。

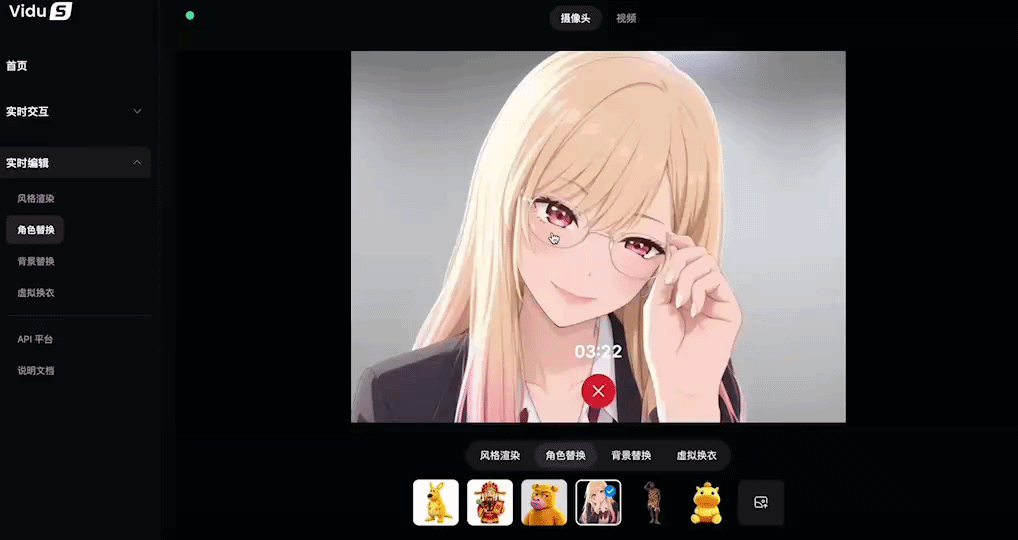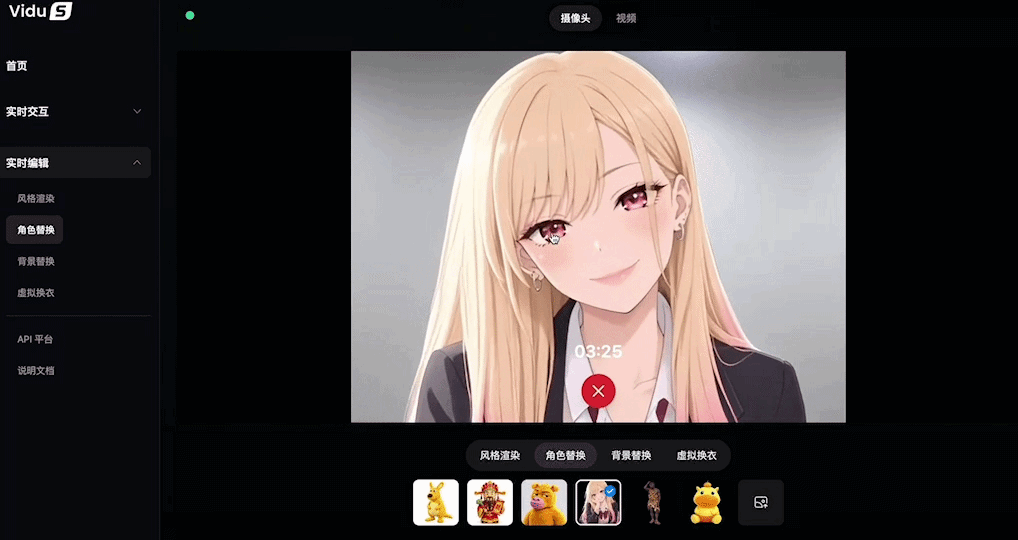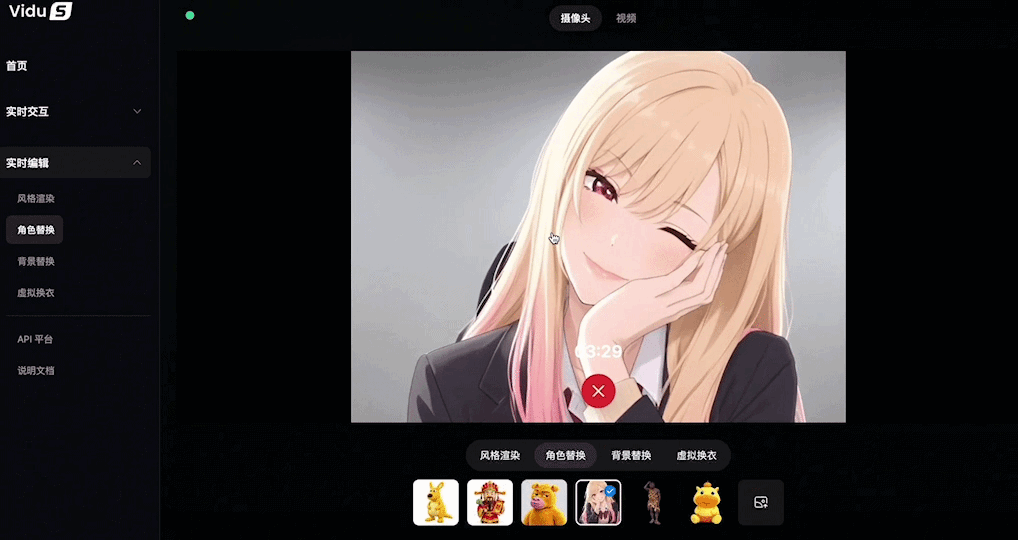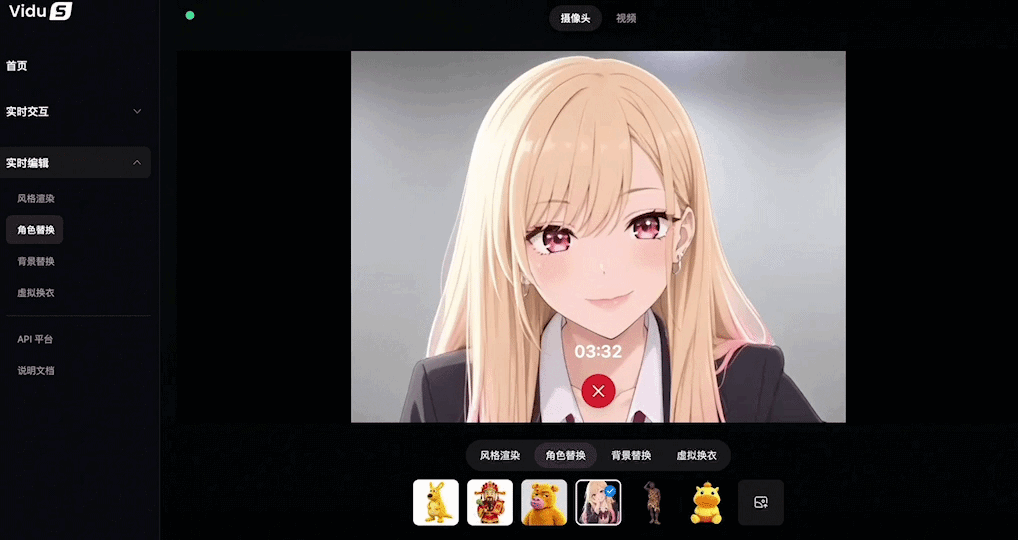
最引人注目的是 S2-Editing:它能持续接收摄像头或视频流,在不打断原有动作、镜头运动和时间顺序的前提下,实时替换人物、服装、风格或背景。就像P图一样,但这次是“P视频”——边拍边改,画面不停。

69天迭代:从说话到跳舞,从单目到立体

Vidu S2 的发布距离其前代 S1 仅隔约69天。这期间,团队不仅提升了分辨率(从540p到720p),还将动作能力从以口型同步为主,扩展到全身舞蹈等大幅运动。更关键的是,控制对象从固定数字人扩展到了动态参考图和完整视频流。

如果说 S1 实现了“边聊边生成”,S2 则做到了“边演边改”。当用户不断加入新指令、角色开始剧烈运动、输入变成连续视频流时,系统仍需快速响应、稳定输出,并精准只改该改的部分。
这对技术提出了三重挑战:速度要快,才能实时;稳定性要高,避免误差累积;控制要准,确保新指令在正确时刻生效。Vidu S2 的整个技术路线,正是围绕这个“速度—稳定—控制”三角展开。
流式生成:如何让AI学会“边走边看”
传统视频扩散模型能看到整段视频,多轮去噪后一次性输出结果。但实时系统不行——它只能依赖已生成的画面,逐段预测后续内容。前一段的微小偏差,可能被下一段放大,最终导致画面崩坏。
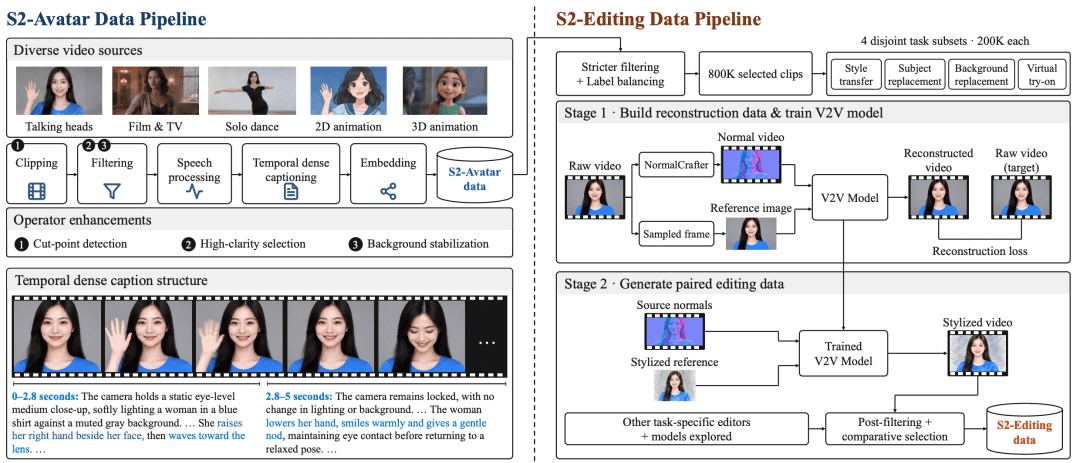
为解决这个问题,Vidu S2-Avatar 从数据和训练两方面入手。团队扩充了舞蹈、二维/三维动画等素材,并按事件顺序标注动作起止和状态变化,帮助模型理解连续动作的衔接逻辑。
训练分两步:先用双向音视频联合扩散模型建立人物、动作、声音与场景的关联;再将时间注意力机制改为分块因果注意力,让模型只能看到“过去”,不能窥探“未来”,从而适应流式生成模式。
Self-Replay Forcing:让模型带着自己的错误复盘
光有因果结构还不够。实际运行时,模型读取的是自己刚生成的画面,其中的变形或抖动会被后续片段继承。为此,团队提出 Self-Replay Forcing。
具体做法是:先让模型按真实推理方式生成一段长视频;再从中切出多个视频块,分别加入噪声,进行一次可计算梯度的“因果回放”。原始生成过程固定不变,参数更新只在回放阶段进行。
这相当于让模型“先犯错,再复盘”。由于多个视频块处于同一计算图中,后续片段的损失能通过梯度反向影响早期表示,从而学会在带偏差的历史条件下维持稳定性。训练还加入了感知损失,防止模式坍塌,保留多样性。
此外,偏好优化贯穿全程:双向阶段用 DPO 提升画质和音画同步;流式阶段用 Streaming NFT 进一步优化实际生成中的动作可控性和指令遵循。
Backbone管动作,Refiner补细节:720p如何跑得动
高分辨率意味着高计算开销。Vidu S2-Avatar 采用 Backbone 与 Refiner 两阶段架构来平衡速度与清晰度。
- Backbone 在低分辨率下生成视频,专注人物动作、整体结构和跨片段连续性;
- Refiner 将低分辨率结果上采样,加入固定强度噪声,再通过一步去噪恢复高清细节。
两者对历史信息的使用也不同:Backbone 读取噪声较高的历史缓存,侧重传递粗粒度运动;Refiner 则读取高分辨率缓存,保留身份特征和纹理线索,用于细节修复。
推理端还采用分层加速策略:根据网络层对精度的敏感度,组合使用 SageAttention、SpargeAttention 和稀疏线性注意力;细粒度 W8A8 量化降低显存占用;算子融合和 CUDA Graphs 减少启动开销。多 GPU 调度则协调各模块执行时序,提升资源利用率。这些优化共同支撑了 25~42 FPS 的 720p 实时输出。
VLM Agent:把用户指令变成连贯动作链
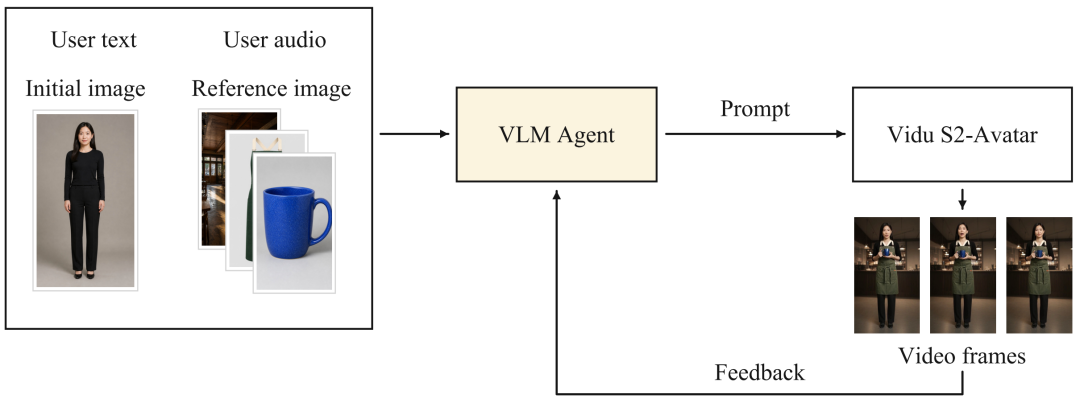
用户临时上传一张衣服或杯子图片,系统如何判断用途?Vidu S2 引入 VLM Agent 来解决这个问题。
Agent 接收文字、语音、初始图和新增参考图,将其转化为生成提示词,并持续检查返回的视频帧。它会判断当前动作是否完成、是否偏离要求,并记录需要延续的状态。
例如,用户说“拿起杯子,然后微笑”,第二条指令仍会保留“手持杯子”状态;人物摘下帽子后,Agent 会记住帽子在手中,直到用户要求重新戴上。这样,多轮指令就能形成连贯的动作链,而非孤立片段。
帧对齐注意力:像P图一样P视频,但时间轴不乱
S2-Editing 的核心挑战是:既要跟随原视频的动作和镜头,又要让新外观在连续画面中保持一致。解决方案是 帧对齐稀疏注意力。
具体来说,目标帧只与源视频中同一时刻的画面交互,避免不同时刻的动作信息互相干扰;而参考图则对所有目标帧可见,为外观提供持续引导。源视频负责动作和空间结构,参考图负责外观变化。
在流式推理中,每个源帧与对应目标帧一起处理,处理完即丢弃,减少缓存占用;生成端则保留必要历史信息,维持连贯性。配合模块间协同调度,系统进一步降低端到端延迟。
训练同样分阶段:先做双向编辑训练,采用帧对齐交互;再转为分块因果注意力,用 Hybrid Forcing 初始化,最后用 Self-Replay Forcing 从自生成轨迹中学习时序一致性。
数据方面,团队从筛选素材中选出80万段视频,分为四组(风格转换、主体替换、背景替换、虚拟试衣),用编辑模型生成候选结果,经质量筛选后构建配对数据。
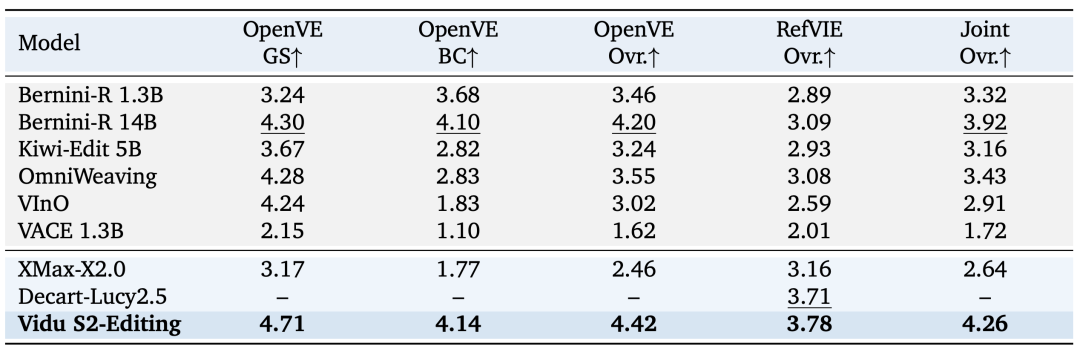
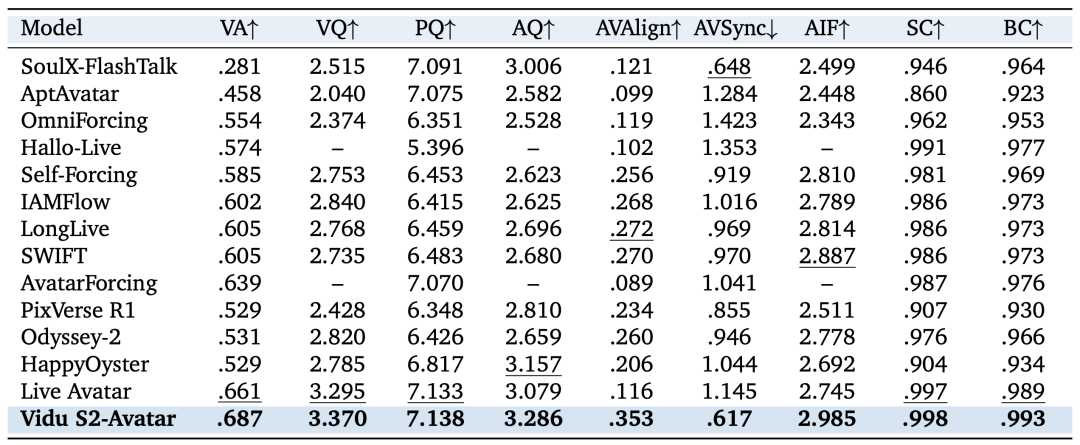
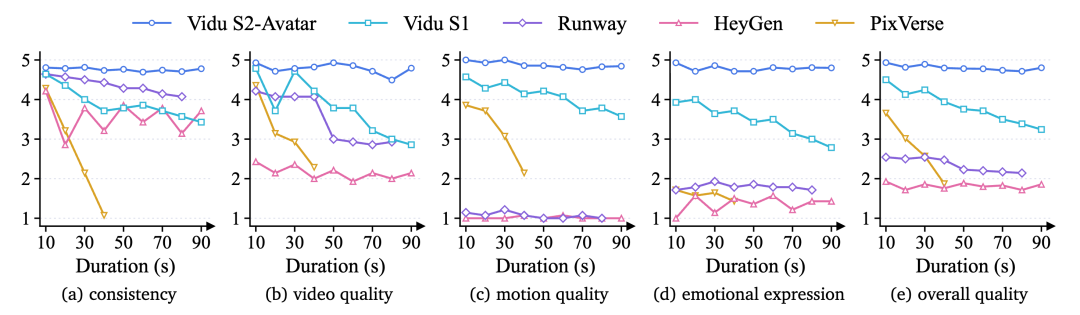
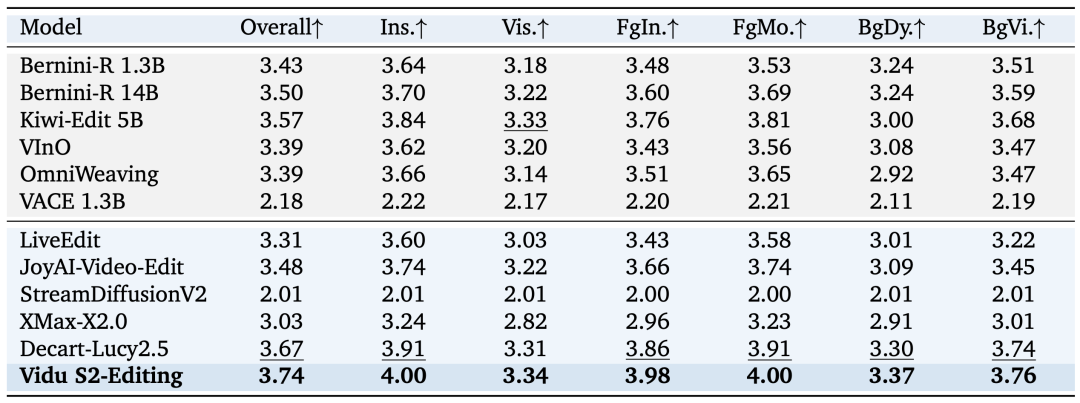
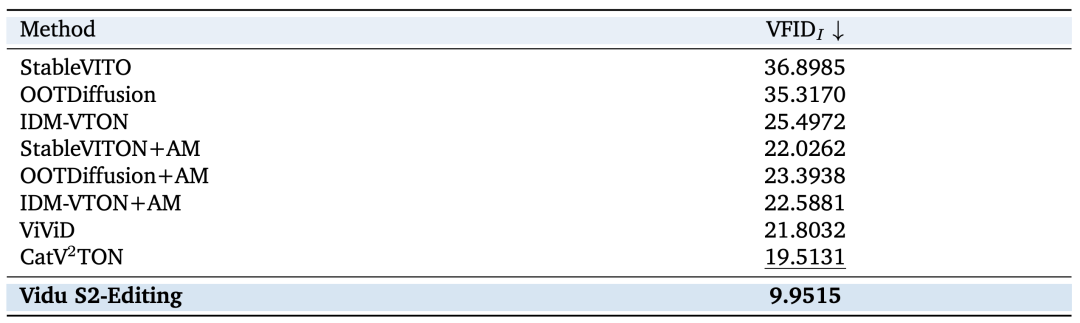
评测显示,Vidu S2-Avatar 在 StreamAV-Bench 的九项指标上均领先,主体一致性和背景一致性分别达 0.998 和 0.993。在10秒至90秒的长时生成中,画质、运动、情绪等评分保持稳定。S2-Editing 在 Sparkle-Bench 获得3.74综合分,在 OpenVE 与 RefVIE 联合评测中得4.26分。虚拟试衣指标 VFIDI 为9.9515(越低越好),显著优于第二名的19.5131。
空间视频:左右眼同步,为XR铺路
Vidu S2 还将实时能力扩展到空间视频——即为左右眼提供带视差的画面,让用户感知深度。
对于 S2-Avatar,系统先生成单目视频,再估计每帧深度,将中心视图向左右偏移,合成双目画面。视差变换会在物体边缘产生空洞,需填补;单帧深度估计易波动,还需稳定相邻帧深度,避免立体效果抖动。
S2-Editing 支持两条路径:一是先编辑单目视频,再转双目;二是将已有双目视频横向拼接,一次推理共同编辑,再拆分输出。这意味着换装、换人、换背景等操作,都能进入头显看到的空间画面。
值得注意的是,字节跳动也被曝正在开发基于 Seedance 的实时空间视频模型,计划与 PICO 头显结合。这说明空间视频正成为 AI 模型与 XR 硬件的新战场。Vidu S2 目前仍以固定视角双目视频为主,距离自由探索的全景环境还有距离。但更高分辨率、更低延迟将是下一阶段重点。
实际效果:视频不停,变化照常发生
技术之外,看效果更直观。
Vidu S2-Avatar 能在实时对话中执行复杂动作:摆臂、扭身、踏步、抬腿,甚至完成物品互动。结合参考图,还能换服装、换背景,输出720p高清画面。
S2-Editing 则让真人视频流“随心所欲”:你说换人,画面里的人立刻变成指定角色;你说换风格,整个画面瞬间变成油画或动漫风。关键是,人物原有的表演节奏丝毫不受影响。
对直播、虚拟拍摄、互动娱乐来说,这意味着视频不再是静态内容,而是一个可随时导演的视觉界面。
开放实验:从第一天就交给用户共创
Vidu S2 并非只停留在演示。产品发布当天,生数科技同步开放了网页体验、API 文档和技术论文。团队希望从 Day 1 就把它作为一个开放实验,让用户参与打磨。
体验链接、API 平台和技术报告均已公开。虽然产品仍在迭代,但这种“边发布边共创”的节奏,或许正是快速推进 AI 视频落地的关键。
AI 视频的未来,不再是等待一段完美生成的结果,而是能在真实时间里,持续运行、随时响应、不断被改造的动态系统。Vidu S2 展示的,正是这条越来越清晰的路径。